人工智能
用 CDK 在托管 Amazon Bedrock Knowledge Base 上构建智能体检索本文介绍如何用 AWS 云开发工具包(AWS CDK)在托管 Amazon Bedrock Knowledge Base 上构建企业级智能体检索。要理解这件事为什么值得做,最好先看看普通检索增强生成(RAG)在哪里失效。大多数 RAG 系统的起点都一样:把问题做嵌入,从单个索引中取回最相近的文本块,交给模型,然后返回答案。一次检索,一次生成。对一大类问题来说,这是正确的设计,也没有理由去构建更复杂的东西。
它的失效方式很有辨识度。如果一个问题需要跨两个语料库才能回答,单次检索只能返回模型所需的一半信息,这比什么都不返回更糟,因为答案会以流畅却残缺的形式出现。如果一个问题中 正确的来源取决于问题本身, 而单个索引没有选择机制。如果一个问题需要在看到第一个结果后再查一次语料库,那么这第二次查询就无处发生。
企业级智能体检索通过把推理智能体引入循环来解决这三个问题。智能体决定是否检索、查询哪个知识库,以及在组织答案之前是否需要回头再查。这正是 Amazon Bedrock Knowledge Bases 的演进方向。随着托管知识库的推出,检索不再是一次嵌入加取回的调用。它已成为一种智能体能力:多轮规划、工具驱动的检索,以及有依据、带引用的答案。AgenticRetrieveStream API 将其作为一等服务功能提供,而不是需要你自己拼装的东西。这确实可行,但也引入了一个真正更难的运维问题。单次流水线是一个读一遍就能推理清楚的函数。而在循环中推理并检索的智能体,对每个问题都会走不同的路径。默认情况下,你既看不到它走过的路径,也不知道它产出的答案好不好。可观测性不再是锦上添花,而成为了解系统是否正常工作的唯一途径。
2024 年 8 月, Build an end-to-end RAG solution using Knowledge Bases for Amazon Bedrock and the AWS CDK 将单次设计部署为一个 CDK 应用:一个 Amazon Simple Storage Service (Amazon S3) 语料库、一个 Amazon OpenSearch Serverless 集合与索引、一个知识库和一个数据源,作为 CDK 堆栈预置,其顺序由你手工编排。自那篇文章发布以来,有三件事发生了变化。
- Amazon Bedrock 现在提供托管知识库 (Type: MANAGED),它自行负责摄取、存储、索引和检索。那篇文章所预置的 OpenSearch Serverless 集合与索引,不再需要你创建、扩展,也不再需要按 OpenSearch 计算单元(OCU)付费。
- Amazon Bedrock AgentCore 提供了智能体那一半, 一个 Gateway 将每个知识库暴露为模型上下文协议(MCP)工具,一个 Runtime 托管推理智能体,以及 AgenticRetrieveStream,它在内部重排并返回经过综合、带引用的答案。智能体检索 仅 在托管知识库上可用。
- 可观测性与评估如今也可以被预置, 而不是事后附加。本方案随同一次部署提供两块 Amazon CloudWatch 仪表盘,覆盖七层遥测,并提供按需与持续两种评估形式。
本文构建的正是这个系统:一个智能体,在两个知识库之间路由,通过 Gateway 检索,并返回有依据、带引用的答案,其行为的每一层都被埋点监测,全部作为一个 Python 编写的单一 AWS CDK 应用。一条命令即可部署全部内容,顺序由 CDK 推导。
如果你读过那篇 2024 年的文章, 从 Amazon S3 存储桶到知识库的路径会看起来很熟悉,而之后的一切都是新的:向量存储没有了,检索变成了智能体式的,而应用所预置的内容中大约有一半是为了告诉你智能体做了什么。如果你没读过,本文也可以独立阅读。
涉及的服务,以及一个问题穿过它们的路径:智能体决定是否检索、查询哪个知识库,Gateway 将每个知识库暴露为它可以调用的工具,托管知识库执行搜索并给出引用,循环按问题的需要重复任意多次。智能体沿途所做的一切都会落到 Amazon CloudWatch 中。
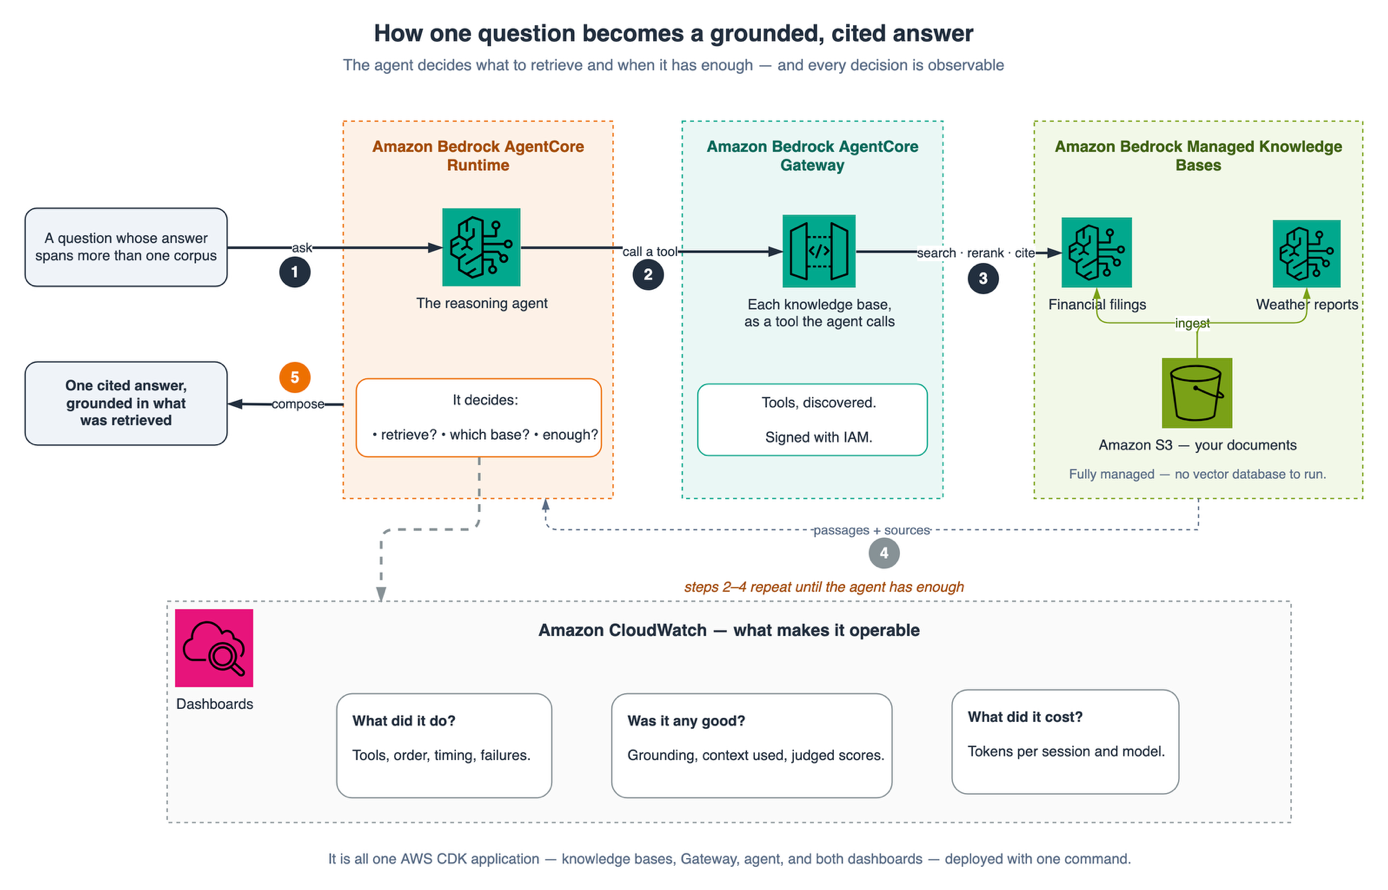
图 1:涉及的服务,以及单个问题穿过它们的路径
背景
在开始逐步讲解之前,先确立三件事会有所帮助:是什么让检索成为智能体式的,为什么托管知识库是它的正确基础,以及为什么可观测性与评估应当属于设计的一部分,而不是事后附加。
从 RAG 到企业级智能体检索
经典检索增强生成(RAG)做一次检索和一次生成。 企业级智能体检索 把推理智能体引入循环:它决定 是否 检索以及 检索什么 ,可以多次检索以细化,选择 哪个 知识库相关(语义路由),然后才组织出有依据、带引用的答案。借助托管知识库,这是一项一等服务能力,AgenticRetrieveStream API 执行多轮规划、执行检索并返回带引用的答案,而不是你在原始向量搜索之上构建和维护的编排层。这在复杂问题上能产生更好的答案,但也产生了一个更复杂的待运维系统,这正是为什么可观测性与评估从一开始就内置其中。
托管知识库与自助式知识库的对比
Amazon Bedrock 现在提供 托管知识库 (Type: MANAGED):Amazon Bedrock 为你管理 摄取、存储、索引和检索 ,默认使用服务托管模型完成嵌入与重排,因此 无需预置、扩展或修补任何向量数据库这与 客户托管 (DIY)知识库不同,后者由你自己选择和运营向量存储(例如 Amazon OpenSearch Serverless)。
对本解决方案而言,最重要的差异有两点:
| 能力 | Amazon Bedrock 托管 | 客户托管(DIY) |
| 智能体检索(AgenticRetrieveStream) | ✅ 支持 | ❌ 不支持 |
| AgentCore Gateway 集成 | ✅ 支持 | ❌ 不支持 |
| 数据存储 | 自动扩缩容,完全由 Amazon Bedrock 托管 | 由你预置、扩缩容和维护 |
| 嵌入 + 重排 | 内置托管模型,无额外成本 | 由你配置 |
| 需管理的基础设施 | 无 | 向量数据库 + 更多 |
由于智能体检索和 AgentCore Gateway 连接器仅在托管知识库上可用,因此它是企业级智能体检索的天然基础。这也意味着 Amazon Bedrock 会为你管理存储和索引,因此在此设计中无需预置 OpenSearch Serverless 集合或 OCU 容量。当你希望选择并运营自己的向量存储时,例如为了复用现有的 OpenSearch Serverless 集合,或满足特定的数据驻留、调优或合规要求,客户托管选项仍然是正确的选择。对于企业级智能体检索而言,托管知识库正是让这一能力成为可能的关键。
为什么需要可观测性与评估
一个智能体系统仅仅 返回答案 对于生产环境来说是不够的。你需要了解它的行为方式(延迟、调用量、token 用量)、检索和答案的质量如何,并且需要持续获得这些信号。本解决方案 预置了 两个 CloudWatch 仪表盘,覆盖七层遥测,外加两种评估形式(按需和持续),全部由同一个 CDK 应用预置。依据、引用和评估层也支持负责任的使用。带引用的答案可追溯到其来源段落,因此响应保持可审计;忠实度和正确性评分让你能够发现答案偏离来源的情况,而不是等到生产环境中才发现。
为什么这个特定解决方案选择 CDK
任何基础设施即代码工具都可以创建这些资源。CDK 在这里占有一席之地,原因与这一架构的具体特点有关: 四个堆栈之间存在密集的交叉引用。Gateway 需要两个知识库 ID。智能体需要 Gateway 的 URL 和 ARN。仪表盘需要知识库 ID、Gateway ARN 以及 智能体运行时 ID,共有七个值跨越堆栈边界,每一个都是某个指标上的维度或某个连接器上的目标。
如果写成原始模板,那就是一组堆栈导出和跨堆栈查找,需要手工保持一致,再加上一个按正确顺序部署并向前传递输出的脚本,而一旦有任何内容被重命名,两者都会发生漂移。在 CDK 中,你传递构造,导出和依赖边都源自这一次传递动作。2024 年的解决方案有三个堆栈,依赖链基本是线性的。到了四个堆栈、七个值在它们之间交叉传递时,这种差异就不再是风格问题了。
解决方案概览
下面是一个问题端到端穿过系统的路径。值得慢慢看一遍,因为本文的其余部分会从左到右逐一讲解。
下图描绘了端到端的智能体检索工作流。用户的问题进入 AgentCore Runtime 上的智能体,智能体通过 AgentCore Gateway 将其路由到两个 AgenticRetrieveStream 工具之一,每个托管知识库对应一个工具,分别是财务和天气,各自从 Amazon S3 摄取数据。所选工具返回有依据、带引用的答案,每一步都会流式传输到 Amazon CloudWatch 和 AWS X-Ray。编号徽标对应下面的逐步讲解。
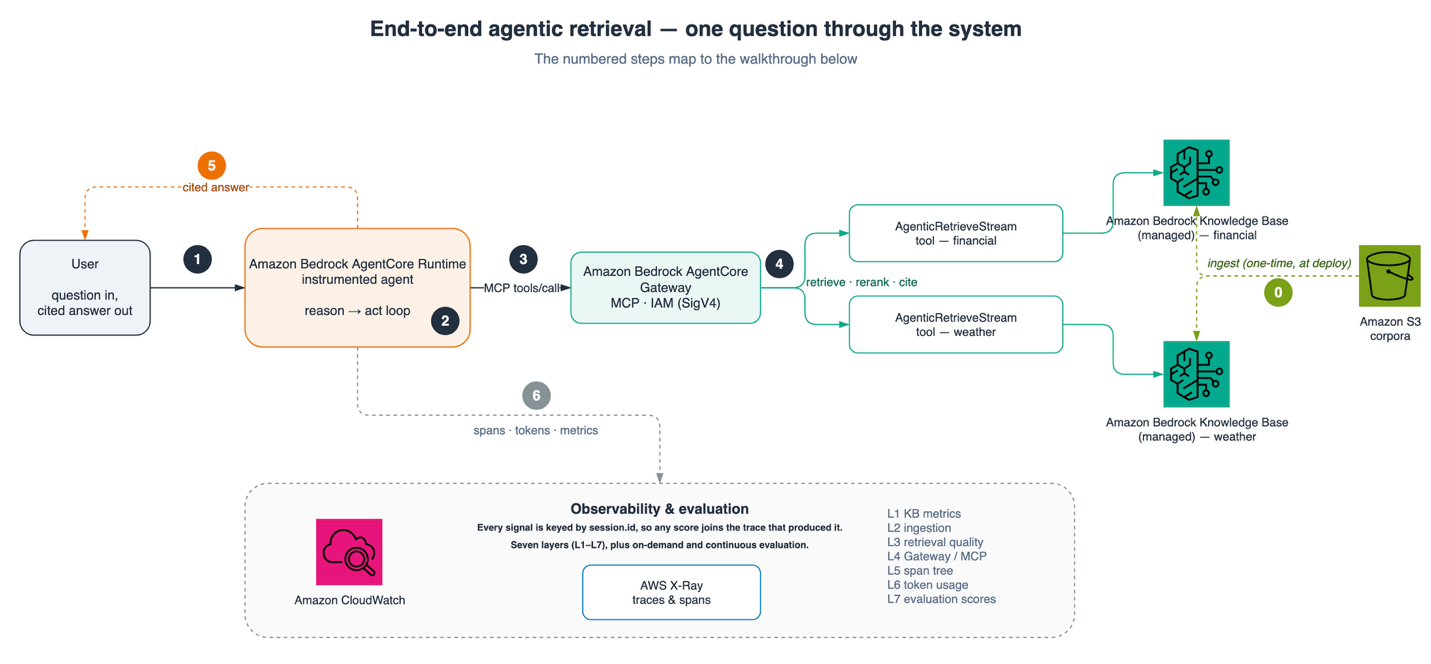
图 2:单个问题的端到端智能体检索工作流
图中的编号步骤对应以下工作流。
步骤 0——一次性,在部署时执行。 在提出任何问题之前,Amazon S3 中的每个语料库都会被摄取到各自的托管知识库中:Amazon Bedrock 会自动解析、分块、嵌入并索引它。这在堆栈部署时发生一次,不属于每个问题的处理路径,因此用虚线箭头绘制并标记为步骤 0。之后每个问题都遵循步骤 1–6:
- 用户向智能体发送问题 ,智能体托管在 Amazon Bedrock AgentCore Runtime 上。Runtime 使用 OpenTelemetry(OTEL)span 自动为整个推理-行动循环提供插桩,因此系统从第一次调用起就可观测。
- 智能体的推理模型进行规划并跨知识库路由。 由于每个知识库都作为独立的检索工具暴露,智能体会选择主题与问题匹配的工具,财务或天气,而不是搜索一个混合索引。
- 所选工具调用由 AgentCore Gateway 通过 MCP 代理,由智能体的 IAM 任务角色授权并使用 SigV4 签名,该调用会调用该知识库在托管知识库上的 AgenticRetrieveStream API。
- AgenticRetrieveStream 执行知识库内部的工作: 它将问题分解为子查询,从 Amazon Bedrock 管理的数据存储(从 Amazon S3 中的语料库摄取)中迭代检索,并综合出有依据、带引用的答案,通过 Gateway 流式返回。
- 智能体检查返回的上下文是否充分。 如果不充分,它会循环,再次路由和检索,然后组织最终答案。如果充分,它将带引用的答案返回给用户。
- 在整个过程中,Runtime 发出 span、token 计数和指标 到 Amazon CloudWatch 和 AWS X-Ray,填充七层可观测性,并为按需和持续评估评分提供输入。
在内部,该工作流是一个 CDK 应用, app.py,它声明了四个堆栈。你不需要选择顺序,CDK 会根据你传递的构造引用推导出顺序:
kb_stack = KnowledgeBasesStack(app, f"{project}-kb", env=env)

gateway_stack = AgenticGatewayStack(
    app, f"{project}-gateway", env=env,
    financial_kb=kb_stack.financial_kb,  # ← the reference creates the dependency
    weather_kb=kb_stack.weather_kb,
)

agent_stack = AgentRuntimeStack(
    app, f"{project}-agent", env=env,
    gateway=gateway_stack.gateway,
)

DashboardsStack(
    app, f"{project}-dashboards", env=env,
    financial_kb=kb_stack.financial_kb,
    weather_kb=kb_stack.weather_kb,
    gateway=gateway_stack.gateway,
    agent_runtime=agent_stack.agent_runtime,
)
这就是全部的连接关系。这四个构造函数调用取代了导出/导入的簿记工作和部署脚本。
| # | 堆栈 | 它创建的内容 | 说明 |
| 1 | -kb | S3 存储桶、语料库上传、两个 Type: MANAGED 知识库、数据源、IAM、摄取 | 知识库达到 ACTIVE 状态,语料库完成摄取 |
| 2 | -gateway | 网关(AWS_IAM / MCP),按知识库的 AgenticRetrieveStream 目标 | 无需 Cognito |
| 3 | -agent | ECR、CodeBuild、在 Runtime 上插桩的 Strands 智能体、提供的日志/跟踪、在线评估 | 约 8–10 分钟 (镜像构建) |
| 4 | -dashboards | agentic-observability + kb-observability 仪表盘 | 在产生流量之前为空 |
智能体运行一个推理-行动循环:它思考(调用一次大语言模型(LLM)),决定调用哪个知识库工具,通过 Gateway 读取返回的内容,并且常常在组织最终带引用的答案之前再次检索。每一步都由 Runtime 自动插桩,因此七个可观测性层会由真实流量填充。
七个层。 L1 知识库原生指标、L2 摄取、L3 智能体检索质量、L4 Gateway/MCP 指标、L5 OTEL span 树、L6 token 用量和 L7 评估分数。第 1、4、5 层自动发出。第 3、6、7 层由驱动程序笔记本作为自定义指标发布。
所有可调项都集中在一个文件中, config.py:
| 设置 | 含义 | 默认值 |
EnvSettings.PROJECT_NAME |
名称前缀,用于 每个 堆栈和资源 | bmkb-obs-cdk |
EnvSettings.ACCOUNT_REGION |
要部署到的 AWS 区域 | us-west-2(或你的配置文件中的区域) |
KbConfig.EMBEDDING_MODEL_TYPE |
MANAGED (捆绑)或 CUSTOM (自带 ARN) |
MANAGED |
AgentConfig.MODEL_ID |
智能体的推理模型,即第 6 层支出 | Claude Haiku 4.5 |
EvalConfig.SAMPLING_PERCENTAGE |
在线评估采样率, 请参阅免责声明 | 100 |
更改 PROJECT_NAME 会为你提供整个解决方案的一个独立命名的副本,因此两个部署可以在同一个账户中共存。驱动程序笔记本读取同一个常量,因此它会自动跟随重命名,无需手动保持堆栈名称同步。
描述数据集
该解决方案附带两个小型语料库,捆绑在仓库的 data/ 目录下:
- 金融 —— 一份合成的 Octank Financial 10-K(octank_financial_10K.pdf,约 198 KB)。
- 天气 —— 一份 真实、公开可获取的 美国国会研究服务局关于龙卷风的报告(IF12695, tornadoes_report.pdf,约 560 KB)。
⚠️ 关于数据: 该金融语料库是 合成的. Octank 是一家虚构公司,10-K 是模型生成的示例数据(CC0 许可)。它并非 真实的财务数据。天气语料库是真实的、属于公有领域的美国政府作品,是一份国会研究服务局报告,可在 sgp.fas.org/crs/misc/IF12695.pdf 公开获取(美国政府作品不受版权保护)。要使用你自己的数据,请将文件放入 data/ 下,并调整 config.py中的前缀,无需其他更改。
这两个语料库被有意设计为彼此独立,因此智能体必须将每个问题路由到正确的知识库,这就是语义路由的故事。由于这些是托管知识库,我们无需配置分块、嵌入或索引:在摄取时,Amazon Bedrock 会解析每个 PDF、对其进行分块、使用其托管模型进行嵌入,并自动建立索引。
我们使用两个独立的知识库,每个都通过 Gateway 作为其自身的检索工具暴露出来,而不是用一个知识库同时容纳两个语料库,这一选择是有意为之的。为智能体提供两个具名工具,使路由成为一次可被观察到的显式推理行为:span 树会显示它为给定问题选择了 哪个 工具,而第 3 层的检索质量指标则按知识库保持可分离,因此金融和天气的精确度绝不会模糊成单一数字。一个横跨两个语料库的单一工具会抹平这种区分,路由决策会移入单个索引的排序内部,脱离视野,而每个质量信号都会成为两个不相关领域的平均值。将语料库及其工具保持分离,正是让智能体行为清晰可读的关键,而这正是本练习的全部意义所在。
在 CDK 中,将语料库放入 S3 是通过 BucketDeployment 完成的:
s3deploy.BucketDeployment(
    self, "FinancialCorpus",
    sources=[s3deploy.Source.asset(str(ROOT / "data" / "financial"))],
    destination_bucket=self.source_bucket,
    destination_key_prefix=KbConfig.FINANCIAL_PREFIX,
)
BucketDeployment 值得了解,恰恰是因为替代方案太诱人了:没有它,触发摄取的 custom resource 往往会多出一个上传步骤,于是现在一个资源承担了两项不相关的任务。在这里,它只需 摄取.
托管摄取会自动扫描、分块、嵌入并索引每个文档:每个知识库索引一个文档,零失败。
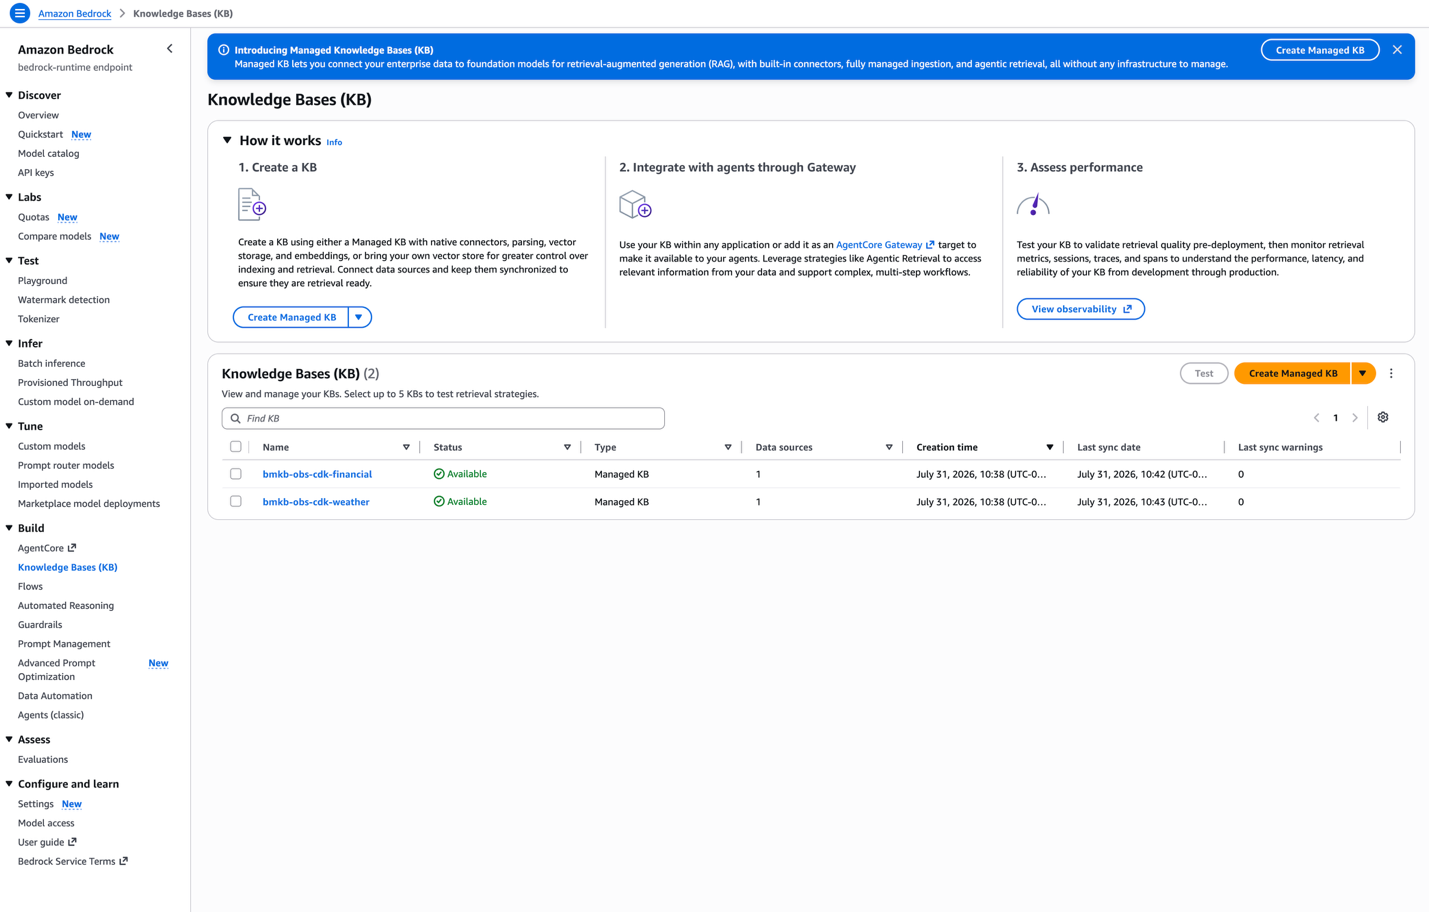
图 3:托管摄取结果,每个知识库索引一个文档,零失败
部署该解决方案
本节将演示如何用一条命令部署整个解决方案。在满足前提条件后, cdk deploy --all 按 CDK 推导出的依赖顺序预置全部四个堆栈,并自动串联每一个跨堆栈的值。
前提条件
- 一个拥有 Amazon Bedrock、AgentCore(Runtime + Gateway)、 AWS Identity and Access Management (IAM)、CloudWatch、 AWS X-Ray, Amazon Elastic Container Registry(Amazon ECR), AWS CodeBuild、Amazon S3、 AWS Lambda,以及 AWS CloudFormation.
- 账户中可用的智能体模型(默认
us.anthropic.claude-haiku-4-5-20251001-v1:0). - 已启用 CloudWatch Transaction Search,因此 OTEL span 会落入 aws/spans,供第 5–7 层使用。
- Node.js 18+ 和 CDK CLI(
npm install -g aws-cdk),以及 Python 3.13+。 - 为 CDK 引导(cdk bootstrap)的账户和区域,每个账户/区域执行一次。
- 无需本地 Docker,智能体镜像由 CodeBuild(ARM64)构建。
一条命令
要部署该解决方案,请克隆仓库、创建虚拟环境、安装依赖,然后运行 cdk deploy --all在终端中运行以下命令:
git clone https://github.com/aws-samples/amazon-bedrock-samples.git
cd rag/managed-knowledge-bases/07-IaaC/managed-kb-observability-cdk/
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cdk bootstrap  # once per account/region
cdk deploy --all
前两条命令克隆示例并进入项目目录。接下来的两条命令创建并激活 Python 虚拟环境,并安装 CDK 应用的依赖项。 cdk bootstrap 为 CDK 准备好账户和区域(每个账户/区域只需执行一次),并且 cdk deploy --all 按 CDK 推导出的依赖顺序预置全部四个堆栈。
账户和区域来自你的 AWS 配置文件(CDK_DEFAULT_ACCOUNT / CDK_DEFAULT_REGION),因此应用无需任何修改即可部署。
区域可用性:托管知识库、智能体检索(AgenticRetrieveStream)和 Amazon Bedrock AgentCore(Runtime 和 Gateway)并非在所有 AWS 区域都可用。部署前,请确认目标区域提供所有这些服务,并相应地设置 ACCOUNT_REGION (每个账户/区域只需执行一次),并 config.py 相应地设置。默认值为 us-west-2。有关当前可用性,请参阅 Amazon Bedrock 以及 Amazon Bedrock AgentCore 文档以及 AWS 区域服务列表.
这个版本中没有部署脚本,而这正是关键所在: cdk deploy --all 会遍历它从其中推导出的依赖图, app.py按顺序部署四个堆栈,并自动传递每一个跨堆栈的值。终端会在每个堆栈完成时报告,先是 bmkb-obs-cdk-kb [1/4](默认的 PROJECT_NAME),然后是 gateway [2/4],接着是 agent [3/4],最后是 dashboards [4/4],而这个顺序是推导出来的,并非声明出来的:它源自堆栈之间的构造引用,因此新增一个消费现有输出的第五个堆栈会自动重新排列部署顺序。
Stack -agent 使用 CodeBuild 构建智能体容器,因此该阶段大约需要 8–10 分钟。其余三个堆栈很快完成。每个堆栈在完成时都会打印其输出,你可以从中获取知识库 ID、Gateway URL、运行时 ARN 以及两个仪表盘的 URL。部署完成后,全部四个堆栈均已完成。以下截图展示了成功部署后的 AWS CloudFormation 控制台。 cdk deploy --all.
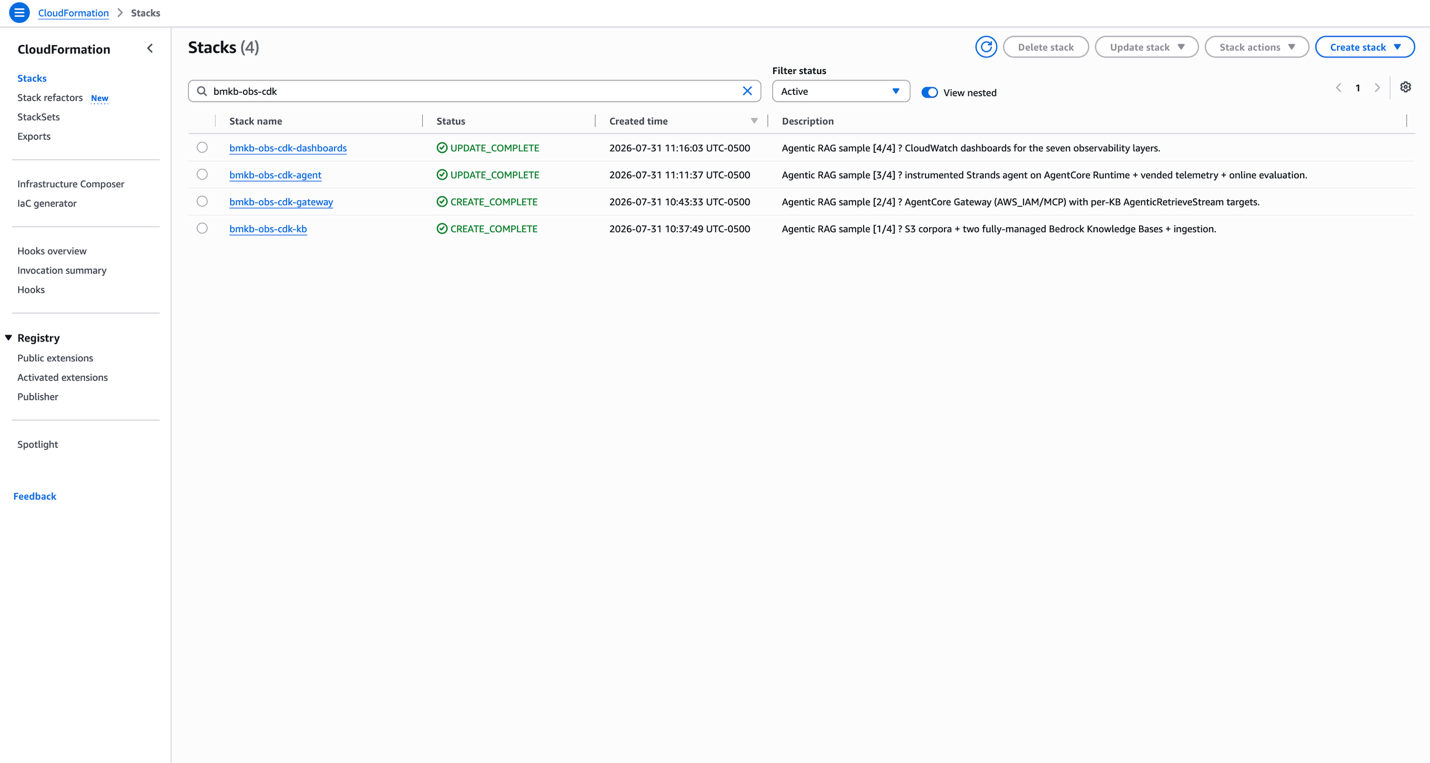
图 4:成功部署后的 AWS CloudFormation 控制台,四个堆栈均处于 CREATE_COMPLETE 状态
在控制台上,全部四个堆栈(kb、gateway、agent 和 dashboards)都报告 CREATE_COMPLETE,每个堆栈的描述中都显示了其在推导出的依赖顺序中的 [n/4] 位置。
关于长时间运行资源的说明
在这个解决方案中,有两件事的耗时远远超过 AWS Lambda 函数 15 分钟的上限,无法采用简单的轮询方式:知识库(KB)摄取同步和 CodeBuild 镜像构建。AWS CDK Provider 框架通过一个 on_event / is_complete 拆分,由一个处理程序启动工作,并轮询第二个处理程序,直到它报告完成。
cr.Provider(
    self, "IngestSyncProvider",
    on_event_handler=on_event,        # StartIngestionJob, return the job id
    is_complete_handler=is_complete,  # GetIngestionJob, report IsComplete
    query_interval=Duration.seconds(30),
    total_timeout=Duration.minutes(30),
)
没有任何阻塞,返回 CloudFormation 的响应协议由框架负责,而不是手写进每个处理程序中,并且 30 分钟预算是一个属性,而不是需要围绕它进行工程设计的东西。
启动并测试
打开 notebooks/01-drive-and-observe.ipynb 并从上到下运行(pip install -r requirements-notebook.txt (第一步)。它读取堆栈输出,然后向已部署的智能体发送针对特定主题的提示, 每个知识库一个会话因此你可以在同一处看到答案和语义路由:财务问题由 Octank 10-K 回答,天气问题由龙卷风报告回答,每个问题都会自动路由到匹配的 AgenticRetrieveStream 工具。
笔记本会从堆栈输出中发现所有内容,因此无需手动粘贴任何信息:
# Stack names are derived from the same PROJECT_NAME the CDK app uses, so renaming the
# project in config.py cannot leave this notebook pointing at stale stacks.
from config import EnvSettings

PROJECT = EnvSettings.PROJECT_NAME
STACKS = {suffix: f'{PROJECT}-{suffix}'
          for suffix in ('kb', 'gateway', 'agent', 'dashboards')}

def outputs(stack_name):
    s = cfn.describe_stacks(StackName=stack_name)['Stacks'][0]
    return {o['OutputKey']: o['OutputValue'] for o in s.get('Outputs', [])}
该笔记本导入的 与应用程序相同,因此两者对堆栈名称的认知永远不会出现分歧。驱动程序通过已部署的智能体发送按知识库划分的提示。财务问题会路由到财务知识库,天气问题会路由到天气知识库,每个问题都会得到有依据、带引用的答案。图 5:按知识库划分的提示被路由到匹配的知识库,每个都返回有依据、带引用的答案该笔记本还会根据智能体实际检索和引用的内容,计算无需参考的 Layer 3 检索质量信号,无需任何人工标注 config.py 该笔记本导入的堆栈名称与应用程序相同,因此两者对堆栈名称的认知永远不会出现分歧。
驱动程序通过已部署的智能体发送按知识库划分的提示。财务问题会路由到财务知识库,天气问题会路由到天气知识库,每个问题都会得到有依据、带引用的答案。
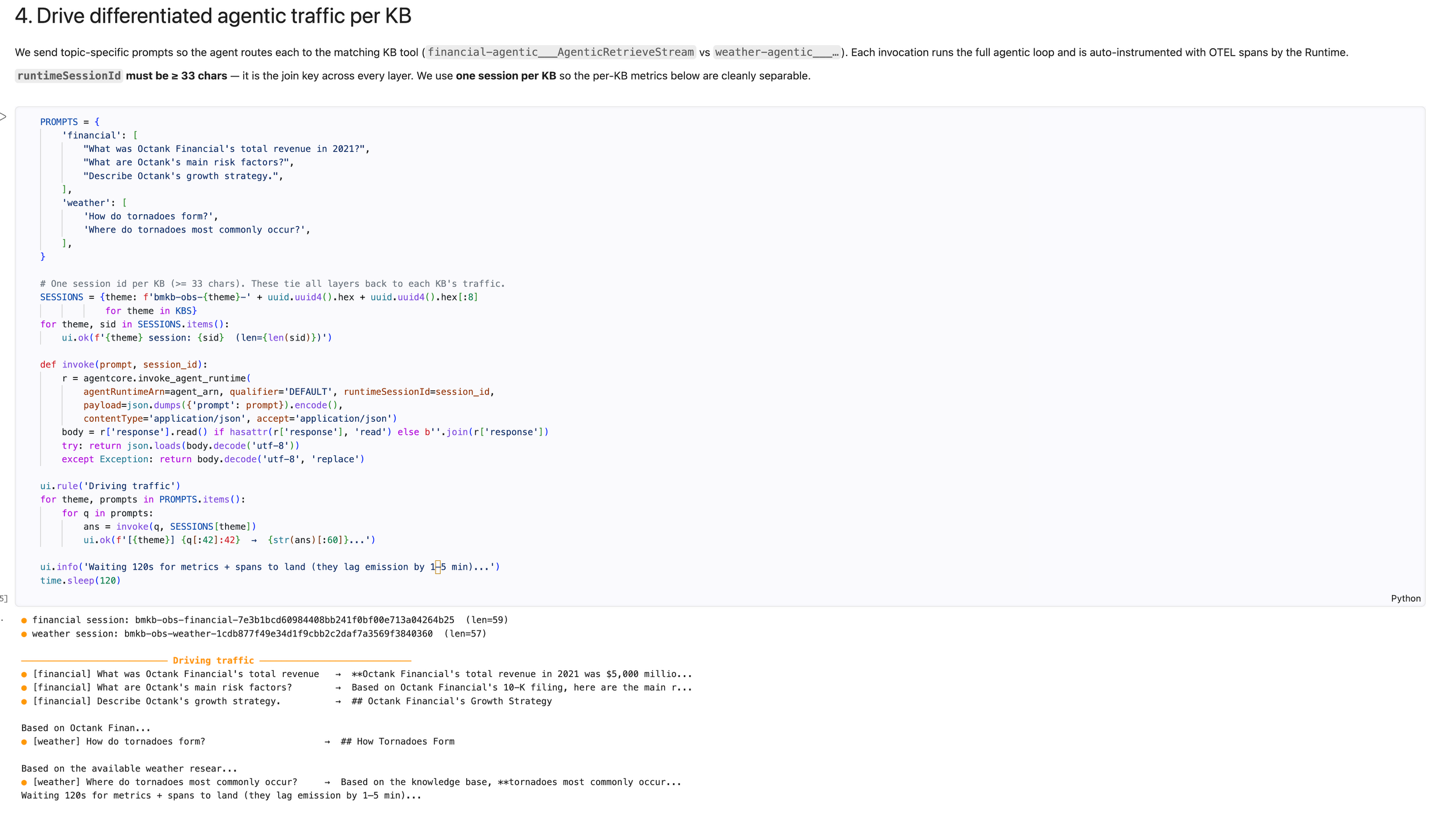
图 5:按知识库划分的提示被路由到匹配的知识库,每个都返回有依据、带引用的答案
该笔记本还会根据智能体实际检索和引用的内容,计算无需参考的 Layer 3 检索质量信号,无需任何人工标注,也无需额外的评判器,并将这些信号发布到 CloudWatch。
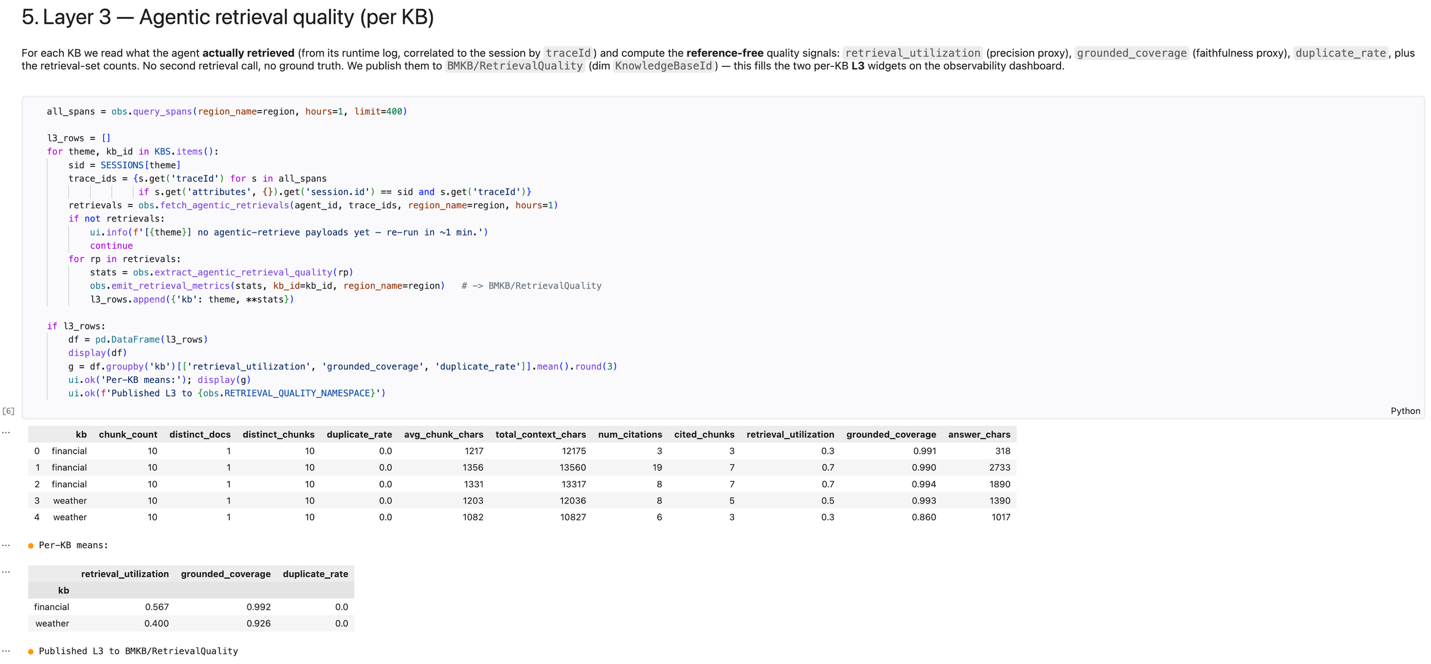
图 6:每个知识库的无参考 Layer 3 检索质量信号
观察:七层仪表盘
这两块仪表盘正是七层变得可见的地方。堆栈会创建这两块仪表盘,而驱动流量则会让它们填充数据。下面的截图展示了这两块仪表盘在 CloudWatch 控制台中的样子。
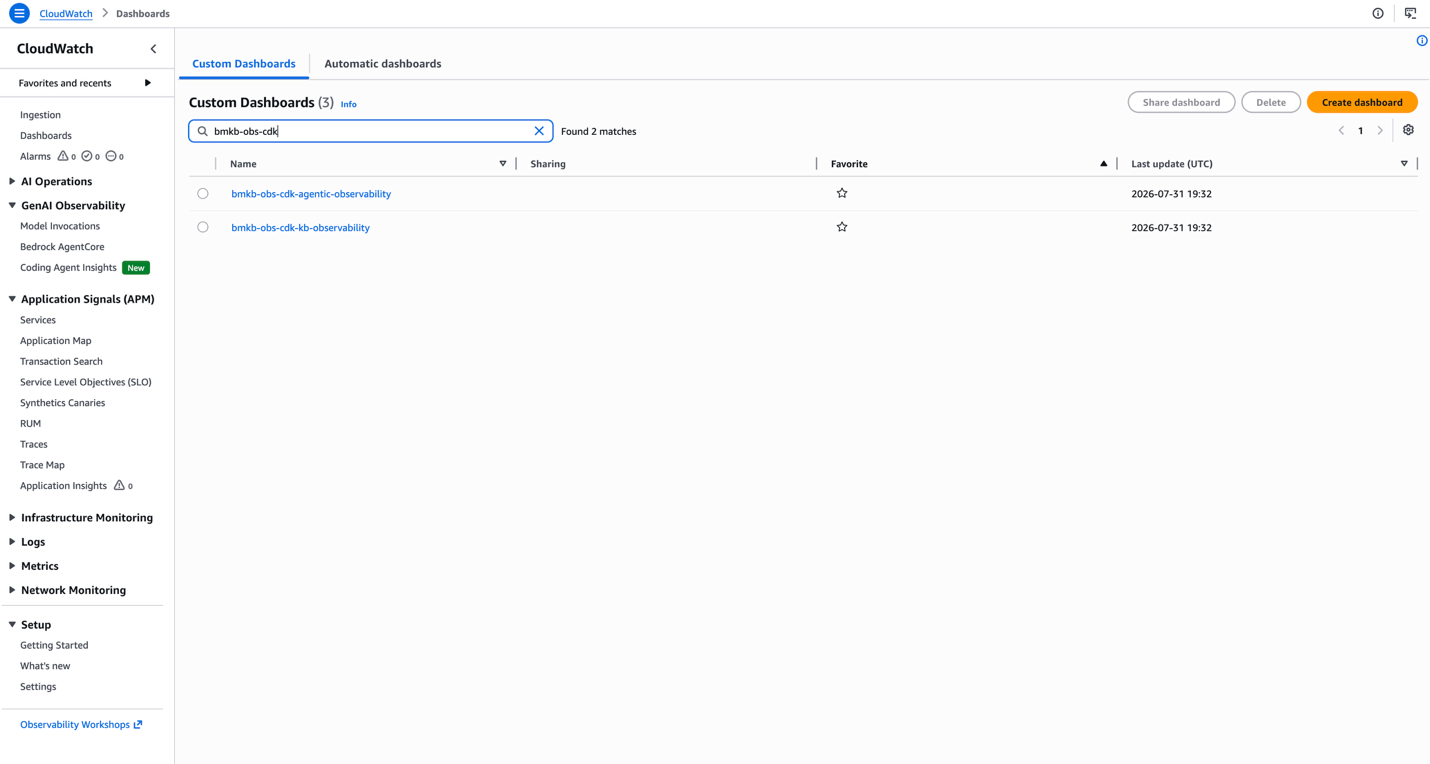
图 7:CloudWatch 控制台中的两块仪表盘:端到端智能体可观测性和按知识库可观测性
这两块仪表盘都会出现在 CloudWatch 控制台中:一块用于端到端智能体可观测性,另一块用于按知识库可观测性(BMKB,Bedrock Managed Knowledge Base)。本节其余部分将逐一介绍每一层所展示的内容。
在这个版本中,仪表盘由类型化对象构建,而不是由 JSON 字符串构建。指标是 Metric,小部件是 GraphWidget,布局是 Row 的列表:
cw.GraphWidget(
    title="L4 — Gateway metrics (MCP)",
    width=12, height=6, period=PERIOD, statistic="Sum",
    left=[
        self._gateway_metric("Invocations", gateway_arn, "tools/call Invocations"),
        self._gateway_metric("SystemErrors", gateway_arn, "SystemErrors"),
        self._gateway_metric("UserErrors", gateway_arn, "UserErrors"),
        self._gateway_metric("Throttles", gateway_arn, "Throttles"),
    ],
)
实际好处并不是代码行数更少, dashboards_stack.py 代码约 400 行,比等效的 DashboardBody JSON 更多。真正的优势在于:拼错的属性或无效的小部件组合会在你的笔记本电脑上约一秒内失败。而同样的错误放在 DashboardBody 字符串里却能成功部署,并在 AWS 管理控制台上渲染成一个损坏的小部件,你只能靠肉眼去发现它。由于 Row 接受任何小部件,文档就成了布局的一部分,而不是一个会逐渐过时的 wiki 页面。每块仪表盘都将 TextWidget 与图表交错排列:_l3_explainer() 返回一个 markdown 表格,定义每个比率以及如何解读它,因此解释 grounded_coverage 的小部件与 cdk synth在你的笔记本电脑上,大约一秒内就会失败。而同样的错误放在 DashboardBody 字符串里却能成功部署,并在 AWS 管理控制台上渲染成一个损坏的小部件,你只能靠肉眼去发现它。
由于 Row 可以接受任何小部件,文档便成为布局的一部分,而不是一个会逐渐过时的 wiki 页面。每块仪表盘都将 TextWidget 与图表交错排列:
[cw.TextWidget(width=24, height=7, markdown=self._l3_explainer())],
[
    self._quality_widget("L3 · Financial KB — agentic quality (reference-free, 0–1)", fin_id),
    self._quality_widget("L3 · Weather KB — agentic quality (reference-free, 0–1)", wx_id),
],
_l3_explainer() 返回一个 markdown 表格,定义每个比率以及如何解读它,因此解释 grounded_coverage 的小部件与绘制它的小部件在同一个提交中发布,而冷启动打开仪表盘的读者也无需猜测什么是无参考指标。
仪表盘 A — 智能体可观测性(端到端)。 仪表盘开头先给出一个说明,解释每一层各自统计的是不同的东西(对于 查询,你会看到约 N 次智能体调用、约 2N 次检索、约 3N 次 LLM 调用,以及约 5N 次 Gateway MCP 操作,智能体循环由此变得可见),随后展示知识库指标(L1)、Gateway 指标与延迟(L4)、token 用量(L6),并且由于智能体使用 AgenticRetrieveStream,它返回的是经过综合、带引用的答案,而不是逐块分数,因此还会展示无参考的第 3 层质量信号,这些信号在仪表盘内联定义并按知识库绘制。在仪表盘 A 上,第 3 层的无参考质量信号按知识库绘制。 查询,你会看到约次智能体调用、约 2N 次检索、约 3N 次 LLM 调用,以及约 5N 次 Gateway MCP 操作,智能体循环由此变得可见),随后展示知识库指标(L1)、Gateway 指标与延迟(L4)、token 用量(L6),并且由于智能体使用 AgenticRetrieveStream,它返回的是经过综合、带引用的答案,而不是逐块分数,因此还会展示无参考的第 3 层质量信号,这些信号在仪表盘内联定义并按知识库绘制。在仪表盘 A 上,第 3 层的无参考质量信号按知识库绘制。首先,fin 次智能体调用、约 2次检索、约 3N 次 LLM 调用,以及约 5N 次 Gateway MCP 操作,智能体循环由此变得可见),随后展示知识库指标(L1)、Gateway 指标与延迟(L4)、token 用量(L6),并且由于智能体使用 AgenticRetrieveStream,它返回的是经过综合、带引用的答案,而不是逐块分数,因此还会展示无参考的第 3 层质量信号,这些信号在仪表盘内联定义并按知识库绘制。在仪表盘 A 上,第 3 层的无参考质量信号按知识库绘制。首先是财务知识库。以下 次检索、约 3N 次 LLM 调用,以及约 5这些图表:_l3_explainer() 返回一个 markdown 表格,定义每个比率以及如何解读它,因此解释 grounded_coverage 的组件与绘制它的组件在同一个提交中发布,冷启动打开仪表盘的读者也无需猜测什么是无参考指标。仪表盘 A——智能体可观测性(端到端)。该面板首先解释每一层如何统计不同的对象(对于 N 次查询,你会看到约 N 次智能体调用、约 2N 次检索、约 3N 次 LLM 调用,以及约 5 Gateway MCP 操作,智能体循环由此变得可见),随后展示知识库指标(L1)、Gateway 指标与延迟(L4)、token 用量(L6),并且由于智能体使用 AgenticRetrieveStream,它返回的是经过综合、带引用的答案,而不是逐块分数,因此还会展示无参考的第 3 层质量信号,这些信号在仪表盘内联定义并按知识库绘制。
在仪表盘 A 上,第 3 层的无参考质量信号按知识库绘制。首先是财务知识库。下图绘制了它的 retrieval_utilization、grounded_coverage 和 duplicate_rate。
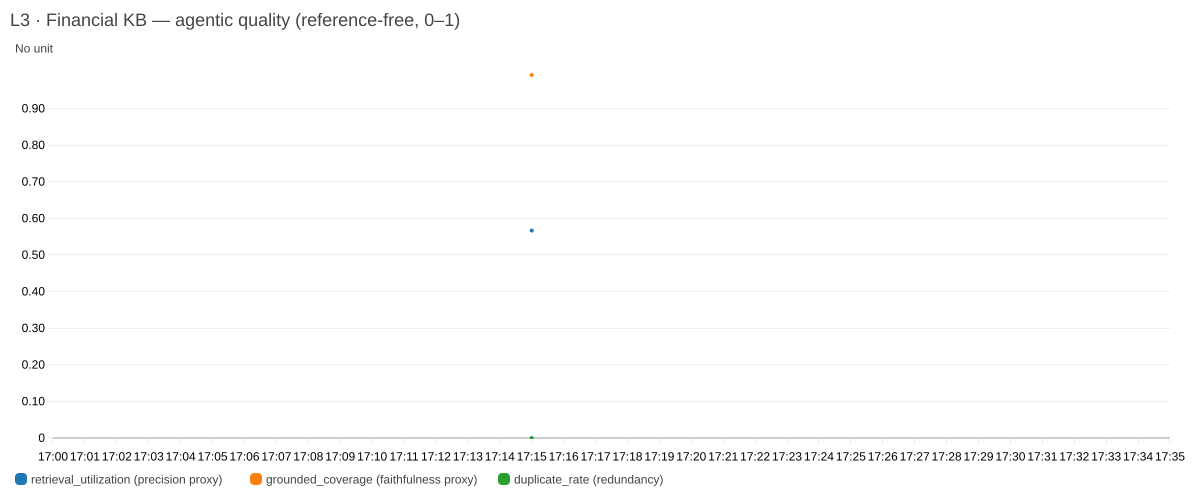
图 8:财务知识库第 3 层质量,绘制检索利用率、有依据覆盖率和重复率
天气知识库显示出同样的三个信号,它们被分别跟踪,因此这两个领域绝不会模糊成一个数字。
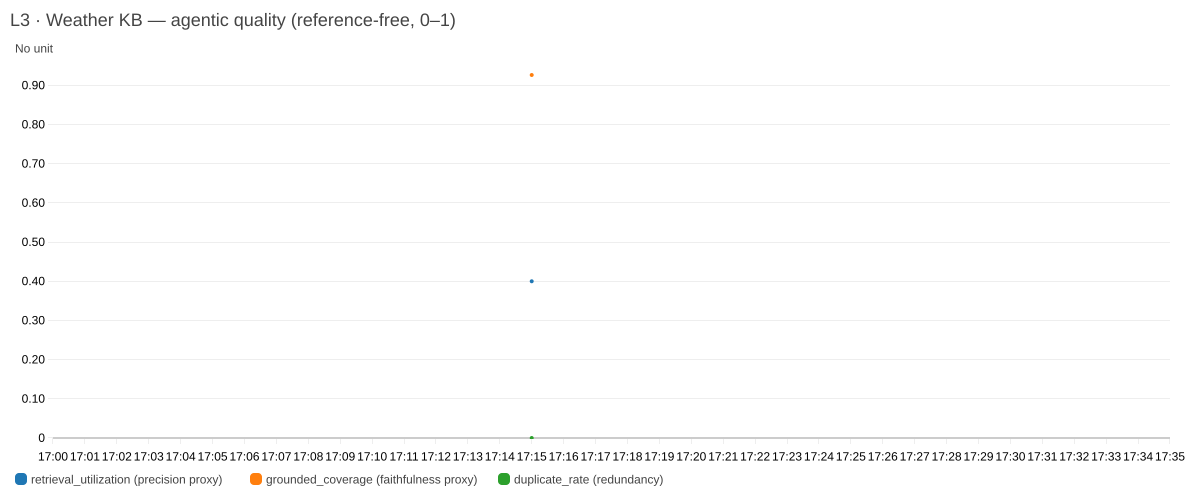
图 9:天气知识库第 3 层质量,与财务知识库分开跟踪
这两张图表分别绘制了财务知识库(左)和天气知识库(右)的 retrieval_utilization、grounded_coverage 和 duplicate_rate,因此每个知识库的检索质量保持可区分,而不会被平均成一个数字。
仪表盘 B——按知识库(BMKB)的可观测性。 同样决定开销的运营信号(按知识库计):索引大小(来自 S3 源字节)、检索量、智能体工具调用、会话 token 用量,以及按模型划分的生成 token 用量,每项都附有内联说明。
以下截图展示了仪表盘 B 的四个指标小组件,它们在一次运行后填充了数据。第一个小组件报告索引大小,该大小根据每个知识库的 S3 源字节数得出。
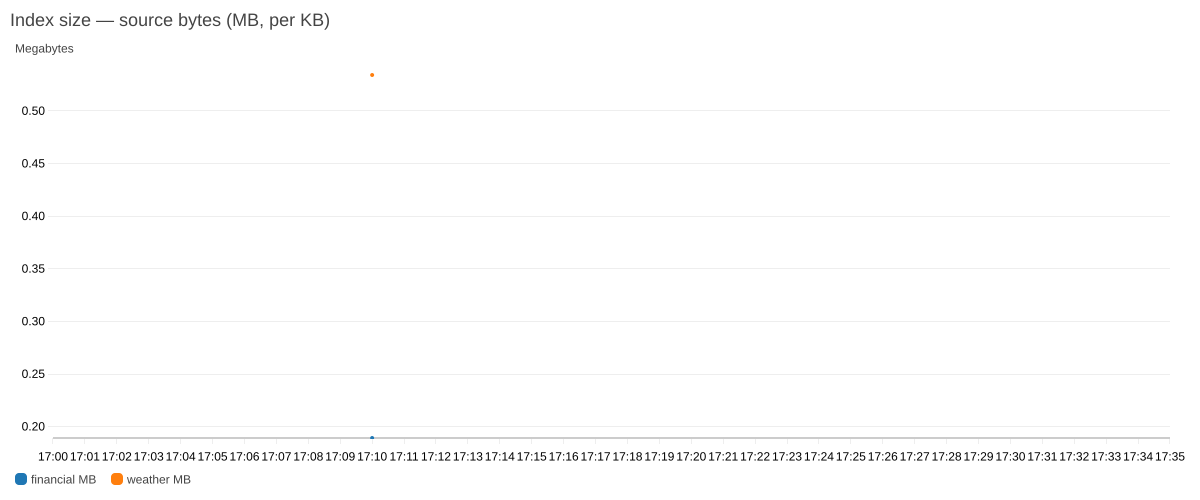
图 10:仪表盘 B 中各知识库的索引大小,由 Amazon S3 源字节数得出
第二个小组件统计每个知识库的检索调用次数。
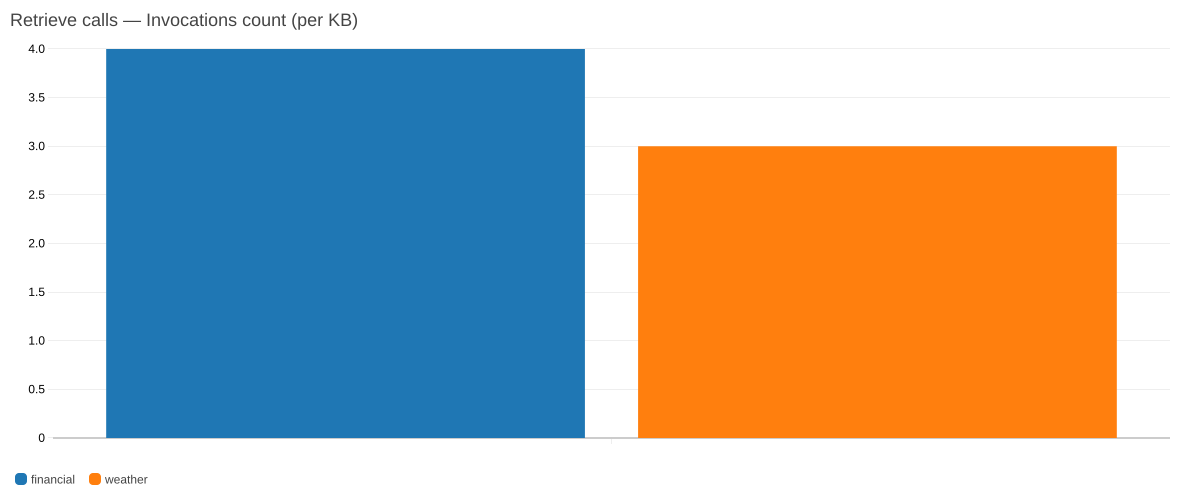
图 11:仪表盘 B 中各知识库的检索调用次数
第三个小组件统计通过 Gateway 进行的智能体工具调用次数。该指标由两个知识库共享,而非分别拆分统计。
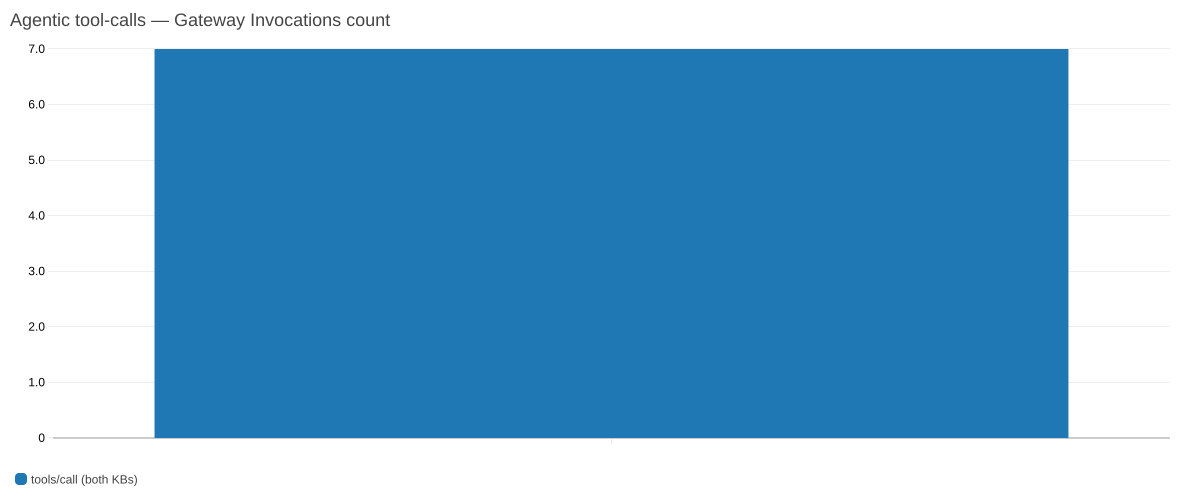
图 12:仪表盘 B 中通过 AgentCore Gateway 进行的智能体工具调用次数,由两个知识库共享
第四个小组件报告每个知识库的会话 token 用量。
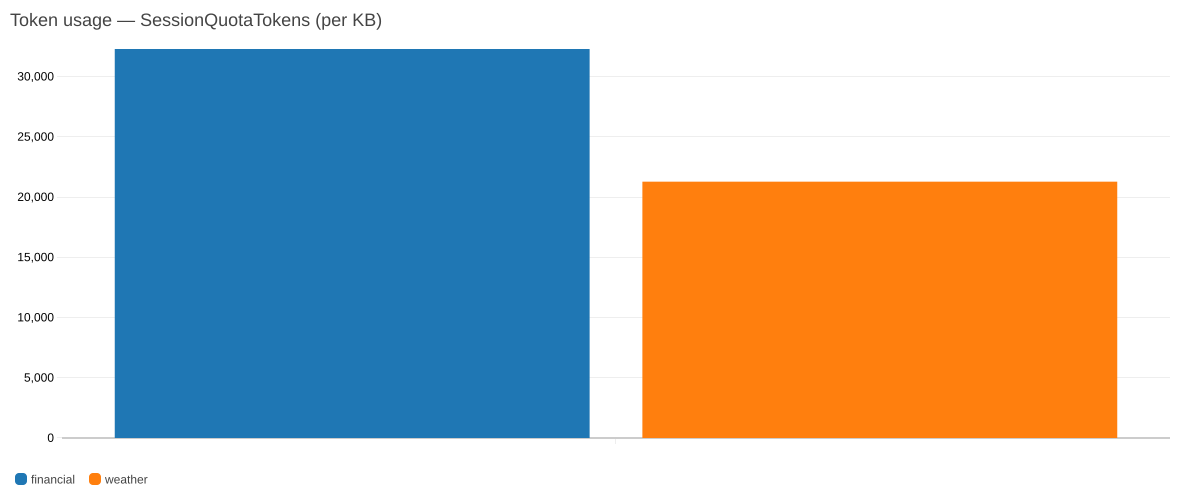
图 13:仪表盘 B 中各知识库的会话 token 用量
这四个小组件分别显示索引大小(来自 S3 源字节)、检索调用量、通过 Gateway 进行的智能体工具调用次数,以及会话 token 用量。除 Gateway 工具调用次数由两个知识库共享外,其余各项均按知识库分别列出。
有一个维度细节值得特别指出,因为类型化 API 不会替你捕捉到它: AWS/Bedrock/KnowledgeBases 命名空间期望一个带前缀的 id, knowledge-base/<id>而方案自身的 BMKB/* 命名空间使用裸 id。就 CDK 而言,两者都只是字符串。
# L1 — AWS/Bedrock/KnowledgeBases wants the prefixed form.
dimensions_map={"Operation": "Retrieve", "KnowledgeBaseId": f"knowledge-base/{kb_id}"}

# BMKB/* — our own namespaces use the bare id.
dimensions_map={"KnowledgeBaseId": kb_id}
第 5 层:span 树
第 5 层是 aws/spans 中的原始 OTEL span 树,这一层直接展示了智能体循环。它值得仔细阅读,因为嵌套关系并不直观:一次 LLM 调用会产生三个 span。Strands invoke_agent span 包裹该轮次,一个内部 chat span 包裹模型调用,而一个 chat <model> 才是实际调用,三者重复相同的 token 属性。 CLIENT 才是实际调用,三者重复相同的 gen_ai.usage.* token 属性。以下截图展示了 aws/spans 中的 span 树,前三行可以看到三层 span 的嵌套。图 14:aws/spans 中的第 5 层 span 树,展示单次 LLM 调用的三层 span 嵌套。阅读前三行:一个 invoke_agent Strands Agents 聚合 span,然后是一个内部 chat span,接着是一个 CLIENT chat span,三者报告的输入 token 均为 7,299、输出 token 均为 268。这就是同一次 LLM 调用在树的三个层级上出现,因此聚合时需要格外小心。该结构
以下截图展示了 aws/spans 中的 span 树,前三行可以看到三层 span 的嵌套。
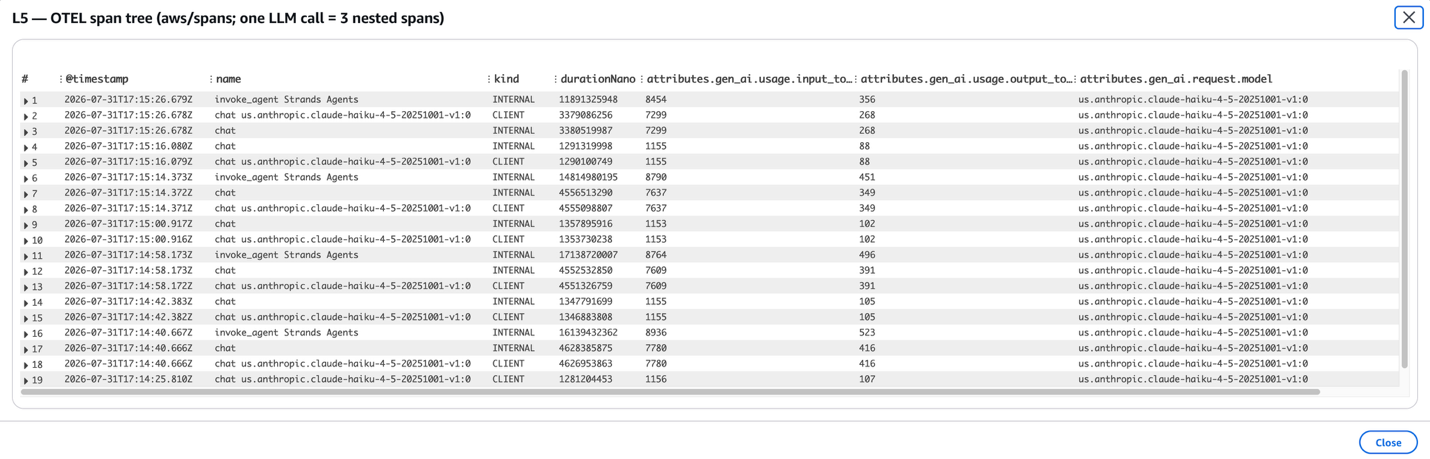
图 14:aws/spans 中的第 5 层 span 树,展示单次 LLM 调用的三层 span 嵌套
阅读前三行:一个 invoke_agent Strands Agents 聚合 span,然后是一个内部 chat span,接着是一个 CLIENT chat span,三者报告的输入 token 均为 7,299、输出 token 均为 268。这就是同一次 LLM 调用在树的三个层级上出现,因此聚合时需要格外小心。
这种结构在你进行聚合的那一刻就变得很重要。为了将每次 LLM 调用只计数一次,请筛选到 CLIENT CLIENT 叶子 span。
fields attributes.gen_ai.request.model as model,
       attributes.gen_ai.usage.input_tokens as in_tok,
       attributes.gen_ai.usage.output_tokens as out_tok
| filter ispresent(in_tok) and kind = 'CLIENT' and name like /^chat /
| stats sum(in_tok) as input_tokens, sum(out_tok) as output_tokens,
        count(*) as llm_calls by model
如果没有该过滤器,同一查询报告的 token 数量和调用次数都会是原来的三倍。
应用该 CLIENT 叶子 span 过滤器后,以下截图展示了按模型统计的生成 token 用量,其中每次 LLM 调用只计数一次。
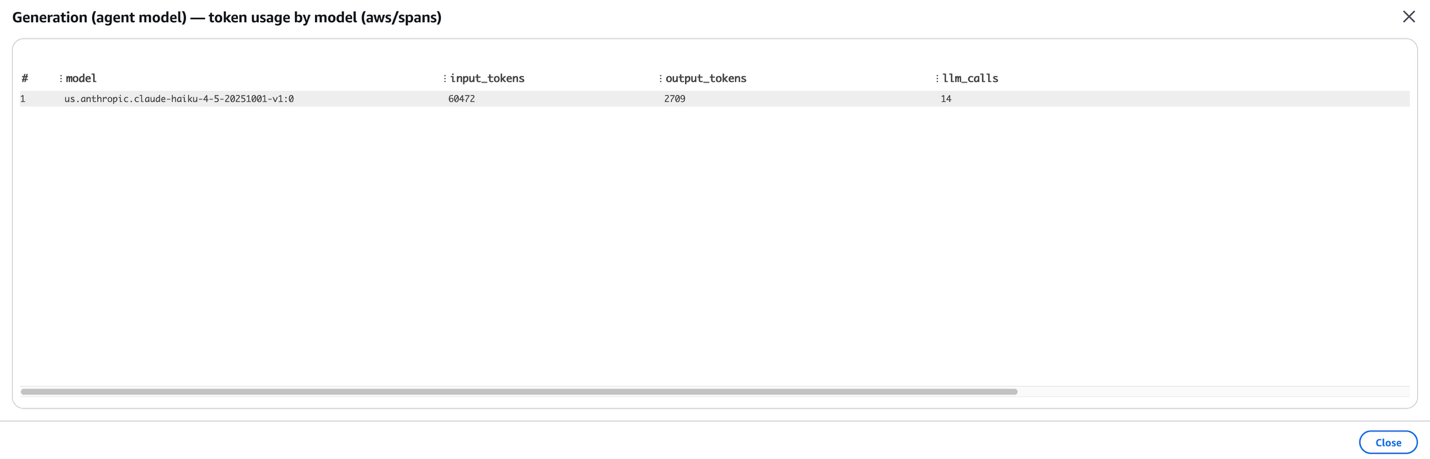
图 15:按模型统计的生成 token 用量,每次 LLM 调用只计数一次
应用该过滤器后,本次运行显示 14 次 LLM 调用,总计 60,472 个输入 token 和 2,709 个输出 token。如果不使用该过滤器,同一查询报告的调用次数和 token 数量都会是原来的三倍。
评估:按需与持续
质量通过两种方式进行衡量,而这两种方式都由该应用提供。
按需: 驱动笔记本调用 AgentCore。此版本中没有部署脚本,而这正是关键所在:(LLM-as-judge)针对每个会话的 span 运行内置评估器——Correctness、Faithfulness、Tool-Selection Accuracy——并将分数发布到 CloudWatch,在 Dashboard A 上作为第 7 层显示。
以下截图展示了 Dashboard A 上的第 7 层:每个知识库的按需评估分数,以及同一仪表盘上的第 5 层 OTEL span 表。
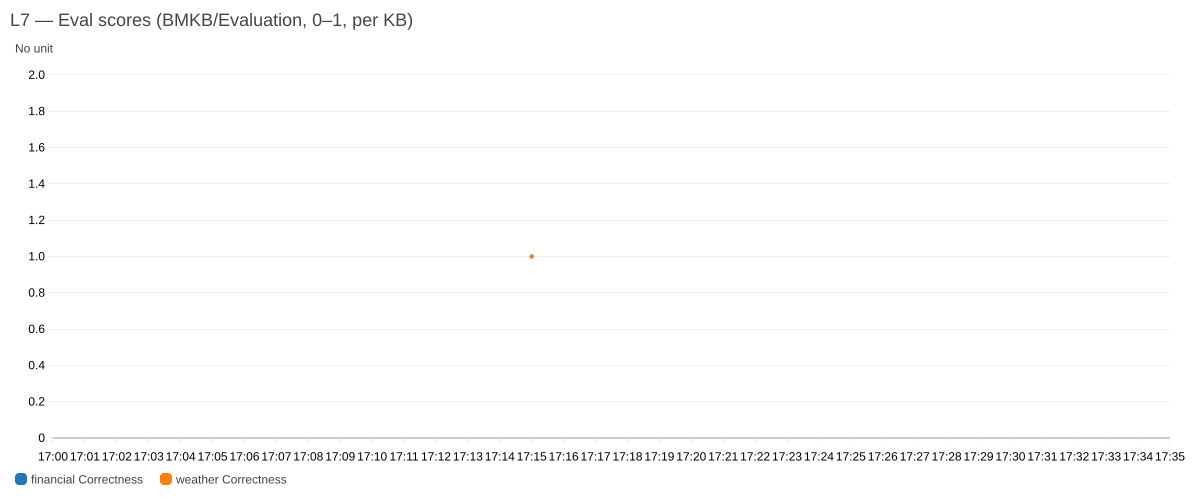
图 16:各知识库的第 7 层按需评估分数,旁边是第 5 层 span 表
第 7 层显示每个知识库的按需评估分数,旁边是第 5 层 OTEL span 表,因此分数与产生这些分数的 span 可以在同一块看板上一起阅读。
持续(在线): 该智能体栈还预置了一个 AWS::BedrockAgentCore::OnlineEvaluationConfig 该功能会对实时会话进行采样并自动评分,无需运行笔记本。配置本身可在 Bedrock AgentCore 控制台中的“评估”→“评估配置”页面。结果会写入日志组 /aws/bedrock-agentcore/evaluations/results/<config-id>,并且每个分数也会作为 CloudWatch 指标发布到 Bedrock-AgentCore/Evaluations 命名空间,以评估器名称和配置 ID 为键,这样你就可以绘制分数图表或对其设置告警,而无需解析日志。
以下截图展示了 AgentCore 控制台中“评估”→“评估配置”页面下的在线评估配置。
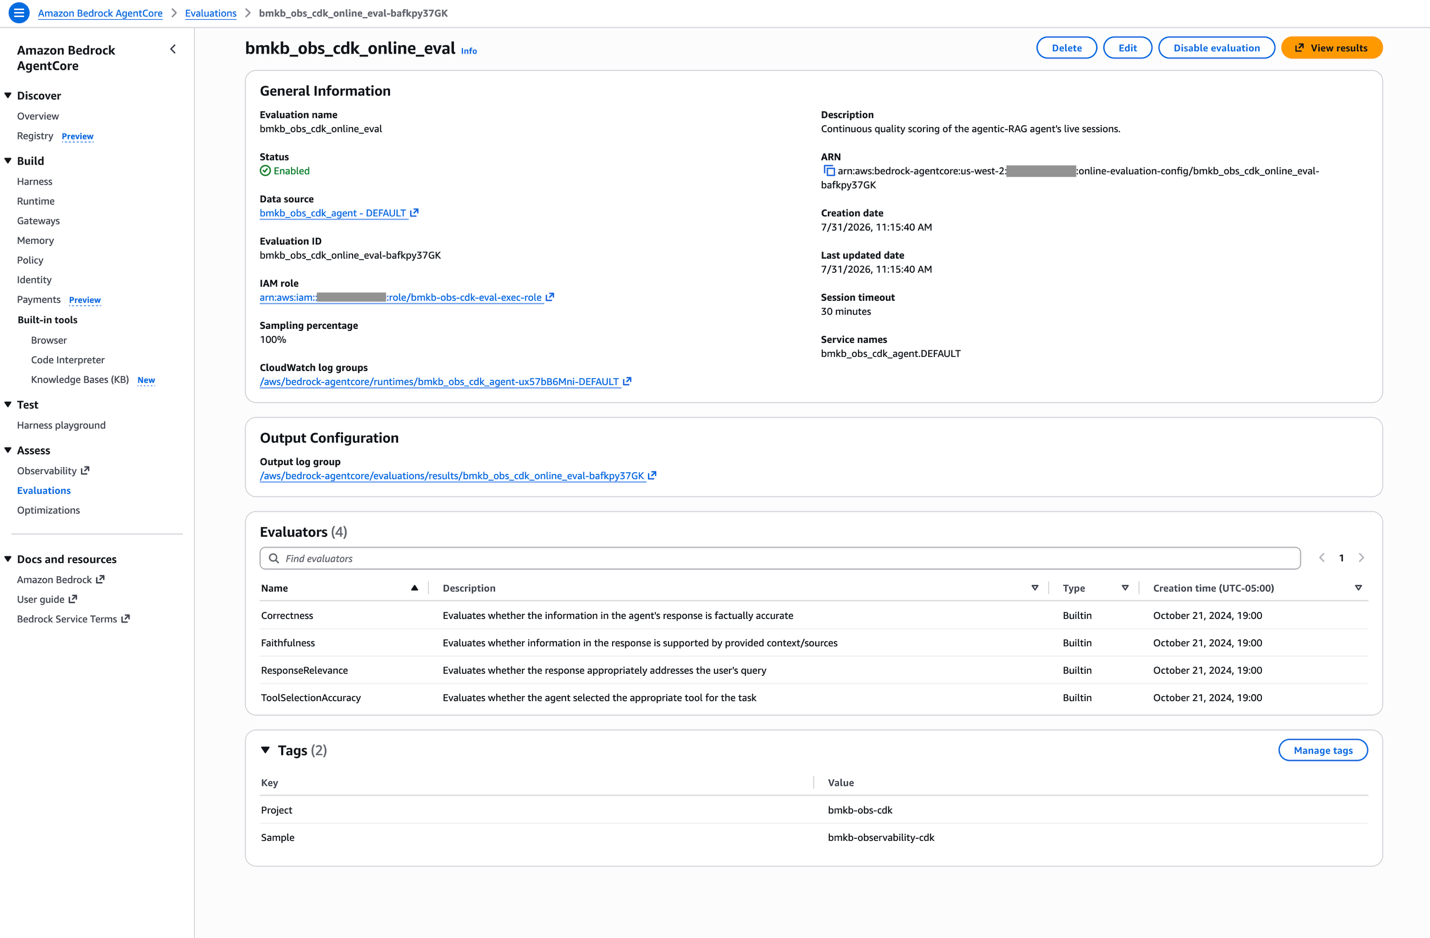
图 17:AgentCore 控制台中的在线评估配置,包含四个内置评估器,采样率为 100%
该配置列出了四个内置评估器:工具选择准确率、忠实度、正确性和响应相关性,均设置为 100% 采样,并显示为 ACTIVE 且已启用。
由于这些分数是普通的 CloudWatch 指标,它们可以像其他任何指标一样绘制图表,无需解析日志,而且同一个小组件还可以承载告警。以下截图展示了这四个评估器分数以普通 CloudWatch 指标的形式绘制的图表。
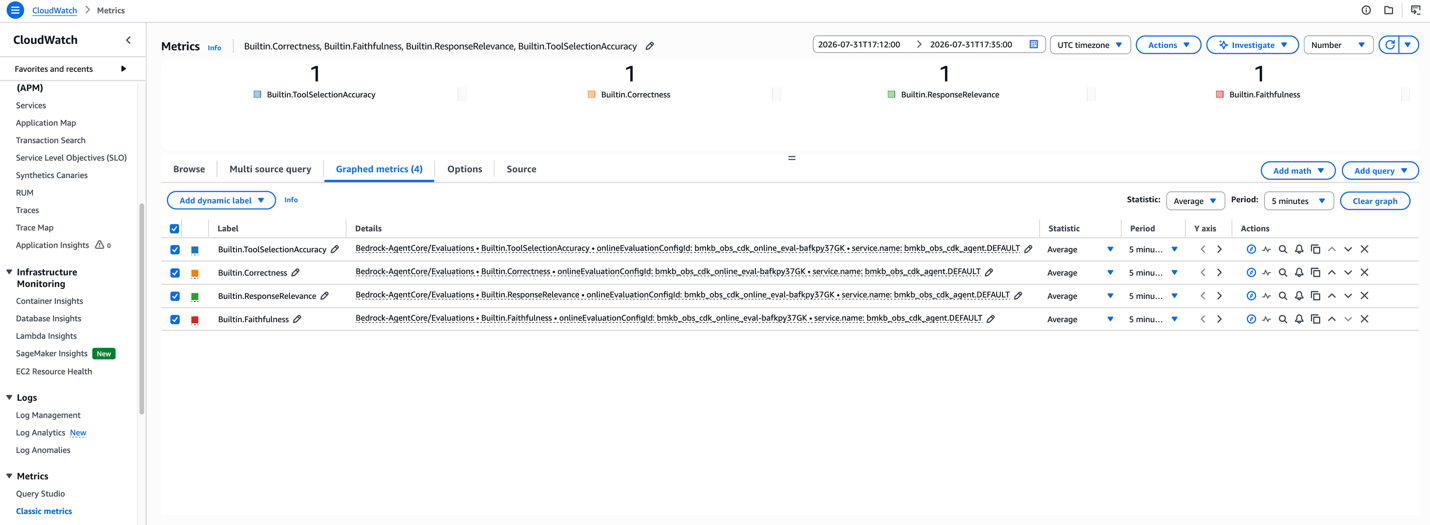
图 18:四个连续评估器分数以普通 CloudWatch 指标形式绘制的图表
这四个评估器分数作为指标显示在 Bedrock-AgentCore/Evaluations 命名空间中,每个指标以评估配置 ID 和智能体的服务名称为键,因此你可以直接绘制图表或对其设置告警,而无需解析日志。
在线结果只有在会话关闭后才会到达。评分在会话完成后运行,因此在您驱动流量后的大约会话空闲超时时间(约 30 分钟)内,结果日志组会保持为空。运行结束后日志组为空是预期现象,并非配置错误。每个结果事件都携带 session.id,因此它会连接到其他所有层。笔记本中的按需路径没有这种等待,这就是两者都保留在这里的原因。
在本次运行的四个内置评估器中,连续路径在正确性、忠实度、响应相关性和工具选择准确率上均获得 1.00 分,每个评估器各评分五条追踪记录,每条结果都附带书面说明。
⚠️ 采样与成本。 此应用将 SAMPLING_PERCENTAGE = 100 纯粹为了博客实验,因此每个会话都会被评分,结果立即可见。 这不是生产环境建议。 在线评估会针对每个采样会话调用一次 LLM-as-judge,因此成本会随采样率和流量规模而变化。对于真实部署,请选择符合你的质量监控需求和预算的采样百分比,并在启用前使该配置与你组织自身的政策和成本治理要求保持一致。该比率是一个单一常量, EvalConfig.SAMPLING_PERCENTAGE,位于 config.py.
清理
完成后,请删除该解决方案,以免继续产生费用,因为存储的 KB 数据、ECR 中的智能体镜像以及仍在运行的在线评估在堆栈闲置期间都会产生费用。一条命令即可拆除所有内容:
cdk destroy --allCDK 会自行按反向依赖顺序删除堆栈:先是仪表盘,然后是智能体,接着是网关,最后是知识库——也就是它部署时推导出的同一张依赖图,反向走一遍。不存在需要与部署脚本保持一致的拆除脚本,这正是只对依赖关系建模一次所带来的较为隐性却宝贵的特性之一。
有两种删除行为值得了解,因为它们都能替代手写的清理代码:
self.source_bucket = s3.Bucket(
    self, "SourceBucket",
    removal_policy=RemovalPolicy.DESTROY,
    auto_delete_objects=True,  # replaces a list_object_versions delete loop
)

self.repository = ecr.Repository(
    self, "AgentImageRepo",
    removal_policy=RemovalPolicy.DESTROY,
    empty_on_delete=True,  # replaces an image-delete loop
)
两者都设置为样本卫生,对于任何你关心的内容,请将存储桶切换为“。 RemovalPolicy.RETAIN.
CDK 引导堆栈(CDKToolkit)及其暂存存储桶不会被删除。它们是账户级共享基础设施,其他 CDK 应用可能依赖它们。
自单次解决方案以来发生了哪些变化
这篇博文和 2024 解决方案 是使用 Python 编写的 CDK 应用程序,通过 cdk deploy这里的创作工具是常量,发生变化的是其底层架构,而大部分变化是减法:
| 关注 | 2024:单次 RAG | 该解决方案 |
| 向量存储 | 你预置、扩展并为其支付 OCU 费用的 OpenSearch Serverless 集合与索引 | 无。类型:MANAGED,Amazon Bedrock 负责存储和索引 |
| 索引生命周期 | 自定义资源会创建索引,并等待该索引变为可搜索状态 | 无需创建 |
| 嵌入模型 | 你选择它并授予模型访问权限 | 默认由服务托管 |
| Stacks | 3:知识库角色 → OpenSearch 基础设施 → 知识库 + 数据源 | 4:知识库 → 网关 → 智能体 → 仪表盘 |
| 检索 | 一次检索,按向量相似度返回前 k 个分块 | AgenticRetrieveStream 在内部完成重排后,返回一个经过综合、带有引用的答案 |
| 选择知识库 | 不适用,只有一个索引 | 该智能体在语义上跨两个 |
| 再看一下语料库 | 无法一次性完成 | 智能体在回答前会再次检索 |
| 遥测 | 未配置 | 七层,两块仪表盘 |
| 评估 | 手动操作:同步、选择模型、提问 | 按需与持续,两种均已预置 |
| 空闲时的成本下限 | 无论你是否查询,OCU 费用都会累积 | 仅存储 |
这种取舍在两个方向上都是真实存在的。用单一索引回答单次提问,每次查询成本更低、推理更简单,而且当一个语料库就足以给出答案时完全够用。当情况并非如此时,就该采用这种设计。
承担主要工作的 CDK 构造
在这个应用中,四个构造承担了大部分工作,它们值得被点名,因为每一个都替代了人们原本需要手写的东西:
- Provider —— 适用于生命周期超过 AWS Lambda 函数 15 分钟上限的自定义资源。
on_event/is_complete拆分意味着在轮询循环中没有任何休眠,而返回 CloudFormation 的响应协议是框架的职责,而不是某个内置的urllib每个处理程序中的回调。 - BucketDeployment – 上传语料库,因此摄取自定义资源只负责摄取。
- auto_delete_objects=True 以及 auto_delete_objects=True 和,取代了手写的
list_object_versions以及镜像删除循环,否则堆栈根本无法被销毁。 - repository.grant_pull_push(project) – 八项一行
ecr:*CodeBuild 所需的操作,在构造时即已正确拼写。
以及类型化仪表盘,来自 Observe 部分:使用 Metric / GraphWidget / Row 对象,而不是 DashboardBody JSON 字符串,这会将无效的 widget 组合从“在控制台上渲染出错”转变为“在 cdk synth.”
有两件事是 CDK 不会改变的,而且这两件事都值得你在开始之前了解:
- 。它们会被原样传递,因此 AWS CDK 的 snake_case 到 PascalCase 转换不会在它们内部生效。像 和 这样的键必须完全按照 API 期望的方式拼写,否则在资源失败之前不会有任何提示。字符串类型的值仍然是字符串。Observe 部分中 与裸 的维度差异对类型系统来说是不可见的。类型化构造检查的是结构,而不是语义。这两者都不是偏好某一种工具而非另一种的理由。它们是的边界.
connector_parameters以及parameter_values它们会被原样传递,因此 AWS CDK 的 snake_case 到 PascalCase 转换不会在它们内部生效。像bucketName以及inclusionPrefixes必须完全按照 API 期望的方式拼写,否则在资源失败之前不会有任何提示。 - 字符串类型的值仍然是字符串。 而
knowledge-base/<id>与裸<id>的维度差异对类型系统来说是不可见的。类型化构造检查的是 结构,而不是 语义.
这两者都不是偏好某一种工具而非另一种的理由。它们界定了“类型化”能为你带来什么,而了解这条边界在哪里,正是让 CDK 令人愉快而非令人意外的关键所在。
结论
我们在托管 Amazon Bedrock Knowledge Base 和 AgentCore 上构建了一套完整的企业级智能体检索解决方案:多知识库语义路由、一个推理智能体、七层可观测性,以及按需评估和持续评估,并将这一切作为单个 AWS CDK 应用程序部署。
有两点值得记住。托管知识库做的是移除基础设施,而不是增加基础设施:无需预置向量存储,无需创建索引并等待其完成,也不会在系统闲置时产生 OCU 计费项。它也是支持智能体检索和 AgentCore Gateway 连接器的知识库类型,如 Amazon Bedrock 文档而一旦检索变为智能体式,可观测性就不再是可选项。这个应用所预置的资源中,大约有一半的存在意义就是回答智能体实际做了什么、以及答案到底好不好,而在智能体式系统中,这并不算额外开销。正是这一部分让系统变得可运维。
CDK 编写模型在接缝处赢得了自己的位置。在这个架构中,有七个值跨越堆栈边界,而每一个都是构造引用,而不是导出/导入对,这也正是为什么没有部署脚本、没有拆除脚本,也没有需要记住的固定顺序。
从这里,你可以将数据源指向自己的语料库,将智能体部署到虚拟私有云(VPC)中,根据预算和策略调整在线评估的采样率,或者向路由器添加更多知识库。要了解更多信息,请参阅 Amazon Bedrock 详情页面以及 Amazon Bedrock 文档该应用、驱动程序笔记本以及自包含实用工具都位于 配套的 GitHub 仓库,因此你可以克隆它,并用一条命令部署你自己的副本。