- 1. CP × HiCache:基于页的 KV 分片
- 1.1 逻辑基数树与页归属
- 1.2 读取分片 KV:逐层收集
- 1.3 HiCache 集成:先恢复每个分片再收集
- 1.4 性能实践
- 2. PP × HiCache:在各阶段间保持缓存操作一致
- 2.1 主机缓存:协调异步传输
- 2.2 外部存储:就缓存前缀达成一致
- 3. 投机解码 × HiCache
- 4. 统一 KV 缓存布局:在兼容拓扑间复用
- 5. P/D × HiCache:解码侧前缀复用
- 结语视角
- 使用 rank_consensus_checker 进行调试
- 致谢
智能体工作负载会反复向模型发送冗长且基本不变的历史记录。基数缓存复用 GPU 内存中的前缀 KV,而 HiCache 将这种复用扩展到主机内存和外部存储。在生产环境中,这还必须与并行、投机解码以及预填充-解码分离协同工作。这要求各 rank 之间做出一致的缓存决策、恢复草稿状态,并协调本地缓存复用与远程 KV 传输。
本文解释 HiCache 如何处理这些需求:
- 上下文并行(CP):在所有者 rank 上存储和恢复 KV 页的同时,保留共享的逻辑前缀。
- 流水线并行(PP):在异步传输独立完成的过程中,保持各阶段缓存决策一致。
- 投机解码:在恢复目标缓存的同时,恢复草稿模型所需的状态。
- 统一 KV 布局:在兼容的并行配置之间共享已存储的 KV。
- 预填充-解码分离(P/D):复用解码侧前缀,使预填充仅传输缺失的 KV。
- 调试:使用
rank_consensus_checker定位各 rank 之间不一致的缓存决策。
在生产服务中,讯飞星辰 MaaS 团队结合流水线并行、预填充-解码分离和 MTP 来服务 GLM-5.1/5.2 CodingPlan 工作负载。请求通常包含 3 万到 20 万输入 token,部分可达 100 万。没有 HiCache 时,该部署的缓存命中率约为 30%,用户面临漫长的响应等待。该团队报告称,加入 HiCache 与外部存储后,命中率提升至 95%,中位 TTFT 降至 3 秒以内。
1. CP × HiCache:基于页的 KV 分片
上下文并行将预填充计算分布到各 rank,但 KV 缓存仍可能在这些 rank 之间复制。基于页的 KV 分片消除了这些重复副本,同时保留每个请求的公共逻辑视图。HiCache 在备份和恢复缓存时必须保留这种页归属。
1.1 逻辑基数树与页归属
在图 1a 中,请求 A/B/C 和 A/B/E 共享 A/B 前缀节点,然后走向不同分支。每个 CP rank 维护相同的逻辑基数树,包括相同的逻辑页 ID。因此,对 A/B/C 的命中在每个 rank 上都会识别出相同的三个缓存页,尽管它们的 KV 数据存储在不同的 GPU 上。
右侧的 GPU 池根据逻辑 ID 存储页。使用两个 rank 时,偶数页属于 rank 0,奇数页属于 rank 1。Rank 0 将 A、C 和 E 存储在本地页 1、2 和 3;rank 1 将 B 存储在本地页 1。树和请求表保留逻辑索引,内存池将其转换为所有者和本地地址。
对于 NNN 个分片 rank、页大小为 ppp 个 token 以及已分配的逻辑槽 xxx:
q=⌊x/p⌋q = \lfloor x / p \rfloorq=⌊x/p⌋
r=q mod Nr = q \bmod Nr=qmodN
ℓ=⌊q/N⌋×p+(x mod p)\ell = \lfloor q / N \rfloor \times p + (x \bmod p)ℓ=⌊q/N⌋×p+(xmodp)
这里,qqq 是逻辑缓存页 ID,rank rrr 将该 token 的 KV 存储在本地行 ℓ\ellℓ。此映射是算术运算,无需逐页查找表。 [页放置与分片组]
当请求复用 A/B/C 并添加页 D 时,分配器延续前缀的所有者序列:0、1、0,然后是 1。在示例中,D 获得逻辑页 ID 5,并占用 rank 1 上的本地页 2。树记录所有权轮转,以便扩展遵循缓存路径;它拒绝会组合不兼容轮转的插入。
启用预填充 CP 时,所有权分布在 CP 组内。交错和锯齿决定分配给每个 rank 的计算,与这种页放置无关。当 CP 禁用时,MLA 还可以在注意力 TP rank 之间分片复制的潜在 KV。
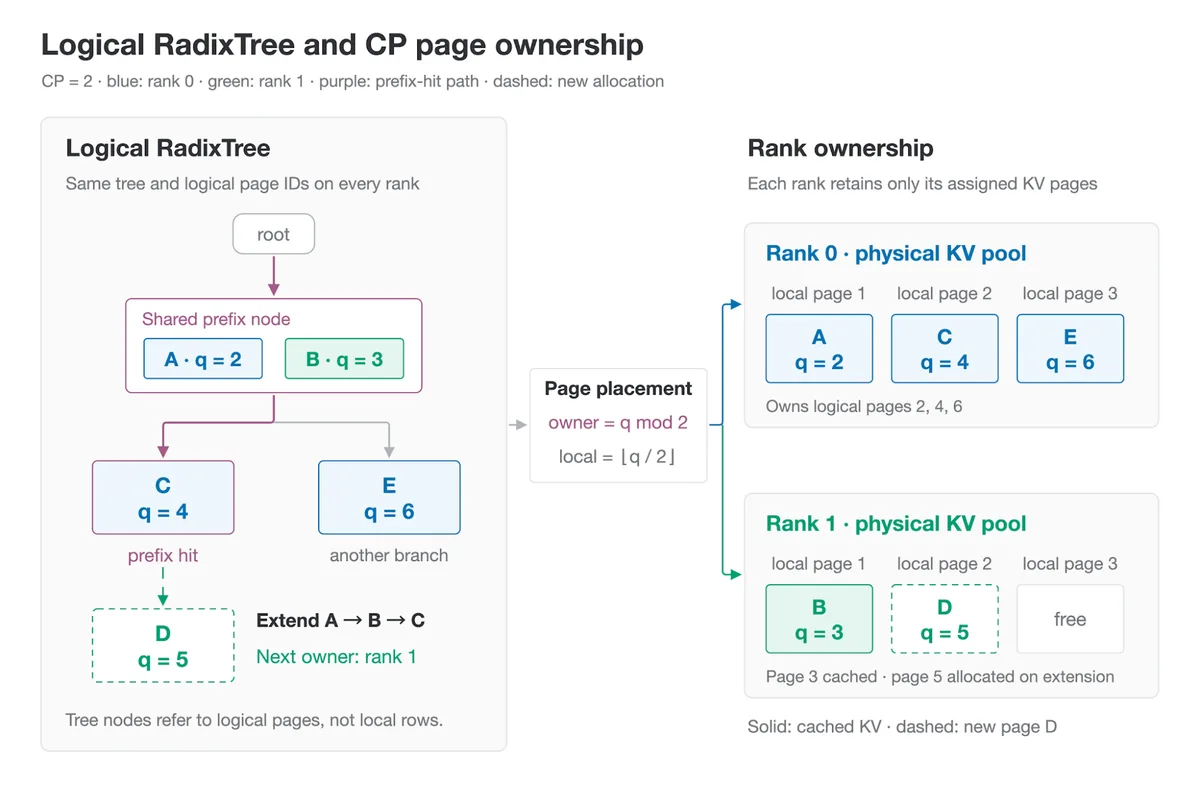
图 1a。 每个 CP rank 维护相同的逻辑基数树。逻辑页 ID q 决定其所有者和所有者本地页。请求共享 A/B 并分支到 C 或 E;扩展匹配的 A/B/C 前缀会在 rank 1 上分配 D,保持所有权循环。虚线轮廓标记新分配。
1.2 读取分片 KV:逐层收集
分片后,rank 的本地缓存仅包含注意力所需历史的一部分。在读取某层的缓存前缀之前,每个 rank 将其拥有的页贡献给一次全收集。结果放入该层的临时缓冲区。
使用同一示例,rank 0 贡献 A 和 C,而 rank 1 贡献 B 和一个填充页。收集的缓冲区按所有者对页分组。页表映射让注意力可以读取逻辑序列 A、B、C,而无需物理重排这些页。当前块的 KV 与来自缓存写入边界已可用的完整块的前缀一起暂存。
两个临时缓冲区在各层之间交替,使下一层的收集与当前层的计算重叠。这使组装的 KV 限制为两个层缓冲区。它们的内存成本计入缓存预算,调度器在接纳每个批次前检查其是否适合。
在支持的配置上,收集使用 GPU 复制引擎而非 NCCL SM 内核,减少与模型计算的竞争。因此,前缀命中节省了重计算,但仍需支付收集其分布式 KV 的成本。[零 SM 收集]
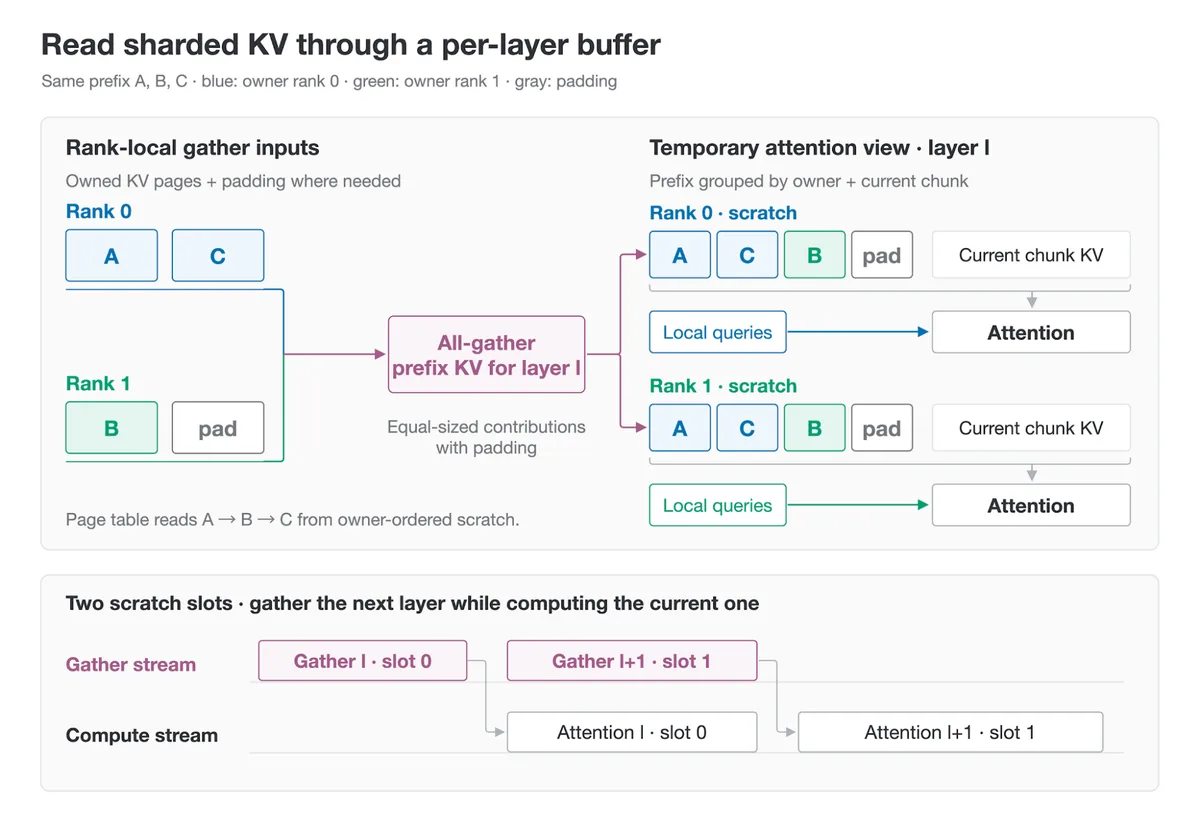
图 1b。 每个 rank 为当前层贡献自己的页。全收集在两个 rank 上产生相同的按所有者排序的前缀缓冲区;页表映射保持逻辑序列 A、B、C。两个暂存槽位使下一层的收集能与当前层的注意力计算重叠。
1.3 HiCache 集成:在收集前恢复每个分片
HiCache 在 GPU 与主机内存之间移动 KV 时必须保持页所有权。否则,恢复的页可能落到一个不会在下次收集中贡献它的 rank 上。在三页示例中,rank 0 将 A 和 C 备份到自己的主机池,而 rank 1 备份 B。重新加载时分配具有相同所有者的 GPU 页,即使它们的物理地址已经改变。
缓存树和传输队列继续使用逻辑索引。在复制边界处,每个 rank 选择自己的源–目标页对,并将其转换为本地地址。然后各 rank 可以通过各自的本地 GPU–主机路径并发地移动不同的分片。
收集还必须等待恢复的数据。HiCache 在传输流上加载 KV,而前缀收集在单独的流上运行。对于每一层,收集等待该层的恢复完成事件;随后注意力等待收集到的缓冲区。顺序是恢复本地页 → 收集前缀 → 运行注意力。调度器在将重新加载排入队列之前预留所需的收集缓冲区。
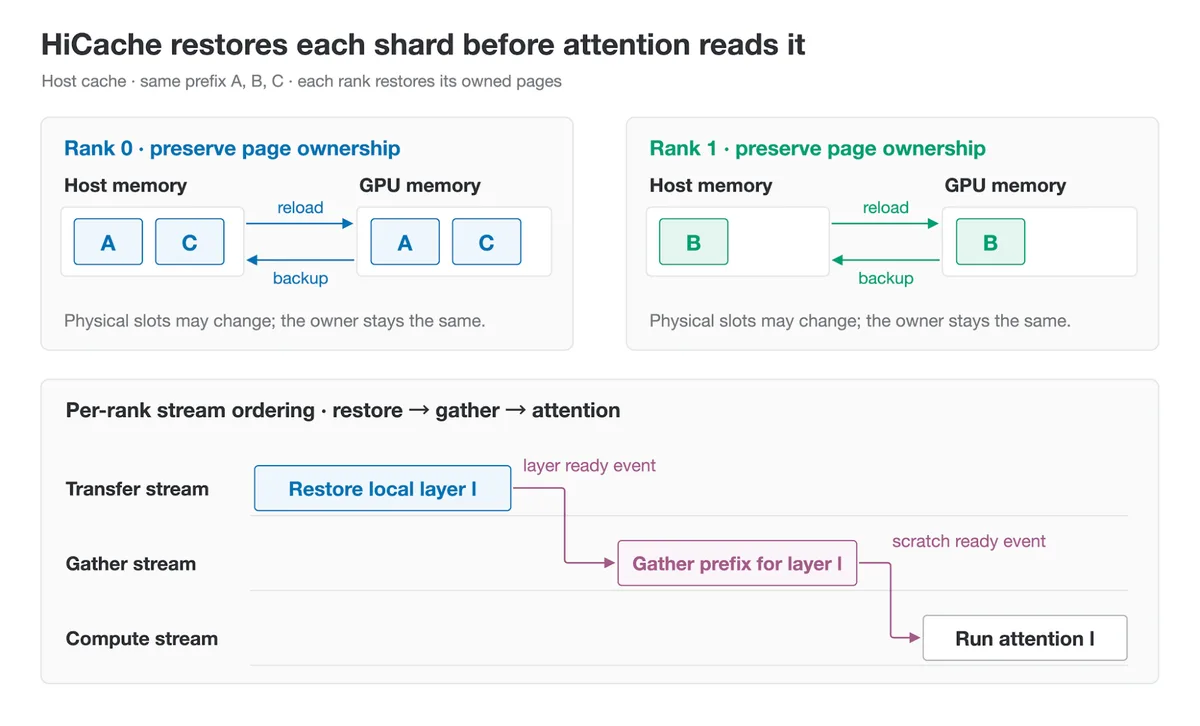
图 1c。 主机备份和重新加载保持页所有权。在每个 rank 上,收集流等待当前层的恢复完成事件,注意力等待收集到的缓冲区。所需的顺序是恢复本地页 → 收集前缀 → 运行注意力。
1.4 性能实践
有关带 CP 分片和 HiCache 的 GLM-5.3 部署示例,请参阅 PR #46789 中的配置指南. 下面的性能评估使用 GLM-5.2-NVFP4。
使用生产流量的性能比较
我们将开源的 CP 分片 HiCache 实现与一个基线进行了比较,该基线在 GPU 上复制 KV,并在主机内存中对 MLA KV 去重。两个部署均使用 GLM-5.2-NVFP4、TP4/CP4、EAGLE MTP,以及 0.9 的静态内存比例。每个部署有两个预填充引擎,每个引擎运行在四块 NVIDIA GB300 GPU 上。
每个部署的目标主机缓存预算为每引擎 960 GB:基线中是一个去重池,而四个分片 rank 中每个 rank 为 240 GB。在三小时的流量窗口内,每种配置处理了约 24.5K 个具有已知缓存层级归属的请求。平均输入长度为 136K–137K token,总输入量相差 1.8%。
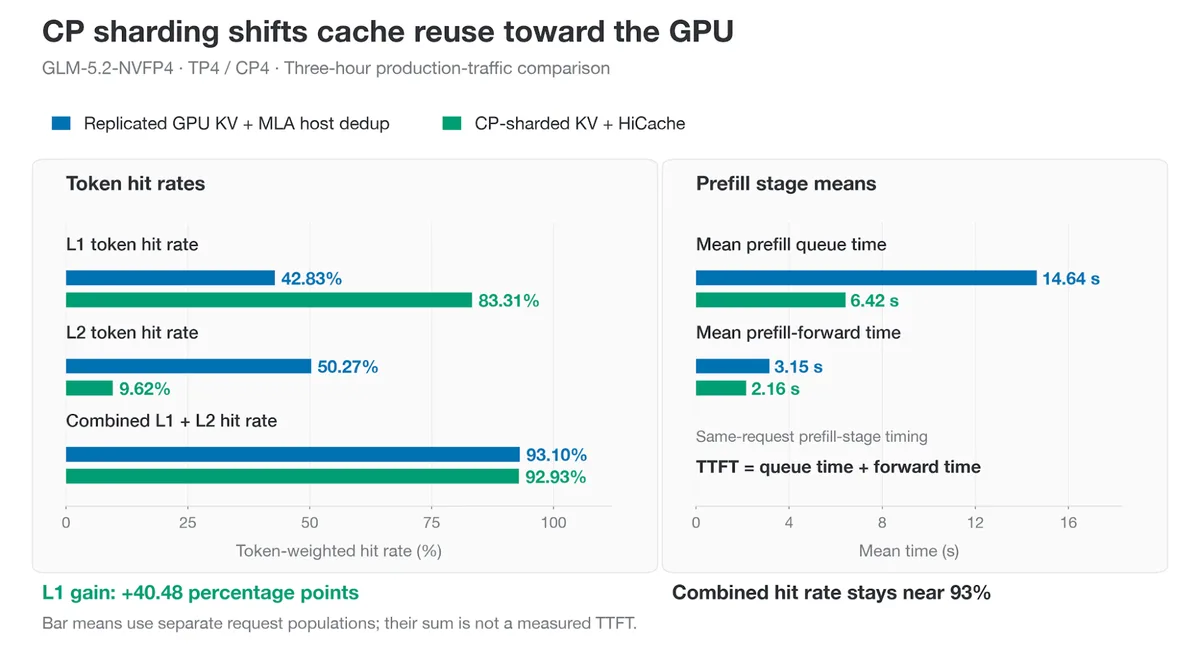
图 1d。 采用 CP 分片后,更多缓存 token 由 GPU 内存提供,更少由主机内存提供;合计命中率保持在 93% 附近。对于同一请求,预填充阶段 TTFT 是排队时间加前向时间。图中均值使用不同的请求群体,不应相加为实测 TTFT。
采用 CP 分片后,GPU token 命中率提高了 40.48 个百分点,而 GPU 与主机合计命中率保持在 93% 附近。由主机内存提供的 token 从 1.712B 降至 0.322B,减少了 81.2%。平均预填充排队时间降低了 56.2%,平均预填充前向时间降低了 31.3%。
CP 分片仍在优化中,逐层 KV 收集会带来一些开销。我们将继续改进其性能,并将 HiCache 集成扩展到 GLM-5 系列之外的更多模型。
2. PP × HiCache:在各阶段之间保持缓存操作一致
CP 分片决定每个页由哪个 rank 拥有。流水线并行按层分布 KV,并要求各阶段在请求流经流水线时一致地应用缓存操作。每个阶段维护自己的基数树。在仅 GPU 缓存的情况下,经典的 RadixCache 在各阶段从相同状态出发并以相同顺序应用相同操作时,会产生相同的逻辑树和缓存决策。各阶段可以在不同时间到达这些操作,而不会改变结果。
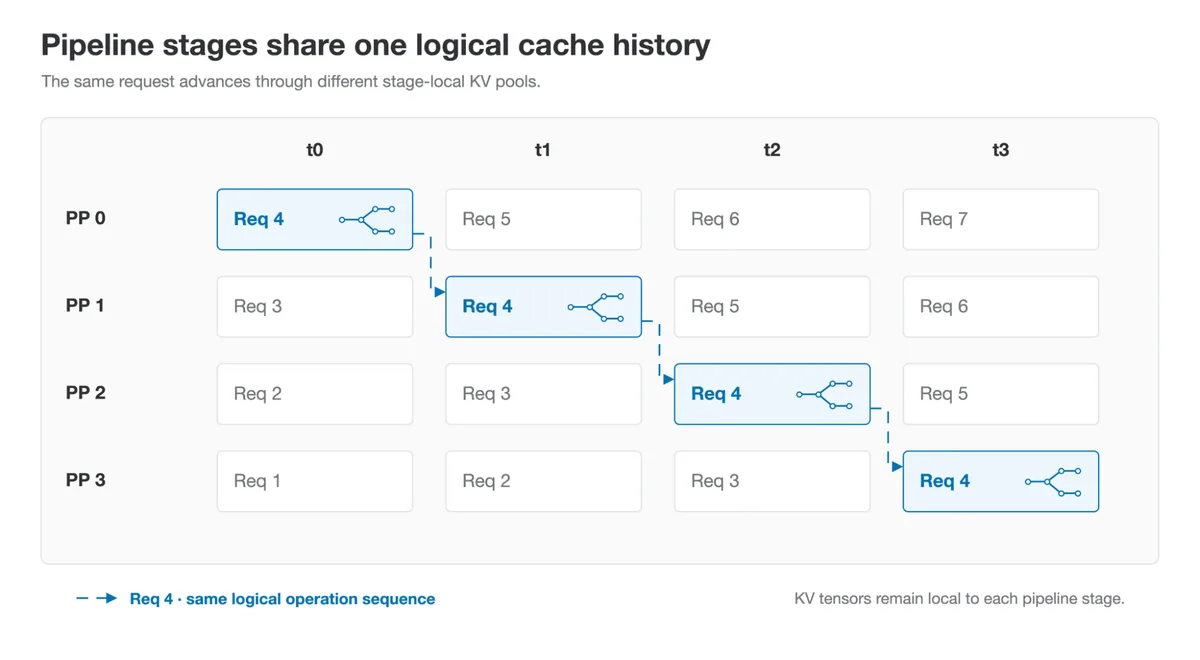
图 2a。 每个流水线阶段存储自己各层的 KV。各阶段在不同时间处理请求,同时遵循相同的缓存操作逻辑序列。
HiCache 在此执行模型中增加了异步传输和存储读取。它们的结果会影响缓存记账和后续调度决策,因此各阶段必须在流水线中的对应点应用它们。否则,微小的差异可能增长为前缀长度或张量形状不匹配,如 #22607.
2.1 主机缓存:协调异步传输
主机缓存不匹配始于各阶段独立决定哪些传输已完成。假设 PP0 看到备份 A 完成而 B 仍在传输中。当 PP1 到达相应的缓存检查时,A 和 B 都已在本地完成。处理每个就绪条目会使 PP0 释放 A 的锁,而 PP1 释放两者。它们的驱逐资格现在不同了,尽管它们收到了相同的请求并发出了相同的缓存操作。
在每个阶段的 TP 组内进行 all_reduce(MIN) 无法协调这些不同的 PP 阶段决策。PR #27285 引入了 pp_sync:PP0 在其 TP 组内减少就绪计数,然后将商定的计数沿流水线向下发送。后续阶段接收并转发这些计数,而不是自行选择。
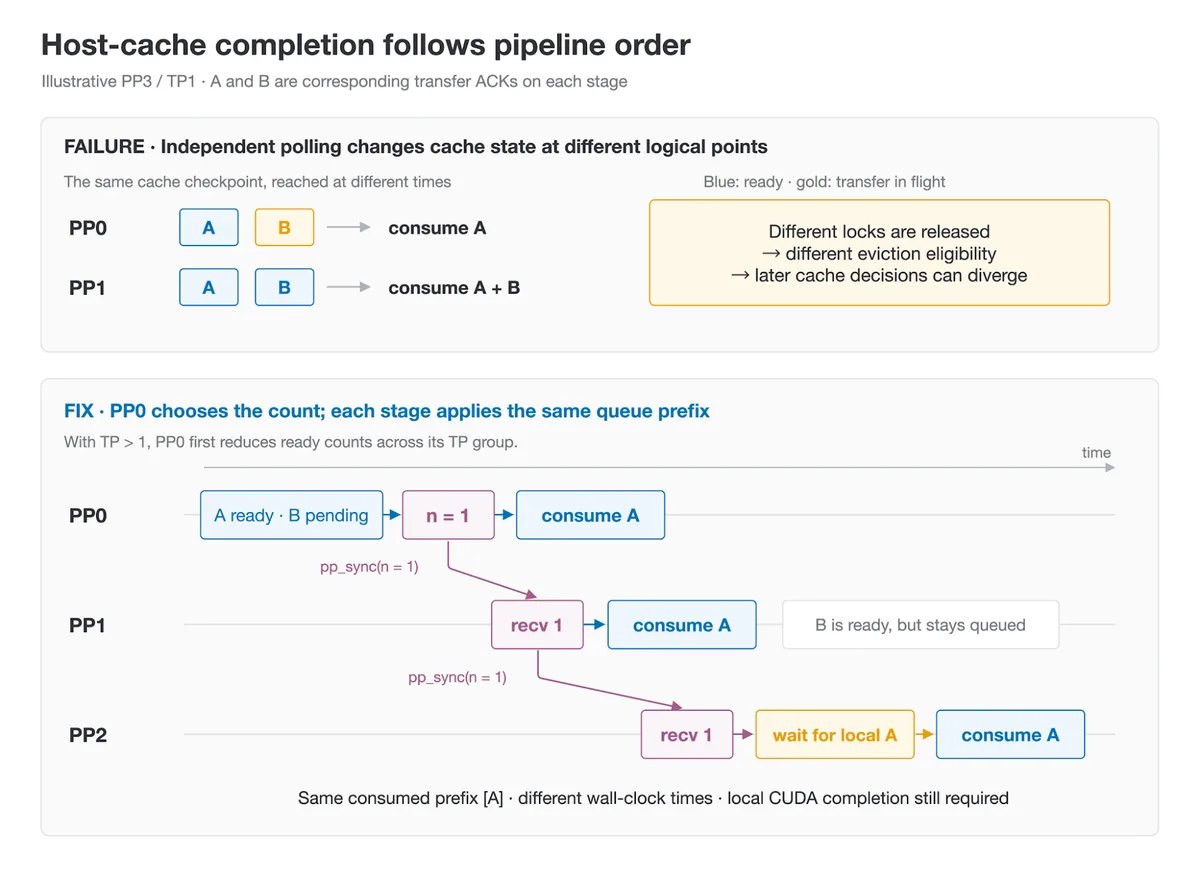
图 2b。 独立轮询让 PP0 消费 A,而 PP1 消费 A 和 B,从而在不同逻辑点改变锁和驱逐状态。使用 pp_sync, 每个阶段消费相同的队列前缀。PP1 保留一个额外的就绪 ACK;PP2 在应用之前等待其选定的本地传输。时间线仅为示意。
对于每个选定的 ACK,本地 finish_event.synchronize() 必须在阶段更新缓存记账之前完成。具有额外就绪 ACK 的阶段将它们留在队列中;所选传输仍在运行的阶段则等待它。这适用于 GPU 到主机的备份和主机到 GPU 的加载。
计数通过点对点消息传递,因此各 PP 阶段可以在不同时间到达检查点。该协议保持已应用缓存操作的顺序,而不强加同时的跨 PP 调度器屏障。
2.2 外部存储:就缓存前缀达成一致
使用外部存储时,每个 PP 阶段为自己的层加载 KV。如果一个阶段加载了四页,而另一个阶段复用了六页,它们对哪些 token 仍需计算就会产生分歧。这可能是因为各阶段发现的缓存数据量不同,或者是因为在它们的调度决策之间又有更多数据完成加载。因此,所有阶段必须对同一请求使用相同的缓存前缀长度。
PR #27010 在后台线程和调度器中对此进行协调:
- 后台线程确定所有 rank 上已加载的内容。 读取前,它们取最小存储命中长度以确定公共缓存前缀。读取期间,它们取最小完成长度以考虑缓慢或失败的读取。每个达成一致的进度更新都会放入有序 ACK 队列供调度器使用。
- 调度器按相同顺序消费该进度。 在每次缓存检查时,PP0 确定要消费多少个 ACK,并将该计数通过
pp_sync传递给后续阶段。后续阶段消费相同的队列条目,将更新的更新留给下一次检查。它们也遵循 PP0 的超时和停止决策。
例如,如果 PP0 在消费了加载四页的 ACK 后停止等待,那么每个后续阶段都会为该请求使用相同的这四页。当 PP1 到达时,六页的 ACK 可能已经排队,但它不会改变该决策。后台读取可以继续进行,同时所有阶段保持相同的缓存前缀和该请求的剩余计算。
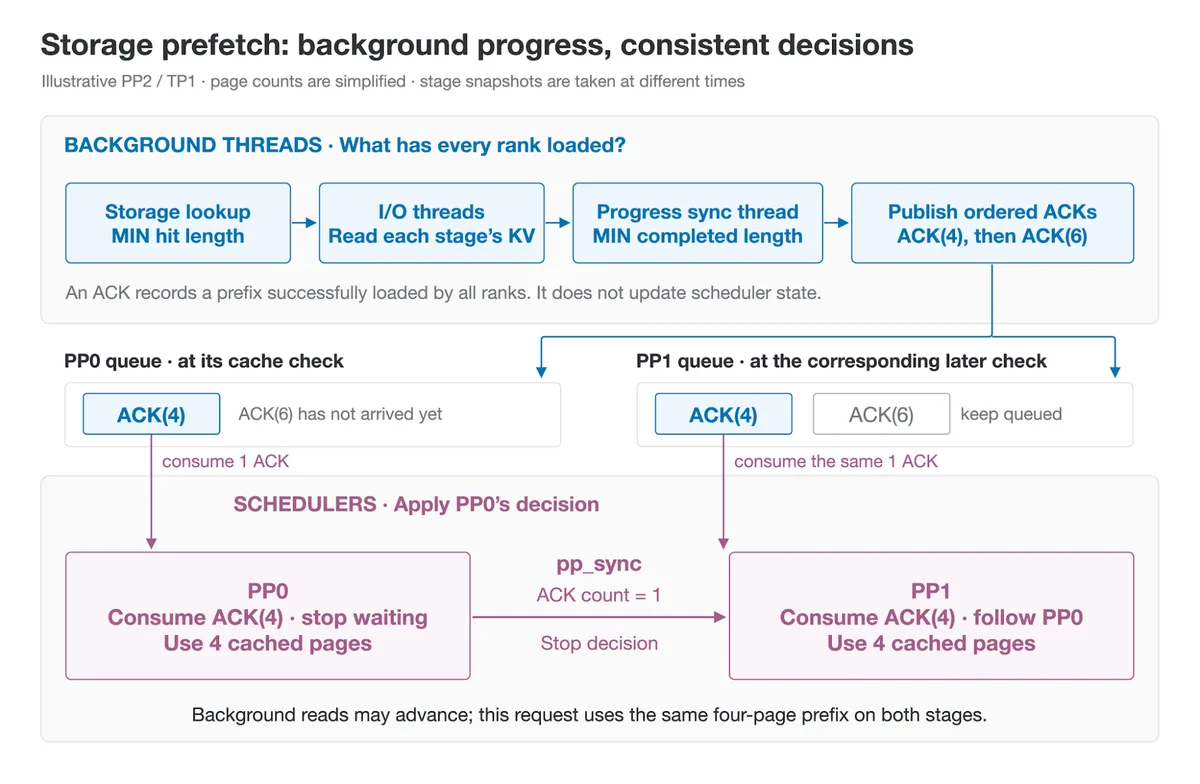
图 2c。 后台线程通过有序 ACK 队列发布达成一致的读取进度。在相应的缓存检查中,PP0 和 PP1 消费相同的 ACK(4),并为该请求使用四个缓存页。当 PP1 稍后到达时已可用的 ACK(6) 仍留在队列中。页数仅为示意。
3. 投机解码 × HiCache
前缀命中让目标模型跳过预填充,但草稿模型仍然需要该前缀背后的历史。仅恢复目标 KV 可能使草稿模型缺少状态,并降低投机接受率。
因此,HiCache 将草稿模型所需的 KV、索引器缓冲区以及单独拥有的循环状态与目标前缀一起保存。它通过两种方式组织这些状态。
- 打包(图 3a) 将兼容的草稿层追加到对应的目标主机池,共享其槽位映射,同时保留独立的 GPU 池。这要求兼容的行形状、dtype 和 token 索引。
- Sidecar(图 3b) 保留独立的主机池和负载布局,其传输索引派生自声明的来源,例如目标 KV 或 SWA。
两条路径都将草稿状态与目标前缀一起备份和恢复,并在读取缓冲区之前将所需的副本包含在传输完成事件中。
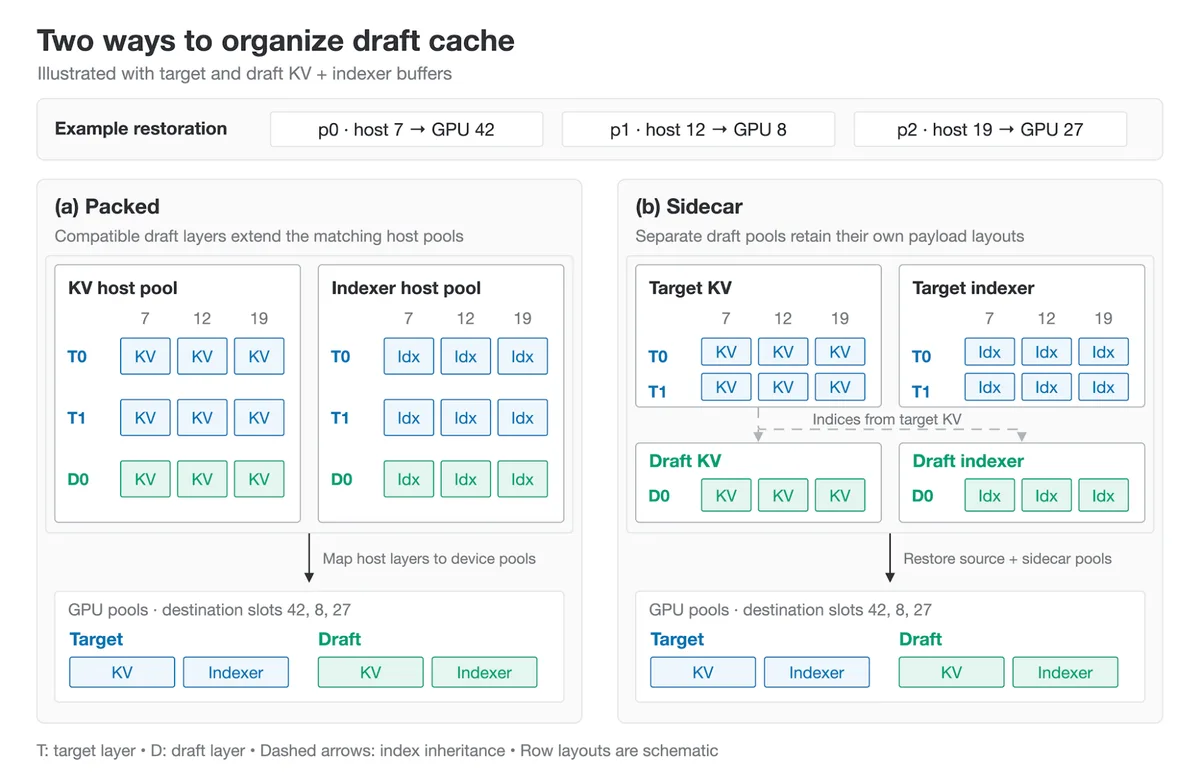
图 3。 打包集成将草稿层追加到匹配的 KV 和索引器主机池。Sidecar 集成保留独立的草稿池,这些池继承其源池的传输索引。该示例将三个缓存页恢复到两个模型的新 GPU 槽位中。
4. 统一 KV 缓存布局:跨兼容拓扑复用
生产服务通常按上下文长度或延迟要求将请求分到不同的桶中,每个桶使用不同的并行配置。例如,短上下文桶可能运行 TP2/PP1,而长上下文桶使用 TP4/PP2,以将更大的 KV 占用分散到更多 GPU 上。随着智能体的对话增长,后续轮次可能转移到另一个桶,同时保留大部分相同的前缀。如果存储的 KV 与写入者的 rank 和本地布局绑定,新桶就无法直接复用它。 统一 KV 布局为这些部署提供了共享的存储表示,使每个读取者都能检索其所需的层和头。
每个 token 页被划分为具有共享层和头边界的块,允许不同的部署从相同的存储对象组装其本地缓存。
图 4 使用一个具有八个 KV 头的 60 层模型。每个块覆盖 30 层和两个头,每个 token 页产生八个对象。TP4/PP2 写入者在每个 rank 上贡献一个对象。TP2/PP1 读取者在每个 rank 上需要四个对象:TP0 在两个层范围上组合 H0 和 H1,而 TP1 组合 H2 和 H3。
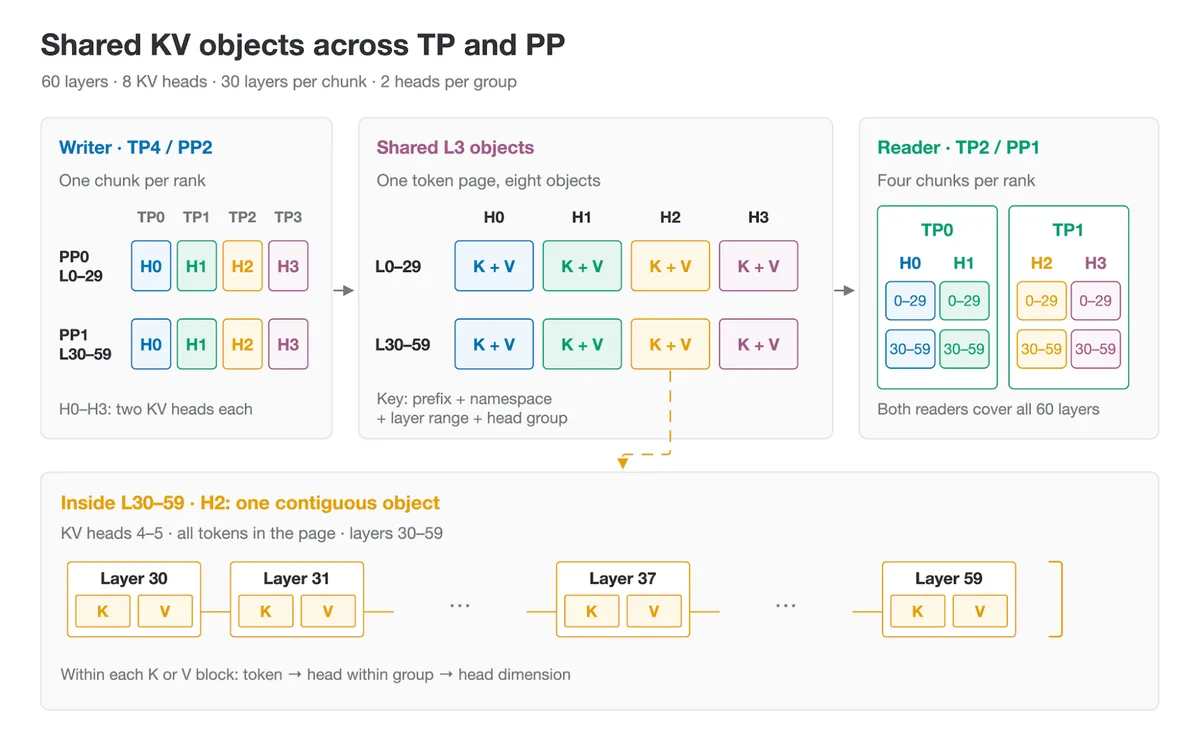
图 4。 写入者和读取者共享固定的层和头网格。展开的对象包含第 30–59 层中头 4–5 的 K 和 V,存储为一个连续的字节范围。
每个对象由其 token 前缀和全局坐标标识:
{page_hash}_{namespace_digest}_L{start_layer}-{end_layer}[_H{head_group}]
命名空间包括模型、逻辑 KV dtype、页大小、复制模式、分区网格和对象布局。共享这些对象的部署必须就这些字段达成一致,并且它们的本地分片必须与块边界对齐。
物理布局遵循相同的分区。对于 MHA,轴为:
(page, head_group, layer, K/V, token_in_page, head_in_group, head_dim)
在一个头组内,每一层的 K 和 V 存储在一起,随后是下一层。如展开的对象所示,选择第 30–59 层因此会选择一段连续的字节跨度。存储后端可以使用偏移量和长度来传输该块。
MLA 使用以下布局,没有单独的头组或 K/V 轴:
(page, layer, token_in_page, dim)
在备份期间,GPU 重布局内核将选定的页按此顺序打包到可复用的暂存缓冲区中,然后将它们复制到固定的主机内存。生成的主机页可以直接拆分为共享的 L3 对象。
配置与当前范围
以下选项需要 unified-layout integration build。对于 60 层、八头的示例,将以下选项添加到两个部署中:
--enable-hierarchical-cache \
--hicache-storage-backend file \
--hicache-storage-key-scheme unified \
--hicache-storage-head-partition 2 \
--hicache-storage-layer-partition 30
统一键方案会自动选择 page_unified 主机布局和内核 I/O 后端。
当前的统一 L3 路径支持文件后端和单个 MHA 或 MLA KV 池。CP 支持仅限于全页副本;DCP 以及按层或按页分片的 CP 需要进一步集成。混合模型缓存组件和草稿模型缓存状态是下一步计划。
5. P/D × HiCache:解码侧前缀复用
在 P/D 服务中,prefill worker 上的前缀缓存命中可以节省计算,但 decode worker 在生成 token 之前仍然需要相应的 KV。如果没有解码侧复用,该 KV 必须在后续轮次中再次传输。对于具有长共享历史的 agentic 工作负载,重复传输会增加等待每个响应的时间。
解码侧基数树允许 worker 保留来自早期请求的 KV,并将其与传入的提示进行匹配。HiCache 将这种复用扩展到主机内存,因此前缀在其 KV 离开 GPU 后仍可复用。在后续请求中,decode 恢复本地缓存的前缀,并要求 prefill 仅发送缺失的后缀。
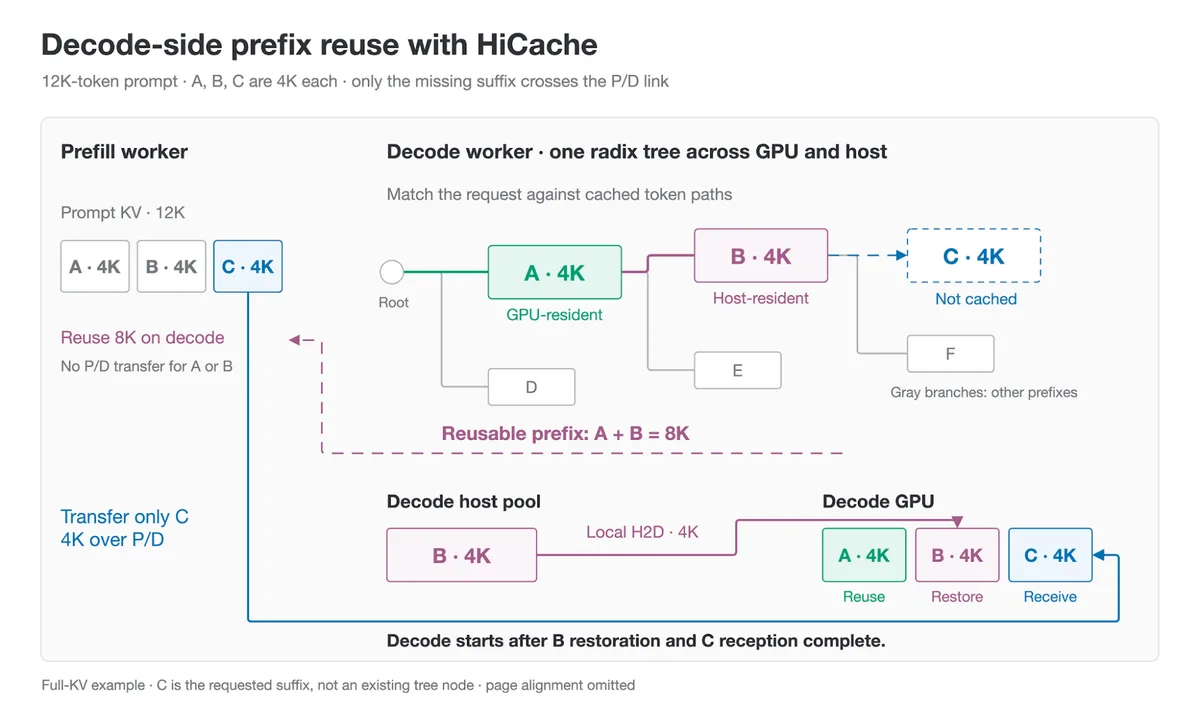
图 5。 高亮的树路径匹配一个 8K 前缀:A 在 GPU 上,B 在主机内存中。Decode 在本地恢复 B,并仅从 prefill 接收 4K 后缀 C。灰色分支显示其他缓存的前缀;C 尚未缓存。解码会同时等待恢复和接收完成。
对于每个请求,decode 将提示与其基数树进行匹配,并锁定驻留在 GPU 上的前缀。它为任何本地恢复的 KV 和传入的后缀预留 GPU 空间,然后向 prefill 报告可复用边界为 decode_prefix_len。Prefill 仅发送该边界之后的 KV;其自身的前缀缓存独立决定它可以跳过多少计算。如果配置了外部存储,L3 跨度只有在其预取被接受后才能扩展可复用前缀。
在图 5 中,12K token 的提示包含三个 4K 跨度。A 已在解码 GPU 上,B 在其主机缓存中,C 缺失。树将 A 和 B 匹配为 8K 前缀。解码从主机内存恢复 B,同时从 prefill 接收 C,将远程传输从 12K 减少到 4K。
本地恢复和远程接收都必须在解码开始前完成。如果恢复无法提供向 prefill 承诺的前缀,请求就会失败。该示例使用 Full-KV 缓存。复用边界必须遵守页对齐和模型所需的缓存状态。混合模型可能需要额外的传输,例如新的 SWA 尾部。
对多轮请求的影响
为了衡量重复前缀带来的收益,评估使用了 GLM-5.2-FP8,每个 worker 配备八块 NVIDIA B300 GPU,并在 prefill 和 decode 上均使用 TP8/EP8。它运行了 32 个并发对话,共 86 轮。四组各八个对话共享一个 32K token 的初始前缀。每个后续轮次增加 1K 输入 token,并为每个响应生成 512 个输出 token,最终每个对话的上下文达到 160K token。
我们将解码侧 GPU 和主机前缀复用与禁用解码侧前缀复用的基线进行了比较。在此工作负载下,同时启用两个缓存层级使平均 TTFT 降低了 25.4%(2.07 → 1.54 秒),中位 TTFT 降低了 60.3%(0.681 → 0.271 秒),同时输出吞吐量提高了 2.9%。这些结果反映了 GPU 和主机前缀复用的综合收益。
复现配置使用上述 GLM-5.2-FP8 设置(每个 worker 八块 NVIDIA B300 GPU,TP8/EP8)。在 Bash 中运行这些命令,在两台主机上定义共享选项,并使用已配置好的 P/D 路由器。一次比较一种解码配置,保持 prefill 不变。
环境(Bash)
export MODEL=/path/to/GLM-5.2-FP8
export SERVED_MODEL_NAME=your-served-model-name
export IB_DEVICES=your-comma-separated-rdma-device-names
export PREFILL_URL=http://your-prefill-host:30000
export DECODE_URL=http://your-decode-host:30000
export ROUTER_HOST=your-pd-router-host
export ROUTER_PORT=your-pd-router-port
共享服务器选项
COMMON="--trust-remote-code --model-path $MODEL \
  --served-model-name $SERVED_MODEL_NAME --tp-size 8 --ep-size 8 \
  --context-length 262144 --max-running-requests 64 \
  --host 0.0.0.0 --port 30000 --schedule-policy fcfs \
  --reasoning-parser glm45 --kv-cache-dtype fp8_e4m3 \
  --disaggregation-transfer-backend mooncake \
  --disaggregation-bootstrap-port 30200 \
  --disaggregation-decode-retraction-backup cpu_tensor \
  --disaggregation-ib-device $IB_DEVICES"
HICACHE="--disaggregation-decode-enable-radix-cache \
  --enable-hierarchical-cache --hicache-host-memory-fraction 1.0"
启动 prefill 与单一 decode 配置
# Prefill host: unchanged for both runs.
python3 -m sglang.launch_server $COMMON \
  --disaggregation-mode prefill --mem-fraction-static 0.899 \
  --enable-hierarchical-cache

# Decode host: baseline.
# Radix caching is off by default in the tested version.
python3 -m sglang.launch_server $COMMON \
  --disaggregation-mode decode --mem-fraction-static 0.963

# Stop baseline services, then restart both hosts.
# Keep prefill unchanged; use this decode command for GPU + host reuse.
python3 -m sglang.launch_server $COMMON $HICACHE \
  --disaggregation-mode decode --mem-fraction-static 0.963
刷新并运行基准测试
# Before each measured run: no active requests; flush both caches.
curl --fail-with-body -X POST "$PREFILL_URL/flush_cache"
curl --fail-with-body -X POST "$DECODE_URL/flush_cache"

# Use the configured P/D router; set ARM=tree for the second run.
ARM=baseline
python3 -m sglang.bench_serving \
  --backend sglang-oai-chat --host "$ROUTER_HOST" --port "$ROUTER_PORT" \
  --model "$MODEL" --served-model-name "$SERVED_MODEL_NAME" \
  --tokenizer "$MODEL" --dataset-name generated-shared-prefix \
  --gsp-num-groups 4 --gsp-prompts-per-group 8 \
  --gsp-system-prompt-len 32768 --gsp-question-len 1024 \
  --gsp-output-len 512 --gsp-num-turns 86 --gsp-range-ratio 1 \
  --max-concurrency 32 --num-prompts 32 --request-rate inf \
  --seed 1 --warmup-requests 0 --output-details \
  --output-file "${ARM}-full.jsonl"
结语视角
可靠的前缀复用同时取决于数据放置和执行顺序。CP 分片在由各 rank 拥有的页面上保留共同的逻辑前缀,而 PP 则跨阶段协调缓存事件。投机解码需要在恢复目标缓存的同时恢复草稿状态。统一 KV 布局为兼容的拓扑提供共享表示,而 P/D 服务只传输解码侧缓存中缺失的后缀。在每种情况下,只有当所需状态已就绪可用时,缓存命中才能节省计算。
使用以下方式调试 rank_consensus_checker
将这些特性组合在一起也会让故障更难追踪。各 rank 可能在不同时间完成缓存传输,但它们仍需就诸如可复用前缀长度等决策达成一致。如果这些决策出现分歧,可见症状可能是后续的形状不匹配或集合通信挂起。
SGLang 的 rank_consensus_checker 有助于定位更早的分歧。它按逻辑顺序比较各 rank 上选定的调度器调用和返回值,包括在不同时间到达同一操作的 PP 阶段。
在启动前于每个调度器进程上启用它,然后重放失败的工作负载:
export SGLANG_ENABLE_RANK_CONSENSUS_CHECKER=1
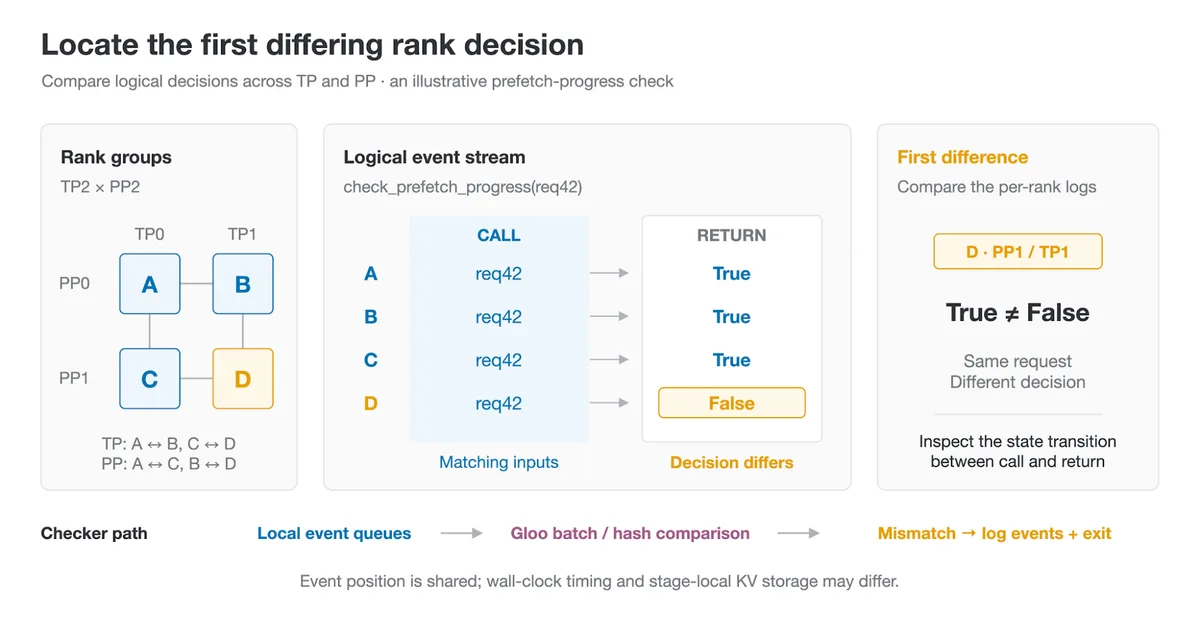
图 6。 PP1/TP1 对同一请求返回了不同的决策。将匹配的调用与不同的返回值进行比较,以缩小排查范围。
当检查器报告“Found rank divergence”时,收集所有 rank 日志并检查第一个不相等的条目。调用顺序不同指向调度或缓存事件消费问题;参数不同则表明更早的状态不匹配。如果输入相同但结果不同,则检查缓存操作本身。比较同一 PP 阶段内的 TP 对等节点,以及跨阶段对应的 TP 位置。
参见 检查器源码 以了解装饰器选项、字段选择器和示例。
致谢
我们感谢阿里云 Tair KVCache 团队、阿里百炼团队、蚂蚁集团 SCT 推理团队、RadixArk,以及 NVIDIA DevTech 和 Dynamo 团队的支持。我们也感谢科大讯飞星辰 MaaS 团队分享其生产经验和结果。我们感谢张百舟、马腾、耿佳静、刘光大、张宏佳、Vladislav Nosivskoy 和张世金在实现、评审、测试和反馈方面的贡献,并感谢相关路线图的所有贡献者 #43098 以及 #21846.