 AI 热点
发布于 2026 年 11 月 21 日
Qwen4 Max 已在 Together AI 上线阿里巴巴旗舰 Qwen 模型在 2026 年 11 月 22 日前可享七折优惠。我们在一次请求中向它提供了一份错误报告和整个 Tornado 代码库,以了解 100 万 token 上下文窗口的价值及其成本。
作者
Sonny Khan
目录
本文链接
摘要
- Together AI 上的 Qwen4 Max: 阿里巴巴旗舰 Qwen 模型现已登陆 Together Serverless Inference,支持 100 万 token 的上下文窗口。
- 我们的测试: Qwen4 Max 在一次请求中接收了一份错误报告以及 Tornado 代码库的全部 344 个文件,其补丁通过了维护者编写的测试。
- 促销价格: 截至 2026 年 11 月 22 日,每 100 万输入 token 的价格为 1.05 美元,每 100 万缓存输入 token 为 0.0525 美元,每 100 万输出 token 为 3.15 美元。
- 调用前须知: 请求必须采用流式传输,且思考功能默认开启,思考 token 按输出 token 计费。
我们向 Qwen4 Max 一次性提供了一份错误报告和整个代码库。该代码库是 Python Web 框架 Tornado:共 344 个文件、652,519 个 token。模型没有任何工具,我们也没有挑选相关文件或先执行检索步骤。72 秒后,它返回了一个补丁,而该补丁通过了 Tornado 维护者为这一错误编写的测试。此次请求花费 69 美分。
它还在代码库的其他位置找到了先例。错误报告从未提及 tornado/iostream.py,但模型指出,那里的代码已经采用了其补丁所需的错误处理方式。Tornado 维护者在自己的修复中也引用了同一段代码。
Qwen4 Max 是阿里巴巴的旗舰 Qwen 模型。它今天已在 Together AI 上线,并在 2026 年 11 月 22 日前享受七折优惠。
测试
Tornado 是一个开源 Python Web 框架。其代码库包含约 340 个代码、测试和文档文件。这些内容可以放进 Qwen4 Max 的上下文窗口,而且远远超过任何人会手动粘贴进提示词的内容量。我们选取了维护者于 2026 年 11 月 18 日提交的一项修复——也就是 Qwen4 Max 发布两天后——并基于该提交之前的代码库状态进行了测试。
这只是一个示例,旨在展示单次调用可以完成什么,以及成本是多少。
该错误位于 Tornado 的 WebSocket 代码中。当连接关闭时仍有消息尚未发送,每一个未被 await 的 write_message() 调用都会记录一条错误,尽管对它使用 await 是可选的。我们将该检出版本中的每个文本文件作为一个提示词发送,并附上一份只描述症状的错误报告:
连接关闭时,write_message 会记录“Task exception was never retrieved”
当 WebSocket 连接在仍有消息尚未发送时关闭(例如,客户端发送消息和一个 FIN,或重置连接,却不读取回复),每个其结果未被 await 的 write_message() 调用都会在 ERROR 级别记录“Task exception was never retrieved”。
对 write_message 返回的 Future 使用 await 是可选的,因此未被 await 的调用不应记录任何内容。对其使用 await 的调用方仍应收到 WebSocketClosedError。
我们要求它找出原因并提供补丁。以下是重放的请求:
返回的结果
首个 token 在 54 秒后到达,回复在 72 秒时完成。Qwen4 Max 将错误追溯到 WebSocketProtocol13.write_message ,它位于 tornado/websocket.py中。该方法会将每次写入封装到一个任务里。当连接关闭时,任务会因异常而失败,但没有任何一方必须获取这个异常,于是 Python 将其记录为“Task exception was never retrieved”。
模型的补丁将该异常标记为已获取。这样不会记录任何内容,而对写入使用 await 的调用方仍会收到错误:
-        return asyncio.ensure_future(wrapper())
+        task = asyncio.ensure_future(wrapper())
+
+        # Awaiting the returned Future is optional, so an error nobody looks
+        # at must not be reported as "Task exception was never retrieved".
+        # Retrieving it here leaves it in place for callers that do await.
+        def _mark_retrieved(t: "asyncio.Task[None]") -> None:
+            if not t.cancelled():
+                t.exception()
+
+        task.add_done_callback(_mark_retrieved)
+        return task
这一先例让补丁读起来就像是项目自身原有的代码。模型在解释中表示,该修复应该采用 BaseIOStream.write 已经用于处理其自身 Future 的方式。该方法位于 tornado/iostream.py中,处在 WebSocket 代码的下一层,并以相同方式解决了同一个问题。维护者的提交也做出了同样的比较。
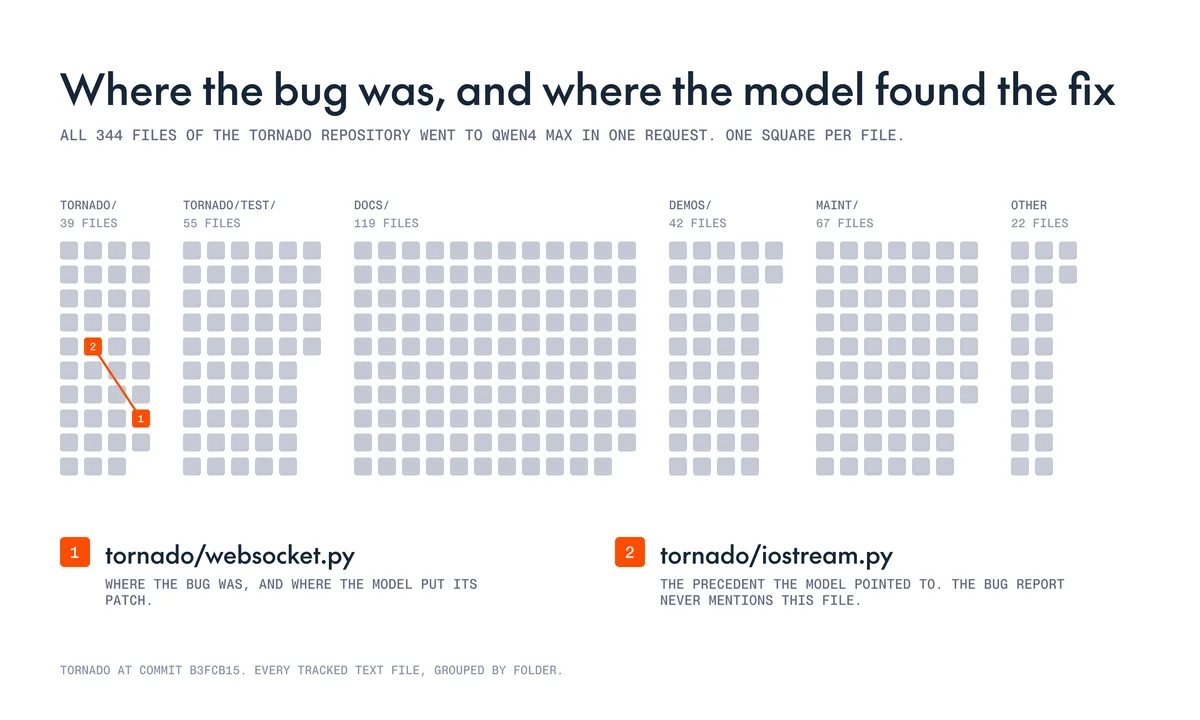
没有人为它挑选这些文件。全部 344 个文件都被输入模型,而模型找到了其中真正相关的两个。
我们的验证方式
Tornado 维护者随修复添加了两项回归测试:一项针对未被 await 的写入,另一项针对被 await 的写入。在修复前的代码上,第一项测试会失败。应用模型的补丁后,两项测试均通过。随后,我们在应用补丁的情况下运行了 Tornado 的完整测试套件,共 1,673 项测试,无一失败。
成本
按促销价计算,此次请求的费用约为 69 美分,其中几乎全部来自 652,519 个输入 token。按标价计算则为 98 美分。
再次发送同一个代码库的成本要低得多。Together AI 会自动缓存提示词输入,促销期间每 100 万缓存输入 token 的价格为 0.0525 美元。当我们重复发送一个约含 630,000 个 token 的请求时,几乎所有内容都命中了缓存。首个 token 的到达时间从 54 秒缩短至 8 秒,输入成本也从约 66 美分降至约 3 美分。
关于 Qwen4 Max
阿里巴巴于 2026 年 11 月 16 日发布 Qwen4 Max,并称其为迄今 Qwen 系列中能力最强的模型。阿里巴巴将该模型定位于长期运行的智能体任务,包括跨大型代码库进行编码,而这正是我们测试的任务类型。
Qwen4 Max 是一种稀疏混合专家模型,拥有 2.4 万亿个参数,其中每个 token 会激活 710 亿个参数。在阿里巴巴自有的行业任务基准 Work360 中——该基准覆盖 721 个专业领域——阿里巴巴报告称,它的整体表现优于 Qwen3.8 Max,在高推理强度下减少 35% 的 token 用量,并且每项任务的平均成本降低约 60%。这些是阿里巴巴提供的数据, 其公告 中有详细信息。
在 Together AI 上运行
Qwen4 Max 已登陆 Together Serverless Inference,其模型字符串为 Qwen/Qwen4-Max。该脚本会像我们的测试一样,在一次请求中发送整个代码库和一份错误报告。你需要 Together Python SDK(pip install together)、一个 TOGETHER_API_KEY、代码库的本地克隆,以及保存为 bug_report.md的错误报告。它会发送 Git 跟踪的所有文本文件,因此请先检查代码库中是否含有密钥。
import subprocess
from pathlib import Path

from together import Together

repo = Path("tornado")
bug_report = Path("bug_report.md").read_text()

# Every file git tracks, skipping the ones that aren't text
names = subprocess.check_output(
    ["git", "-C", str(repo), "ls-files"], text=True
).splitlines()
files = []
for name in names:
    try:
        files.append(f"=== FILE: {name} ===\n{(repo / name).read_text()}\n")
    except UnicodeDecodeError:
        continue

client = Together()

stream = client.chat.completions.create(
    model="Qwen/Qwen4-Max",
    messages=[
        {
            "role": "system",
            "content": f"This is a complete repository, {len(files)} files.\n\n"
            + "".join(files),
        },
        {
            "role": "user",
            "content": f"Here is a bug report.\n\n{bug_report}\n\n"
            "Explain the cause, then write a patch.",
        },
    ],
    stream=True,
)

for chunk in stream:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    # delta.reasoning carries the model's thinking, delta.content the answer
    if delta.content:
        print(delta.content, end="", flush=True)
其中有两点是该模型特有的。请求必须设置 stream=True, 因为 Together AI 上的 Qwen4 Max 仅接受流式请求。并且思考默认开启,因此模型会先在 delta.reasoning 中流式输出推理过程,随后会短暂停顿,再开始输出答案。思考 token 按输出 token 计费。若想在简单请求中跳过思考,请传入 reasoning={"enabled": False}.
若想不编写代码直接试用,请打开 在体验平台中. 模型页面 也提供了相同的详细信息。
现已可用 在 Together AI 上运行 Qwen4 Max 支持 100 万 token 的上下文、文本和图像输入,以及自动提示词缓存,并通过 Serverless Inference 提供服务。 打开体验平台常见问题
Together AI 上的 Qwen4 Max 费用是多少?
Together AI 上的 Qwen4 Max 标价为每 100 万个输入 token 1.50 美元、每 100 万个输出 token 4.50 美元、每 100 万个缓存输入 token 0.075 美元。截至 2026 年 11 月 22 日可享七折优惠,价格分别为 1.05 美元、3.15 美元和 0.0525 美元。思考 token 按输出 token 计费。
Together AI 上的 Qwen4 Max 上下文窗口有多大?
Qwen4 Max 在 Together AI 上支持 100 万 token 的上下文窗口。在我们的测试中,一个包含 652,519 个输入 token 的请求在 54 秒后返回了首个 token。
Qwen4 Max 接受图像输入吗?
是的,Together AI 上的 Qwen4 Max 接受文本和图像输入,并返回文本。请将每张图像作为一个 image_url 块放入消息内容中,具体方式请参阅视觉文档。 视觉文档.
为什么我的 Qwen4 Max 请求在未启用流式传输时会失败?
Together AI 上的 Qwen4 Max 仅接受流式请求。未启用流式传输的请求 "stream": true 会返回 400 错误,错误代码为 streaming_required。请设置 stream=True 在 SDK 中,或 "stream": true 在请求正文中设置,并从流中读取回复。
如何关闭 Qwen4 Max 的思考功能?
传入 reasoning={"enabled": False} (在 Python SDK 中),或在请求正文中传入 "reasoning": {"enabled": false} ,即可关闭 Qwen4 Max 的思考功能。思考功能默认开启,相关内容会在答案之前返回到 reasoning 字段中。若要让模型针对难题进行更多思考,请将 reasoning_effort 设置为 "max".
Qwen4 Max 支持工具调用吗?
是的,Qwen4 Max 在 Together AI 上通过标准的 tools 参数支持工具调用。它可以在一轮中返回多个调用。
提示词缓存适用于 Qwen4 Max 吗?
是的,Together AI 上的 Qwen4 Max 会自动使用提示词缓存,缓存输入 token 的标价为每 100 万个 0.075 美元。在我们的测试中,重复发送一个包含 630,000 个 token 的请求时,几乎所有内容都命中了缓存,首个 token 的返回时间也从 54 秒缩短至 8 秒。缓存采用尽力而为机制,因此并非每次重复请求都能命中缓存。
我可以微调 Qwen4 Max,或在专用端点上运行它吗?
不可以,目前 Qwen4 Max 在 Together AI 上仅以无服务器方式提供,也不支持微调。阿里巴巴表示,Qwen4 系列中规模更小的开放权重模型将陆续推出。