人工智能
在 EKS 上使用 Ray Train DLC 和 EFA 进行分布式训练通常阻碍 PyTorch 训练扩展到集群的,是容器,而不是模型代码。每个容器都需要相同的 CUDA 运行时, 一个针对它编译的 PyTorch 构建、 NCCL (NVIDIA 集合通信库)、 Elastic Fabric Adapter(EFA) 用户空间库、将 NCCL 连接到 EFA 的 AWS OFI NCCL 插件,以及集群运维人员认可的 Ray 版本。构建该镜像,并在其中任何一个组件更新时重新构建它,本身就是一项独立的工程,与你原本要训练的模型毫无关系。 Ray Train 深度学习容器 (DLC)就是该镜像,由 AWS 构建。AWS 组装整个技术栈,将其作为一个整体进行测试,发布到 Amazon Elastic Container Registry(Amazon ECR)Public,并持续为其打补丁。
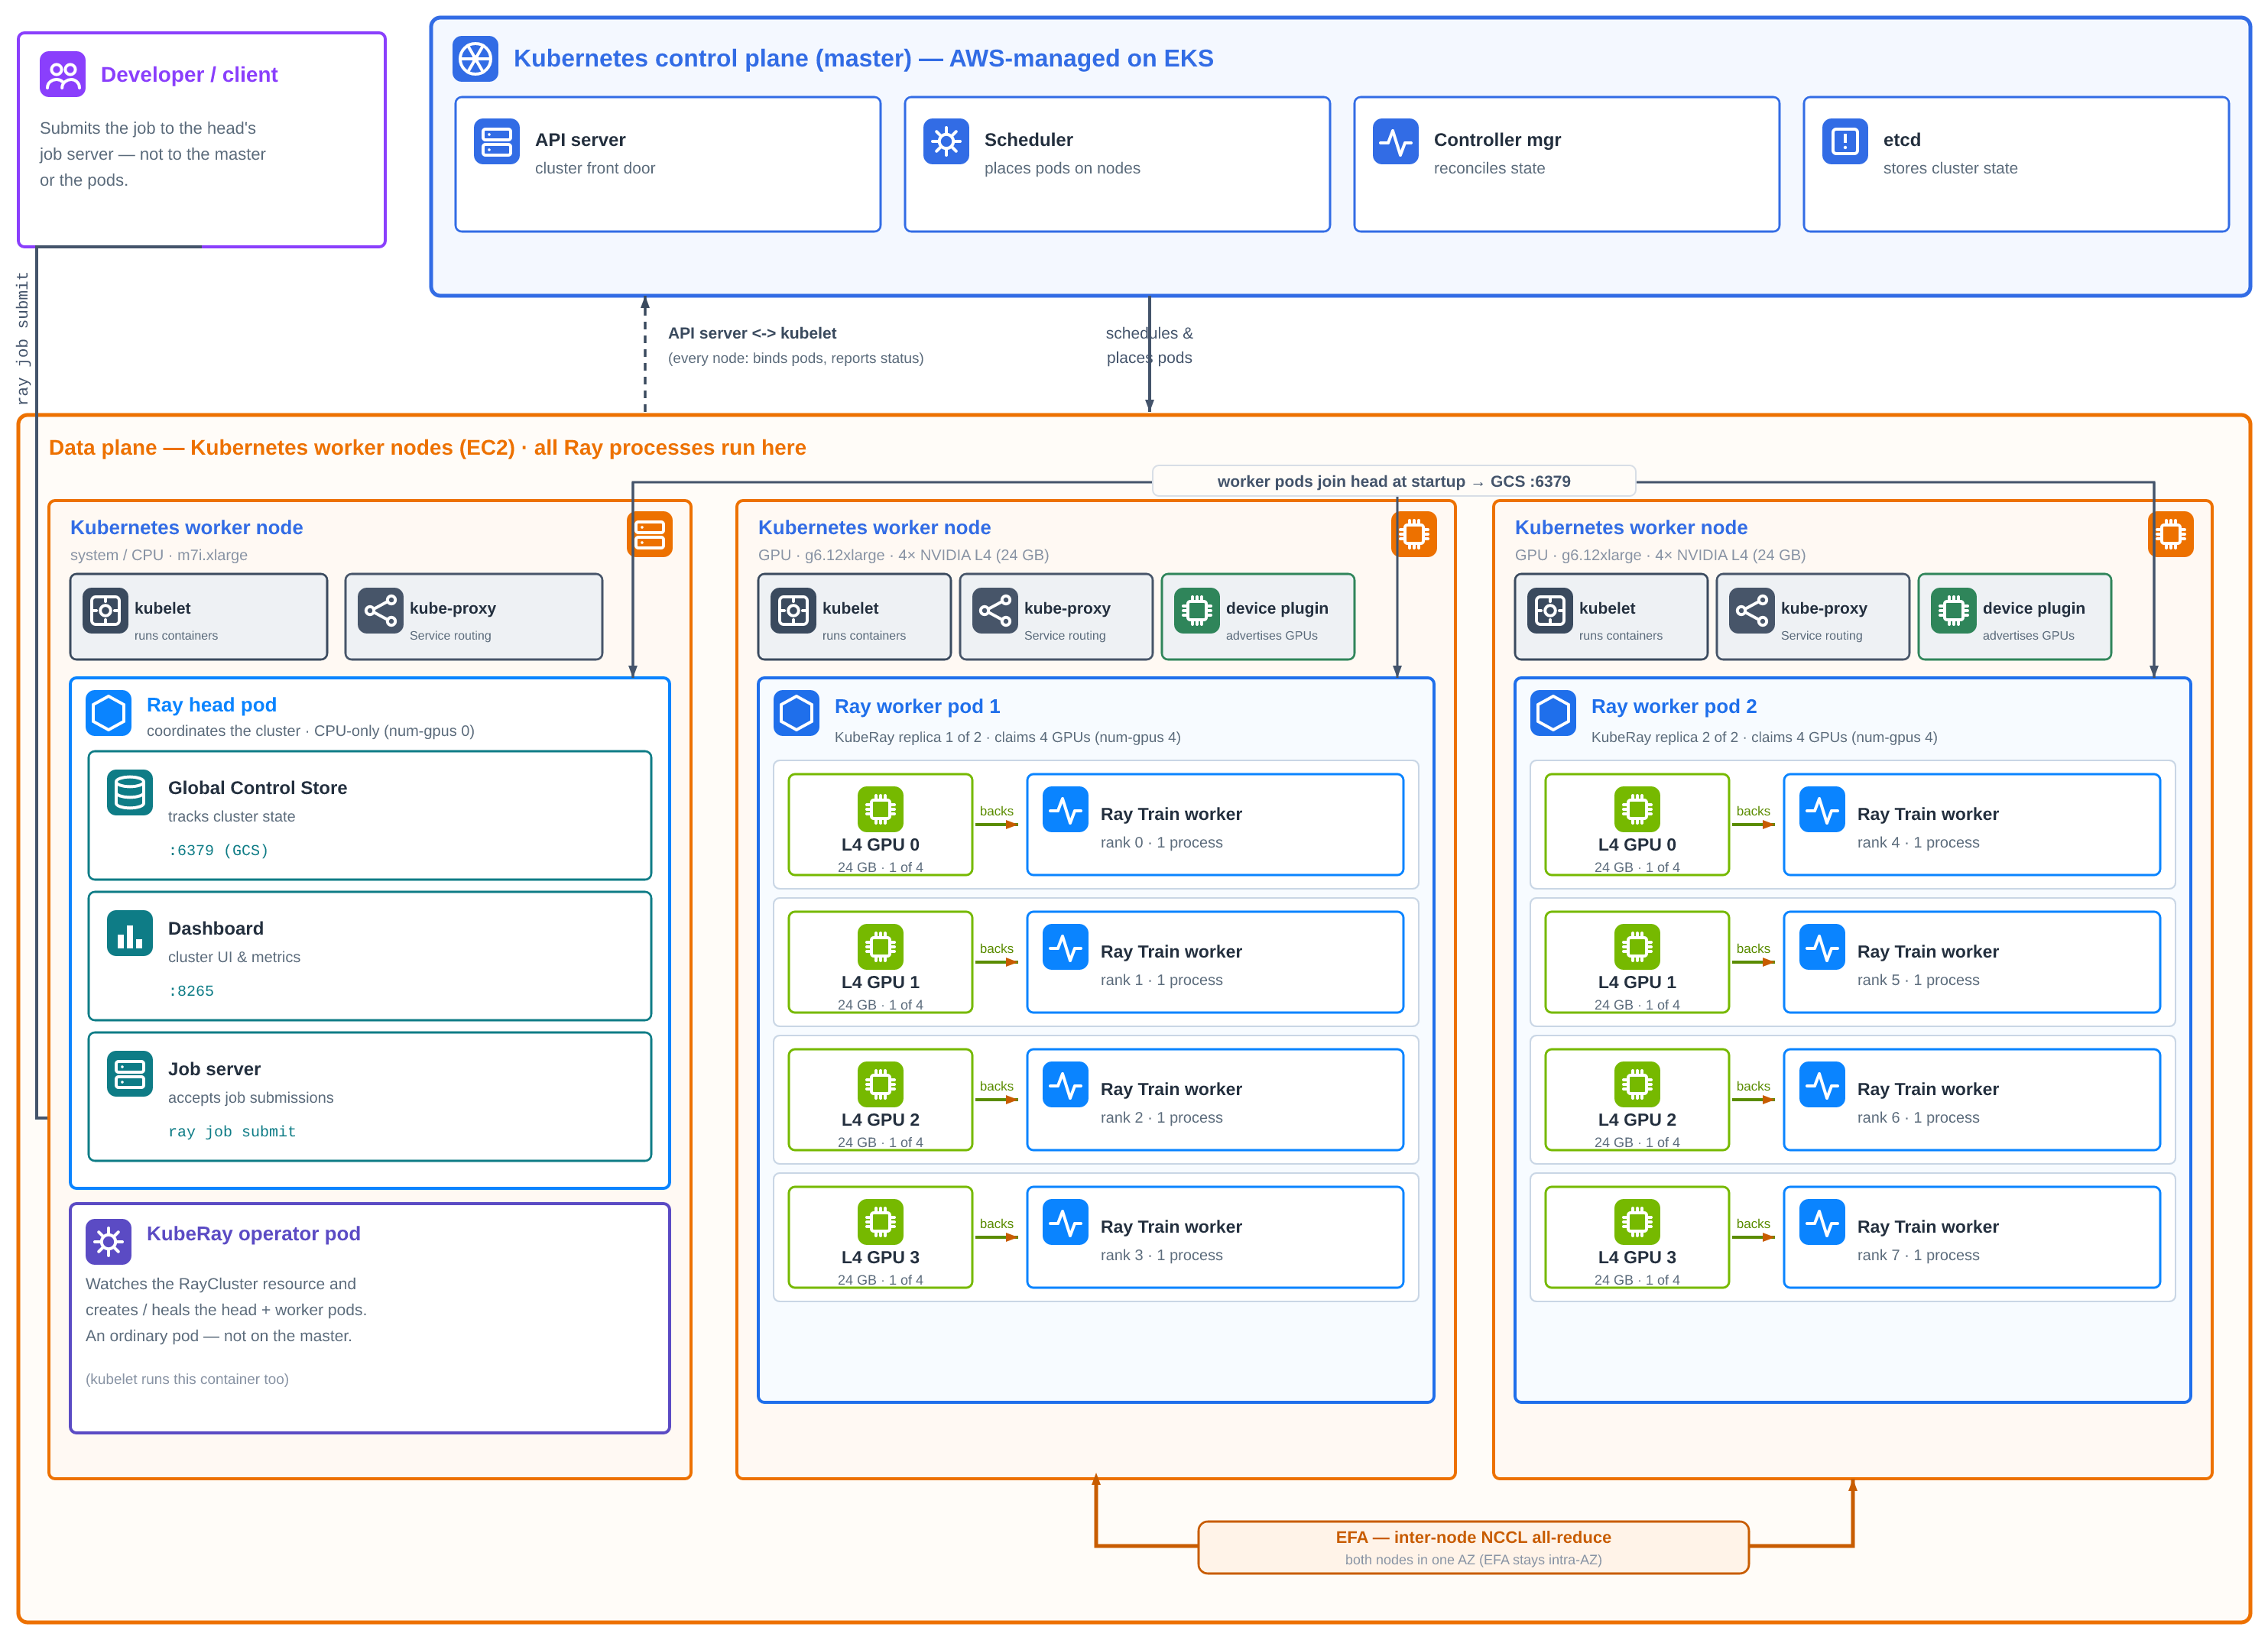
图 1:一个 EKS 集群,其控制平面由 AWS 管理,一个 CPU 系统节点(m7i.xlarge)运行 KubeRay operator 和 Ray head,两个启用了 EFA 的 g6.12xlarge 节点位于同一个可用区。KubeRay 根据一个 RayCluster 清单构建该集群,Ray Train 放置八个 worker,每个 GPU 一个,节点间集合通信通过 EFA 进行。
Ray 以单一集群的形式跨机器运行作业,包含两种角色。Ray head 负责协调并运行跟踪集群状态的全局控制存储,以及你提交作业所用的仪表板和作业服务器。Ray worker 节点提供 GPU 并运行训练进程。每个 worker 在启动时通过连接 head 的地址加入集群。在 Kubernetes 上,其中每一个都是一个 pod。Kubernetes 本身没有 Ray 集群的概念,因此必须有某个组件来创建 head 和 worker pod,在每个 pod 中以正确的角色启动 Ray,让 worker 指向 head,并替换发生故障的 pod。 KubeRay 负责完成这些工作。它是一个开源的 Kubernetes operator,新增了 RayCluster 资源:你在一个清单中描述 head 组和 worker 组,KubeRay 便据此构建并维护集群。
同一个带标签的镜像既作为 Ray head 运行,也作为 Ray worker 运行,无论 KubeRay 是在 Amazon Elastic Kubernetes Service(Amazon EKS) 上启动它,还是你自己在 Amazon Elastic Compute Cloud(Amazon EC2)上启动它。你需要添加的是配置:使用哪些实例、每个 pod 获得多少 GPU、NCCL 使用哪种网络传输,以及作业需要哪些额外的 Python 包。所有这些都在镜像外部设置。
本文通过一个示例完整演示了如何直接使用已发布的 DLC,在位于两台 g6.12xlarge 实例上的八块 NVIDIA L4 GPU 上,借助 PyTorch 全分片数据并行(FSDP)微调 Qwen2.5-1.5B。训练代码只有一个函数,集群只需一个 RayCluster 清单外加一个变量文件,全程无需构建任何镜像。由于 DLC 已内置 EFA 协议栈,两台实例之间的集合通信直接通过 EFA 在 pod 请求时立即启动。整个解决方案就在这个 示例仓库,并且它使用相同的 KubeRay-on-EKS 基础,作为我们的 多节点 Ray Serve 演练.
无需构建任何东西即可获得的内容
Ray Train DLC 是在 PyTorch 训练镜像之上叠加 Ray 训练库的镜像。本示例拉取的标签, public.ecr.aws/deep-learning-containers/ray:train-ml-cuda-v1.1,取代原本需要像这样构建的镜像:
| 层 | 原本需要自行构建并保持对齐的内容 | 在 Ray Train DLC 中 |
| 分布式运行时 | 支持 KubeRay 的版本,并带有 dashboard 和 job server 的 Ray | Ray 2.58.0,包含 Train、Tune 和 Data |
| 框架 | 为你的 CUDA 版本编译的 PyTorch | PyTorch 2.13.0、torchvision 0.28.0 |
| GPU 运行时 | 相互兼容的 CUDA、cuDNN 和 NCCL 版本 | CUDA 13.0.2、cuDNN、NCCL 2.29.7 |
| 网络 | EFA 安装程序、libfabric 以及 aws-ofi-nccl,基于该 NCCL 构建 |
EFA 最新版、AWS OFI NCCL 插件、GDRCopy |
| 训练库 | 为你的 CUDA 编译的 DeepSpeed、flash-attn 和 Transformer Engine | DeepSpeed、flash-attn、Transformer Engine、PyTorch Lightning、Hugging Face 库 |
| 诊断 | 从源码构建的 NCCL 测试 | all_reduce_perf 已在路径上 |
网络这一项是最少有团队愿意负责的。这里一旦不匹配并不会报错。NCCL 会退回到 TCP socket,作业仍会跑完,但速度只有应有的一小部分。在 DLC 中,这些库是一起构建并一起测试的,而且 AWS 对每个版本都以多节点 EFA 和多节点 KubeRay 训练测试作为发布门槛,而这正是本示例所走的路径。
还有几个特性可以省去你原本需要按集群逐个完成的工作:
- 无需配置镜像仓库—— 该镜像是公开的,因此节点无需凭证即可拉取,过程中不会构建或推送任何内容。
- 无匹配驱动—— 启动时,入口点会检查主机的 NVIDIA 驱动,如果它比镜像中的 CUDA 版本旧,就会自动启用随附的 CUDA 前向兼容库。
- 没有头节点与工作节点的镜像之分—— 该镜像没有固定角色。无论容器由什么启动,都会提供
ray start命令,因此一个标签即可服务于每个 pod。 - 没有单独的推理镜像系列—— Ray Train 共享了
rayECR 仓库,其中包含 Ray Serve DLC 以及 Ray LLM DLC,在train-ml标签前缀。
配置它,无需重建它
训练任务之间所有不同的部分都围绕镜像进行设置。示例使用了其中每一种机制:
| 你控制的部分 | 你如何设置它 | 在本示例中 |
| 头节点或工作节点角色 | KubeRay rayStartParams 每个 pod 组 |
同样 DLC_IMAGE 两者皆然。头节点以 num-gpus: "0" |
| 每个 pod 的 GPU 和 EFA 数量 | Kubernetes 资源请求 | nvidia.com/gpu: 4, vpc.amazonaws.com/efa: 1 |
| 网络传输 | Pod 或作业上的环境变量 | FI_PROVIDER, NCCL_NET_PLUGIN, NCCL_SOCKET_IFNAME, NCCL_DEBUG |
| 额外的 Python 包 | Ray runtime_env 在提交时 |
作业所需的任何软件包,在提交时安装 |
| 镜像版本 | 镜像中带版本号或摘要固定的标签 DLC_IMAGE |
train-ml-cuda-v1.1 |
| 集群形态 | 脚本中的变量/env.sh |
实例类型、节点数量、每节点 GPU 数、区域、可用区 |
| 训练作业 | 参数 train.py |
模型、步数、序列长度、批大小 |
每个作业的软件包。 该镜像已内置 HuggingFace 训练栈,因此本示例的作业无需额外添加任何内容。当某个实验确实需要镜像未包含的库时,Ray 会在提交时通过以下方式为该作业安装: runtime_env 且镜像保持不变。没有新镜像,也没有新标签。
每个作业的传输。 该镜像默认使用 FI_PROVIDER=efa,并且其 NCCL 配置排除了回环接口和 Docker 网桥接口。在 EKS 上,你将 NCCL_SOCKET_IFNAME 在 Pod 的 eth0示例在清单中仍然设置了全部四个网络变量,因此其行为在一个文件中即可见,而不依赖于镜像默认值。由于这些是普通环境变量,单个作业可以通过其 runtime_env.
你选择的版本。 示例将 train-ml-cuda-v1.1当前次要版本,因此集群可以从一次运行到下一次运行复现。 vX.Y 标签会随安全重建而更新。完全限定的 vX.Y.Z 标签则停留在原始发布构建上,因此当你需要字节完全一致的运行时,请固定一个摘要。同一镜像也可通过私有 ECR URI 获取。
集群的布局方式
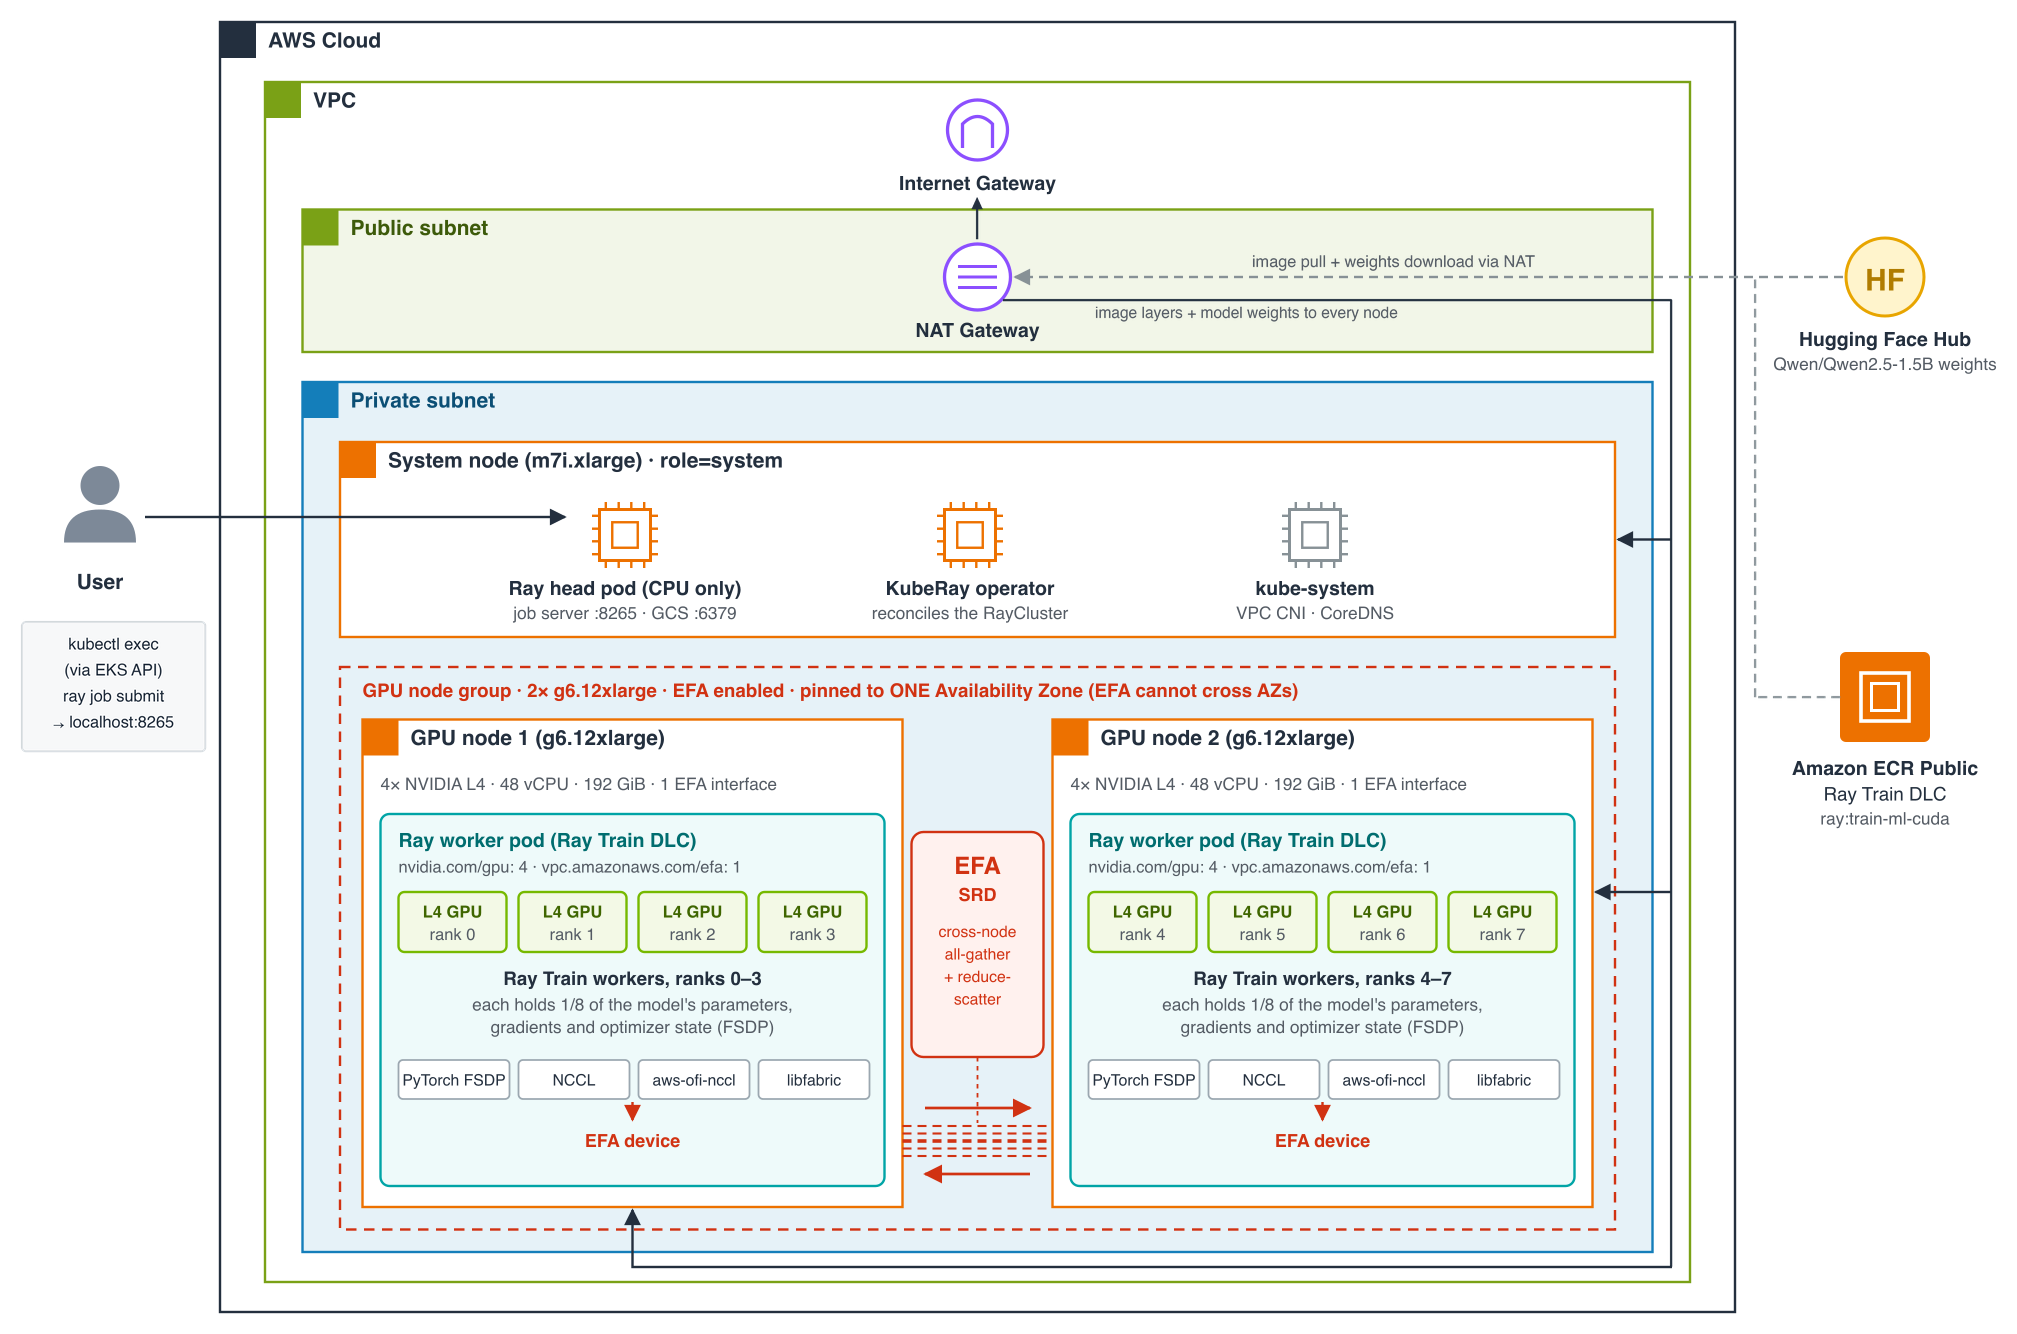
图 2:示例的集群。每个 pod 都运行来自 Amazon ECR Public 的同一个 Ray Train DLC。CPU 系统节点运行 KubeRay operator 和一个不带 GPU 的 Ray 头节点。每个启用了 EFA 的 g6.12xlarge(两者位于同一可用区)各运行一个四 GPU 的 Ray 工作节点 pod。
所有节点都位于同一个虚拟私有云(VPC)的私有子网中,并且仅通过 NAT Gateway 访问互联网;每个节点正是通过这种方式从 Amazon ECR Public 拉取 DLC,工作节点也通过这种方式从 Hugging Face 下载模型权重。一台 m7i.xlarge 构成系统节点组,承载 kube-system 附加组件、KubeRay operator 和 Ray head。head 在端口 8265 上运行作业服务器,在 6379 上运行 Ray 的控制存储,并且它不声明任何 GPU,因此不会有训练工作落到它上面。作业从 head pod 内部提交, kubectl exec,通过 EKS API 访问,因此端口 8265 永远不会暴露在集群之外。
训练运行在两台 g6.12xlarge 实例,每个实例配备四块 NVIDIA L4 GPU、48 个 vCPU、192 GiB 内存、40 Gbps 网络和一个 EFA 接口。每个实例运行一个 Ray worker pod,该 pod 占用全部四块 GPU 和 EFA 接口,Ray Train 在每个 pod 中放置四个 worker:一个实例上为 rank 0–3,另一个实例上为 4–7。由于 EFA 流量不跨可用区,脚本将两个实例放在同一个可用区,并已确认该可用区提供 g6.12xlarge。
Ray Train 在容器内执行的操作
该 DLC 提供了这套技术栈。 Ray Train 提供原本需要由启动器代码完成的部分。多节点 PyTorch 通常意味着在每台主机上为每块 GPU 启动一个进程,并为每个进程指定其 rank、world size 和 rendezvous 地址。使用 Ray Train 时,你将训练循环写成一个函数,并将其传给 TorchTrainer , ScalingConfigRay 会在集群中有 GPU 的每块 GPU 上启动一个 worker,组成 torch.distributed 进程组,并在每个 worker 上运行你的函数。
本示例要求 Ray Train 为 FSDP,它将模型的权重、梯度和优化器状态分散到全部八块 GPU 上,而不是复制到每一块上。bfloat16 格式的 Qwen2.5-1.5B 需要约 12 GB 来存放这四个张量。按八路分片后,每块 L4 GPU 大约持有 1.5 GB。代价是通信开销:FSDP 在使用每一层的权重之前会先收集这些权重,之后再对梯度进行 reduce-scatter,因此整个模型在每一步都会在各 rank 之间传输。在两个实例之间,正是这些流量由 DLC 的 EFA 协议栈承载。
前提条件
开始之前,你必须准备好以下各项:
- 工具: 已登录目标账户的 AWS Command Line Interface (AWS CLI) v2、eksctl、kubectl、Helm,以及
envsubst来自 GNU gettext。 - 配额: 两个 g6.12xlarge 实例的 96 个 vCPU 的 G 系列按需容量,且需位于至少有一个可用区提供该实例类型的 AWS 区域。如果你已经持有这些实例的按需容量预留,请设置
CAPACITY_RESERVATION_ID,脚本会将节点组启动到该容量预留中,并跳过容量搜索。 - 预算: 每小时约 9.50 美元,在 GPU 实例运行期间,涵盖两个实例、EKS 控制平面和 NAT 网关。
快速确认 CLI 是否指向你预期的账户:
aws sts get-caller-identity训练代码:一个函数和一个训练器
code/train.py 就是整个任务,其中不包含任何与容器、集群或网络相关的内容。Ray 会在 train_func 每块 GPU 执行一次。它向 Ray 请求自己的 rank,加载模型,将其交给 prepare_model 用于 FSDP,并运行一个普通的 PyTorch 循环:
code/train.py —— 每 GPU 函数(节选)
def train_func(config):
    ctx = ray.train.get_context()
    world_size, rank = ctx.get_world_size(), ctx.get_world_rank()
    device = ray.train.torch.get_device()

    model = AutoModelForCausalLM.from_pretrained(config["model_id"], torch_dtype=torch.bfloat16)

    # Any submodule above 10M parameters becomes its own FSDP unit. Wrapping by
    # size, not by a model-specific layer class, keeps the script model-agnostic.
    auto_wrap_policy = partial(size_based_auto_wrap_policy, min_num_params=int(1e7))
    model = ray.train.torch.prepare_model(
        model,
        parallel_strategy="fsdp",
        parallel_strategy_kwargs={"auto_wrap_policy": auto_wrap_policy},
    )
    optimizer = torch.optim.AdamW(model.parameters(), lr=config["learning_rate"])

    for step in range(config["steps"]):
        input_ids = torch.randint(0, model.config.vocab_size,
            (config["batch_size"], config["seq_len"]), device=device)
        optimizer.zero_grad()
        loss = model(input_ids=input_ids, labels=input_ids).loss
        loss.backward()  # parameters gathered again, gradients reduce-scattered
        optimizer.step()  # local: each rank updates only its own slice
        ray.train.report({"step": step, "loss": loss.item()})
驱动程序加入正在运行的集群,统计其 GPU 数量并启动训练器。由于工作进程数量来自集群,同一个脚本无需改动即可在单节点或多节点上运行:
code/train.py —— 驱动程序(节选)
ray.init(address="auto")  # join the RayCluster
num_workers = int(ray.cluster_resources().get("GPU", 0))  # 8 here

trainer = TorchTrainer(
    train_func,
    train_loop_config={...},
    scaling_config=ScalingConfig(num_workers=num_workers, use_gpu=True),
    run_config=RunConfig(name="ray-train-fsdp-llm"),
)
result = trainer.fit()
这些批次是随机 token ID,因此这次运行除了集群之外不依赖任何其他东西。样本的评判标准是真实的 FSDP 集合通信是否跨越了两个节点,以及作业是否完成。对于真实的微调,请用 Ray Data 或 DataLoader 流水线替换随机张量。函数中其他内容都不需要改动。
清单文件:这是配置 DLC 的唯一位置
manifest/raycluster.yaml 是镜像与集群交汇之处,它之所以简短,是因为镜像所需甚少。头节点唯一的特殊设置是 NVIDIA_VISIBLE_DEVICES=void,这可以防止容器运行时的 NVIDIA hook 在没有 GPU 的节点上失败。工作节点组承载其余所有内容:
manifest/raycluster.yaml —— 工作节点组(节选)
workerGroupSpecs:
  - groupName: gpu-workers
    replicas: 2
    rayStartParams:
      num-gpus: "${GPUS_PER_NODE}"  # keeps Ray's GPU count equal to the pod's
    template:
      spec:
        nodeSelector: { role: gpu-worker }
        containers:
          - name: ray-worker
            image: "${DLC_IMAGE}"  # the DLC as published; same tag as the head
            env:
              - { name: NCCL_DEBUG, value: "INFO" }  # print the chosen transport
              - { name: NCCL_SOCKET_IFNAME, value: "eth0" }  # pod network on EKS
              - { name: FI_PROVIDER, value: "efa" }  # libfabric: EFA, nothing else
              - { name: NCCL_NET_PLUGIN, value: "ofi" }  # load the AWS OFI plugin
            resources:
              limits: { nvidia.com/gpu: "${GPUS_PER_NODE}", vpc.amazonaws.com/efa: "1",
                cpu: "40", memory: 160Gi }
              requests: { nvidia.com/gpu: "${GPUS_PER_NODE}", vpc.amazonaws.com/efa: "1",
                cpu: "40", memory: 160Gi }
把它理解为三个决策。
哪个镜像: ${DLC_IMAGE},对头节点和工作节点均不做修改。
哪个硬件: 每个 pod 使用四块 GPU 以及该节点的单个 EFA 接口。请求 vpc.amazonaws.com/efa 正是它让 EFA 设备插件将接口挂载到容器中。没有它,NCCL 就无法识别 EFA,并会回退到套接字。
哪种传输方式: 四个环境变量,因此无需任何自动检测。
两个较小的细节可保持多节点作业稳定。首先,请求应等于限制,这会将工作进程置于 Kubernetes 的 Guaranteed 服务质量(QoS)类别中。这一点很重要,因为单个被限流或被驱逐的 rank 会拖住其他七个。其次, num-gpus 它源自与 GPU 请求相同的变量,因此 Ray 对容量的视图始终与 Kubernetes 保持一致。
提出这一点:基础设施只需一条命令,然后才是作业
配置集中在一处, scripts/env.sh:集群名称、区域、Kubernetes 版本、节点类型与数量、镜像、KubeRay 与两个设备插件的固定版本,以及训练参数。导出其中任意一项即可为某次运行更改它。全部五个脚本都是幂等的,可以安全地重复运行。 deploy_cluster.sh, deploy_node_group.sh,以及 deploy_ray_train_job.sh 在创建或操作集群资源之前,先执行每个提示。 install_gpu_plugins.sh 以及 install_kuberay.sh 是协调器,并且直接贯穿运行。
cd training/ray-train/scripts
source ./env.sh
./deploy_all.sh ——先找到容量实际所在的位置,再在那里构建基础设施。
g6.12xlarge 的容量在各区域和可用区之间每天都会变化,因此这只是一个起点,而不是事先猜定的某个区域。 env.sh它首先运行 find_gpu_capacity.sh它会针对每个候选区域检查:每个可用区是否提供 g6.12xlarge、账户的按需 G/VT 系列 vCPU 配额是否有空间容纳所请求的节点数量,以及作为容量信号的 EC2 Spot 放置评分。借助 --probe,它会 deploy_all.sh 默认通过,它会在每个候选可用区中创建并立即取消一个真实的容量预留,从而得到确定答案。随后它会显示计划并询问一次:
Proceed with the whole chain without further prompts? (y/N):回答 是,然后按顺序在推荐区域中运行 、 、 、 和 ,每个脚本都会跳过自己的重复确认,因为这个问题已经问过了( 也会跳过此提示,而 只显示计划,不创建任何内容)。如果 GPU 节点组无法在最佳可用区启动,脚本会将其移除,并尝试探测确认的下一个可用区。 还会与集群实际的私有子网进行交叉核对,而不仅仅是 g6.12xlarge 恰好提供的区域,因此 GPU 节点组不会最终被固定到某个可用区 依次运行, deploy_cluster.sh, deploy_node_group.sh, install_gpu_plugins.sh,以及 install_kuberay.sh 在推荐区域中,每个脚本都会跳过自己的重复确认,因为这个问题已经问过了(-y 也会跳过此提示,而 --plan (只显示计划,不创建任何内容)。如果 GPU 节点组无法在最佳可用区启动,脚本会将其移除,并尝试探测确认的下一个可用区。 GPU_AZ 还会与集群实际的私有子网进行交叉核对,而不仅仅是 g6.12xlarge 恰好提供的区域,因此 GPU 节点组不会最终被固定到某个可用区,而该可用区在集群中没有子网。所选区域和可用区会保存到 scripts/.placement.env其他所有脚本都会读取该文件,因此后续命令无需重新导出任何内容即可定位到同一位置。在全新区域中,这四个步骤总共需要 20 到 30 分钟。如果检测到现有集群或节点组,则会复用它们。
deploy_cluster.sh 会创建 EKS 控制平面、VPC、OpenID Connect (OIDC) 提供程序、核心附加组件以及 m7i.xlarge 系统节点组,并在实际提供 g6.12xlarge 的可用区中选择子网。 deploy_node_group.sh 添加两个开启 EFA 的 g6.12xlarge 实例,标记为 role=gpu-worker 以及 nvidia.com/gpu.present=true第二个标签是团队经常忽略的一个。缺少它,NVIDIA 设备插件图表的 DaemonSet 会在零个节点上运行,而且没有任何错误指向原因。 install_gpu_plugins.sh 确保两个设备插件都已存在。较新的 eksctl 会将它们打包进一个启用 EFA 的节点组,因此在全新集群上它会找到它们并跳过安装。否则,它会按固定的 chart 版本安装它们。无论哪种方式,它都会验证 nvidia.com/gpu 以及 vpc.amazonaws.com/efa 在每个 GPU 节点上都可分配,而不是信任一次成功的 Helm 发布。 install_kuberay.sh 将 KubeRay operator 安装到系统节点上,使其不占用 GPU 实例。
默认不会做的是运行训练作业。 deploy_all.sh 默认不会做的是运行训练作业。这仍然是一个单独的步骤,你可以随意重复运行,因为它是真正的作业运行而非基础设施,而且作业失败后绝不会让你重新走一遍集群设置流程。传入 --train 将其串联起来:
./deploy_ray_train_job.sh —— RayCluster、作业以及各项检查。
使用以下内容渲染清单: envsubst 并应用它。随后,在等待任何 Pod 之前,它会重新读取每个 GPU 节点的可分配资源:如果某个设备插件没有启动,你会在这里得到明确的错误,而不是让 Pod 一直停留在 Pending 状态直到超时。一旦 head 节点就绪且两个 worker 节点也都就绪,它就会复制 code/ 到 head 节点上,并通过 kubectl exec,并从其中提交:
ray job submit --address http://localhost:8265 --working-dir /tmp/ray-train-code \
python3 train.py --model_id Qwen/Qwen2.5-1.5B
submit 调用会流式输出全部八个 rank 的日志,并在作业结束时返回。随后脚本会检查 NCCL 使用了哪种传输方式;如果作业失败或 EFA 不在通信路径中,脚本会以错误退出,这也使它可用作持续集成(CI)门禁。 ./deploy_ray_train_job.sh status 会打印 RayCluster 状态、每个 Pod 由哪个实例承载以及 GPU 容量。正确配置的集群如下所示:
$ kubectl get nodes -l role=gpu-worker \
-o custom-columns='NAME:.metadata.name,GPU:.status.allocatable.nvidia\.com/gpu,EFA:.status.allocatable.vpc\.amazonaws\.com/efa'
NAME               GPU   EFA
ip-192-168-70-51   4     1
ip-192-168-92-26   4     1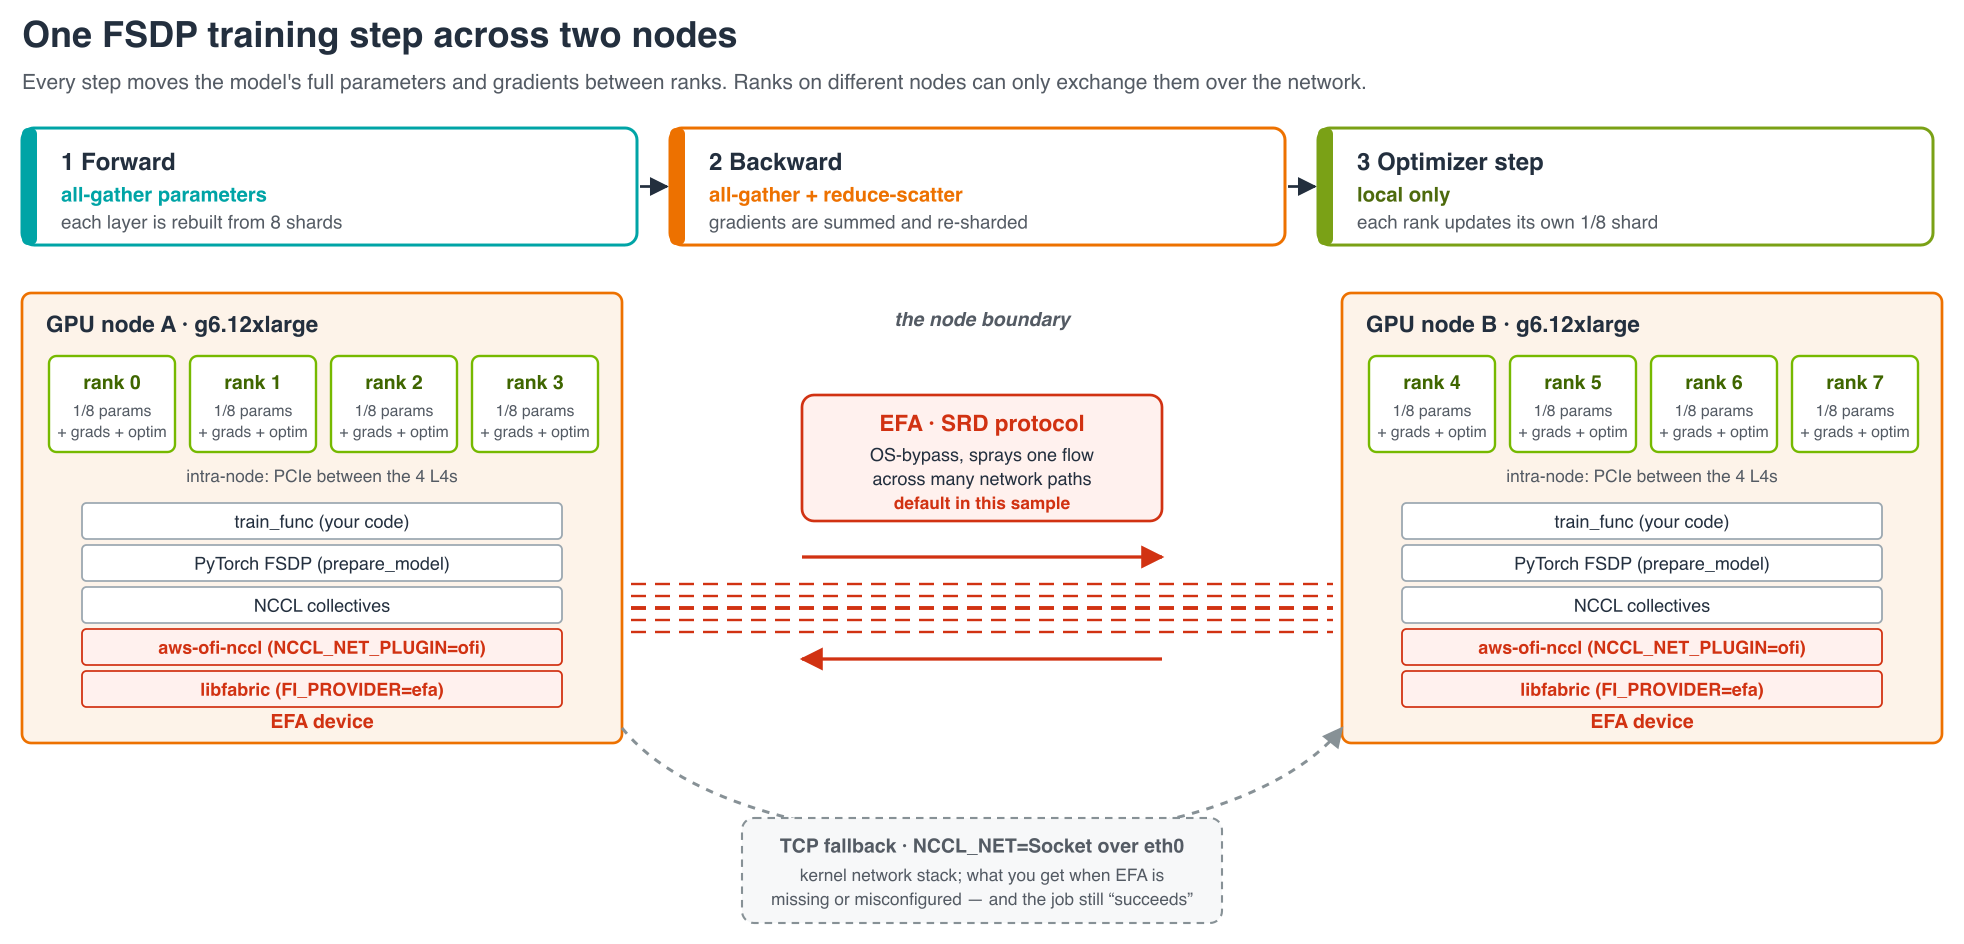
图 3:在此集群上执行一次 FSDP 步骤。权重在前向和反向传播过程中被收集,梯度则通过 reduce-scatter 进行归约分散。实例之间的流量走 DLC 镜像自带的路径,即 NCCL → AWS OFI NCCL 插件 → libfabric → EFA;当该路径缺失时,则回退到 TCP 套接字。
根据你的工作负载进行调整
由于镜像按发布状态使用,且作业从集群获知其规模,大多数改动只涉及一个文件:
| 你需要更改 | 在哪里 | 无需更改 |
| 该模型 | MODEL_ID |
代码、清单、镜像 |
| 步数、序列长度、批大小 | STEPS, SEQ_LEN, BATCH_SIZE |
代码、清单、镜像 |
| 训练循环本身 | 训练器、清单、镜像、脚本。额外的 Python 包 pip list。镜像将 DLC 版本固定到带版本号的标签。其他所有内容。GPU 实例系列、代码、镜像。有多少个 GPU 实例,以及清单中的 、 和 。代码(它会统计 GPU 数量)。区域或可用区,可选。其他所有内容。表中的变量除非另有说明,否则都位于 中。切换实例系列时, 必须与硬件匹配,并且该系列需要支持 EFA,还要出现在 EFA 设备插件的允许实例列表中。 train_func |
训练器、清单、镜像、脚本 |
| 额外的 Python 包 | --runtime-env-json pip list |
图 |
| 固定版本的 DLC 发布 | DLC_IMAGE 到带版本号的标签 |
其他所有内容 |
| GPU 实例系列 | GPU_NODE_TYPE, GPUS_PER_NODE |
代码、镜像 |
| 多少个 GPU 实例 | GPU_NODE_COUNT,加上 replicas, minReplicas 以及 maxReplicas 清单中 |
代码(它会统计 GPU 数量) |
| 区域或可用区 | REGION,可选 GPU_AZ |
其他所有内容 |
表中的变量位于 env.sh 除非另有说明。切换实例系列时, GPUS_PER_NODE 必须与硬件匹配,并且该实例系列需要支持 EFA,还要出现在 EFA 设备插件的允许实例类型列表中。此处固定的插件版本已知包含 g6.12xlarge。迁移到 p5 或其他支持 GPUDirect 的实例系列时,无需更改镜像或训练代码。
拆除
GPU 实例是开销最大的部分,连同控制平面和 NAT 网关,每小时约 9.50 美元。请按照与创建时相反的顺序删除各项:
./delete_ray_train_job.sh        # RayCluster
./install_kuberay.sh cleanup     # KubeRay operator
./install_gpu_plugins.sh cleanup # NVIDIA and EFA device plugins
./delete_node_group.sh           # GPU instances
./delete_cluster.sh              # EKS cluster, VPC and system node
接下来去哪里
两个实例和八块 GPU 在一个 EKS 上运行了一次分片微调,所用容器并非自行构建。Ray Train DLC 提供了一套经过测试的技术栈,从 CUDA 一直到 EFA。KubeRay 使用同一个标签将其启动为 head 和 worker。Ray Train 负责放置 worker 并组建进程组。所有可变的部分,从硬件到传输方式再到 Python 包,都是从镜像外部设置的。镜像自带的 EFA 路径通过四个环境变量生效,在代码不变的情况下,吞吐量相比 TCP 翻了一倍。
接下来可以做的:
- 将随机批次替换为真实数据集,并设置检查点保存到 Amazon Simple Storage Service (Amazon S3) 或 Amazon FSx for Lustre。
- 固定
DLC_IMAGE固定到带版本号的标签,以实现可复现的运行。 - 开启
FailureConfig这样长时间运行的任务在丢失一个实例后仍能继续。 - 迁移到 p5 等支持 GPUDirect RDMA 的更大机型系列。镜像和代码保持不变。