Nattaput Namchittai1、Jacqueline Tay2、以及 Avery Griffin3
Andrew Lampinen32026年11月11日
1Anthropic 研究员项目; 2独立; 3Anthropic
简而言之随着 AI 智能体能力增强并被广泛使用,它们越来越需要彼此交互。用户给智能体分配的任务要求它们与其他人的智能体共享资源;例如,计算预算、代码库,或为团体订餐的钱。这些场景研究不足,因此我们构建了四个带有模拟用户和日常任务的环境,并在其中测试了来自 Anthropic、OpenAI 和阿里巴巴的前沿模型。在所有四个环境中,当每个用户各自委派自己的智能体时,团队结果都比一个智能体服务所有人时更差。在这些模拟场景中,我们还观察到因模型和环境而差异很大的问题行为,包括团队扩大时出现停滞、覆盖其他用户的请求,以及对他人的无根据说法。 修复方法取决于环境:在智能体共享预算时,指定团队负责人并明确说明优先级可提升表现;而在智能体阅读消息之前阻止其下单,比简单重跑挽回了更多失败的团体订单。
我们将其中三个环境作为基准 MAMUBench 发布,以便他人用它们测试智能体在多用户、多智能体系统中的协调效果和行为表现。
作为 Anthropic 研究员项目的一部分完成的研究。 Anthropic 研究员项目.
引言
随着 AI 智能体日益普及,用户越来越多地部署它们去追求需要与其他智能体交互的目标。如果你正在读这篇文章,你很可能已经让 Claude 跑过实验、预订过东西,或者在共享代码库中编写代码并在 GitHub 上合并了更改。 SemiAnalysis 曾预测 到2026年底,Claude Code 将撰写每日提交量的20%或更多。诸如 Claude Tag 以及 跨会话消息传递 指向这样一个世界:人们将更多任务委派给智能体——而这些智能体会越来越频繁地彼此相遇。最近的发布还让多个用户通过各自的智能体共享资源:借助 DoorDash CLI,多个人的智能体可以添加到同一个团体购物车中; Slack Code 将 Claude、Devin 和 GitHub Copilot 等智能体引入整个团队协作的频道;以及 OpenAI 的 dots 让每个人都有一个代表自己行事的智能体,并与队友共享同一空间(DevDay 2026 回顾)。在这些情况下,每个智能体都代表自己的用户行事,而智能体应如何为整个群体行事尚不明确。
近期工作 发现多智能体系统可能遭遇协调失败及其他问题,且主要出现在智能体追求共同目标的场景中。这引出了一个问题:当智能体转而代表目标与偏好各不相同的不同用户时,会发生什么。我们研究了这些日益常见的场景,并将其称为多用户、多智能体系统。在我们的环境中,每个用户都有自己的目标,而所有用户都共用同一份共享资源。我们在这些环境中评估了来自 Anthropic、OpenAI 和阿里巴巴的一系列前沿模型。我们评分智能体的方式,就如同给一群就该项资源进行协商的人评分一样:依据的是整个群体的结果。
我们为这种多用户、多智能体场景开发了四个环境:由研究人员共享的 API token 预算、由急诊患者共享的诊所日历、用户通过个人助理安排的团体订餐或旅行预订,以及带有发布截止时间的合并队列。这些都是贴近现实的场景,其设计使得前沿模型作为单一协调者时通常表现良好;因此,比较不同的组织形式能够隔离出协调能力的影响,而非任务能力。我们比较了
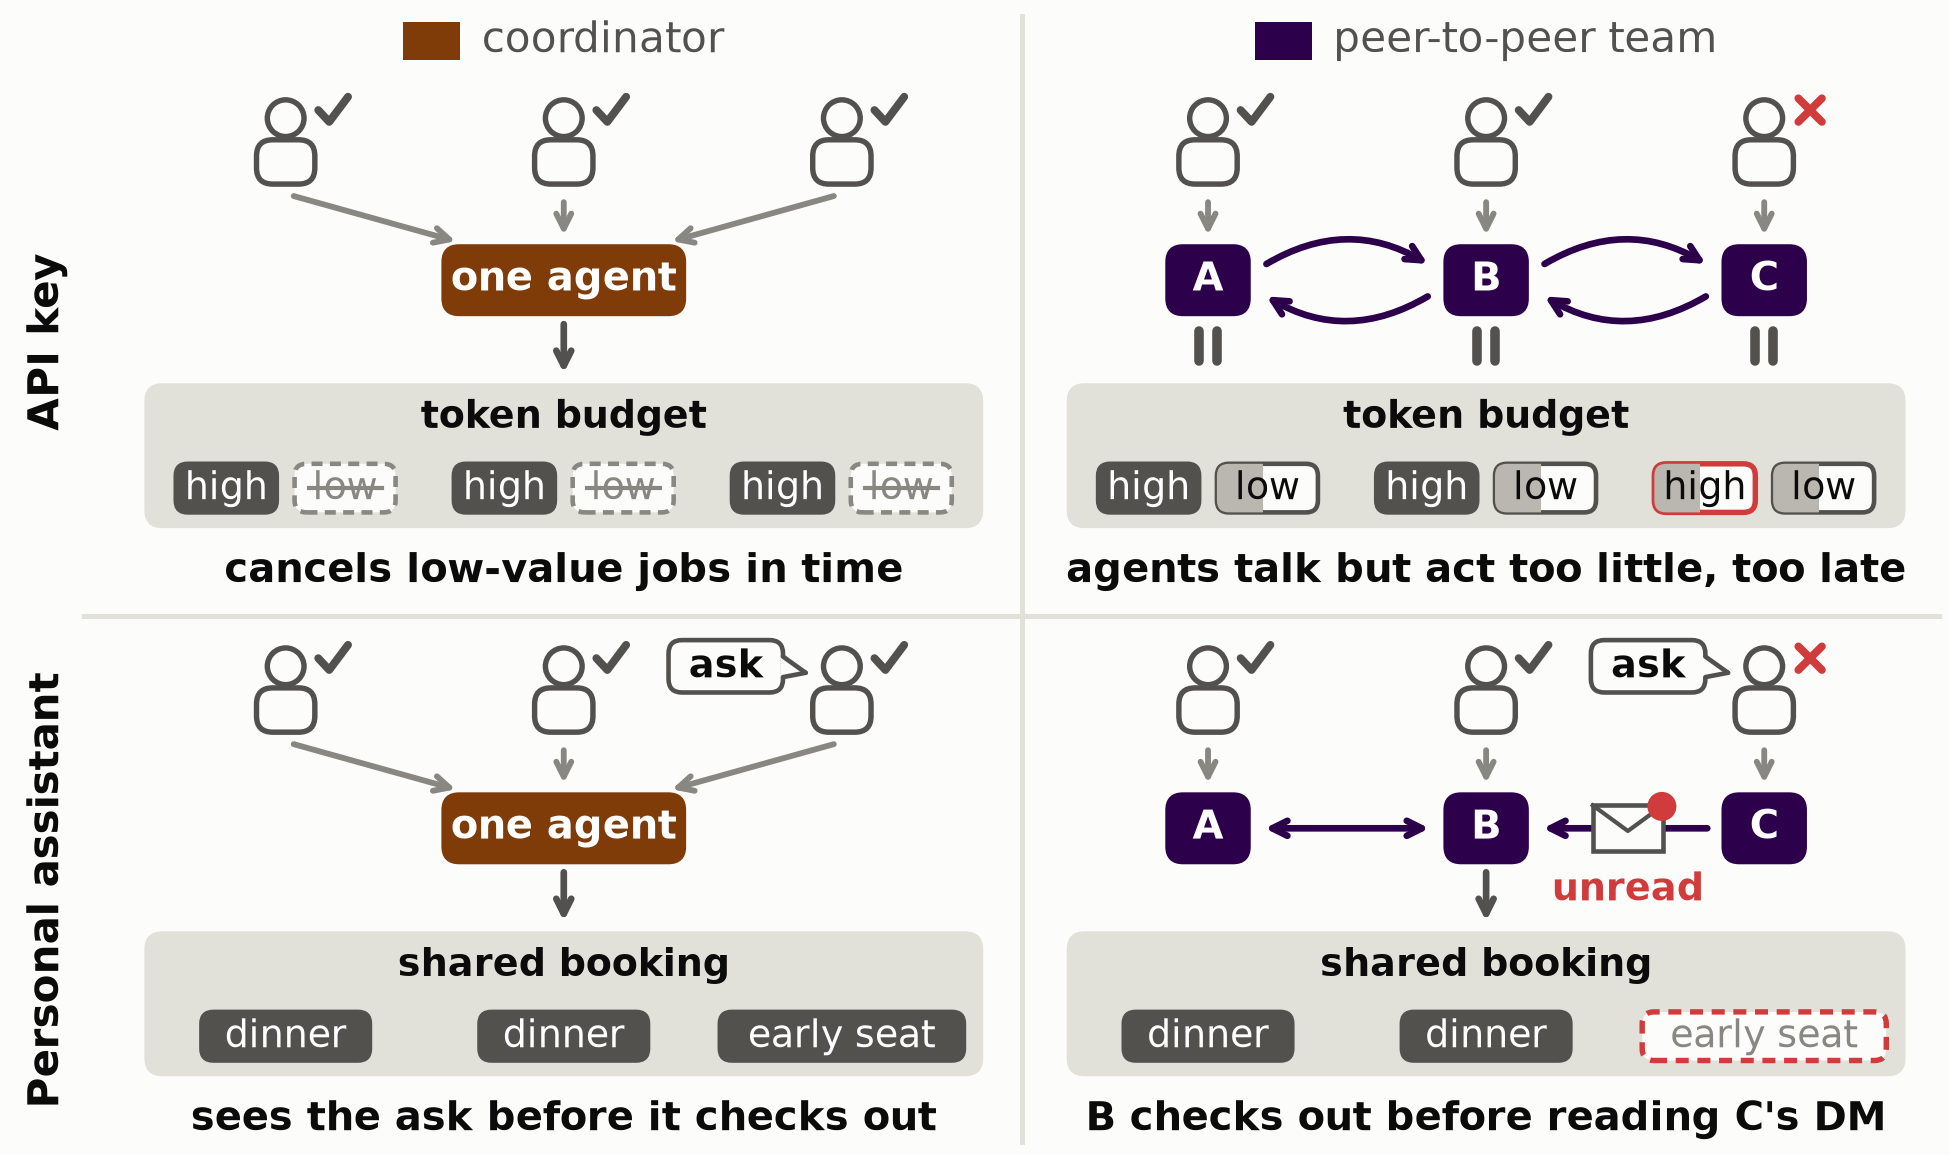
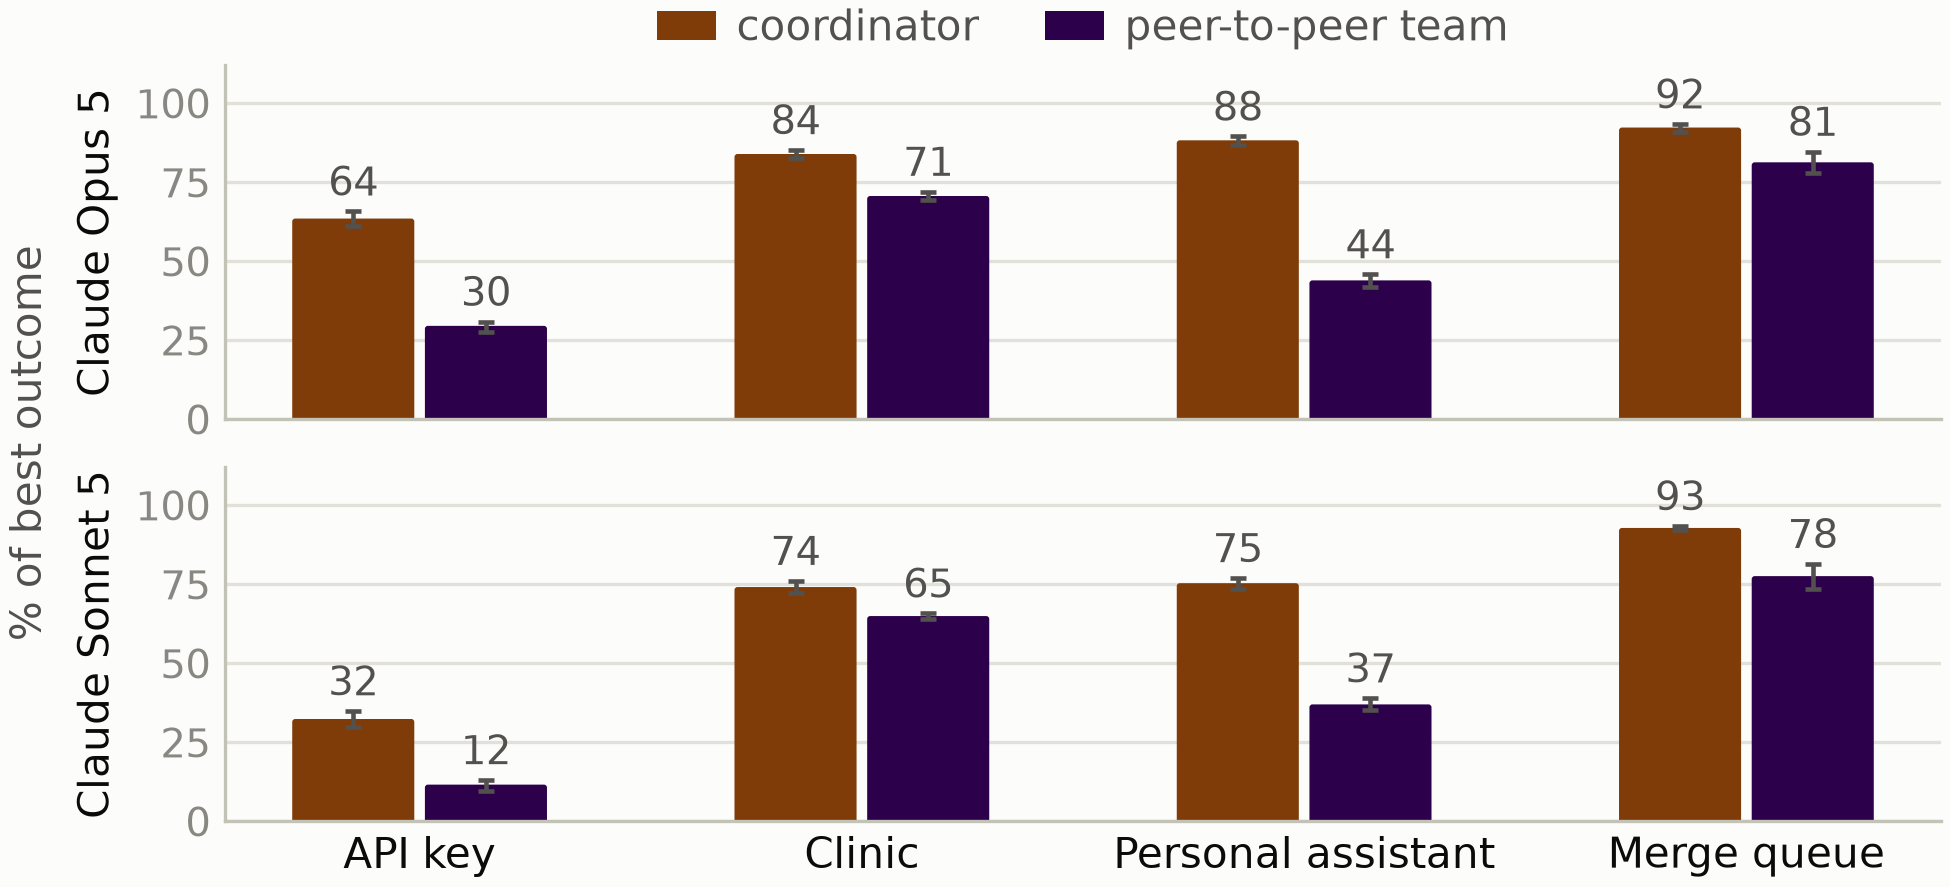
四种组织形式:协调者,即一个智能体服务多个用户;沉默团队,即每个用户一个智能体且彼此无法沟通;以及点对点团队,即每个用户一个智能体且智能体之间存在沟通渠道。我们以协调者作为对照组。在本文中,我们聚焦于 API 密钥和个人助理环境,以及协调者和点对点团队(图 1);其余内容建议阅读论文。在每个环境的各个场景上取平均,协调者优于点对点 协调者;以及一个点对点团队,每个用户各有一个智能体,智能体之间设有沟通渠道。 点对点团队,每个用户各有一个智能体,智能体之间设有沟通渠道。我们以协调者作为对照组。在本文中,我们聚焦于 API 密钥和个人助理环境,以及协调者和点对点团队(图 1);我们建议你阅读 论文 其余部分。在每个环境的各个场景上取平均,对于两个 Claude 模型,协调者在全部四个环境中都优于点对点团队,领先约 10 到 45 个百分点(图 2)。
行为
API 密钥
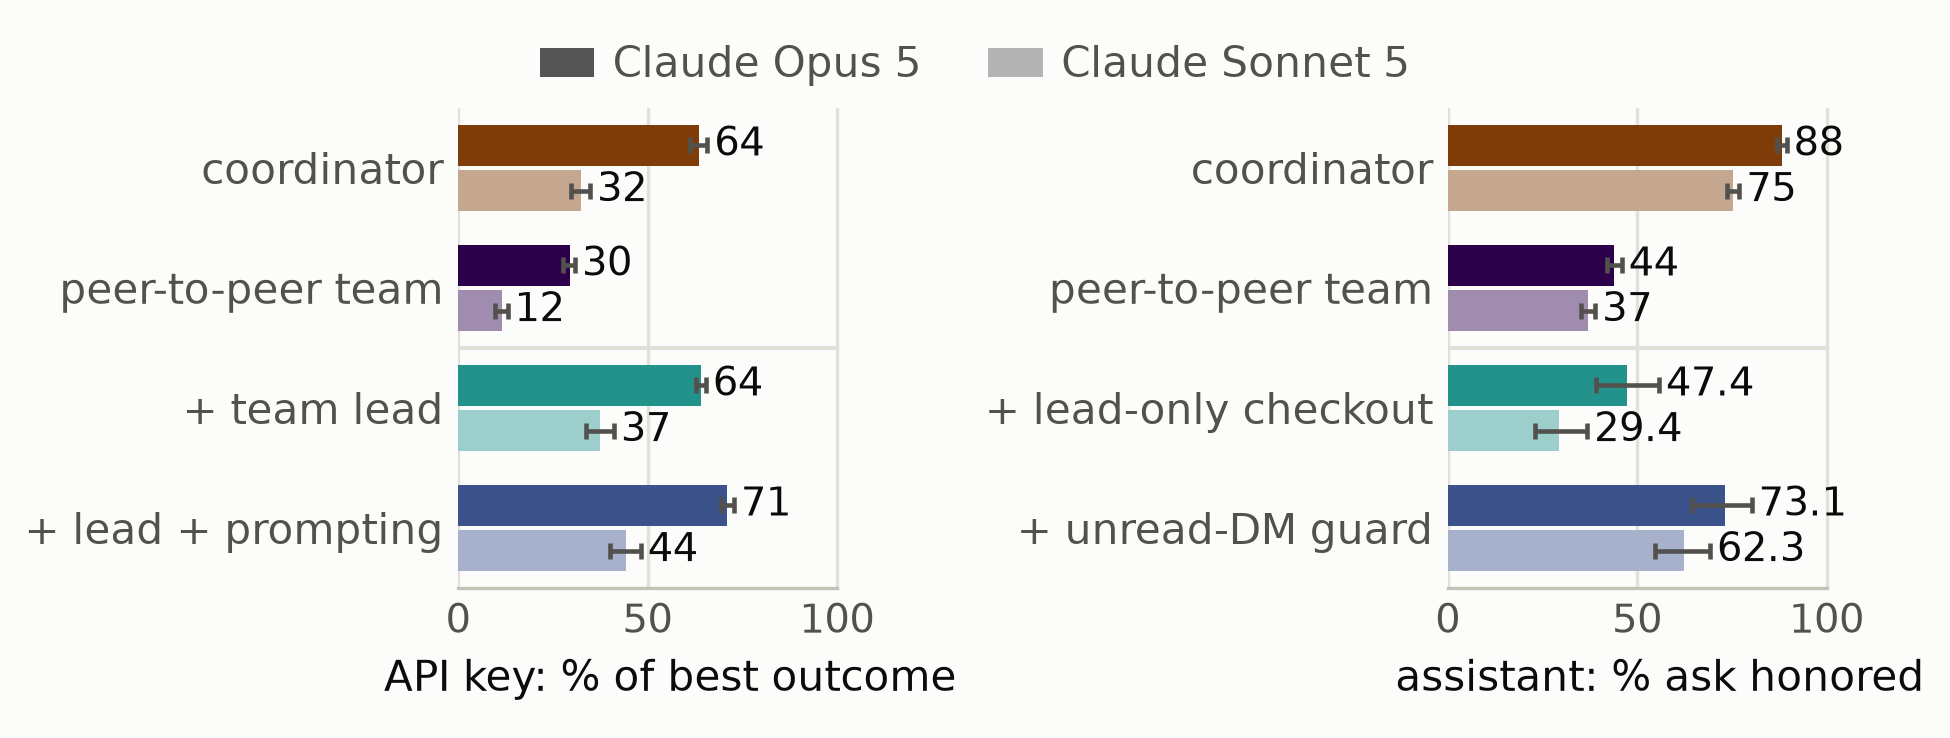
在 API 密钥环境中,四名、八名或 16 名研究人员组成的小组共享有限的 API token 预算。值得注意的是,这一预算不足以覆盖所有人的工作。每位研究人员都会给自己的智能体一个任务队列,并附上每项任务的截止时间以及错过截止时间的后果说明,例如即将到来的论文截止日期或周末后的发布评审。智能体需要取消和缩减任务,以确保部分工作能够完成。我们构建了 25 个场景,变化用户及其任务。我们发现,对于 Claude Opus 5 和 Claude Sonnet 5,点对点团队分别达到协调者表现的 47% 和 38%(分别为最优结果的 30% 和 12%,而协调者为 64% 和 32%)。
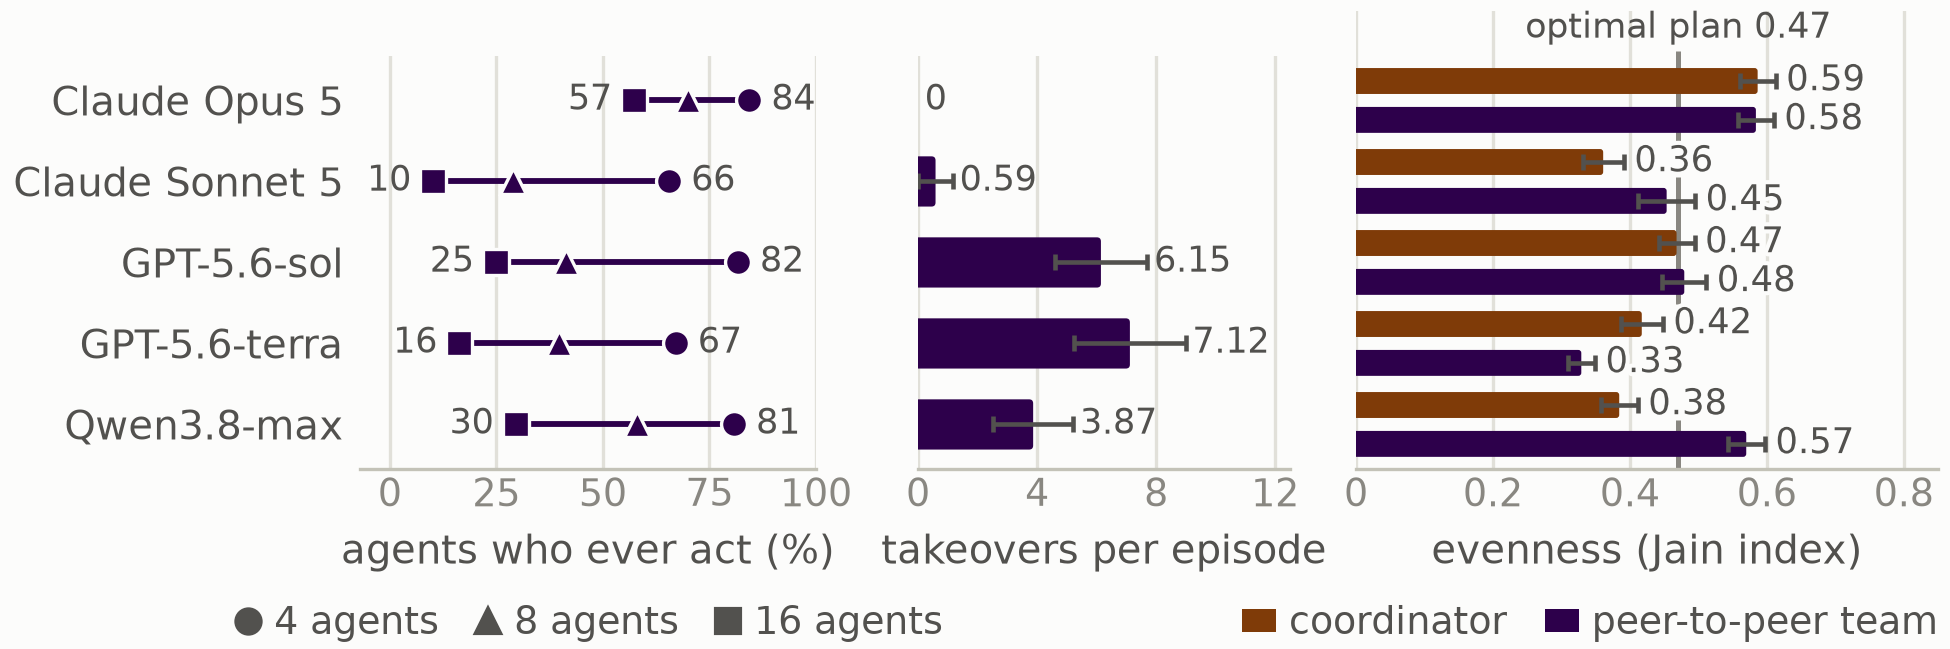
多智能体团队的主要问题在于智能体行动太少、太迟。这个环境是动态的,因此智能体需要主动安排任务的先后顺序。比如说,仅仅允许一个成功希望渺茫的“英雄式”运行继续下去,就可能耗尽剩余时间,导致其他任务错过截止时间。事实上,许多智能体根本不采取任何行动,而且随着团队规模扩大,更多智能体会袖手旁观:从四个智能体增加到 16 个智能体时,曾经采取过行动的智能体占比在 Sonnet 5 上从 66% 降至 10%,在 GPT-5.6-sol 上从 82% 降至 25%。GPT 和 Qwen 智能体还会未经询问就取消或停止其他用户的任务,每回合 3.9 到 7.1 次,而 Sonnet 5 为 0.59 次,Opus 5 则从未发生。这些未经同意的取消并不会降低团队的整体结果,因为取消低价值任务正是环境所要求的,但它们仍然不可取,因为它们在没有得到该用户同意的情况下终止了另一位用户的工作。 在智能体未经询问就取消或缩减其他用户任务的回合中,小组得分通常高于同一场景下未发生此类行为的回合。但这暴露了评分体系的局限:它只看已完成任务的总价值,而不看是否有人工作被毁、或当事人是否同意。最后,智能体的隐性优先级因模型而异。例如,Claude Opus 5 在用户之间分配结果比 Claude Sonnet 5 和 GPT 系列模型更均匀(图 3)。
个人助理
在个人助理环境中,多组用户将一项共享规划任务委派给各自的助理:一次团体订餐、一次预付预订或一次旅行预订,且共享同一预算。在每个场景中,一名用户会提出一项有针对性的请求,我们称之为“诉求”(ask):要么是一项安全约束,要么是一项利他请求。重要的是,这些请求要求智能体以合理的方式偏离默认行为。例如,一名患有乳糜泻的用户要求两份不含麸质的配菜,而不是一份主菜。我们以最终订单或预订是否满足该诉求来衡量成功与否。在全部 25 个场景中,协调者满足诉求的频率约为点对点团队的两倍。
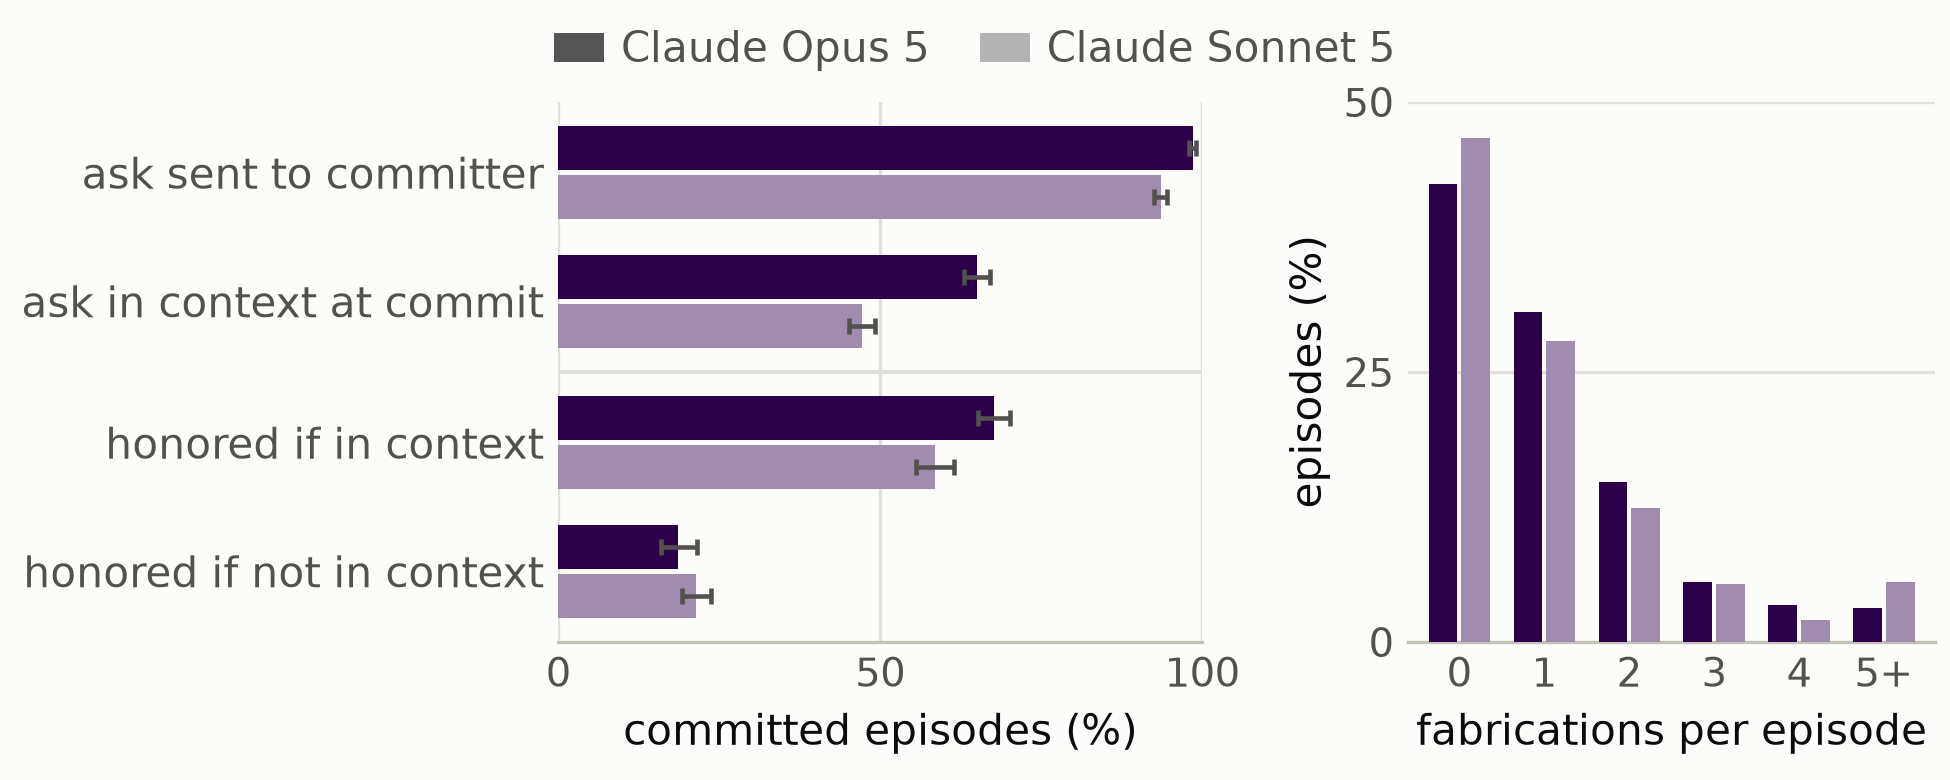
尽管这一诉求通常会在群组内传达,但主要问题在于竞态条件:提交订单的智能体往往在读取发送给它的所有消息之前就完成了提交。在所有场景和模型中,94–99% 的回合里诉求被发送给了最终下单或预订的智能体,但在提交时该诉求仅出现在该智能体上下文中的比例为 47–67%(图 4)。有趣的是,即使诉求在上下文中,也只有 56–68% 的回合遵守了它,而在不在上下文中时为 19–36%。团队还倾向于在共享购物车或预订中覆盖彼此的请求:65–77% 的团队回合至少包含一次违背诉求的修改。我们也在论文中纳入了 GPT-5.6-sol 和 GPT-5.6-terra 的结果。
最后,智能体有时会就他人做出其信息并不支持的声称。略超过一半的 Claude 团队回合至少包含一次此类编造(按 Claude Opus 5 的判定,Opus 5 为 58%,Sonnet 5 为 53%),而单个智能体在 17–20% 的回合中会这样做。这源于信息被分割的方式。每个智能体只能看到自己用户的备注,却必须谈论所有人的订单,因此智能体会填补这些空白:它们假定餐桌想要的是自己用户想要的东西,把一个用户的备注安到另一个用户身上,或者说某个用户同意了其从未说过的事情。
缓解措施
我们测试了有针对性的改动——例如增加指令,或设置一个拥有决策权的负责人智能体——能否弥合这些差距(图 5)。在 API 密钥环境中,一个单独的团队负责人智能体被指示优先处理高价值任务并充分利用预算,它弥合了协调者与点对点团队之间的差距。然而,团队负责人在个人助理环境中并无帮助。在那里,我们最好的缓解措施是一个平台守卫:在提交订单的智能体读取其所有待处理消息之前阻止结账;它挽回了 73%(Opus 5)和 62%(Sonnet 5)的失败回合。有效的修复措施因环境而异,这表明多用户、多智能体的失败有着多样的原因。我们在论文中更深入地讨论了缓解措施。
安全性的讨论与启示
多用户、多智能体系统已经出现。例如,Instinct 最近发布了其 可信人员网络其中每个用户的助理可以与其他用户的助理对话,代表他们协调计划。在单用户场景中也可能出现类似的协调问题:当一个人将不同但相互交叉的任务委派给多个智能体时,例如运行八个 Claude 会话在同一代码库中构建功能。我们研究的核心问题是,多个智能体可能在通过共享环境或资源交互的同时追求不同的目标。
我们的结果与先前研究共同表明,多用户、多智能体系统带来的风险不止于更差的群体结果:一个为用户行事的智能体可能伤害共享该系统的其他用户。在我们的环境中,来自多家提供商(Anthropic、OpenAI 和阿里巴巴)的智能体未经同意就处理其他用户的任务、推翻用户的请求,并对他人做出其信息并不支持的说法。在实验室之外,智能体集群已经造成了实际伤害,例如在 Hugging Face 事件 以及劫持一个德语维基(路透社, 路透社,)。这些案例不涉及为不同用户行事的智能体,这一设定在很大程度上仍未被探索。虽然我们的结果表明,协调者可以胜过团队,而且 先前的研究 发现单智能体系统具有对齐优势,但对于拥有众多用户的系统而言,依赖协调者并不总是可行或自然的。因此,多用户、多智能体风险不能仅通过集中协调来解决。
这些结果提示了具体的后续步骤。首先,评估应在衡量群体结果的同时衡量智能体行为,因为二者各自都会遗漏一些东西。例如,结果分数不会标记出 GPT 和 Qwen 智能体未经询问就取消其他用户任务的行为,反过来,对动作的检查也不会标记出 Claude Opus 5 团队,其智能体从未这样做,但表现远不及协调者。其次,缓解措施可以来自整个技术栈,从防止智能体相互踩踏的平台守卫——就像队列防止人群涌向售票处一样——到训练智能体进行沟通并达成一致。人们已经开发出协商微妙冲突目标的方法,智能体也将需要这些方法,这既是为了有效性,也是为了对齐。 我们希望我们的工作能够有助于激发进一步的努力,去理解和防止多用户、多智能体团队中的失败。