人工智能
修复评估偏差,在 Amazon Bedrock 上解锁更好的模型本文由 Property Finder 的 Khaled Thabit、Meriem Boughrara 和 Mohamed Desouky 共同撰写。
数字房地产应用 Property Finder的工程团队发现,其评估标签中有 96.8% 直接沿用了单一模型的预测结果,而非经过人工专家核验。他们的真实基准系统性地偏向现有模型,使所有替代方案都显得表现不佳。这些标签也存在错误,但真正阻碍客观模型对比的是这种偏差。他们是在将视觉 AI 工作负载迁移到 Amazon Bedrock.
上更具成本效益的方案时发现这一问题的。Property Finder 每天在中东和北非(MENA)地区处理数万张房产图片。其系统对每张图片评估 11 项质量属性,涵盖水印检测、房间分类、装修状态、照片质量和建筑特征指标。这意味着每天有数千条新房源上线,每条平均包含 15 张图片,全部都需要在上线前完成质量评估。
Property Finder 需要一个更具成本效益的方案。但以那些标签为基准来衡量,任何替代方案都处于劣势。
最难的部分并不是找到更好的模型,而是发现他们的评估方法本身就是障碍。
在本文中,我们分享 Property Finder 如何识别评估偏差、构建无偏的真实基准,并应用进化式提示词优化在 Amazon Bedrock 上选出合适的模型,最终实现更高的准确率和 86% 的成本降低。我们将逐步介绍该方法论和迭代示例,其中的经验可供您应用于自己的工作负载。
下图展示了 Property Finder 与 AWS 生成式 AI 创新中心团队用于在 Amazon Bedrock 上迭代提升分类准确率的提示词优化循环。
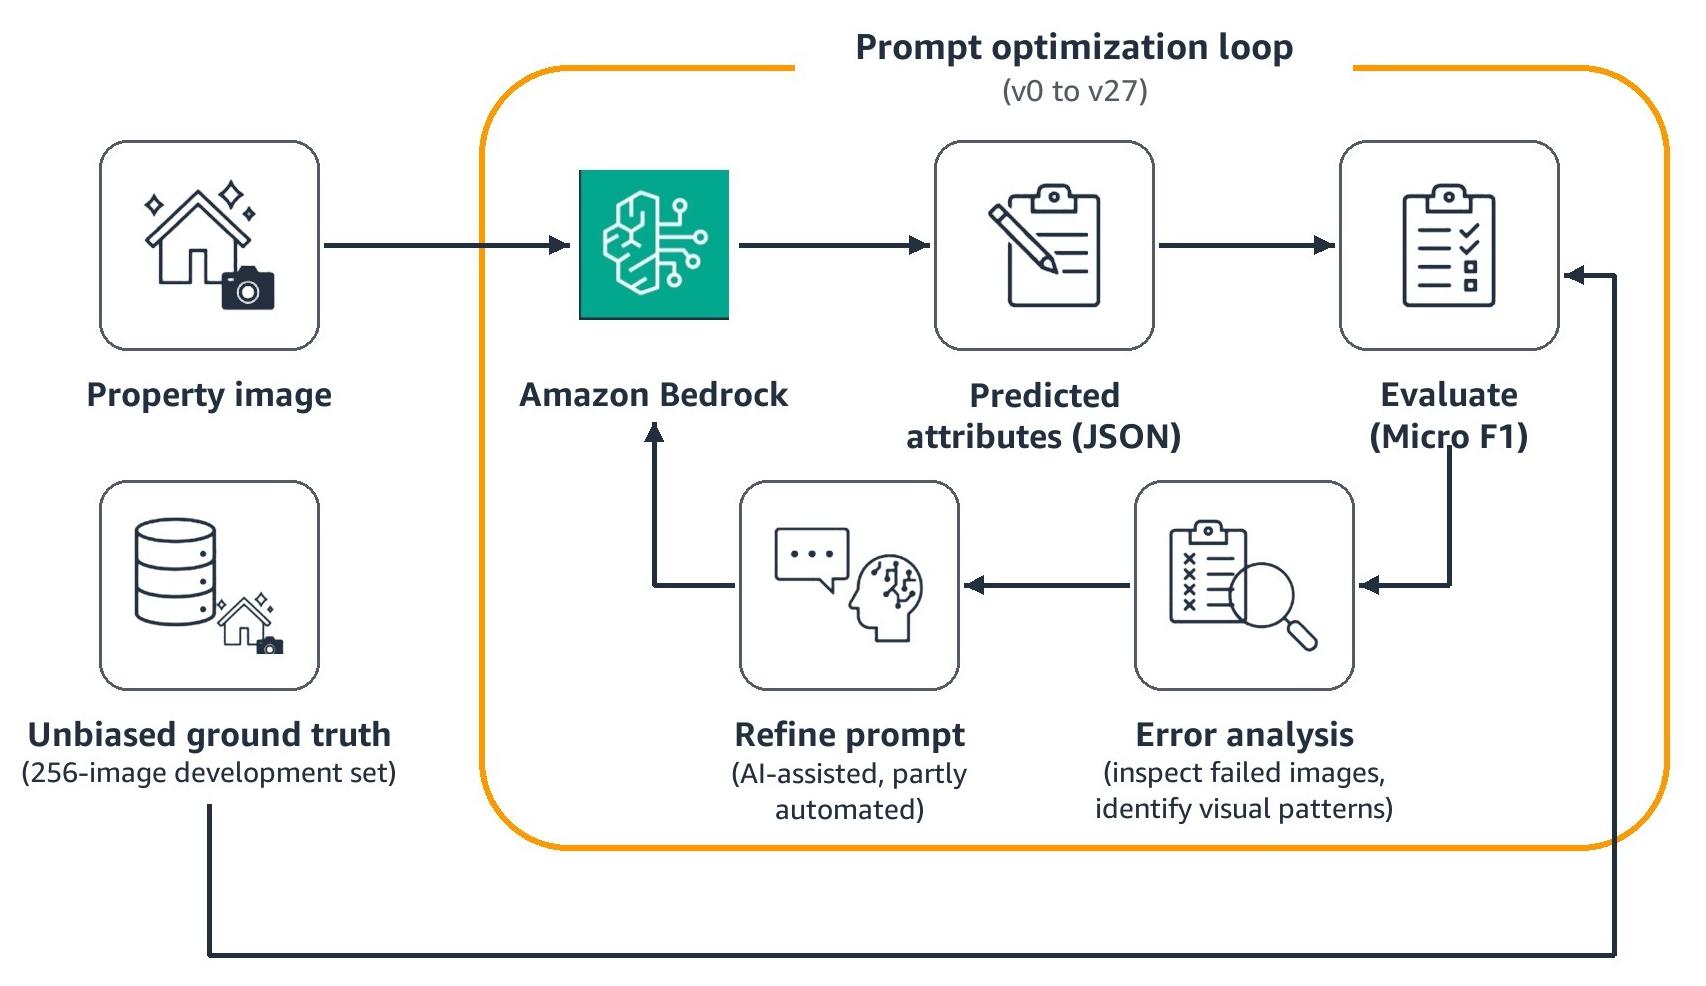
图 1:提示词优化循环架构
该图展示了迭代式提示词优化循环。房产图片由 Amazon Bedrock 处理,以 JSON 格式输出预测属性。在优化过程中,这些预测结果会与包含 256 张图片的专家标注开发集进行 Micro F1 评分对比。随后通过错误分析检查失败图片并识别视觉模式,为下一个提示词版本提供依据。该循环从 v0 运行到 v27。AI 助手协助优化提示词,后期版本采用了自动化优化。
你的评估可能在骗你
许多团队都会遇到这种情况。你想对比视觉模型,于是构建了一个评估数据集。获取标签最常见的方式是运行当前模型,并将其输出当作真实基准。该模型已在生产环境中运行且无人投诉,所以标签应该足够好。
但这会造成循环评估:任何替代方案都是按其与现有模型行为的接近程度来评判,而非按实际正确性来评判。
Property Finder 的评估数据集恰恰存在这个问题。在其标注样本中,96.8% 直接来自现有视觉语言模型(VLM)的预测,而非独立的人工核验。任何替代模型在尚未处理一张图片之前就已处于结构性劣势。
隐藏的错误证实了问题的严重性。水印文本提取存在字符级错误却被标记为正确,包括虚构的品牌名称和缺失的字符。照片分类将单一标签强加于包含多种房间类型的图片上。
在其余 3.2% 的人工标注样本中,标注者引入了原始规范之外的类别,例如在提示词中并不存在该标签的情况下出现了 Office 。当答案键是由你试图替换的模型所编写时,模型对比就失去了有效性。
构建可信的真实基准
要打破这一循环,你需要具备真实领域知识的人类专家独立进行全新标注。不参考先前的模型输出,也无法获取现有模型的预测结果。
数据集范围
Property Finder 团队手工标注了 356 张阿联酋图片以及一组单独的埃及图片。团队从具有代表性的行业细分中选取了未标注的生产房源。本文报告的是阿联酋图片的结果。埃及图片作为跨区域校验,共 230 张,本文不予报告。最先标注的 256 张阿联酋图片构成用于调优的开发集。最终模型对比的评估集使用全部 356 张,其中新增了在开发运行之后标注的 100 张图片。356 张图片的集合大致足以检测模型之间的中等差异。单个属性中的稀有类别样本较少,因此这些属性上的较小差异可能无法被检测到。
专家标注
一位策略与分析专家标注了所有图片。他们带来了房地产房源质量标准方面的专业知识。AWS 生成式 AI 创新中心团队通过专门的澄清会议进行了系统性质量审查。这些审查解决了模糊案例,并保持了整个数据集标注的一致性。
多标签转换
房地产图片经常通过门洞展示多个房间,或呈现重叠的质量特征。从单标签分类转向多标签分类,缓解了一个主要的人为歧义来源。
一张通过门洞展示卧室的走廊照片确实同时属于两者。在允许多个标签之后,你衡量的是模型做对了什么,而不是因合理的次要预测而惩罚它。
一种混合方法可以补充这一方法论:来自不同模型家族的模型提出候选标签和分歧,由人类专家裁决每一个案例,从而不将任何模型输出直接用作标签。这将减轻未来数据集扩展的标注负担。
指标选择
Micro F1 被用作主要指标,因为它对每个预测赋予相同权重,这与整体标签正确性的业务目标相符。Macro F1 被同时报告,因为 Micro F1 会被高频类别主导,可能掩盖在稀有属性上的薄弱表现。每个标签的精确率和召回率有助于识别具体的失败模式。每样本交并比(IoU)衡量每张图片的预测标签与专家标签的重叠程度。九个单标签属性(例如旋转或水印检测)每张图片只有一个正确答案。AWS 团队还用精确匹配准确率对它们进行评分,即答案与专家标签一致的图片所占比例。
提示词优化作为强化学习
在无偏评估就位后,你就可以开始改进了。你无法改进你无法正确衡量的东西。
优化遵循一个类似于强化学习的循环。把每个提示词版本看作一个智能体,把 Micro F1 分数看作奖励信号,把错误分析看作改进的梯度。这一思路类似于 GEPA(遗传-帕累托反思式提示词进化), 即你变异提示词组件、评估适应度、选择幸存者并迭代。在这次合作中,AWS 团队根据错误分析改进了大多数版本,由 AI 助手审查失败的图片并提出修改建议。
MIPROv2, 一个来自 DSPy 库的自动提示词优化框架,在 v27 中为照片分类任务的这一手动流程提供了补充。
起点
第一个提示词(v0)使用了通用分类指令,此处为便于说明而简化:
“将这张图片分类为以下类别之一:客厅、厨房、卧室、浴室……”
专有模型 A 是 Property Finder 的生产基线,在 256 张图片的开发集上取得了 0.55 的 Micro F1。它使用的是 v22,一个为其模型系列调优的提示词。v21 之前的分数使用的是更早的单标签设置,不能直接比较。
逐次迭代
AWS 团队在多个候选模型上测试了早期版本,并添加了结构化输出格式和属性特定定义。
最具启发性的修复来自图片级错误分析。在早期的单标签版本中,模型始终将通过门洞可见的房间分类为次要房间类型。AWS 生成式 AI 创新中心团队添加了明确指令,要求根据占据画面大部分区域的房间进行分类。后来切换到多标签输出后,主房间保留为一个标签,并允许将通过门洞可见的房间作为附加标签。
区域定制带来了下一个提升。在某些地区,房源照片带有装饰性的阿拉伯文字叠加层,这些并非水印。针对该文字的规则消除了一整类误报。
v21 提示词将照片分类和房间类别切换为多标签输出,并成为每个模型共享的起始提示词。借助它,来自 Meta 的 Llama 4 Maverick 17B Instruct 在开发集上取得了 0.75 的 Micro F1。在此基础上,AWS 团队分别调优每个模型的提示词。对于该模型,v24 针对房间面积高估、多标签处理和输出格式。随后 v25 是一个自动优化的版本,将关键任务放在最前面。在 v27 中,MIPROv2 重构了照片分类任务,该模型在该任务上的 Micro F1 达到 0.76。
终点
最终提示词 v27_PF 是 v27 加上 Property Finder 为渲染图、带边框或画框的图片以及走廊添加的规则。与 v27 一样,它保留了阿拉伯文字规则和输出格式指令。每次模型调用后的归一化步骤处理剩余的格式差异。
借助 v27_PF,Llama 4 Maverick 17B Instruct 在 356 张图片的评估集上取得了 0.80 的 Micro F1,而专有模型 A 使用 v22 得分为 0.56。评估集包含 256 张开发图片,两个模型的提示词都是在这些图片上调优的。因此这些分数偏乐观。
从专有模型 A 切换到 Llama 4 Maverick 17B Instruct(各自使用其调优后的提示词),使开发集上的 Micro F1 从 0.55 提升到 0.81。这是 47% 的相对提升。仅对 Llama 4 Maverick 17B Instruct 进行提示词调优,就使其从共享 v21 提示词的 0.75 提升到 v27 的 0.81。
失败方法的教训
并非一切都成功了。 2-bucket 方法将水印属性和其他属性放在两个单独的 API 调用中。它没有带来有意义的准确率提升。带框图片检测也大幅下降。由于同一提示词中没有水印属性,模型将水印叠加层误认为图片边框。
通用提示词无论运行在哪个模型上也都失败了。房地产图像具有太多领域特异性,不适合一刀切的指令。
结果:成本、准确率和速度
AWS 生成式 AI 创新中心团队使用无偏评估框架在 Amazon Bedrock 上评估了多个模型。所有模型都从共享的 v21 提示词开始,然后在开发集上针对其模型系列进行调优。专有模型 A 进行了一轮调优,即 v22。Llama 4 Maverick 17B Instruct 进行了多轮调优,即 v24 到 v27,再加上 Property Finder 的边缘情况规则,因此它背后有更多的调优工作。与专有模型 A 的最终比较使用了 356 张图片的评估集。Property Finder 基于全部 11 个属性的准确率和成本效率,选择 Llama 4 Maverick 17B Instruct 用于其生产工作负载。有关各区域的模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型.
下表显示了 Llama 4 Maverick 17B Instruct(v27_PF)在 356 张图片评估集上每个单标签属性达到的精确匹配准确率。它在九个属性中的六个上达到 90% 或更高,并在全部 11 个属性上达到或超过专有模型 A。在照片分类上(每张图片可能有多个标签),两者得分相同。
| 属性 | 精确匹配准确率 |
| 旋转检测 | 100% |
| 人物检测 | 97% |
| 带框图片检测 | 97% |
| 水印检测 | 94% |
| 渲染检测 | 93% |
| 带家具状态 | 91% |
| 在建房间 | 81% |
| 房间面积 | 65% |
| 水印文本提取 | 55% |
每 1,000 张图片成本
Property Finder 每天为数万张图片评分,因此单张图片成本至关重要。Llama 4 Maverick 17B Instruct 是一款高性价比的开放权重模型,且该流水线通过单次调用即可获取一张图片的所有属性。
| 结果 | 数值 |
| 每 1,000 张图片的预估成本 | $2.35 |
| 与 Property Finder 此前方案相比的成本降幅 | 86% |
这些数字是截至 2025 年 12 月美国东部(俄亥俄)区域的估算值。Llama 4 Maverick 17B Instruct 的数字假设每张图片有 9,000 个输入 token 和 200 个输出 token,来自最初的双调用成本分析。使用生产提示词的单次调用大约包含 7,500–8,000 个输入 token,因此这是一个上限估算。86% 是与 Property Finder 此前方案(使用 v21 提示词)的成本分析估算值相比得出的。准确率对比使用的是由 v21 调优而来的 v22,因此其成本可能有所不同。有关当前定价,请参阅 Amazon Bedrock 定价.
推理速度
Property Finder 在生产环境中运行这一优化后的流水线,每天在 Amazon Bedrock 上使用 Llama 4 Maverick 17B Instruct 处理数万张图片。在其自身的监控中,Property Finder 观察到推理延迟与此前方案相比降低了 40–60%。
将此应用于您的工作负载
首先审计您的评估标签。如果它们来自模型预测而非人类专家,那么您就面临与 Property Finder 发现的相同的偏差问题。
为几百个代表性样本构建领域专家真值,并保留一个从不用于调优的独立测试集。当您的分类任务涉及重叠属性时,采用多标签指标。然后利用图像错误分析迭代提示词,将每次迭代视为进化优化循环中的一代。
部署此类流水线时,请添加负责任的 AI 控制措施。例如,您可以使用 Amazon Bedrock Guardrails 来执行内容策略并过滤不当的模型输出。此流水线中的属性预测不附带经过校准的置信度分数,因此请使用一个实用信号来选择需要人工审核的图片。模型分歧就是这样一个信号。当两个模型对某个属性给出不同答案时,该图片往往存在歧义。对每张图片都运行第二个模型会增加成本,因此您可以先从样本开始。在依赖该信号之前,请检查它在您的开发集上捕获真实错误的频率。
结论
在本文中,我们介绍了 Property Finder 如何识别评估偏差、构建无偏真值,并应用进化提示词优化,通过在 Amazon Bedrock 上进行模型选择,以更低的成本实现更高的准确率。
要取得这一结果,需要三个要素共同作用:无偏评估以实现诚实的衡量;无需重新搭建平台即可评估并在模型系列之间切换的灵活性;以及针对领域精心进化定制的提示词。Amazon Bedrock 提供了基础。它通过单一 API 让 Property Finder 能够访问多个模型系列,继承了 AWS 的治理和安全控制,并能够在新模型可用时采用新模型而无需更改其基础设施。
要开始在 Amazon Bedrock 上进行模型评估和选择,请访问 Amazon Bedrock 文档. 如果您大规模处理视觉工作负载并希望获得构建无偏评估框架的帮助,请联系 AWS 生成式 AI 创新中心.
在评论中分享您在模型评估和提示词优化方面的经验。
致谢
AWS 的其他贡献者包括 Yousuf Albannai、Amine Sehili、Thomas Ounnas、Aris Tsakpinis、Rafik Soliman、Nikhil Ulhas Pandit 和 Sneh Sharma。