人工智能
在 Amazon ECS Fargate 上为 AI 智能体访问数据湖构建的无服务器 MCP 服务器构建由人工智能(AI)驱动的应用的组织面临一个反复出现的挑战:让大语言模型(LLM)智能体访问企业数据湖,而无需在每个智能体和应用之间重复集成逻辑。大多数团队一开始会将智能体直接连接到数据库和 API,中间没有像模型上下文协议(MCP)服务器这样的共享网关。每新增一个数据集都需要定制代码,每个智能体都要重新实现自己的访问控制。随着数据集或智能体数量的增长,权限执行会出现偏差,接入一个新数据源会变成一项耗时数天的工程工作。
我们的团队支持亚马逊北美分拣中心(NASC)网络,规划团队依赖运营数据来管理产能、劳动力和包裹流转。为了让这些团队能够以对话方式访问这些数据,我们在 Amazon Elastic Container Service(Amazon ECS)上构建了一个无服务器的 模型上下文协议(MCP) 服务器, Amazon Elastic Container Service(Amazon ECS) 并使用 AWS Fargate,为 NASC 的规划团队解决这一问题。该服务器充当 AI 智能体与企业数据湖之间的集中式、与智能体无关的网关。公开一个新数据集只需一个 JSON 元数据文件,服务器会在下一次管道同步时自动发现它。
在本文中,我们介绍该架构,展示元数据驱动的方法如何消除对每个数据集单独编写集成代码的需求,并说明无服务器基础设施如何在多租户环境中支持多个智能体和应用。
问题陈述与设计目标
两个相互关联的挑战塑造了我们对这个系统的设计:碎片化的数据访问模式和不可持续的接入模式。
大规模集成挑战
我们的数据湖包含数千个数据集,涵盖运营指标、业务分析和领域特定数据。多个团队希望拥有能够以对话方式查询这些数据的 AI 助手,但每个团队都从零开始构建自己的集成。每个智能体都嵌入了自己的 SQL 生成逻辑、模式知识和连接处理,因此一次模式变更就意味着要逐个修补每个智能体。访问控制是碎片化的,数据访问决策没有单一的审计点。接入一个新数据集需要定制工具代码、查询验证和重新部署,通常每张表需要数天的工作量。
设计目标
我们确立了四项要求:
- 配置驱动的数据湖访问。添加数据集只需一个元数据文件,而无需编写代码。
- 与智能体无关的工具接口。任何兼容 MCP 的客户端都可以调用相同的工具。
- 集中式权限执行。访问控制在 MCP 服务器层强制执行。
- 弹性基础设施。系统可随突发性 AI 工作负载模式进行扩展。
解决方案概述
该架构将关注点分离为四层(客户端、MCP 服务器、工具和知识库刷新),每一层都可独立扩展和部署。元数据目录为工具层提供支撑,存储模式描述、列级语义和表关系,供 AI 智能体在生成 SQL 时参考。由于智能体在查询时从目录中获取模式知识,因此无需硬编码表结构,也无需在模式变更时重新部署。知识库刷新层使该目录保持最新,在新数据集元数据到达时对其进行索引。以下各节将详细描述每一层。
架构详解
下图展示了从用户查询到数据层、贯穿全部四层的请求流程。用户从客户端应用(网页聊天、Slack、IDE 插件或外部智能体)提交查询。请求通过 Amazon Route 53 进行 DNS 解析,到达公有子网中配置了 HTTPS 和 AWS WAF 的 Application Load Balancer。负载均衡器将请求路由到 Amazon Cognito,后者对用户进行身份验证并丰富请求内容。经过身份验证的流量随后进入私有子网,客户端层在此运行于 Amazon ECS Fargate 上。该层在 Amazon DynamoDB 中处理会话状态,并通过内部 Application Load Balancer 将请求转发到同样运行在 Amazon ECS Fargate 上的 MCP 服务器层。在 MCP 服务器层中,由 Amazon Bedrock 驱动的 AI 智能体编排使用 FastMCP(用于构建 MCP 服务器的 Python 框架)构建的工具。 Amazon Bedrock Guardrails 应用于每一次模型交互。在右侧,数据层承载工具后端。Amazon Athena 和 Amazon Redshift 对数据湖执行 SQL 查询,而 Amazon Bedrock Knowledge Bases 这一全托管的检索增强生成(RAG)能力则负责语义搜索。数据摄取到 Amazon Simple Storage Service(Amazon S3)和知识库的过程由 AWS Lambda 处理。以下各节将详细描述每一层。
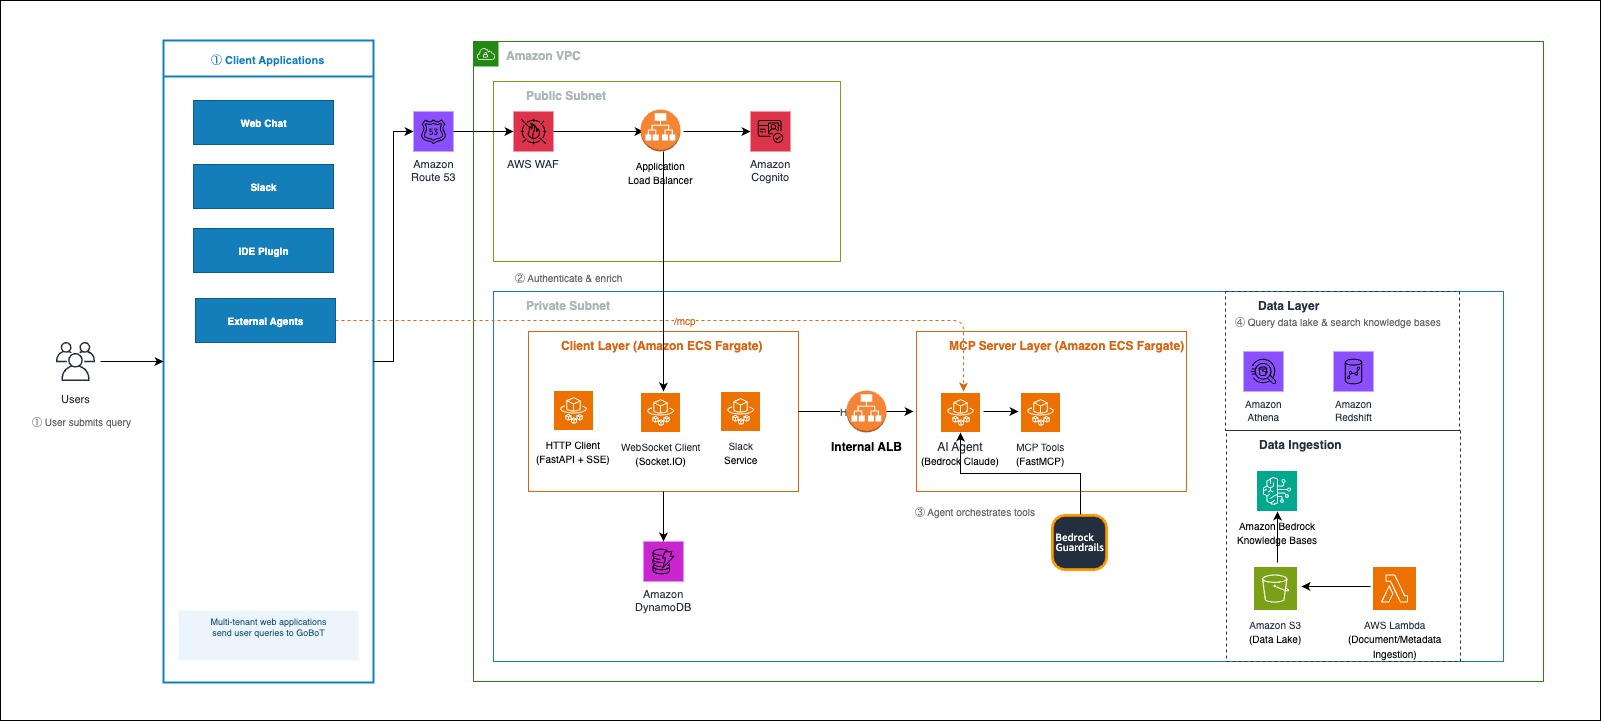
图1:请求通过无服务器 MCP 服务器的流程,从客户端应用程序到数据层
MCP 客户端层:身份验证和会话管理
请求从客户端应用程序发出,经 Amazon Route 53 进行 DNS 解析,到达配置了 HTTPS 和 AWS WAF的 Application Load Balancer。负载均衡器将流量转发到 Amazon ECS Fargate 客户端服务,该服务与 Amazon Cognito 集成以实现 JSON Web Token(JWT)身份验证,并与 Amazon DynamoDB 集成以实现会话存储。
上下文映射配置驱动这一丰富过程,将每个查询限定为仅涉及相关表。在我们的测试中,这种限定使端到端交互延迟保持在 15–20 秒范围内。以下示例展示了一个上下文映射配置:
{
  "package_data": {
    "description": "Package tracking and delivery information",
    "tables": ["analytics_db.regional_order_summary", "operations_gold.load_summary"],
    "sources": {"wiki": [], "quip": []}
  },
  "labor_planning": {
    "description": "Workforce management and capacity planning",
    "tables": ["workforce.capacity_details"],
    "sources": {"wiki": [], "quip": []}
  }
}
当上下文指定了表时,MCP 服务器会将元数据目录的搜索范围缩小到这些表,从而减少噪声并提高 SQL 生成的准确性。添加新的业务领域只需向此映射添加一个条目。
MCP 服务器层:无状态执行与对话状态
MCP 服务器运行在独立的 ECS Fargate 集群上,与客户端层隔离。请求通过 Amazon Route 53 和私有子网中的内部 Application Load Balancer 到达该服务器。服务器负责完整的编排,包括查询分析、工具选择、执行和响应生成。通过 MCP 协议端点(/mcp),即由 FastMCP 驱动的 JSON-RPC 接口,Amazon Q Developer 或 IDE 扩展等外部兼容 MCP 的客户端可以直接发现并调用工具。
Fargate 任务是无状态的,对话状态持久化在 DynamoDB 中,因此任务可以被替换或扩缩容而不会丢失数据。当请求到达时,智能体检索会话历史,使用 Amazon Bedrock 分析用户意图,发现并调用适当的工具,然后将结果流式返回给用户。
工具层与元数据驱动的数据湖访问
每个工具都通过 FastMCP 注册,并可在运行时被发现:
| 序号 | 工具 | 后端 | 用途 |
| 1 | SQL 查询工具 |
Amazon Athena Amazon Redshift |
针对数据湖和 Redshift 中任意已配置数据集的 SQL 查询 |
| 2 | 文档与元数据搜索 | Amazon Bedrock Knowledge Bases | 对内部文档、表元数据和团队 wiki 进行语义搜索 |
| 3 | 策略搜索 | Amazon Bedrock Knowledge Bases | 搜索运营策略和标准流程 |
Athena 查询工具是数据湖的主要接口。智能体首先查询元数据目录以了解可用的模式,通过 Amazon Bedrock 生成优化的 SQL 查询,验证并自动修正 SQL 以兼容 Athena,然后执行该查询。结果会返回给编排智能体,用于自然语言合成。
负责任 AI 控制
Amazon Bedrock Guardrails 应用于所有 LLM 交互,旨在过滤有害内容、强制执行接地检查,并帮助阻止提示注入尝试。这些护栏作为 MCP 服务器层的生产控制措施运行,因此每个连接的智能体都能受益于相同的内容安全策略,无论其如何连接。Athena 查询工具强制执行 SELECT仅查询,在写操作到达数据湖之前就在工具层将其拒绝。
知识库刷新层:使用单个 JSON 文件完成数据集接入
整个系统围绕配置驱动的可扩展性构建。新增一个数据集只需一个描述该表的元数据 JSON 文件,以及一个可选的上下文映射条目。该文件记录表的模式、业务上下文和列级语义。它作为唯一事实来源,供 AI 智能体用来理解和查询该数据集:
{
  "database_service_name": "athena",
  "database_name": "analytics_db",
  "table_name": "regional_order_summary",
  "business_description_for_the_table": "Regional order history with shipping status and delivery performance. Contains completed orders with delivery data. Refreshes daily. In Athena SQL, always use date() to wrap string literals when comparing against timestamp columns.",
  "column_details": {
    "order_id [varchar]": {
      "description": "Unique order identifier assigned at checkout.",
      "sample_values": ["ORD-20250115-001234", "ORD-20250116-005678"]
    },
    "order_date [timestamp(3)]": {
      "description": "Date and time the order was placed. Use this column for time-range filtering.",
      "sample_values": ["2025-01-15 08:00:00.000", "2025-01-16 12:30:00.000"]
    },
    "warehouse_id [varchar]": {
      "description": "Fulfillment center that processed the order.",
      "sample_values": ["FC-EAST-07", "FC-WEST-03", "FC-SOUTH-12"]
    }
  },
  "load_type": "Incremental (refreshes last 7 days)",
  "refresh_frequency": "Daily at 6:00 AM UTC",
  "table_size": "~2.1B rows",
  "creation_time": "2024-03-15",
  "last_refresh_time": "2025-05-20T06:00:00Z"
}
其中, business_description_for_the_table 字段携带引擎特定的查询提示,例如“始终使用 date() 来包裹字符串字面量”,从而减少 SQL 验证失败。 column_details 字段将每个 column_name [type] 与自然语言描述和示例值配对,使智能体同时具备模式感知和业务语义。 sample_values 字段对于准确生成 WHERE 子句很重要,因为智能体从中学习真实的数据模式,例如 warehouse_id 包含类似 FC-EAST-07 而不是像“东部区域设施”这样拼写出来的名称。
该管道读取元数据文件,使用 Amazon Titan Text Embeddings 生成向量嵌入,并将它们索引到 Amazon Bedrock Knowledge Bases 中。一旦完成索引,该表即可被所有已连接的智能体发现,无需手动重新索引或重启服务器。
为了提高特定应用的准确性,工程师可以选择将数据集与业务上下文关联。这会缩小搜索范围,使智能体优先选择正确的表。以下示例展示了一个上下文映射条目:
{
  "delivery_metrics": {
    "description": "Delivery accuracy and defect attribution data",
    "tables": ["analytics_db.customer_orders_summary"],
    "sources": {"wiki": [], "quip": []}
  }
}
如果未指定上下文,智能体会搜索所有已索引的表。上下文映射通过限制搜索空间来降低延迟并提高 SQL 准确性。这种范围限定是可选的,并且可以随时添加,而无需修改元数据文件本身。
综合来看:一个实际运行的查询
当用户问“我们上个月价值最高的 10 笔订单是什么?”时,客户端会用业务上下文丰富请求以缩小范围。智能体将问题转换为向量嵌入,在元数据目录中搜索匹配的模式,并通过一次轻量级 LLM 调用选择最相关的表。
使用选定的模式、列描述和引擎特定的查询提示,智能体生成如下 SQL 语句:
SELECT order_id, customer_id, total_amount, order_date
FROM analytics_db.regional_order_summary
WHERE order_date >= date_add('month', -1, current_date)
ORDER BY total_amount DESC
LIMIT 10
SQL 经过验证,并针对引擎兼容性进行自动修正,然后对 Amazon Athena 执行。智能体将结果格式化为自然语言响应,并流式返回给用户。在我们的测试中,这一端到端流程可在 15–20 秒内完成。
同样的编排能力不仅限于纯 SQL。由于文档搜索作为同一服务器上的另一个工具注册,智能体可以在单轮对话中回答同时涉及结构化和非结构化来源的问题,例如“我们第四季度的退货率是多少,产品团队的分析对根本原因有何说法?”对于该请求,智能体会运行 Athena 查询获取退货率数据,并通过 Knowledge Bases 文档搜索获取分析内容,然后将两者合并为一个响应。
安全与多租户访问
这种单轮编排之所以可行,是因为每次工具调用都经过同一个受控网关。该架构采用分层安全,而非单一执行点。MCP 服务器运行在内部 Application Load Balancer 之后的私有子网中,无法从互联网访问。只有位于面向公网的 Application Load Balancer(配有 AWS WAF)之后的客户端层才能将请求路由到它。Amazon Cognito 在客户端层验证用户身份,只有经过身份验证、携带令牌的请求才会被转发到下游。在工具层面,Athena 查询工具强制执行 SELECT仅查询,在写操作到达数据湖之前就将其拒绝。所有工具调用都会以结构化 JSON 记录到 Amazon CloudWatch ,这为安全团队提供了一个跨每个智能体和应用程序的数据访问单一审计点。该架构可在 Amazon Bedrock 和 Amazon Bedrock Knowledge Bases 可用的 AWS 区域中使用。
这种集中式设计也正是该服务器实现多租户的原因。由于标准化的 /mcp 端点接受任何兼容 MCP 的客户端,无论其使用哪种 LLM 或编排框架,多个智能体共享相同的工具和相同的访问控制。新增一个智能体只需将其指向服务器端点,因此接入另一个团队可以扩展系统,而不会削弱或重复安全模型。
无服务器基础设施与扩展
每一层都通过适合其工作负载模式的机制进行扩展:
| 层 | 扩展机制 | 触发条件 |
| 客户端(ECS Fargate) | ECS 服务自动扩缩容 | CPU 利用率(50% 阈值) |
| MCP 服务器(ECS Fargate) | ECS 服务自动扩缩容 | CPU/内存利用率 |
| Athena | 无服务器(自动) | 查询并发数 |
| Amazon Bedrock | 托管服务扩展 | 推理请求 |
Amazon ECS Fargate 提供无服务器计算,无需管理任何 EC2 实例。下游服务(Athena、Bedrock)会自动扩展,因此系统无需更改配置即可处理单个查询或数百个并发查询。
用例与扩展
该架构除了基本的问答之外,还支持多种模式。企业知识助手可以将数据湖查询与文档搜索相结合,回答同时涉及结构化数据和非结构化知识的复杂问题,例如“我们第四季度的退货率是多少,产品团队的分析对根本原因有何说法?”内部数据分析副驾驶让业务用户无需编写 SQL 即可通过对话方式查询数据湖,依靠元数据描述和查询提示引导智能体采用准确、高效的查询模式。
标准化的 /mcp 端点还支持多智能体工作流。用于数据分析、文档检索和运营告警的多个专用智能体可以共享同一个 MCP 服务器,每个智能体都通过通用协议访问完整的工具套件。接入新团队的数据遵循同样的配置驱动模式。他们添加一个元数据 JSON 文件,在一个管道同步周期内,其数据集便可被每个已连接的智能体和应用程序发现。
结论
Amazon ECS Fargate 上的集中式 MCP 服务器在 AI 智能体与企业数据湖之间提供了一个可扩展、安全的网关。这种元数据驱动的方法无需为每个数据集编写集成代码,而 Model Context Protocol 标准意味着任何兼容 MCP 的客户端都可以连接,无需自定义适配器。
关键的架构决策是将工具层与智能体层分离。智能体快速演进,但数据访问模式应当比任何单一智能体实现更长久。将可扩展性视为配置问题而非代码问题,可以加速接入流程。
如需了解更多信息,请参阅 Amazon ECS on AWS Fargate, Amazon Bedrock、 Amazon Bedrock Knowledge Bases 用户指南、 Amazon Athena,以及 模型上下文协议规范.
后续步骤
我们正在从两个方向扩展这一架构。首先,是更细粒度的访问控制:表所有者可以按权限组将敏感列标记为受限,智能体会自动将这些列从生成的 SQL 中排除,而无需在提示层面做任何更改。
其次,是闭合反馈回路:当查询失败或产生低置信度结果时,系统会捕获失败模式,并给出有针对性的建议,以改进列描述、添加查询提示。