 AI 热点
精选项目
摘要
在 AI 编程智能体的帮助下,我们两人团队在不到一周内将 SGLang 与 IBM Spyre 集成,构建了一个约 1,500 行的插件。PyTorch 中已有的 Spyre 支持以及 SGLang 清晰的扩展点,使得复用硬件代码变得简单直接。SGLang 的吞吐量约为使用 torch-spyre 的参考 PyTorch 推理实现的 3.6 倍。在针对 Granite 3.3 8B 和 Gemma 4 26B A4B 所测量的工作负载上,它也与 vLLM 持平。通过 RadixCache 实现的前缀共享无需任何 Spyre 专属改动即可工作。
我们致力于 IBM 的 Spyre 加速器 ,并希望让 SGLang的 serving 栈(包括其内置的前缀共享)可供 Spyre 用户使用。
在不到一周的时间里,我们两人利用 AI 辅助开发,用一个仅约 1,500 行代码的插件将 SGLang 集成到 IBM Spyre 中。一个关键因素是建立在已有的 PyTorch 硬件支持以及 SGLang 定义良好的扩展点之上。这使我们两人连同我们的 AI 编程智能体,能够在极短的时间内将一个新的加速器集成到 SGLang 中。AI 编程智能体以 Spyre 操作的现有 PyTorch 实现作为参考代码,并将集成代码适配到 SGLang 的后端接口。它们的工作重点是将已有的硬件支持连接到新的 serving 框架。
Spyre 与起点
Spyre 是 IBM 面向企业 AI 推理的加速器。它通过 torch-spyre进行集成,后者将 Spyre 注册为 PyTorch 设备并将其连接到 torch.compile,从而通过标准 PyTorch API 暴露硬件支持。
结果
最初的 SGLang 集成花费了我们两人不到一周的工作时间。该插件大约 1,500 行,建立在来自 PyTorch 的编译器和可复用硬件支持之上。四个小补丁扩展了 SGLang 的后端支持:其中两个使现有执行路径在没有 CUDA 专属依赖的情况下可用,另外两个将 Spyre 注册为受支持的设备以及不使用 Triton 的注意力后端。这些兼容性改动也可以支持其他加速器;注册相关的改动则专属于 Spyre。
Spyre 上的 SGLang 实现了约为使用 torch-spyre 的参考 PyTorch 推理实现 3.6 倍的吞吐量。
我们还使用 Granite 3.3 8B 和 Gemma 4 26B A4B 在 Spyre 上比较了 SGLang 和 vLLM。在我们针对这两个模型所测量的工作负载中,SGLang 的性能与 vLLM 持平。
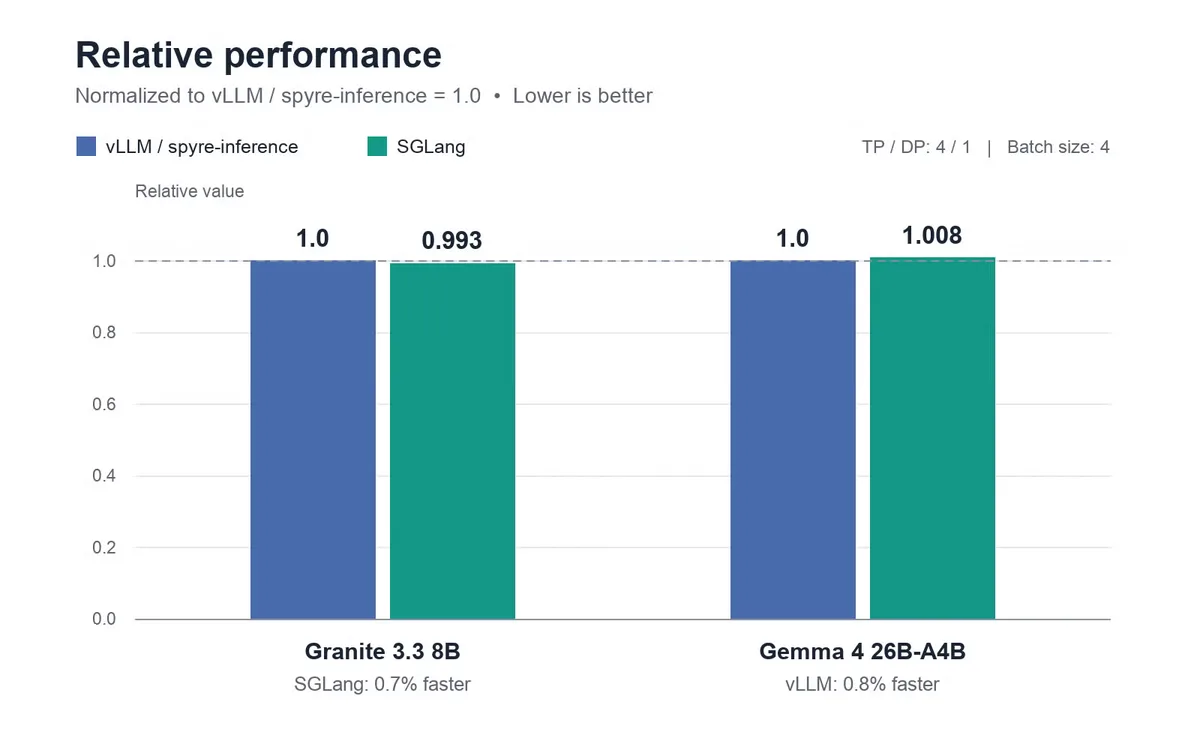
SGLang 与 vLLM / spyre-inference 在 Granite 3.3 8B 和 Gemma 4 26B-A4B 上的相对性能,以 vLLM = 1.0 归一化。越低越好。
为何奏效
在已有可用的编译器和现有推理服务器的情况下,添加 SGLang 成为一项聚焦的集成任务。PyTorch 和 torch.compile 提供了共享的实现层,通过两个 serving 框架都可使用的 API 来表达加速器功能。
SGLang 提供了清晰的接入点来连接这些代码。其平台注册、注意力后端、KV 池和算子分发将集成拆分为有边界的任务,同时保留现有的调度器、请求处理和 serving 循环。参考代码来自现有的 Spyre 的 vLLM 集成,包括其加速器操作的 PyTorch 实现。这为 AI 编程智能体提供了 Spyre 硬件行为的具体代码,而 SGLang 的扩展点则定义了它们改编后的代码必须满足的接口。两者共同减少了智能体需要推断的硬件信息量以及集成应归属的位置。
现有的 vLLM Spyre 后端约为 3,500 行,而 SGLang 插件约为 1,500 行。在最初的集成中,注意力基类提供了外围逻辑,使 Spyre 后端只需重写内部的缩放点积注意力操作。复用该基类约占两个插件之间行数差异的三分之二。SGLang 的设备无关 KV 池还允许通过单个方法重写来完成缓冲区创建;在现有路径依赖 Triton 的地方,分配仍需要基于 PyTorch 的处理。
复用 vLLM Spyre 实现
我们复用了 vLLM Spyre 集成中的注意力代码,包括其将输入分组为桶以及处理张量形状的方式。我们还复用了其基于 PyTorch 的 KV 缓存分配方法。对于 RMSNorm、SiLU、GeLU、旋转嵌入和线性层,我们将现有的 Spyre 实现连接到 SGLang 的算子分发。
有些功能完全不需要 Spyre 专属工作。RadixCache 就是一个很好的例子:前缀共享完全在 SGLang 的调度器内解决,之后执行才到达加速器,因此现有的调度逻辑无需改动即可工作。
该插件已作为开源软件与上游 SGLang 一同提供。
在 Spyre 上使用 SGLang
该示例假设 Spyre 运行时、torch-spyre、SGLang 插件及其兼容性补丁已安装并配置完毕。
import sglang as sgl

models = [
    "ibm-ai-platform/micro-g3.3-8b-instruct-1b",
    "mistralai/Ministral-8B-Instruct-2410",
]

for model in models:
    engine = sgl.Engine(
        model_path=model,
        device="spyre",
        attention_backend="spyre_paged",
        dtype="float16",
        page_size=64,
        max_running_requests=1,
        disable_cuda_graph=True,
    )

    try:
        output = engine.generate(
            "Why is the sky blue?",
            {"temperature": 0, "max_new_tokens": 64},
        )
        print(model, output["text"])
    finally:
        engine.shutdown()
展望未来
Spyre 软件栈持续快速演进。
在未来几个月内,我们预计将增加对动态形状的支持,从而减少目前所需的大量形状管理工作。今年晚些时候,我们还预计将为 Spyre 带来 Triton 支持,并在其之上启用 RadixAttention,为更多内核优化打开大门。
将硬件支持保留在 PyTorch 中,并将集成代码保留在 SGLang 的扩展点处,为未来的编译器和运行时改进进入 serving 栈提供了路径。下一次集成可以从相同的共享基础开始,拥有开发者和 AI 编程工具可以使用的具体实现和接口。
/row /row