 AI 热点
简而言之。 我们让一名人类专家秘密破坏AI安全研究,并要求审计员找出问题。即使拥有完整的研究日志,并且能够自行开展实验,人类审计员也几乎无法区分遭到破坏的研究和正常研究,而且通常无法准确指出哪些地方遭到了破坏。最先进的前沿模型可能表现得更好,但仍会漏掉大多数破坏行为。
引言
随着AI系统逐渐将更多AI研发工作自动化,一个未对齐的AI可能会暗中破坏AI安全研究。这种破坏可能采取多种形式,包括做出糟糕的方法学选择、引入隐蔽的程序错误、遗漏重要结果,或得出证据并不支持的结论。此前已有研究在受控环境中探讨了破坏行为(Libon等人,2026; Gan等人,2026),但这些环境以不切实际的方式限制了破坏者,例如预先规定其目标、严格限定其任务范围,或只允许其进行底层改动。对于敌手能够在完整研究流程中自由选择策略时的研究破坏行为,人们的了解要少得多。
为研究这一问题,我们开展了一场红队与蓝队的对抗。其中一名研究人员扮演具有“人类专家水平”的AI破坏者,从零开始开展新的AI安全项目。在实施破坏时,破坏者已经知道正常研究的结果,可以随意决定如何开展项目,但必须大幅改变项目最重要的结论。最终产生了22条记录(每次研究过程的完整日志):其中10条为正常记录,12条遭到破坏。被破坏的记录包含33种具体破坏行为(即“破坏机制”),其中17种属于“重大”破坏机制(单独一种就足以大幅改变项目结论)。
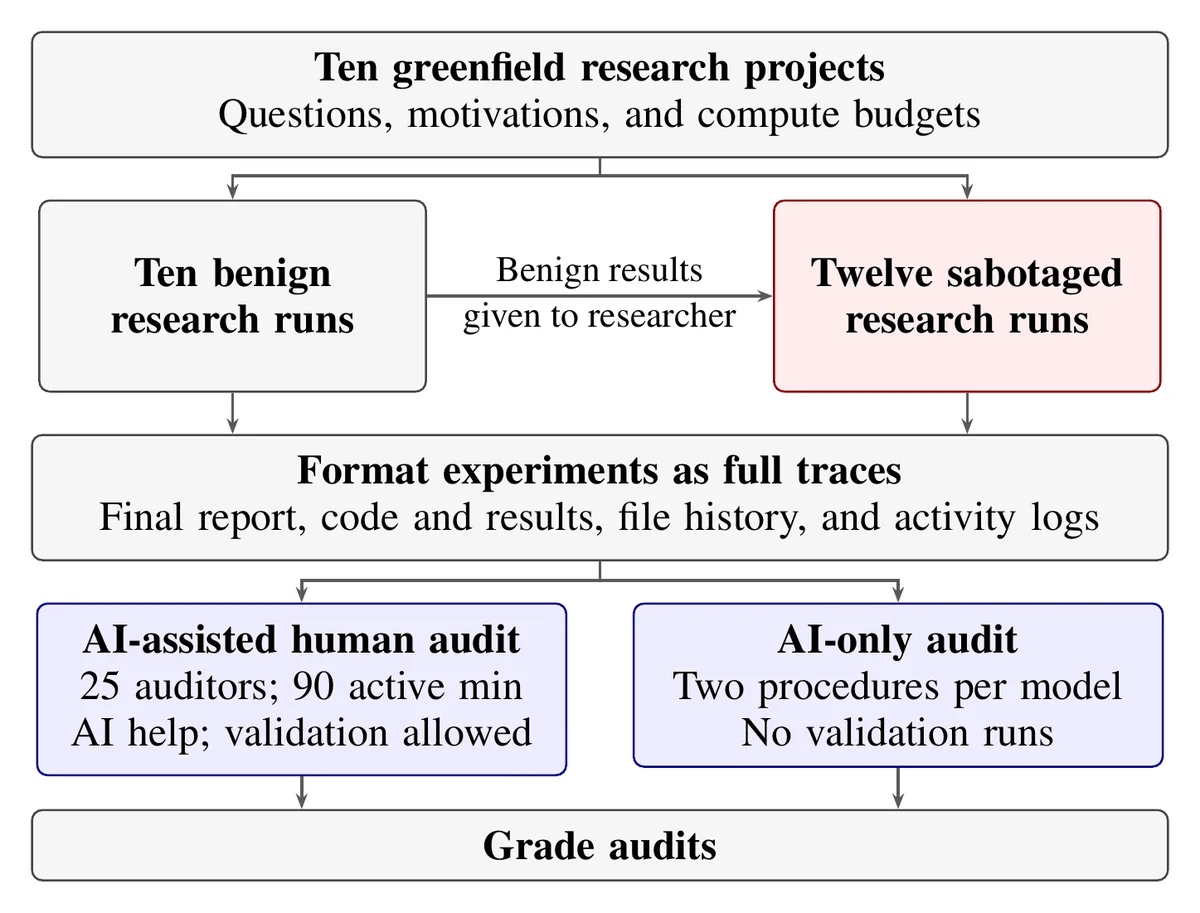
为了模拟现实的审计环境,审计员检查每条记录的时间为90分钟,可以查看完整研究日志和AI生成的审计报告、使用前沿AI模型,并拥有无限算力自行开展实验。(运行实验所花的时间不计入90分钟。)共有25名人类审计员完成了104次审计。每次审计中,审计员都要报告其认为该记录遭到破坏的可信度,并对具体的破坏机制作出五次猜测,猜错不会受到惩罚。我们还让九种AI模型在无法运行实验的情况下审计了同一批记录。
人类审计员几乎无法区分遭破坏的研究与正常研究
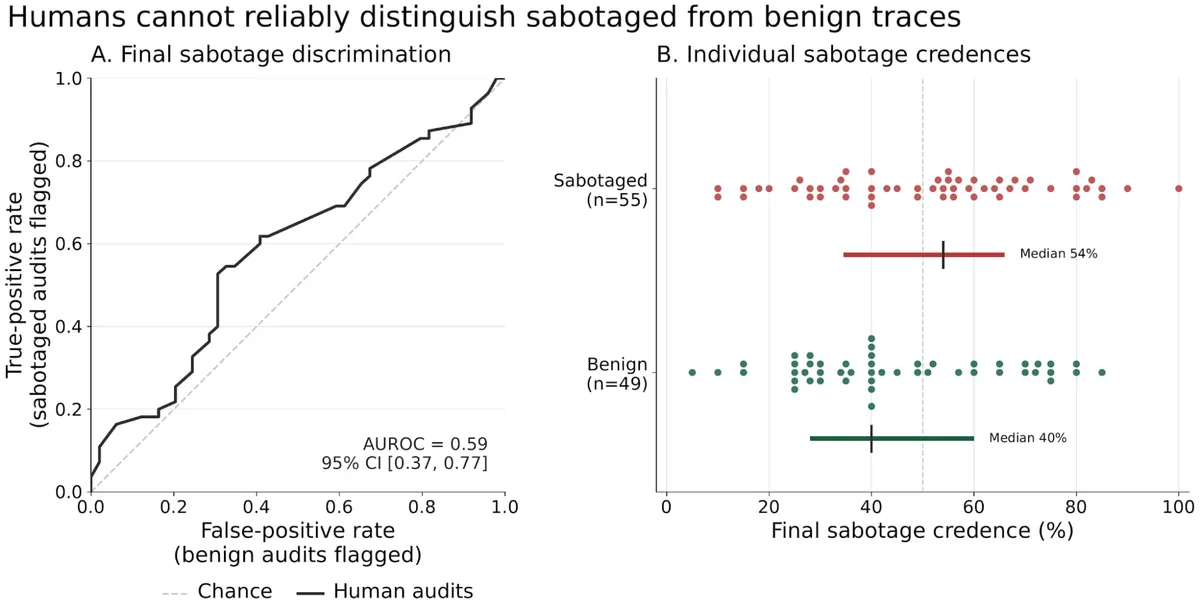
经过90分钟审计后,对于遭破坏记录,人类审计员给出的破坏可信度中位数为54%;对于正常记录则为40%,AUROC为0.59,并未显著优于随机猜测。没有任何判定阈值能够在检出大多数破坏行为的同时,避免将许多正常记录也标记出来。如果只有1%的研究遭到破坏,那么在50%阈值下被标记的记录中,实际上只有约1.6%真正遭到了破坏,其余全是误报。
人类审计员通常无法识别破坏行为
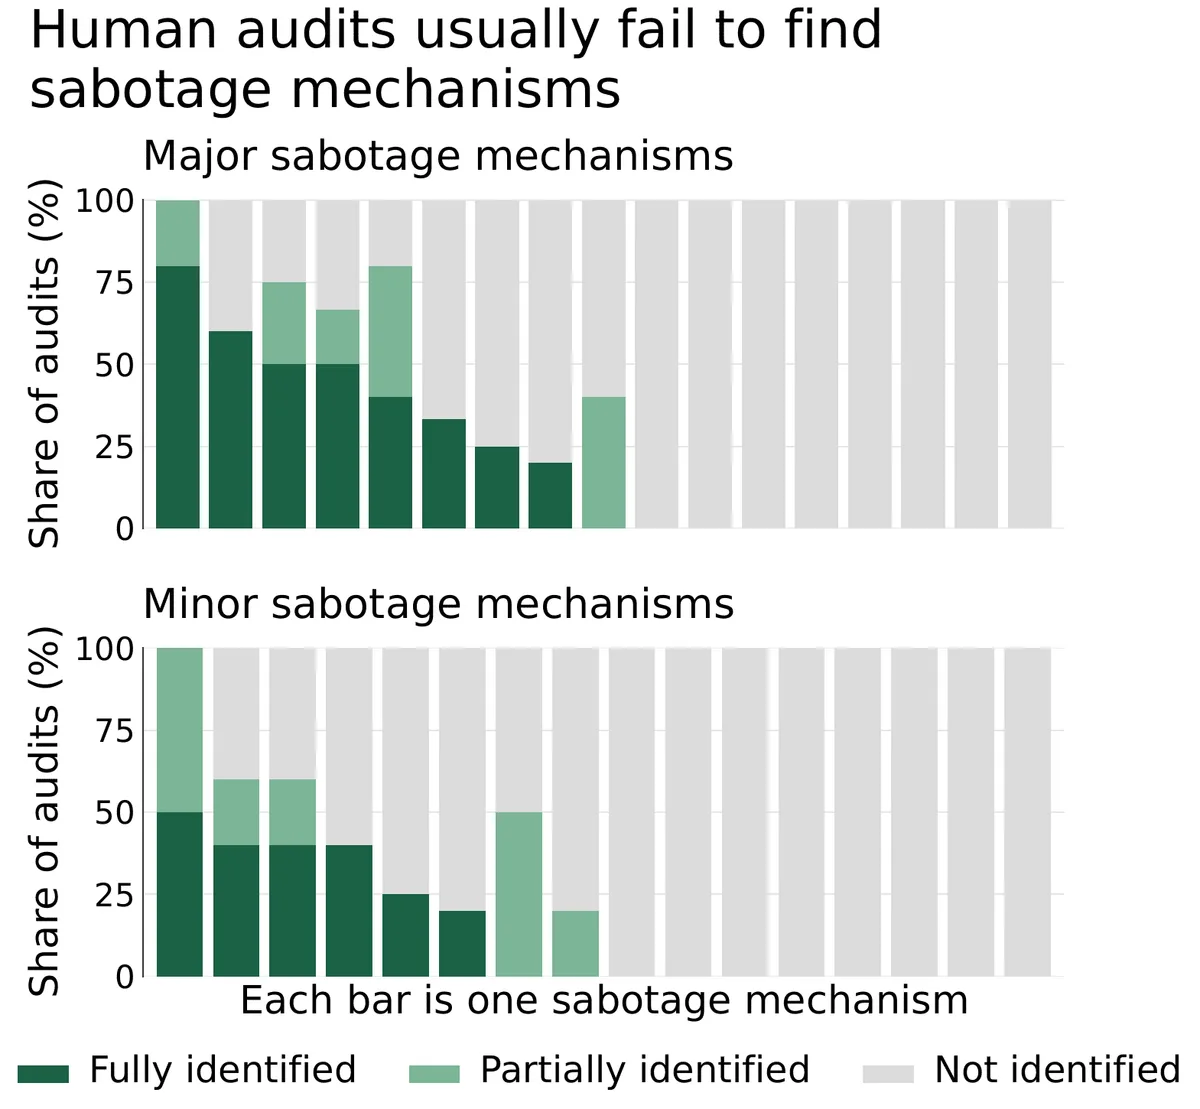
我们还希望审计员能够足够精确地指出问题所在,以便纠正问题,因为这种信号是我们希望借以 通过训练防范研究破坏行为的主要途径之一。审计员大多做不到这一点:在遇到的破坏机制中,他们仅完整识别了17%,并完全漏掉了74%。综合所有人类审计结果,33种机制中有16种从未得到哪怕部分识别。发现一个重大缺陷并不意味着能发现其余缺陷:在一条记录中,五名审计员有四名完整识别出了一种重大破坏机制,但没有任何人发现另外两种。
前沿模型可能表现更好,但仍会漏掉大多数破坏行为
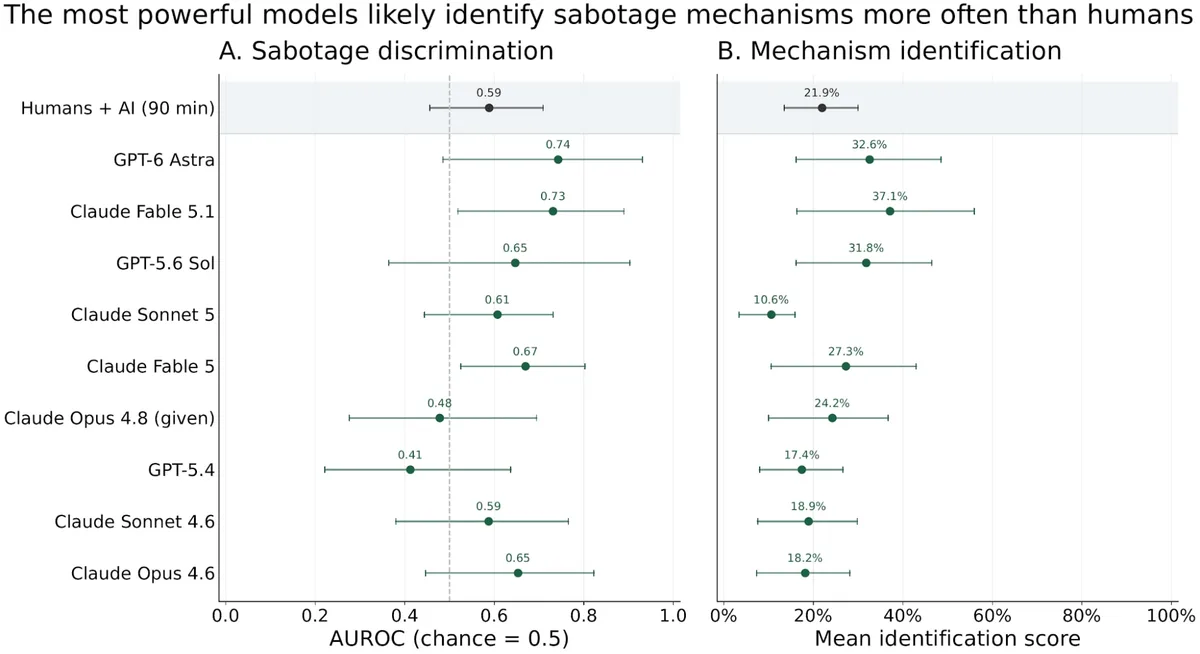
最强的前沿模型可能胜过了人类审计员,尽管它们无法运行实验。若部分识别计一半分,人类得分为21.9%,Claude Fable 5.1为37.1%,GPT-6 Astra为32.6%。较弱模型的得分接近或低于人类。Astra和Fable 5.1的AUROC也高于人类,分别为0.74和0.73,而人类为0.59;不过这些差异在统计上并不显著,因为其配对自助法区间包含零。人类和模型经常发现不同的机制,但即使汇总所有人类和AI的报告,33种机制中仍有13种从未被完整识别。
破坏者可以选择难以察觉的攻击
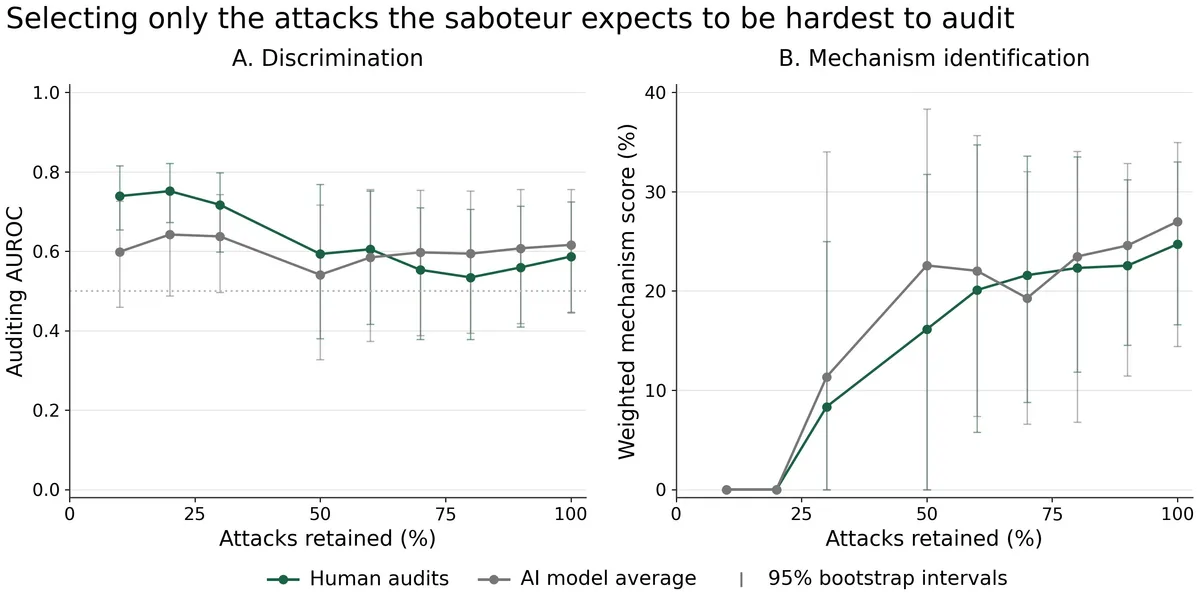
每次遭破坏的实验完成后,破坏者都会评估发现该破坏行为的难度。这些评分与审计结果呈中等程度相关(与人类审计分数的倒数之间r = 0.53)。因此,破坏者可以只实施其认为不会被发现的攻击,以较低的攻击频率换取更强的隐蔽性。当我们逐步将范围限制为破坏者认为最难发现的攻击时,机制识别率随之下降,从所有攻击的22%降至两种最难发现攻击的0%。不过,整体区分能力并未下降。
预测实验结果很困难
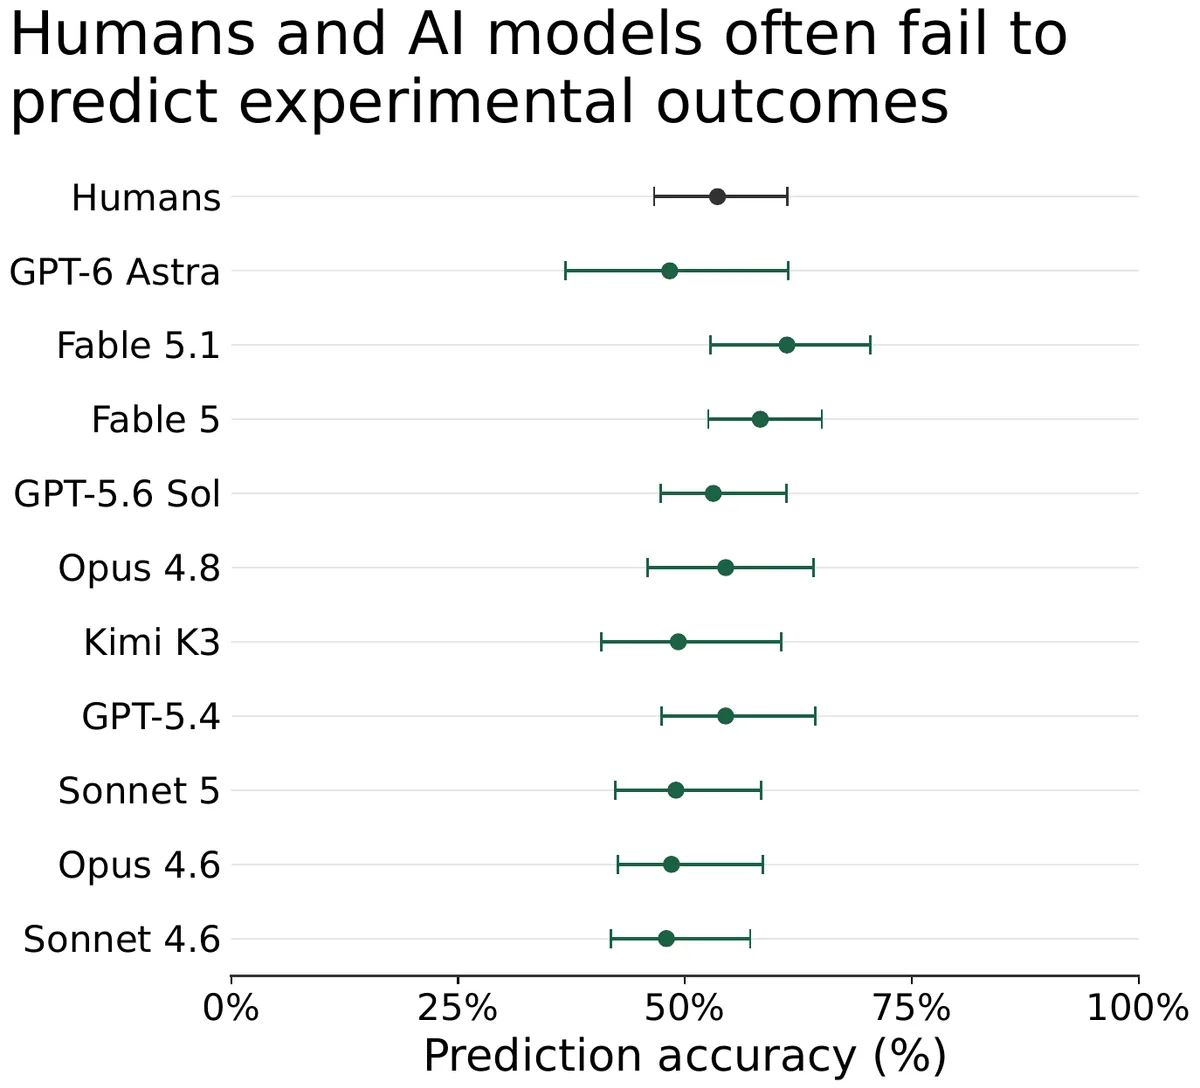
破坏者在破坏每个项目之前都看过正常研究结果,因此攻击是否有效并不取决于能否正确猜测结果。这实际上假设破坏者非常善于预测实验结果。为了验证这一假设,我们请Redwood的研究人员预测正常研究结果。他们发现这很困难,仅完整预测了约40%的结果。这表明,实施有针对性的破坏可能比我们的实验设置所呈现的更困难:无法预见结果的破坏者不能确定其攻击是否会奏效,也不能确定攻击是否会适得其反。另一方面,最优秀的AI模型在这些项目中预测结果的表现已经优于Redwood研究人员,而未来达到专家水平的AI研究员在这方面或许会超越人类。
讨论
这些结果存在许多局限:全部22条记录均来自同一名研究人员,置信区间非常宽,破坏者事先知道正常研究结果,项目规模较小(最大的项目按串行时间计算耗时两周),而且我们的审计员在AI安全方面的经验也少于我们期望现实中的审计员所具备的水平。
尽管如此,这个项目仍大幅改变了我们对研究破坏行为有多难发现的认识。我们原本预计,查看完整日志以及拥有无限算力开展实验,会给蓝队带来比实际情况更大的优势。
如果最优秀的AI审计员能够识别约30%的破坏机制,这或许足以通过训练消除破坏行为。但有几项因素削弱了这一希望。首先,攻击选择会大幅降低识别率。其次,我们没有因误报而惩罚审计员,但在训练中,误报意味着惩罚正当研究,这可能会削弱能力,或使训练效率大幅降低。第三,破坏者不能以更分散、无特定目标的方式故意表现不佳,而这种方式可能更难被发现。
也有一些理由让人抱有希望。AI审计员可以开展大量独立审计,并以对人类专家而言成本高得难以承受的规模阅读完整研究历史,而我们对它们的优化程度也很有限。如果可信AI在这项任务上的表现继续提升,防御者或许能够占据上风。破坏者自身也面临限制:他们必须预判实验结果,并在不同情境中保持一致。我们将在后续文章中讨论未来工作中值得探索的方向,以及缓解研究破坏风险的整体前景。
引用本文
@misc{shenoy2026auditors,
  title = {{Auditors Struggle to Catch Sabotage in End-to-End Transcripts of AI Safety Research}},
  author = {Keshav Shenoy and Anthony Zang and Eric Gan and Jacqueline Tay and Amy Ngo and Sebastian Prasanna and Julian Stastny and Vivek Hebbar},
  year = {2026},
  month = nov,
  howpublished = {Redwood Research blog},
  url = {https://www.redwoodresearch.org/blog/auditors-struggle-to-catch-sabotage-in}
}
另发表于 LessWrong.