 AI 热点
人工智能
降低生成式 AI 成本:规则用代码,判断用模型生成式 AI 系统中最大的成本杠杆在于你是否要调用模型。我们经常看到团队把每项任务都交给大语言模型(LLM)处理,包括输入校验、格式化和路由。单次调用看似便宜,但在生产规模下,这些小额成本会成为架构中最大的支出项之一。 只要确定性规则能完成工作,跳过模型就能省钱、降低延迟,并消除一个非确定性的来源。在本文中,你将了解如何判断工作流中的每个步骤是否真的需要模型。然后,你可以将每个选项映射到 AWS:确定性代码、受约束的决策调用,或在 Amazon Bedrock 上规模合适的模型。 Amazon Bedrock.
为什么不必要的模型调用会累积成开销
这种模式通常始于原型阶段。一次模型调用在某个步骤上奏效,于是它就成了下一步的默认做法。这些步骤包括校验输入、重新格式化请求体和选择路由。在原型规模下,没有人会注意到这项成本。
在生产规模下,不必要的模型调用会从三个方面给你带来成本:
- 随着请求数量增加,成本也会增长,即使对于低价值步骤也是如此。
- 延迟会叠加,因为链式调用中的每次模型调用都会增加数百毫秒。
- 输出可能会有所不同,因为相同的输入可能返回不同的答案。这使测试更加困难,审计更加缓慢。
于是,每次发布新模型都会重新引发关于该用哪个模型的争论。而更早的那个问题——这一步到底需不需要模型——却无人问津。
成本指导,包括 AWS Well-Architected 生成式 AI 镜头,往往从模型选择开始。本文则更早一步:这一步到底需不需要模型?
如何判断一个步骤是否需要模型
图 1 以流程图形式展示了整个决策过程,其中包含三条带标签的泳道:以代码运行、问题、在模型上运行。让每个工作流步骤依次经过三个问题,并在第一个满足该步骤要求的选项处停止:
- 规则能否校验成功,例如格式、schema、关键词或范围?如果规则只能解决该步骤的一部分,则先运行规则这条快速路径。
- 模型能否一次性写好规则,例如正则表达式或 JSON schema?
- 这一步是否从固定列表中选择一个答案,例如路线、类别或“是/否”?
如果这三个问题的答案都是否,那么该步骤就是开放式的,应交给规模合适的模型来运行。
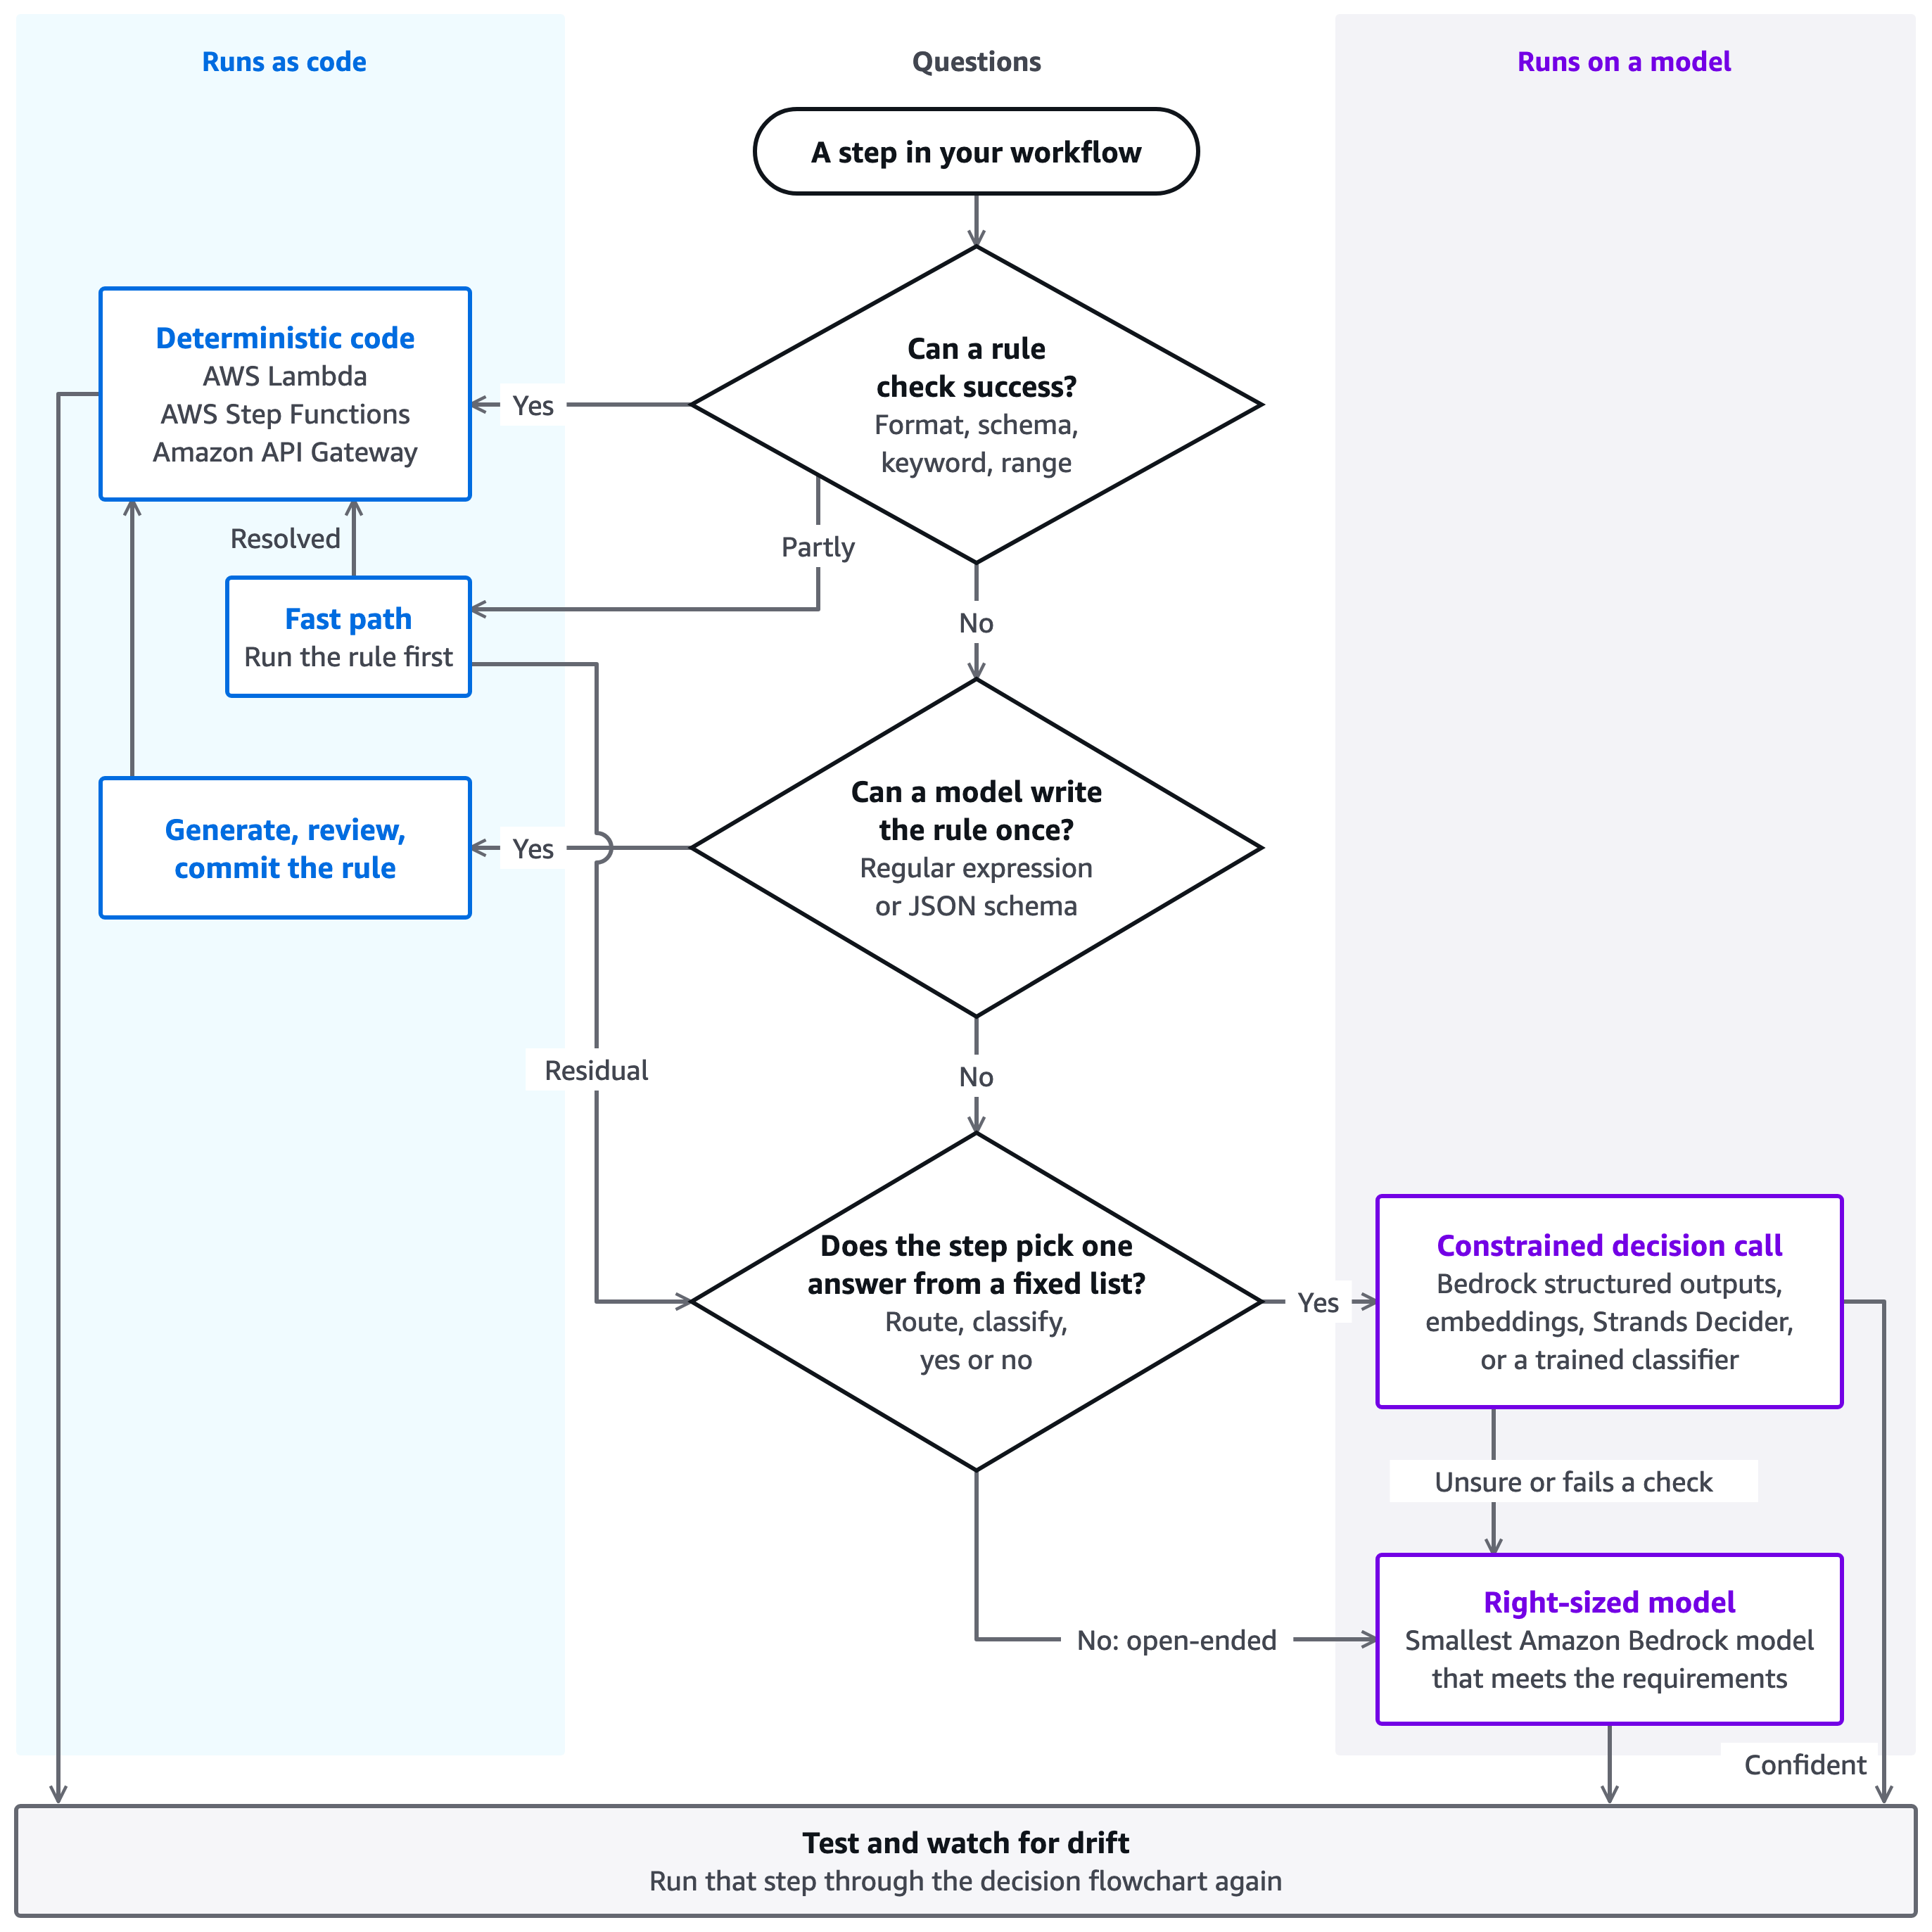
图 1:判断一个工作流步骤是否需要模型,以及需要哪个模型
以一个客户支持助手为例。下表展示了它的五个步骤如何经过该流程图。
| # | 步骤 | 图表的流程路径 | 运行位置 |
| 1 | 检查订单号的格式 | 规则可以校验成功。 | Amazon API Gateway REST API 请求校验,或一个 AWS Lambda 函数 |
| 2 | 按意图路由消息 | 规则可以解决其中一部分。快速路径上的关键词匹配可以处理诸如“退款”之类的消息,剩余部分则交给第三个问题。 | 一个 AWS Step Functions 使用 JSONata 的选择状态。剩余部分则交给受约束的决策调用。 |
| 3 | 从承运商邮件中提取追踪号 | 模型可以一次性写好规则。它起草一个正则表达式,由你审核并提交。 | 代码,作为 AWS Lambda 中已提交的模式 |
| 4 | 为工单选择四个支持队列之一 | 答案来自一个固定列表。 | 一个受约束的决策调用。不确定的答案会升级到规模合适的模型。 |
| 5 | 起草一封给客户的回复 | 这项任务是开放式的。 | 规模合适的模型,即满足要求的最小 Amazon Bedrock 模型 |
当任务开放、模糊或具有生成性时,你可以使用模型:总结文档、起草回复、从散文中提取含义。当任务具有可校验的规则时,应使用确定性代码:电子邮件格式、schema、精确关键词、数值范围。下表展示了当你把规则明确的任务交给模型时会失去什么。
| 属性 | 确定性代码 | 模型调用 |
| 每次调用成本 | 通常低几个数量级 | 按 token 计费,在大规模场景下成本不可忽视 |
| 延迟 | 个位数毫秒或更短 | 数百毫秒 |
| 规则本身的正确性 | 对于按原文写出的规则,精确匹配 | 高,但错误率非零 |
| 可审计性 | 该规则存放在源代码管理中 | 更难向审计人员解释 |
| 随时间推移的稳定性 | 在你更改它之前保持稳定 | 当你迁移到新的模型版本,或某个版本被停用时,行为会发生变化 |
模型也可能产生幻觉,对同一输入返回不同的答案。温度为 0 可以降低出现不同答案的可能性,但并不能保证输出完全一致。 Amazon Bedrock 模型评估 以及 Amazon Bedrock Guardrails 帮助你衡量并控制这些风险。规则不存在这两个问题,这也是受监管工作负载青睐规则的原因之一。一个有用的测试:如果你能把验收测试写成规则,通常也能把该步骤写成规则。更多信息,请参阅 编排模型:从基于规则到AI原生 ,详见 AWS Prescriptive Guidance。
决定,而非生成
大多数路由和分类步骤介于规则与开放式生成之间。规则无法决定每一种情况,但这些步骤也不需要生成的文本。它们需要的是从你预先定义的固定选项列表中给出一个答案,就像前一个示例中的支持队列一样。使用一个将输出限制为允许答案的组件,并为你提供何时升级的信号。有把握的答案继续处理,不确定的答案则升级。 AWS Well-Architected 智能体 AI 透镜对此有所描述: 分层、基于置信度的升级在 AWS 上,你可以通过四种方式构建它:
- 一个带有结构化输出的亚马逊 Bedrock 小型模型—— 答案仅限于一个
enum选项,外加一个会触发升级的“不确定”选项。这是模型自身的判断,而非经过校准的分数,因此在用它来决定是否升级之前,请先对照标注数据进行检查。 - 嵌入向量相似度 – 使用 Amazon Bedrock 嵌入模型对输入进行嵌入,并选出最接近的带标签示例。将相似度分数用作升级信号,并在标注数据上设定其阈值。
- Strands Decider——一个基于 Apache License 2.0 的实验性开源决策模型—— 它从选项中选择,或根据评分标准打分,并为每个答案返回一个经过校准的置信度。其 README 报告称,在短分类任务上,置信度为 0.9 或更高的答案正确率约为 95%。由于该模型是实验性的,在生产环境中使用之前,请在你自己的数据上验证这一结果。你需要自行托管它,例如部署在 Amazon SageMaker AI 端点,遵循其 部署指南 在其代码仓库中。
- 在 Amazon SageMaker AI 上部署经过训练的 classifier—— 一旦你有了带标签的训练数据,它就能以低延迟和低成本返回类别概率。
以下 JSON schema 将结构化输出答案限制为四个队列外加“不确定”。Amazon Bedrock 要求 schema 中的每个对象都设置 additionalProperties 。 false.
{
  "type": "object",
  "properties": {
    "queue": {
      "type": "string",
      "enum": ["billing", "technical", "account", "other", "unsure"]
    }
  },
  "required": ["queue"],
  "additionalProperties": false
}
无论你选择哪种方案,都要用你自己的标注数据检验其升级信号,并在那里设定阈值。将你的授权决策(例如退款限额)保留在规则中。
确定性快速路径模式
许多成本模式关注的是模型之间的路由。快速路径则更早一步:先运行确定性检查,只把规则无法解决的部分交给模型。意图路由就是一个例子。许多消息带有明确的信号,例如“退款”或“重置我的密码”,关键词匹配可在个位数毫秒或更短时间内解决。 如果规则能解决95%的请求,那么每20个请求中只有1个会到达模型,这还没有算上模型选择带来的节省。(此为示意性算术,并非基准测试。)
在 AWS 上,你可以用现有的构建模块来组合实现这一点:
- AWS Step Functions Choice 状态会在工作流调用任何模型之前进行分支。
- AWS Lambda 承载那些需要的不仅仅是 Choice 状态的规则,例如验证和 schema 检查。
- Amazon API Gateway(REST API)的请求验证会在任何计算运行之前拒绝格式错误的输入。
- 受限的决策调用或 Amazon Bedrock 模型只处理剩余部分。
以下 Choice 状态是一种关键词快速路径。它使用 JSONata 将退款和密码重置消息直接发送到代码,并将其他所有内容发送到受限的决策调用。
"KeywordFastPath": {
  "Type": "Choice",
  "QueryLanguage": "JSONata",
  "Choices": [
    {
      "Condition": "{% $contains($states.input.message, /refund/i) %}",
      "Next": "RefundFlow"
    },
    {
      "Condition": "{% $contains($states.input.message, /reset (my )?password/i) %}",
      "Next": "PasswordResetFlow"
    }
  ],
  "Default": "ConstrainedDecisionCall"
}
你也可以让模型一次性写出规则,而不是每次都运行它。让模型起草一个正则表达式或 JSON schema,审查后提交。运行时,规则以规则的速度和成本运行。审查模型编写的正则表达式,并用已知的良好和不良输入进行测试。避免使用嵌套量词,例如“ (a+)+这可能会在某些输入上使匹配变得非常缓慢(正则表达式拒绝服务,即 ReDoS)。
当你确实需要生成时,Amazon Bedrock 结构化输出会将响应约束为你定义的 JSON schema。随后响应会与 schema 匹配,因此你的代码无需自定义解析逻辑即可解析它(检查内容是否正确)。将范围检查(例如数值边界和长度限制)保留在代码中。有关支持的模型和 schema 功能,请参阅 从模型获取经过验证的 JSON 结果.
如果你的规则存在于配置中,只允许使用已知的原语,例如正则表达式、schema 检查、关键词列表和范围检查。绝不要从配置文件中运行任意代码。
当你确实需要模型时,选择规模合适的模型
选择满足你质量下限的最便宜、最快的模型。这通常不是最新或最大的模型。生成式 AI Lens 在其最佳实践中涵盖了这一点,即 选择合适的模型规模. Amazon Bedrock 的有效成本优化策略 深入介绍了这一点。在比较模型之前先定义需求:
- 质量下限: 可接受的最低输出质量,在黄金评估集(带有已知正确答案的任务标注示例)上衡量。
- 成本上限: 每次请求或每个成功结果所需支付的最高费用。
- 延迟目标: 体验所能容忍的 p95 或 p99 响应时间。
- 合规约束: 诸如数据驻留等可能排除候选模型的要求。
Amazon Bedrock 通过一个 API 提供多种模型系列和规模,因此你可以为每个任务选择合适规模,而无需更改集成。 Amazon Bedrock 智能提示词路由 将每个请求路由到受支持模型系列中合适的模型。 Amazon Bedrock 模型蒸馏 将知识从较大的模型迁移到较小、成本更低的模型,以适配你的使用场景。模型提供商会用广泛的基准测试来评估新的前沿模型,但你的工作负载只是单一任务,且只有一个质量下限。较大的模型可能增加成本和延迟,却无法改善该任务的表现。在切换之前,请根据你的需求评估每一次发布,例如在黄金评估集上的质量和你的延迟目标。
将模型选择视为经过测试的配置
生成式 AI Lens 建议用你的基准真值数据测试候选模型,并具备快速更新模型的方法。更进一步,把这一决策当作经过测试的配置来对待:
- 为每个任务维护一个黄金评估集,其中包含标注好的基准真值,并在持续集成中运行它。
- 根据你的需求进行把关。把低于质量下限的更便宜模型视为回归。
- 将模型置于配置标志之后,以便你可以回退一次替换。
- 用正确的判定基准来验证。对照基准真值检查规则。将模型作为评判者的评估保留给开放式输出。
- 留意漂移。在影子模式下通过模型抽样一些由规则解析的请求,当二者不一致时重新分类该步骤。
付诸实践
把模型容量花在需要判断的地方,其他地方一概不用。你可以通过四个步骤做到这一点:
- 工具 – 将每次调用标记为确定性代码、受限决策调用或模型调用。跟踪每个成功结果对应的成本。
- 将规则迁移到代码中—— 在 AWS Lambda 或 AWS Step Functions 上运行可进行规则校验的步骤。这通常是收益最大且最安全的做法。
- 添加受限决策调用—— 将固定选项步骤交给一次调用处理,当它不确定时再升级。
- 在切换模型之前先进行测试—— 在它成为默认模型之前,让每个新模型都通过你的黄金评估集。
结论
在本文中,你了解了如何判断一个工作流步骤是否根本需要模型。规则应放在确定性代码中,固定选项应放在受限决策调用中。开放式工作则交给规模合适的 Amazon Bedrock 模型。目标是在你的质量下限允许的范围内,以最低的成本和延迟满足每项要求。在问该用哪个模型之前,先问这个步骤是否需要模型。
更多信息,请参阅 AWS 人工智能博客上的这些文章:
- 使用 Amazon Bedrock AgentCore Evaluations 的决策模型。.
- 使用 Amazon Bedrock Intelligent Prompt Routing 以获得成本和延迟方面的优势.
- Amazon Bedrock 上的结构化输出:符合 schema 的 AI 响应.
- 修复评估偏差,在 Amazon Bedrock 上释放更好的模型.
要尝试受限决策调用,请打开 Amazon Bedrock 控制台,或从其部署 Strands Decider GitHub 仓库.
从一个高流量工作流开始,并衡量其中有多少部分根本不需要模型。