人工智能
使用 Amazon Bedrock Managed Knowledge Base 进行单次与智能体检索一位银行运营部门的员工在早晨开始时,向内部 AI 助手询问开立企业账户需要哪些文件。答案就在一份清单中。几个小时后,同一位员工又问,这些要求对于独资企业、有限责任公司(LLC)和拥有多名所有者的合伙企业有何不同。这个答案分散在几份政策指南中。同一个助手必须同时处理这两个问题:对第一个问题要快速且低成本,对第二个问题要全面彻底。应用程序需要一种方式,将检索投入与每个请求相匹配,而不必为简单和复杂问题分别构建系统。
Amazon Bedrock Managed Knowledge Base 现在通过 AgenticRetrieveStream支持单次检索增强生成(RAG)和仅检索请求。使用单次 RAG 时,服务会搜索一次您的知识库,并使用基础模型(FM)根据找到的段落生成答案。使用仅检索请求时,服务会返回匹配的段落而不生成答案,因此您的应用程序或用户可以直接处理源文本。这些模式加入了现有的智能体检索,在该模式中,服务会在回答前规划并运行多次搜索。您现在可以使用同一个 API 来处理该员工的两个问题:用单次 RAG 进行清单查询,用智能体检索进行跨政策比较。
在本文中,我们将解释这些新设置如何工作,以及何时使用每种模式。我们使用一个示例性的内部银行政策助手来展示单次 RAG 如何处理直接问题,以及智能体检索如何支持跨政策文档的比较。我们还将展示当员工需要查看源段落而不是生成的答案时,如何配置仅检索请求。
主要优势
智能体检索 可帮助助手回答需要多次搜索的问题。基础模型会将问题分解为子查询,搜索相关知识库,并评估结果是否提供足够信息来回答原始问题。如果发现信息缺口,它可以在配置的迭代限制内优化搜索并检索更多证据。
对于应用程序构建者而言,这带来了多项优势:
- 更好地支持多部分问题 – 有针对性的搜索可以为问题的每个部分找到证据,而不是依赖一次搜索覆盖所有内容。在银行示例中,助手可以分别查找独资企业和 LLC 的要求,然后再进行比较。
- 信息缺失时进行后续搜索 – 规划器可以利用找到的内容来决定下一步搜索什么。当某个段落没有提供足够上下文时,它还可以检索完整文档,从而帮助解决单次检索可能无法解决的缺口。
- 带支持证据的答案 – 启用响应生成后,服务会将检索到的信息整合为带引用的答案。跟踪事件会显示规划和检索步骤,帮助开发者检查答案是如何生成的。
- 减少自定义编排 – 服务通过一个 API 管理规划、检索、评估和响应生成工作流。应用程序无需实现自己的循环来协调这些步骤。
这些智能体能力对于复杂问题仍然很有价值。对于直接查询,应用程序也需要一种无需额外规划即可检索和回答的方式。扩展后的 maxAgentIteration 范围弥补了这一缺口。通过一个参数,您可以为每个请求选择三种模式之一:
- 仅检索 返回段落而不生成答案。
- 单次 RAG 检索一次并生成答案,不进行规划轮次。
- 智能体检索 针对复杂问题规划并运行多次搜索。
单次 RAG 使用一次基础模型调用来生成答案,与智能体检索相比,可以减少延迟和模型使用量。仅检索请求不进行任何基础模型调用。您可以为每个请求平衡速度和答案质量,而无需集成第二个 API,也无需为简单和复杂查询维护单独的代码路径。
如何计算检索迭代次数
在介绍新的取值之前,有必要先明确迭代次数是如何计算的,因为这正是行为可预测的关键。
一次迭代等于一次基础模型调用。循环始终以一次答案生成调用结束。取值 n 最多可进行 n 减 1 轮智能体规划,最后一次迭代保留用于生成响应。每个规划轮次包括一次查询重写和一次检索。迭代次数越多,意味着规划轮次越多,在难题上的结果越好。迭代次数越少,意味着延迟越低。
有一点不计入:推测性检索。在第一个规划步骤之前运行的初始检索属于检索,而不是迭代。它永远不会计入您的 maxAgentIteration 值,而且只会让请求更快。在阅读以下取值时,请记住这一区别。
新增内容
范围现在为 0–5。
三种模式均支持多个知识库,包括 maxAgentIteration=0 和 1。单次检索并不意味着单个知识库。智能体模式增加了查询分解、证据评估和迭代搜索,而不是对多个知识库的独占访问。
maxAgentIteration = 1:基础 RAG(主要用例)
这就是单次 RAG:一次检索,然后一个答案。没有智能体规划,没有查询重写。API 针对您的查询检索一次,并基于这些段落生成有依据的响应。这就是 检索一次,然后生成响应 模式,此前无法通过此 API 表达。
将其与 generateResponse=true 搭配使用,可获得基于检索段落生成的有依据答案。如果您只需要段落,请改用 maxAgentIteration=0 ,如下一节所述。
如果您的大部分流量都是范围明确、直接的问题,这很可能就是您想要的默认设置。
maxAgentIteration = 0:仅返回段落,零次 LLM 调用
这会执行一次有保证的检索,不生成任何内容。不会调用任何基础模型。它等同于直接调用 Retrieve API。因此,对于已经统一使用 AgenticRetrieveStream 并宁愿更改参数也不愿切换 API 的调用方来说,这一设置最为有用。
由于不调用任何大语言模型(LLM),因此没有答案可生成。将 generateResponse=true 设为该值无效,会返回 4xx 错误,因为生成答案需要调用 LLM。
maxAgentIteration = 2 到 5:智能体模式,行为不变
在 智能体模式下,基础模型会将复杂问题拆解为聚焦的子查询,并在多个步骤中检索证据,包括跨多个知识库进行检索。它会评估检索到的信息,并在证据缺失时优化搜索。对于单次搜索可能无法完全解决的多部分问题和比较类问题,这种方法可以提高检索准确性。
启用响应生成后,值 n 允许在基于检索到的证据生成答案之前进行最多 n 减 1 轮规划。使用 2–5 之间值的现有请求保持当前行为不变。
如何选择取值
一种理解方式是:
maxAgentIteration |
您得到什么 | 最适合 |
| 0 | 一次检索,不生成,零次 LLM 调用 | 段落检索。已统一使用此 API、希望获得 Retrieve 式行为的调用方 |
| 1 | 一次检索加一个答案 | 面向直接、范围明确问题的单次 RAG |
| 2 到 5 | 最多 n 减 1 轮规划,然后生成答案 | 多部分、比较类、探索性以及跨知识库的问题 |
值越低,调用越快、越可预测。值越高,规划器在真正困难的问题上就能进行更多分解和优化。对于简单流量,从低值开始;当复杂查询的准确性比延迟更重要时,再提高该值。
实践示例:内部银行政策助手
设想一家虚构的银行,其运营团队使用一个由开户流程、文档清单和政策指南知识库支持的内部助手。员工使用该助手查找并理解银行记录在案的要求。以下示例说明应用程序如何为每个工作流选择检索模式。这些示例并不描述客户部署或实测结果。
下图展示了银行助手如何为每个请求选择检索模式。
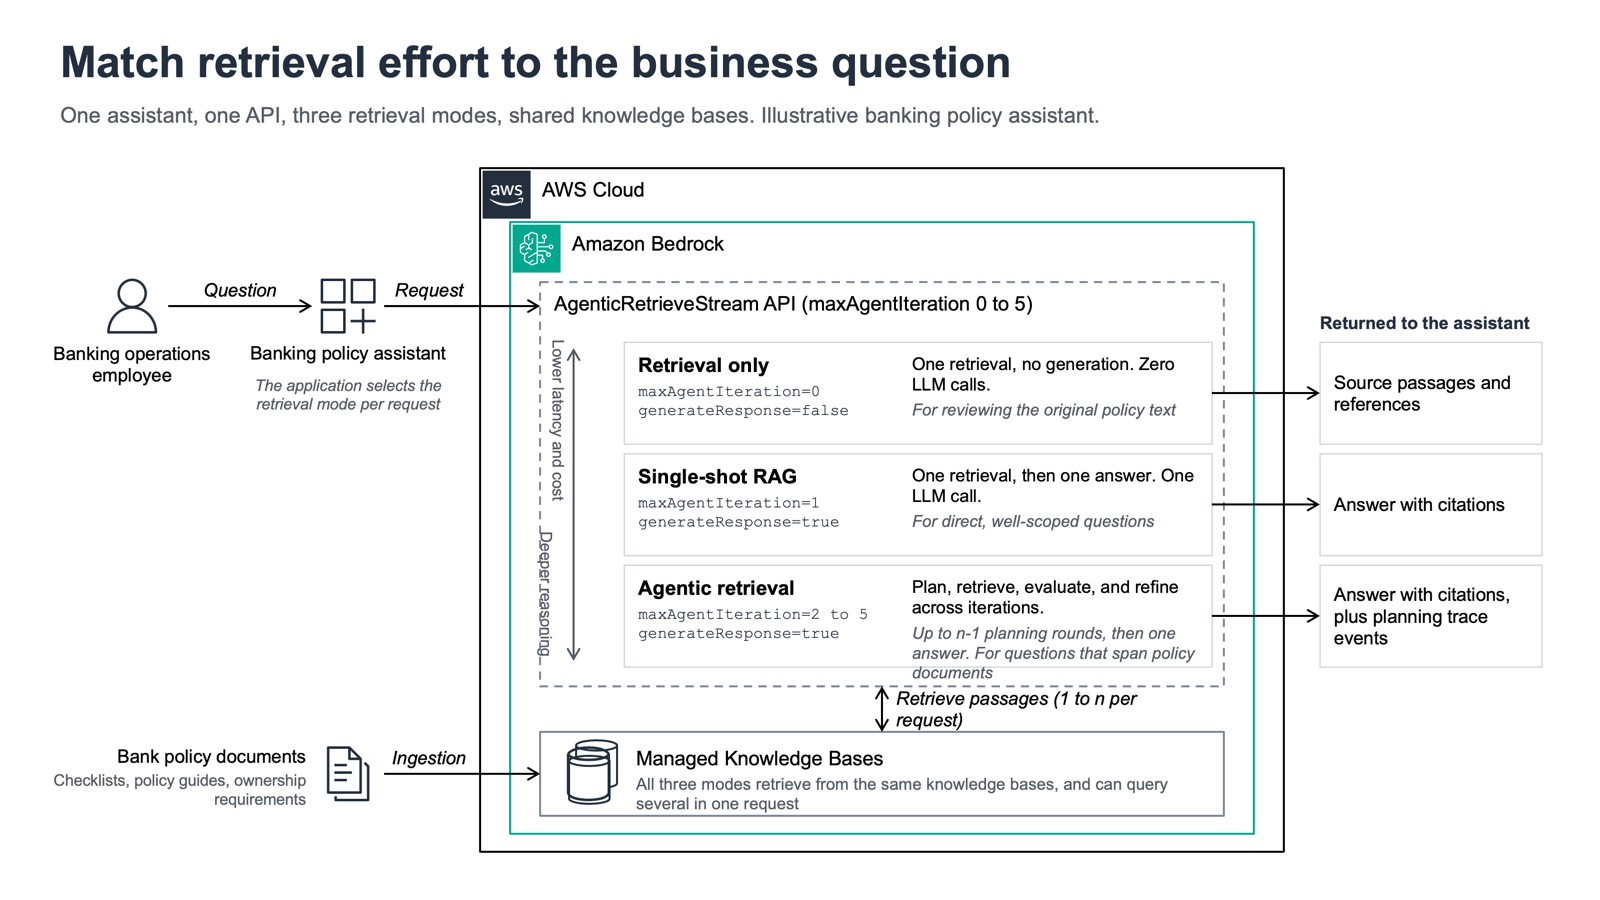
图 1:银行助手如何为每个请求选择检索模式
员工向助手提问。应用程序选择一种检索模式,并将请求发送到 AgenticRetrieveStream。在单次 RAG 中,服务会搜索知识库一次并生成答案。在智能体检索中,服务会将问题拆分为多个部分,多次搜索,然后生成带引用的答案。在仅检索模式下,服务返回源段落而不生成答案。以下各节将解释每种模式。
回答直接的文档问题
一名员工问道:“为独资经营者开立企业支票账户需要哪些文件?”在此示例中,银行维护了一份包含答案的专用清单。应用程序设置 maxAgentIteration=1 和 generateResponse=true 来检索相关段落并生成响应,不进行查询重写或智能体规划。
这就是单次 RAG 模式:一次检索,随后一次答案生成调用。当问题和支撑内容已经范围明确时,它可以避免规划步骤。
比较不同政策文档中的要求
另一名员工问道:“独资经营者和有限责任公司的开户要求有何不同,根据我们的政策,非居民所有者是否适用任何额外检查?”回答这个问题可能需要来自不同流程和所有权验证指南的信息。
对于此工作流,应用程序可以设置 maxAgentIteration=4 和 generateResponse=true,允许在生成答案之前最多进行三轮规划。规划器可以将问题拆分为子查询,检索相关证据,并在信息缺失时优化搜索。应根据有代表性的问题来评估合适的迭代上限,而不是假设更高的值总能产生更好的答案。
显示源段落而不生成答案
正在审阅开户流程的员工可能希望看到相关政策文本,而不是生成的摘要。应用程序设置 maxAgentIteration=0 和 generateResponse=false 以返回段落,不进行任何语言模型调用。然后,它可以显示这些段落及其来源引用,供员工审阅。
所有三个工作流都使用 AgenticRetrieveStream。应用程序选择迭代上限以及是否返回生成的答案。选择模式属于应用程序逻辑,而不是此参数提供的自动路由。该助手支持政策查询和比较。它不批准账户,也不替代银行的审核和授权流程。
解决方案概述
以下示例展示了一个完整的智能体请求。其后的各节将其调整为单次 RAG 和仅检索模式。
为银行助手选择检索模式
示例代码使用虚构的政策文档演示了这三个工作流。
{
    "messages": [
        {
            "content": {
                "text": "How do account-opening requirements differ for sole proprietors and LLCs, and what additional checks, if any, apply to nonresident owners under our policy?"
            },
            "role": "user"
        }
    ],
    "retrievers": [
        {
            "description": "Knowledge base of account-opening procedures, documentation checklists, and policy guides",
            "configuration": {
                "knowledgeBase": {
                    "knowledgeBaseId": "KB12345678"
                }
            }
        }
    ],
    "generateResponse": true,
    "agenticRetrieveConfiguration": {
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        "maxAgentIteration": 4
    }
}
示例:单次 RAG
设置基本 RAG 只需在智能体调用基础上做一行更改。将 maxAgentIteration 设为 1,并保持响应生成开启。
{
    "messages": [
        {
            "content": {
                "text": "What documents are required to open a business checking account for a sole proprietor?"
            },
            "role": "user"
        }
    ],
    "retrievers": [
        {
            "description": "Knowledge base of account-opening procedures, documentation checklists, and policy guides",
            "configuration": {
                "knowledgeBase": {
                    "knowledgeBaseId": "KB12345678"
                }
            }
        }
    ],
    "generateResponse": true,
    "agenticRetrieveConfiguration": {
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        "maxAgentIteration": 1
    }
}
您仍像以往一样消费流。不同之处在于流中的内容:一次检索和一个有依据的答案,中间没有规划跟踪事件。
示例:仅返回段落
对于不生成内容的检索,将 maxAgentIteration 设为 0。在此值下,响应生成必须关闭。
{
    "messages": [
        {
            "content": {
                "text": "Show the policy text for the business account-opening procedure."
            },
            "role": "user"
        }
    ],
    "retrievers": [
        {
            "description": "Knowledge base of account-opening procedures, documentation checklists, and policy guides",
            "configuration": {
                "knowledgeBase": {
                    "knowledgeBaseId": "KB12345678"
                }
            }
        }
    ],
    "generateResponse": false,
    "agenticRetrieveConfiguration": {
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        "maxAgentIteration": 0
    }
}
这会返回去重后的源段落,不生成答案。检索行为与直接调用 Retrieve 一致,但响应格式不同:段落会出现在流的 result 事件中,且不包含 score 或 location 字段。
结论
借助 Amazon Bedrock Managed Knowledge Base,您现在可以通过以下方式在一个助手内组合单次 RAG、智能体检索和仅检索请求: AgenticRetrieveStream在银行示例中,您可以启用响应生成来回答开户清单问题,这样会生成答案而不进行规划调用。对于跨业务结构的比较,您可以设置以允许在生成响应之前进行额外搜索。当员工需要阅读政策文本时,您可以设置并禁用响应生成,以返回段落而不调用语言模型。您的应用程序选择模式,员工继续使用同一个助手。 maxAgentIteration=1 要在现有应用程序中采用新模式,请从您自己文档中的一组有代表性的问题和预期答案开始。使用同一知识库,将单次 RAG 与您当前的智能体配置进行比较。测量响应延迟和请求成本,并检查答案是否正确且有检索到的段落支持。纳入答案跨多个文档的问题,以及文档无法回答的问题,这样更快的响应就不会掩盖缺失的证据或不支持的结论。 maxAgentIteration=4 利用这些结果,选择满足每个工作流质量要求的最低迭代上限。在额外搜索能改善答案的地方保留智能体检索,在单次检索足够的地方使用单次 RAG,并在任务是源审阅时禁用生成。现有使用 2–5 值的请求保持不变,因此您可以有选择地引入新模式,而不必重新设计整个应用程序。 maxAgentIteration=0 并禁用响应生成,以返回段落而不调用语言模型。您的应用程序选择模式,员工继续使用同一个助手。
要在现有应用程序中采用新模式,请从您自己文档中的一组有代表性的问题和预期答案开始。使用同一知识库,将单次 RAG 与您当前的智能体配置进行比较。测量响应延迟和请求成本,并检查答案是否正确且有检索到的段落支持。纳入答案跨多个文档的问题,以及文档无法回答的问题,这样更快的响应就不会掩盖缺失的证据或不支持的结论。
利用这些结果,选择满足每个工作流质量要求的最低迭代上限。在额外搜索能改善答案的地方保留智能体检索,在单次检索足够的地方使用单次 RAG,并在任务是源审阅时禁用生成。现有使用 2–5 值的请求保持不变,因此您可以有选择地引入新模式,而不必重新设计整个应用程序。
要开始使用,请配置 maxAgentIteration , generateResponse 中的 AgenticRetrieveStream API 参考,然后根据应用程序的问题和响应时间目标评估这些设置。要了解有关该服务的更多信息,请访问 Amazon Bedrock Managed Knowledge Base 服务页面。关于作者 AgenticRetrieveStream API 参考,然后根据应用程序的问题和响应时间目标评估这些设置。要了解有关该服务的更多信息,请访问 Amazon Bedrock 托管知识库 服务页面。