人工智能
Exowatt 借助 SageMaker 无服务器模型定制在准确率上超越前沿模型Exowatt 构建模块化、可调度的太阳能系统,为 AI 数据中心等能源密集型应用提供可靠电力。其旗舰产品 Exowatt P3 通过光学透镜捕获太阳能,将其以热量形式储存在长时热电池中,并通过热机按需调度电力。与并网光伏太阳能系统不同,P3 在电表后端直接为数据中心供电,帮助数据中心无需等待长达数年的电网并网排队即可上线。Exowatt 构建了一组 AI 智能体,用于监控和分诊实时告警,并为太阳能系统提供运营决策支持,这些系统往往位于边缘侧,连接有限甚至无连接。随着其机队从测试台扩展到制造阶段并部署数千台现场设备,运行这些系统的智能层也必须随之扩展。
本文介绍 Exowatt 如何利用 Amazon SageMaker AI 无服务器模型定制构建可重复的 AI 流水线。该流水线为边缘和云端两个部署目标生成任务专用的微调模型,准确率高于前沿模型,成本最高降低 49 倍。
这里描述的两个模型是该流水线的首批产出,而非最终目标。此次合作更持久的成果是流水线本身:一条从原始运营数据到经认证的训练集、微调模型和已评估部署产物的可重复路径。Exowatt 现在可以在几天内而非数月内跑完这条路径。告警分诊和能源市场分析只是众多狭窄、高价值任务中的两个,同样的方法也适用于这些任务。
挑战:在实体能源基础设施上运行 AI
Exowatt 的能源管理系统(EMS)运行在日益增长的运营站点机队上。每个站点持续产生告警:硬件组件运行超出规格、连接中断、电压读数超出范围以及类似事件。随着机队扩展到数千台现场设备,人工操作员无法实时监控每个站点。Exowatt 需要一个 AI 智能体,能够读取每个站点的告警状态,并自主、可靠地采取或建议正确的下一步行动。
前沿模型无法解决这个问题,原因有三:
- 任务狭窄且专有。Exowatt EMS 上的告警分诊取决于其特定硬件、数据和运营逻辑。通用前沿模型并不专门针对此任务。
- 必须在边缘运行,没有 GPU,且往往没有互联网。许多站点连接有限或间歇性中断,因此依赖云端调用前沿模型的智能体在连接中断时会让操作员失去覆盖。
- 成本无法在机队层面扩展。将每个运营决策都路由到前沿模型,在数千个站点上对持续重复的决策并不经济。
这正是 Exowatt 转向模型定制的原因。Exowatt 最初的微调工作流依赖于选择开放权重模型、构建容器并创建自定义训练配方,之后才能运行任何实验。这是模型实验的主要障碍。此外,他们还必须决定模型微调的 GPU 硬件需求。随着团队加快实验节奏,每次运行首先需要选择特定的 GPU 实例类型,然后等待该自选容量可用。当所选实例类型不可用时,这可能延迟运行开始或完全阻塞运行。
他们需要一个足够小、可在无 GPU 边缘控制器上运行的模型,同时在该特定任务上足够准确,能与前沿模型相比自主行动。微调缩小了这一差距:一个紧凑、任务专用的模型,既可在云端部署,也可在边缘部署。
解决方案概述
Exowatt 通过在 Amazon SageMaker AI 上采用云原生、无服务器模型定制方法应对这些挑战。同一训练流水线为两个部署目标生成微调模型:边缘和云端。
Exowatt 在第一个用例(边缘告警分诊)中基于 Qwen3-1.7B 模型实施了该方法,然后将同样的方法应用于第二个用例(云端能源市场分析)的 Qwen3-14B 模型。公司计划复用该解决方案,在整个机队中构建更小的任务专用模型。
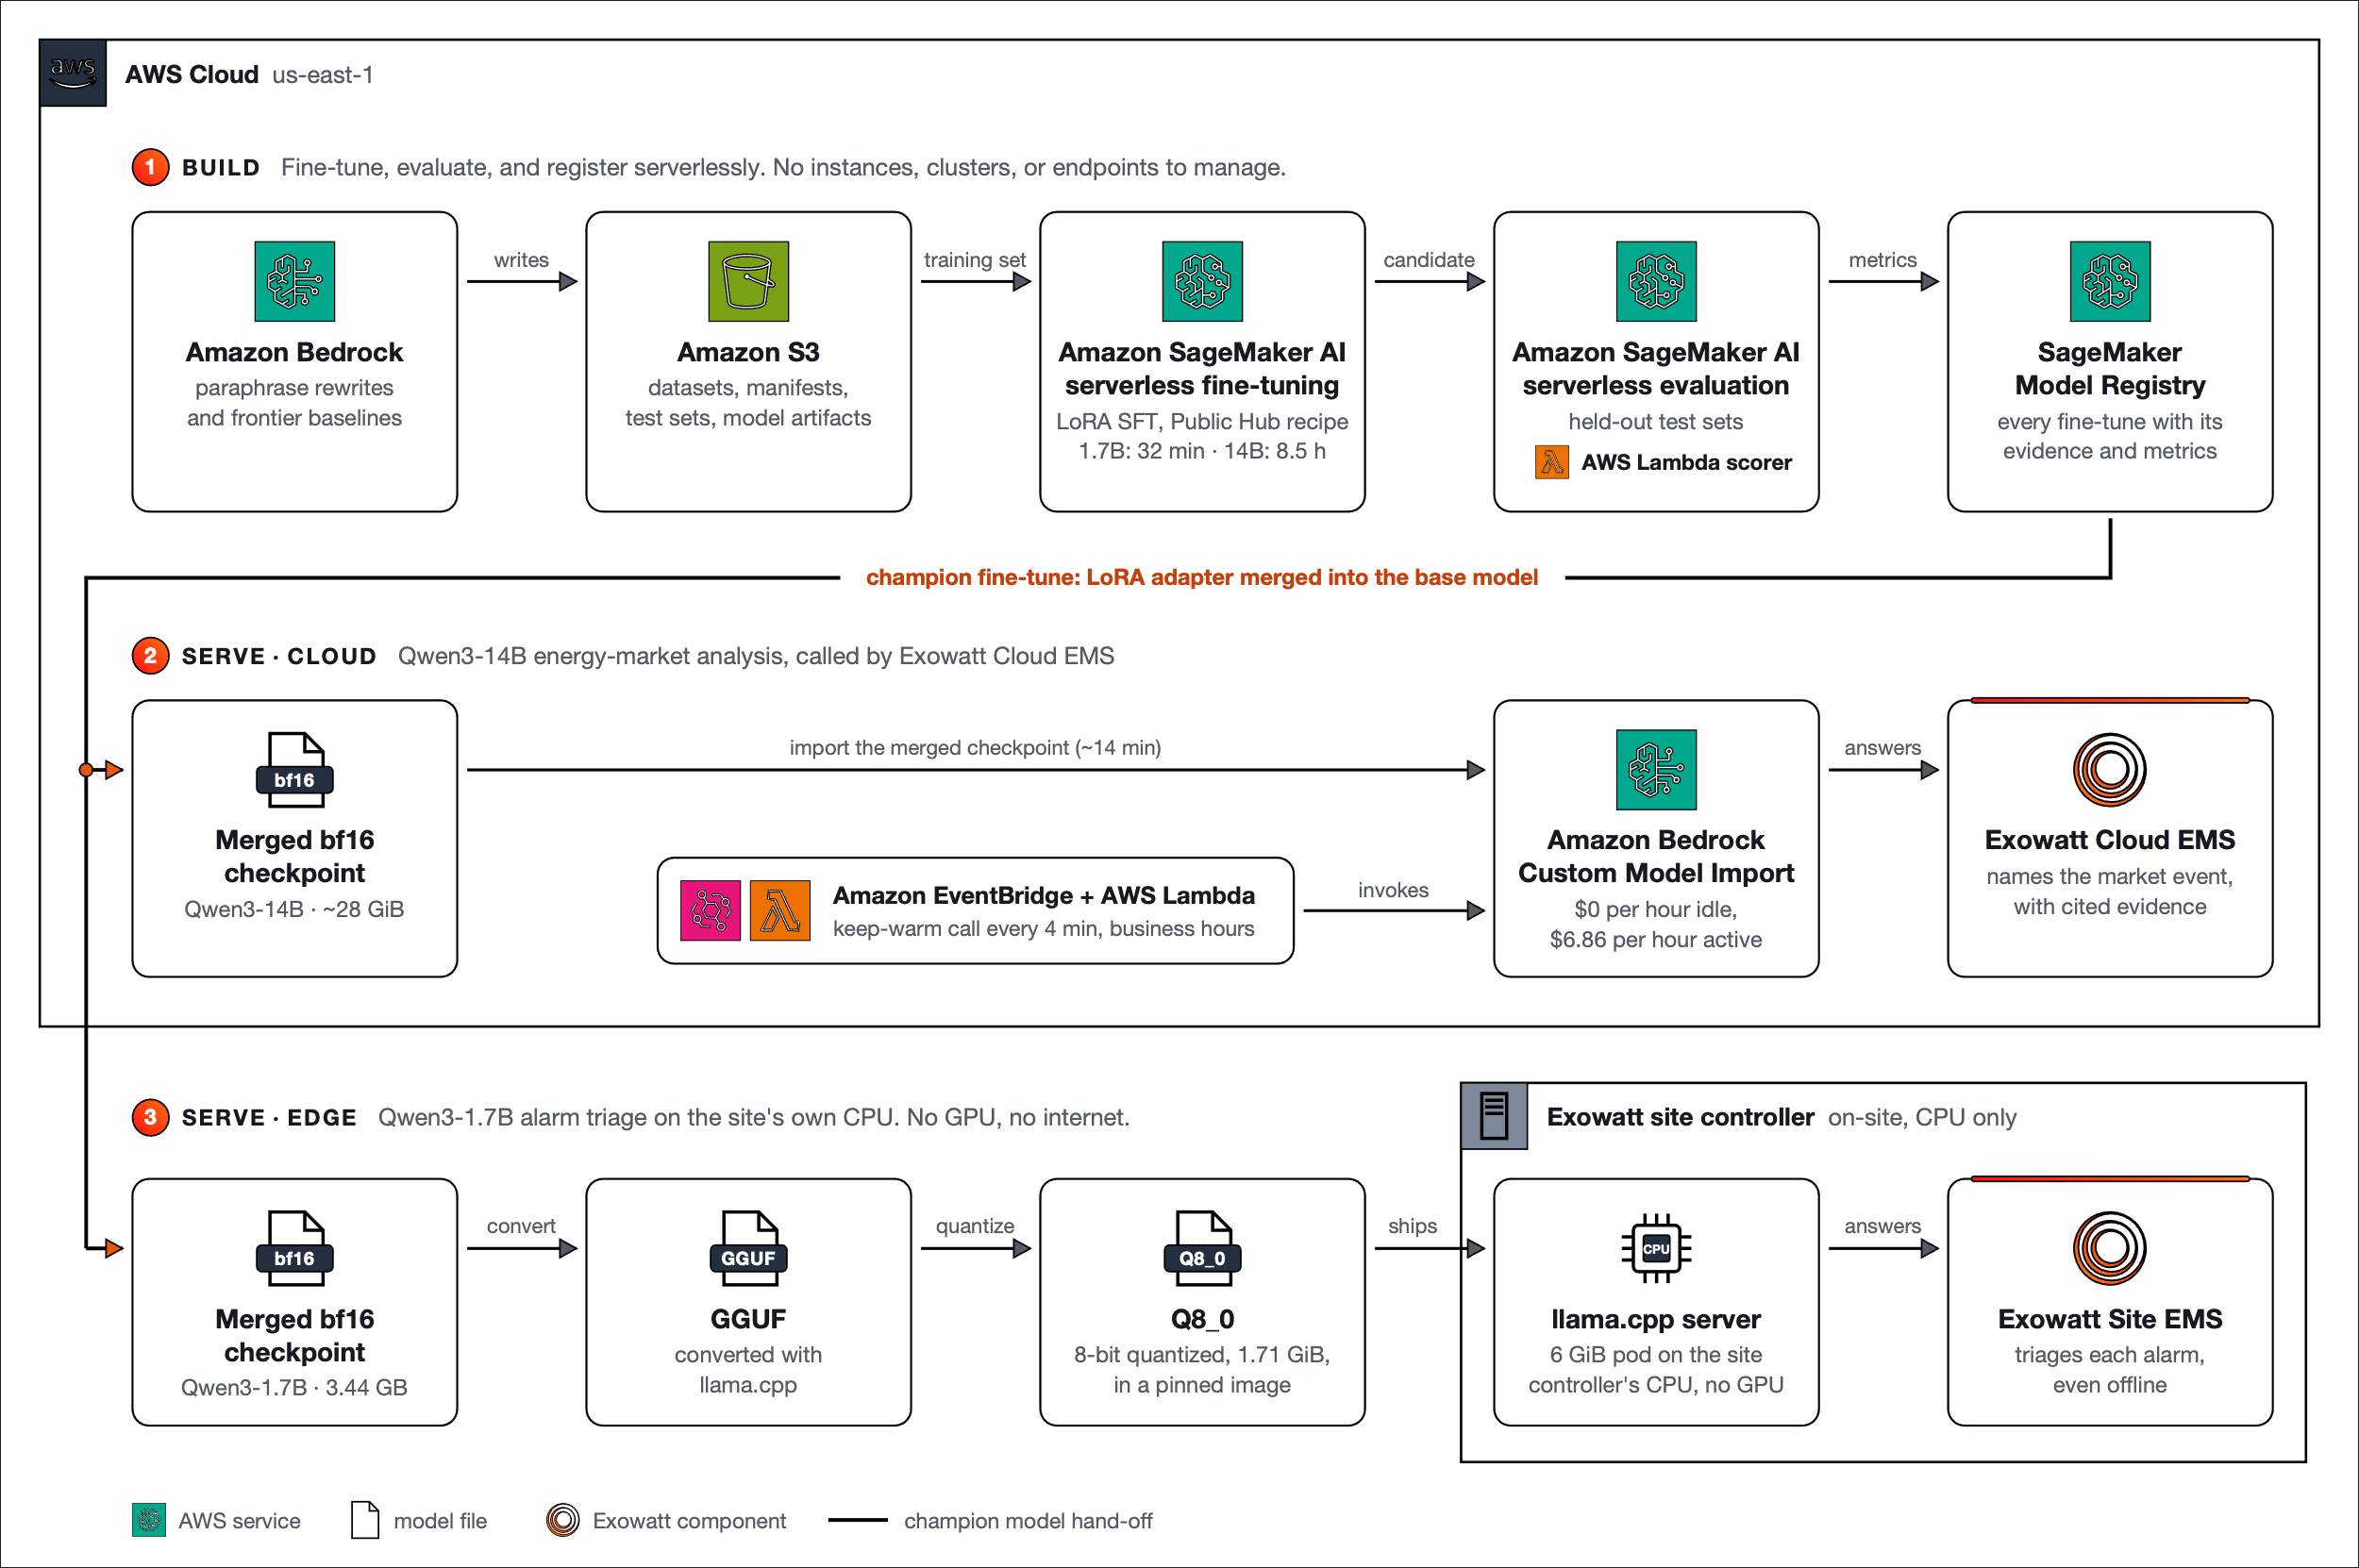
图 1:Exowatt 微调与部署流水线,涵盖构建、云端服务和边缘服务三个阶段
以下七项 AWS 服务为 AI 流水线提供支持,无需管理实例、集群或端点:
| AWS 服务 | 用途 |
| Amazon Simple Storage Service (Amazon S3) | 数据、清单、模型产物和测试集 |
| Amazon SageMaker AI 无服务器微调 | 每次微调运行,从 Public Hub 配方启动 |
| Amazon SageMaker AI 无服务器评估 | 每个候选模型 2,000 条答案作为托管作业评分 |
| SageMaker Model Registry | 每次完成的微调及其证据和指标 |
| Amazon Bedrock Custom Model Import | 托管用于 Cloud EMS 的微调 Qwen3-14B,由 Cloud EMS 服务私有调用。无闲置成本 |
| Amazon Bedrock(Claude、Qwen3) |
改写(训练数据中每个答案三次重写)和前沿模型基准测试 告警分诊改写使用 Amazon Bedrock 上的 Qwen3-VL-235B。能源市场改写使用 Amazon Bedrock 上的 Claude Sonnet 4.6。 |
| AWS Lambda + Amazon EventBridge | 无服务器评估评分器以及自定义模型的定时保活调用 |
该工作流分为三个阶段:
模型定制(云端): Exowatt 使用无服务器模型定制、低秩适配(LoRA)和监督微调(SFT)在 SageMaker AI 上微调开放权重基础模型。由于无服务器训练按需分配容量,团队每天可运行多个实验,而无需等待自选 GPU。评估后,最佳模型注册到 SageMaker AI Model Registry。
边缘部署: 对于告警分诊等对延迟敏感、受连接性限制的工作,微调后的 Qwen3-1.7B 模型被冻结、量化为 GGUF 格式,并通过现场控制器在边缘的 Kubernetes Pod 内使用 llama.cpp 运行。此路径无需 GPU,且无需互联网连接即可运行。
云端部署(弹性): 对于联网的车队级分析,微调后的 Qwen3-14B 能源市场模型通过 Amazon Bedrock Custom Model Import 提供服务,该服务无闲置成本,仅在模型活跃时计费。
为什么选择 Amazon SageMaker AI 无服务器模型定制
Amazon SageMaker AI 无服务器模型定制服务通过 SageMaker Public Hub 提供多种开放权重模型及现成的微调配方,因此团队无需构建和优化自定义训练容器,而这项工作通常可能需要数周。对 Exowatt 而言,这将微调从一项稀缺的、需排期的活动转变为常规的按需活动。这使得快速实验与测试循环变得可行,同时保持较低的实验成本。
在预置 GPU 上进行微调需要选择特定实例类型、申请该容量、等待其可用、运行作业,并在持有实例期间持续付费。持有时间通常包括实验之间的空闲时间,因为专用实例会一直保持运行。对于运行大量实验的小团队来说,这会拖慢创新并增加成本。Amazon SageMaker AI 无服务器模型定制会自动管理和编排运行微调作业所需的基础设施,消除容量管理的烦恼,并且仅按微调作业运行时间计费。
用例 1:使用 Qwen3-1.7B 进行边缘告警分诊
Exowatt 站点全天候产生告警。一个紧凑的现场模型会读取每条告警以及站点自身的状态和遥测数据,并返回一小组固定分类之一,附带引用的证据(例如系统离线、组件降额或传感器不匹配),或在证据不足时明确弃权。
模型选择与训练数据
团队首先尝试了带提示和护栏的 Qwen3-8B,但其表现停滞在目标以下(0.735 宏 F1)。微调后的 Qwen3-1.7B 改变了这一局面:在这个狭窄的单轮任务上,它以约五分之一的参数量超越了 Qwen3-8B 加提示的设置,同时保持足够小,适合无 GPU 的边缘推理。跨 12 个数据集版本的 13 个微调 Qwen3-8B 候选模型从未击败带提示的 8B 基线。而更小的模型配合更多样化的数据做到了。
训练集规模小且经过精心策划:2,522 个示例,由针对生成的站点场景的 684 个已验证决策,加上 1,838 条经认证的改写组成,这些改写保持每个决策不变,同时重写文本。改写由 Amazon Bedrock 上的 Qwen3-235B 生成,成本约为 3.72 美元。仅当确定性检查确认决策、标签、证据引用和每个数字均未改变时,才保留每条改写(2,218 个候选中通过了 1,838 个)。一个故障类别被完全排除在训练之外,并保留 320 个案例用于测试。
训练与部署
训练在 SageMaker 无服务器微调上约 32 分钟完成,成本约为 20–25 美元。模型量化为 8 位(约 1.71 GiB),在站点现有 CPU 服务器的 6 GiB llama.cpp Pod 中离线运行。它也可在 t3.2xlarge 实例类型上运行。
用例 2:使用 Qwen3-14B 进行云端能源市场分析
可调度储能将时机转化为运营决策:每个站点必须持续决定为其负载保留多少储存能量以及何时释放,而对于并网站点,市场状况会影响这一选择。微调后的模型读取六小时的实时市场数据包(约 90 行实时价格、日前预测和电网通知),并在约四秒内返回五种市场事件之一(例如价格飙升或稀缺附加费)。每项声明都关联到特定数据行,以指导调度策略。
为什么选择 Qwen3-14B
选择 Qwen3-14B 是因为它受 Amazon Bedrock Custom Model Import 支持,作为 SageMaker Public Hub 模型提供并附带现成的 LoRA 配方(无需管理自定义容器或实例类型),并且约 28 GiB 的规模足够小,可以经济高效地提供服务。
训练数据与过程
Exowatt 使用来自五年历史(12 张表约 1.63 亿行)的公开 Electric Reliability Council of Texas (ERCOT) 市场数据对该模型进行微调。团队通过规则将这些数据标注为 25,000 个示例(22,000 个用于训练,1,000 个用于验证,2,000 个留出用于测试)。然后,他们通过让 Amazon Bedrock 上的 Anthropic Claude Sonnet 4.6 重写每个示例的文本,同时保持其标签和数值字段不变,将训练集扩展到 86,281 行。
训练为单个 LoRA 轮次(rank 16,alpha 32),在托管无服务器微调中约 8.5 小时完成,最多同时运行四个作业。从初始计划到冠军模型在 Cloud EMS 中提供服务,团队在六天内运行了 23 个作业和约 155 小时的托管训练。
决定性的改进来自改写多样性:每个答案增加三次重写,将宏 F1 从 0.950 提升到 0.975。基础模型仅得分 0.415 宏 F1。它生成了有效的 JSON,但尚不了解市场。微调解决了这个问题。
部署
合并后的检查点约 14 分钟即导入 Amazon Bedrock Custom Model Import。该模型无闲置成本,仅在活跃时按每小时 6.86 美元计费。
基准测试结果
在边缘告警分诊任务上,经过微调的 Qwen3-1.7B 从一个无法生成有效答案的模型提升到在 320 个测试用例上取得 0.911 的宏 F1,超过了所有前沿基线。将相同的微调与评估循环应用于拥有 2,000 个测试用例的能源市场任务时,Qwen3-14B 达到了 0.975 的宏 F1,同样超过了前沿基线,且成本仅为后者的一小部分。在这两个案例中,一个小型微调模型在特定任务上都击败了规模大得多的通用模型。
两个模型都返回严格的 JSON,其中每一条断言都引用了具体的输入数据行。任何缺乏支持的断言都会在到达操作员之前被丢弃,这正是团队能够在自主的物理环境中信任小型模型的原因。
| 模型 | 宏 F1 | 每 1,000 次决策成本(美元) | 离线运行? |
| Claude Haiku 4.5 | 0.519 | ~$4.70 | 否 |
| Claude Opus 4.7 | 0.680 | ~$22 | 否 |
| Claude Sonnet 4.6 | 0.698 | ~$15 | 否 |
| 微调后的 Qwen3-1.7B | 0.911 | $0* | 是 |
| 基础版 Qwen3-1.7B | 无得分(未通过有效性门槛) |
表 1:边缘告警分诊结果,微调后的 Qwen3-1.7B 与前沿模型对比
每 1,000 次决策 0 美元意味着没有按量计费的 API 或 GPU 推理成本。量化模型运行在站点现有的 CPU 上。
| 模型 | 宏 F1 | 事件准确率 | 有效 JSON | 每 1,000 个答案成本(美元) |
| 基础版 Qwen3-14B | 0.415 | 0.54 | 0.834 | $0.64 |
| Claude Sonnet 4.6 | 0.538 | 0.584 | 0.991 | $17.79 |
| Claude Opus 4.7 | 0.625 | 0.718 | 0.9995 | $29.26 |
| 微调后的 Qwen3-14B | 0.975 | 0.983 | 1.000 | $0.60 |
表 2:云端能源市场分析结果,微调后的 Qwen3-14B 与前沿模型对比
成本按 Amazon Bedrock 目录价乘以每个答案实测的 token 数计算。微调将一个开放模型从最后一名提升到第一名:相比 Claude Opus 4.7 提升 0.35 宏 F1(95% 置信区间为 0.324 至 0.371),而每 1,000 个答案的成本约低 49 倍(0.60 美元对 29.26 美元)。该模型在之后第二个测试集上保持了 0.968 的宏 F1。
业务收益
更快的迭代和更快的上市时间: Exowatt 仅用九天就将其定制模型从实验推进到生产。如果团队必须构建和优化自定义容器与训练配方、配置 GPU 并管理基础设施,这一过程可能需要数月。借助 SageMaker AI 无服务器模型定制,团队训练 Qwen3-1.7B 约用 32 分钟,训练 Qwen3-14B 约用 8.5 小时,无需申请容量,且最多可同时运行四个训练作业。对于能源市场用例,Exowatt 运行了 23 个作业,总计约 155 小时的托管训练,并在六天内从基础模型推进到在 Cloud EMS 中提供服务的微调模型。合并后的检查点约 14 分钟即导入 Amazon Bedrock。端到端流水线使用了七项 AWS 无服务器服务,Exowatt 无需管理任何实例、集群或端点。
相比前沿模型更高的准确率: 两个微调模型在各自任务上都击败了规模更大的前沿模型:Qwen3-1.7B 为 0.911 宏 F1(Claude Sonnet 4.6 为 0.698),Qwen3-14B 为 0.975(Claude Opus 4.7 为 0.625)。
两种部署方式下更低的成本: 在云端,Qwen3-14B 每 1,000 个答案的服务成本为 0.60 美元,而 Claude Opus 4.7 为 29.26 美元(约低 49 倍),没有闲置成本,仅在 Amazon Bedrock Custom Model Import 上活跃时按每小时 6.86 美元计费。在边缘端,量化后的 Qwen3-1.7B 运行在站点现有的 CPU 上,没有每次推理成本,也不依赖网络连接。
有据可依、低风险的输出: 在两个模型中,证据围栏移除了所有未引用的断言(即任何来源、字段或值与输入不字面匹配的证据引用),并且边缘模型在不确定时会选择弃答而非猜测。这正是团队能够以影子模式在站点的云托管副本上自主运行该模型的原因。
经验教训
对于特定任务,更小的微调大语言模型可以胜过大型前沿模型: 微调后的 Qwen3-1.7B 和 Qwen3-14B 模型在目标任务上都胜过了前沿模型,以小得多的模型实现了更高的准确率和仅为后者一小部分的成本。
数据质量和多样性胜过原始数据量和额外训练轮次: 对于范围严格限定的任务,数据质量比模型规模或数据量更重要。在告警分诊模型上,更多经过验证的训练多样性将宏 F1 从 0.584(仅用 684 条已验证决策训练)提升到 0.911(使用经改写扩展的 2,522 行数据集)。仅对相同行运行更多轮次效果更差:一个在 684 条原始行上训练 11 轮(相同步数)的对照运行仅达到 0.879。在整个过程中,精选数据比数据集规模更重要。
移除配置步骤改变了团队的工作方式: 当训练运行不再需要等待 GPU 容量时,微调就从罕见事件转变为常规的迭代工作。
一条训练流水线服务于两个部署目标: 将模型训练与部署分离,使 Exowatt 能够将同一条流水线同时用于离线边缘部署和联网的车队级分析,从而简化运维并加速云端模型部署。
结论
Exowatt 现在拥有一条可复用的 AI 流水线,可将任务从针对模型的数据准备推进到模型部署。Exowatt 不打算为不同任务调整同一个模型,而是计划将相同的微调原则应用于不同任务,每个任务都有自己的数据、特定模型和评估,并随着新设备类型和市场任务上线而在整个车队中推广。
这一模式可推广到能源行业之外。各行业的 AI 工程师、数据科学家和客户都可以采用相同的原则。使用 Amazon SageMaker AI 无服务器模型定制作为低开销的 AI 流水线,微调小型、任务特定的模型,然后将它们部署到工作发生的地方:在连接性或延迟有要求时部署到边缘,对于弹性工作负载则通过 Amazon SageMaker AI 等托管云端点部署。
如需了解更多信息,请参阅 Amazon SageMaker AI 无服务器模型定制 和 Amazon Bedrock.