 AI 热点
- 我们最新的客户黑客松将 Databricks Lakebase 推到了聚光灯下,十一个项目充分展示了为湖仓打造的 Postgres 数据库所能实现的全方位能力。
- 两条赛道对应团队使用 Lakebase 的两种方式:在其上构建应用并利用数据库分支,以及将其连接至湖仓以实时提供数据和机器学习特征。
- 从先在分支上测试操作、确认无误后才触碰生产环境的 AI 智能体,到让一家保险公司淘汰独立搜索索引的构建项目,这些成果表明,为什么运营数据库正在成为数据平台的一部分,而不是一个与之并行的系统。
Databricks 黑客松如何运作
我们举办这些黑客松的原因很简单:学习一个产品最快的方式就是用这个产品去构建东西。每场黑客松都以一场赋能培训开场,团队在其中了解产品及其路线图方向。随后开始动手构建。团队协作约一周并提交项目,最优秀的解决方案将获得奖品。
这一次,我们向比以往更广泛的客户群体开放了黑客松,而本次的主角是 Databricks Lakebase.
为什么 Lakebase 非常适合黑客松
Lakebase 是全托管的 Postgres,因此任何写过 SQL 查询或使用过 ORM 的开发者都能立即上手构建。它的不同之处在于底层架构。存储与计算分离,数据库与你的湖仓数据同处一套 Unity Catalog 治理之下。这带来了典型 Postgres 数据库难以轻松实现的三件事:
- 分支。Lakebase 的 分支 功能就像数据库的 Git 分支。新分支通过写时复制存储即时创建,因此你只需为发生变化的数据付费,而且创建分支对生产环境没有性能影响。
- 同步。 同步表 会持续将 Unity Catalog 表以只读表的形式复制到 Postgres,使应用能够以低延迟查询湖仓数据。这通常被称为反向 ETL。反方向上,Lakehouse Sync 利用变更数据捕获将 Postgres 表复制回 Unity Catalog Delta 表。
- 服务。Lakebase 可以保存应用状态,借助 pgvector、PostGIS 和 pg_trgm 等扩展支持搜索,并可作为 Databricks 在线特征存储 背后的在线存储,为实时机器学习服务。
这些正好对应我们设置的两条赛道。赛道 1 聚焦分支与构建应用。赛道 2 聚焦同步与服务。在两者之下,Unity Catalog 统一治理谁能看到什么,无论数据是在笔记本中被查询,还是被生产应用读取。
赛道 1:用 Lakebase 分支构建应用
面向对象: 应用开发者。这些工程师构建运行在运营数据之上的 应用、API 和智能体,他们过去通常不得不在缓慢的共享预发数据库与为每位开发者准备昂贵副本之间做选择。分支消除了这一取舍。每个 Lakebase 项目都从生产分支开始,你可以从中创建子分支用于开发、测试或实验。由于分支采用写时复制,大型数据库的分支几秒内即可就绪,且只有变更会占用新的存储。该赛道的团队使用 Genie Code 构建应用,并将分支视为廉价、可丢弃的生产副本。
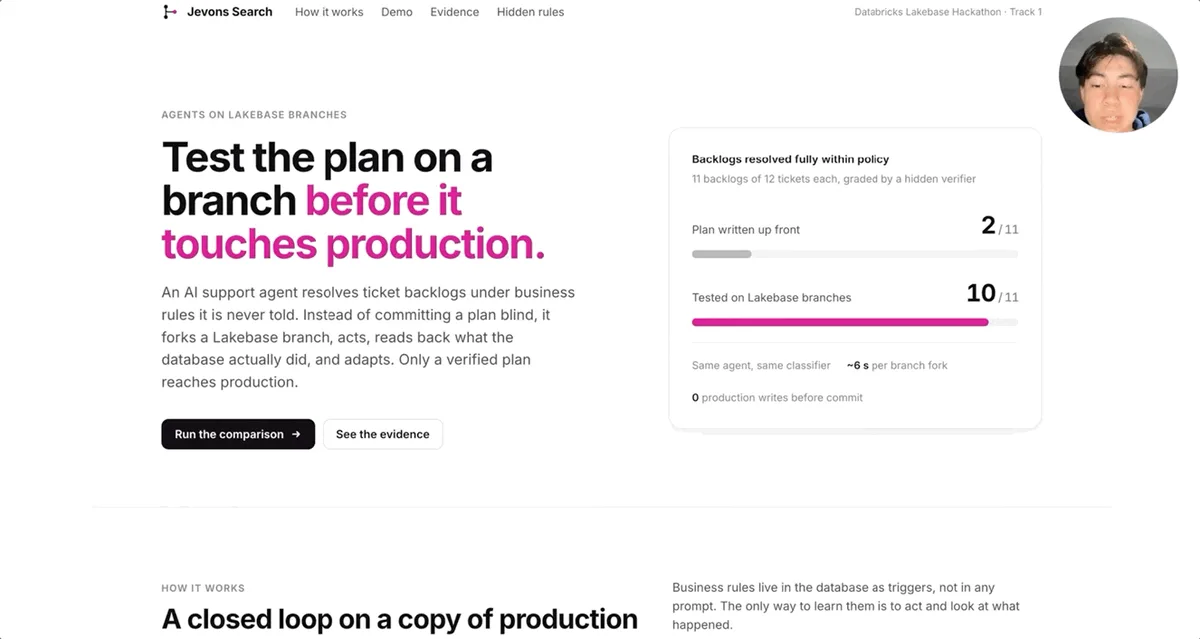
Lyft 着手解决一个随着 AI 智能体开始对生产数据采取行动而日益突出的问题:智能体在发起退款、取消预订或关闭工单时,并不知道以触发器形式存在于数据库中的业务规则。他们的项目 Jevons Search 为智能体提供一个 Lakebase 分支来操作。对于每一批支持工单,智能体在大约六秒内从生产环境分叉出一个写时复制分支,执行其操作,读回数据库实际做了什么,并进行调整。他们没有使用大型 LLM 来做规划,而是使用一个基于 gte-large 嵌入的轻量级分类器(在 MLflow 中跟踪,并在 Model Serving 上提供服务),将每张工单归入八个策略类别之一,运行时完全不消耗 LLM token。在基于 Wanderbricks 示例数据构建的合成数据集上,预先规划在符合策略的情况下完全解决了 11 个支持积压中的 2 个。在分支上测试则解决了 11 个中的 10 个。团队还测试了项目名称背后的理念:Lakebase 的分叉速度足够快,同一分钟内能评分的分支数量是原来的四倍多,但更多分支并没有带来更多通过。精确决策加上来自数据库的真实反馈,胜过了蛮力。
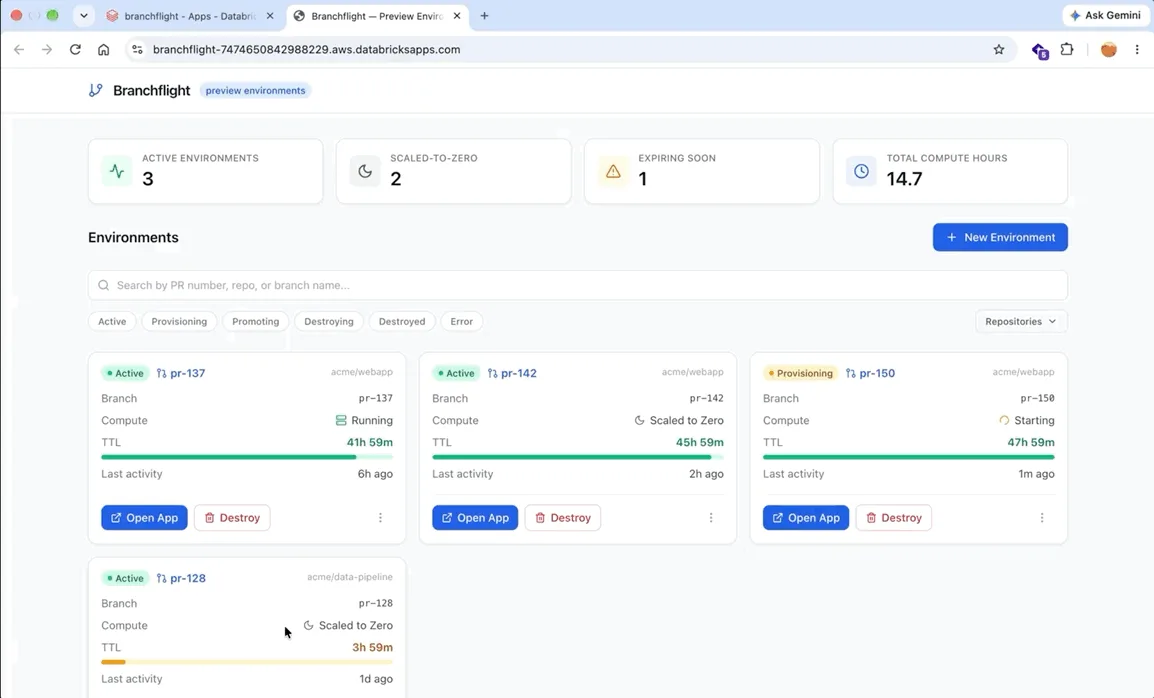
CIBC 构建了 Branchflight,一个为每个拉取请求提供独立预览环境的平台。当拉取请求开启时,Branchflight 会在不到五秒内从一个经过 PII 脱敏的模板分支创建一个零拷贝的 Lakebase 分支,并部署一个连接到它的预览版 Databricks App。环境在无人使用时缩容至零,在设定时间后自动过期,并在变更合并前通过模式差异检查。该平台自身的状态、审计日志和成本指标也存放在 Lakebase 中。
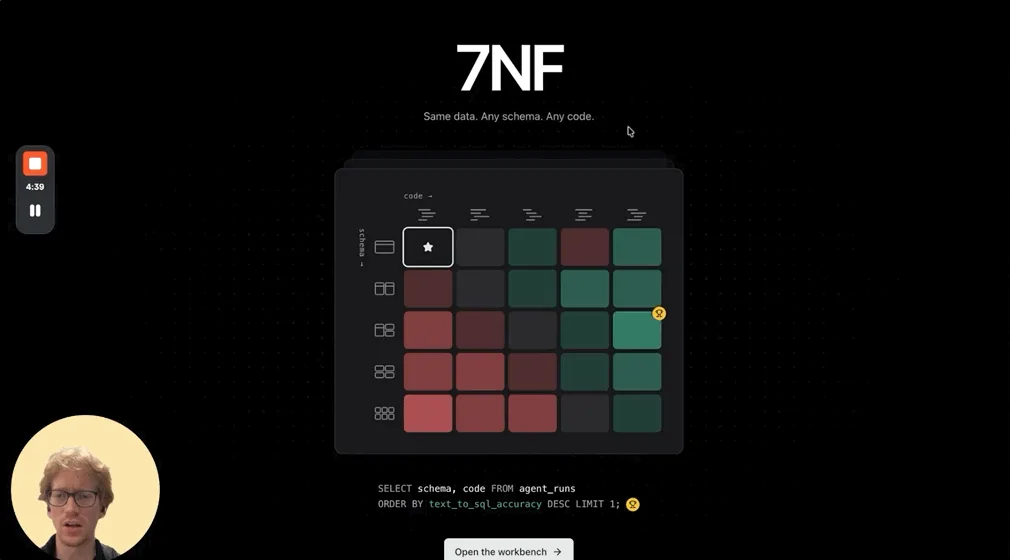
Arbital Health 提出了一个每个将文本转 SQL 面向用户部署的团队都应思考的问题:模式本身对准确率的影响有多大?他们的基准测试 7NF 保持数据不变而改变模式,每种布局都作为独立的 Lakebase 分支运行。模型仅根据是否返回正确的行来评分,因此团队可以为客户数据库挑选最佳模式,或改进自己的文本转 SQL 模型。
分支还出现在一些意想不到的地方。
在他们的黑客松提交项目中, OneTrust 将防火墙规则视为代码,把 Lakebase 分支引入网络安全领域。为了在不危及实际基础设施的情况下评估拟议变更,他们尝试让一个 Go 应用启动一个带有专用计算的写时复制 Lakebase 分支,并连接一个测试实例来运行递归可达性查询和策略检查。在测试中,扩大攻击面的试运行被立即丢弃,而通过验证的规则则直接合并到生产环境。
另一个 CIBC 团队构建了 BranchCut,这是一个 3D 电影式工作空间,将 Git 风格的分支与合并引入创意工作。创作者可以从场景中的任意节点分叉,尝试不同的镜头运动或灯光,并排比较各个版本,再将最佳版本合并回去,由 Lakebase 跟踪项目、分支、场景状态和合并历史。
Reach Mobile 构建了 StreetCart,帮助购物者比较附近商店的价格、距离和库存,而不必一家一家地跑。Lakebase 是该应用的产品、商店和库存运营数据库,Lakebase 搜索则为产品发现提供支持。团队利用分支在更改生产模式之前测试新的产品类别属性。
Markel 着手解决大多数财产与意外险保险公司都在运行的一个系统:一个独立的搜索索引,通常是 Elasticsearch,仅为了让理赔、承保和呼叫中心团队获得快速读取。这第二份副本有自己的管道、自己的模式漂移和自己的治理缺口。Markel 的应用通过 Lakebase,从用于分析的同一套受治理的 gold 表提供这些读取。理赔分析师按保单号、姓名、地址或电话搜索保单;呼叫中心坐席通过电话号码在保单、理赔和经纪人数据中识别来电者;承保人则能在一处查看某位经纪人的损失记录。新理赔在到达时即进行风险评分。
赛道 2:将 Lakebase 连接到湖仓
构建在 Lakebase 之上只是故事的一半。另一半是当运营数据库和湖仓不再是彼此分离的系统时会发生什么。
面向对象:数据和 ML 工程师。这些人构建管道和模型,通常还必须构建一条单独的路径,将数据送入需要在毫秒级获取这些数据的应用和服务。
这条赛道旨在弥合这一差距。 同步表 通过托管的 Spark 声明式管道将经过整理的 Unity Catalog 数据移入 Lakebase Postgres,使应用可以将其与自己的表连接。 Lakebase 变更数据流 则反向而行,将 Postgres 中发生的变更流式传回 Delta 以供分析。而且,由于 Databricks 在线特征存储运行在 Lakebase 上,在湖仓中定义的特征可以实时提供给模型。
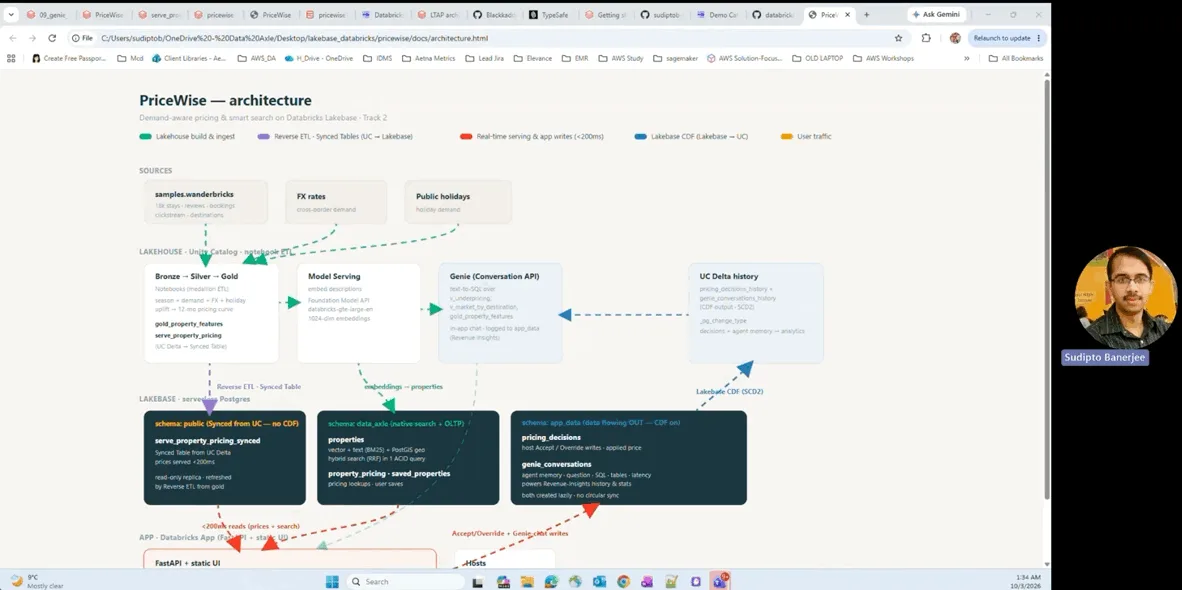
Data Axle 为度假租赁房东构建了 PriceWise,这些房东设定一个固定的每晚价格,而需求在一年中变化剧烈。在超过 18,000 个房源中,团队估计房东们放弃了约 64% 的潜在每晚收入。PriceWise 结合了混合搜索(pgvector 嵌入加 BM25,通过倒数排名融合合并)、分解为四个需求驱动因素的定价建议(包括对 20 英里内房源进行 PostGIS 比较),以及一个嵌入式 Genie 智能体,可回答诸如顶级竞争对手拥有哪些设施之类的问题。每次 Genie 对话都作为智能体记忆保存在 Lakebase 中,因此房东可以从中断处继续。搜索、定价、智能体记忆和特征服务全部运行在一个通过同步表保持最新的 Lakebase 数据库中,定价响应最快只需 4 毫秒,房东的决策也会写回 Lakebase。
一家运输公司的一个团队构建了一个实时航班风险应用,将流式数据转化为实时运营视图。他们将航班、机场和天气警报表从 Unity Catalog 同步到 Lakebase,为 Databricks App 中的实时地图提供支持,展示了同步表如何让为分析提供数据的同一批管道也为运营应用提供数据。
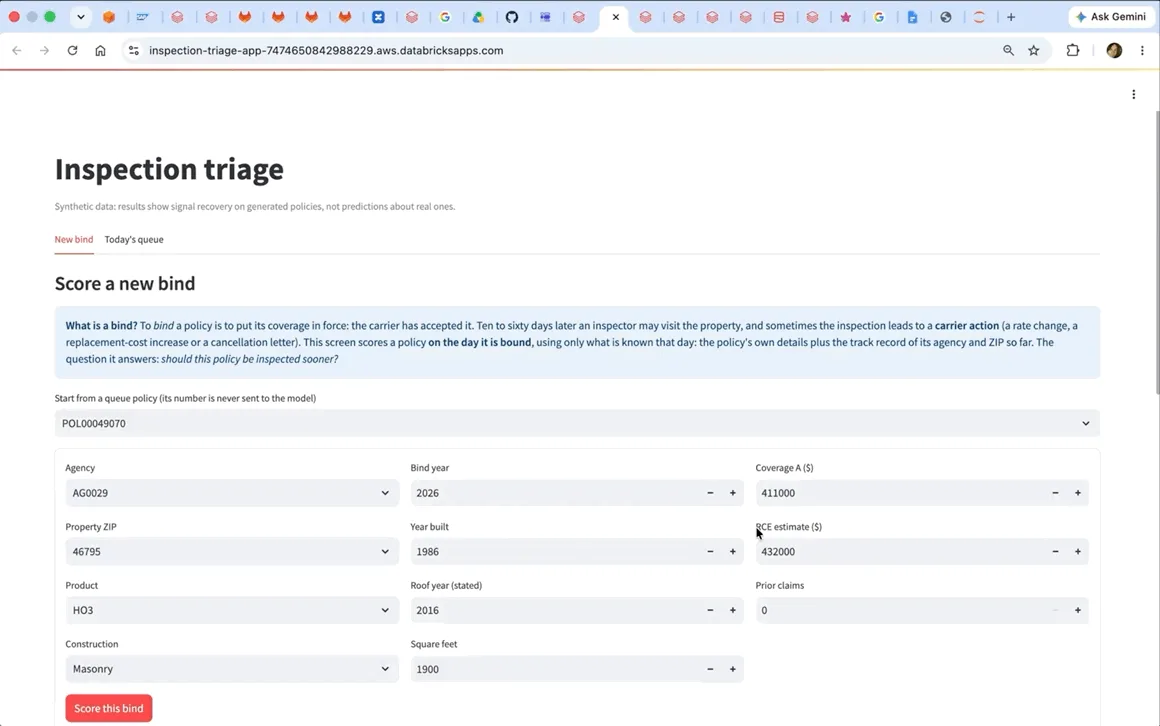
另一家保险公司的一个团队关注保单签发之后出现的一个缺口。风险评分通常发生在保单绑定之前,但没有人预测检查员之后会发现什么。他们的应用对每次绑定后检查导致承保人采取行动的可能性进行评分,并对检查队列进行排序,使风险最高的保单优先被看到,并附有通俗易懂的原因说明。特征被一次性定义为 Databricks 特征视图,并从 Lakebase 在线存储提供,因此相同的定义同时驱动训练和实时评分。
Sobeys 构建了一个包含三个智能体的对话式购物助手。食谱智能体通过向量搜索查找食谱,产品智能体使用模糊 Postgres 三元组搜索将食材匹配到商店产品,健康智能体则根据家庭的过敏档案检查每个食谱。要求提供对花生过敏安全的泰国食谱,应用就能在一次对话中从食谱到食材再到购物车。
更大的图景
将两条赛道连起来读,你就得到了一次 Lakebase 的实用之旅。开发者给 AI 智能体一个分支而不是生产环境。平台团队在几秒内为每个拉取请求提供自己的数据库。数据工程师将整理好的表同步到 Postgres 以支持实时应用。ML 工程师一次性定义特征并实时提供它们。
将这一切联系在一起的是,Lakebase 并不游离于数据平台之外。同样的 Unity Catalog 治理适用于湖仓表和为其提供服务的 Postgres 表,为仪表板提供数据的同一份数据也可以为应用、智能体或模型提供数据。多个团队用 Lakebase 直接处理的东西替换了单独的系统,例如搜索索引、暂存数据库或手工构建的同步作业。
向所有十一个团队致敬,他们构建了真实的东西。以下是开始使用 Lakebase 的一些资源:
常见问题
什么是 Databricks Lakebase?
Lakebase 是为湖仓构建的全托管 Postgres。存储与计算分离,数据库与你的湖仓数据相邻,处于同一 Unity Catalog 治理之下,因此任何写过 SQL 查询或使用过 ORM 的开发者都可以立即开始构建。
Lakebase 中的数据库分支如何工作?
Lakebase 分支就像数据库的 Git 分支。每个项目都从生产分支开始,新的子分支通过写时复制存储即时创建,因此你只需为发生变化的数据付费,创建分支对生产环境没有性能影响。
什么是 Lakebase 同步表?
同步表会持续将 Unity Catalog 表复制到 Postgres 中作为只读表,因此应用程序可以以低延迟查询湖仓数据。这通常被称为反向 ETL。在相反方向上,Lakehouse Sync 使用变更数据捕获将 Postgres 表复制回 Unity Catalog Delta 表。
Lakebase 能支持搜索和实时机器学习吗?
可以。Lakebase 支持 pgvector、PostGIS 和 pg_trgm 等 Postgres 扩展用于搜索,并且它充当 Databricks 在线特征存储背后的在线存储,因此在湖仓中定义的特征可以实时提供给模型。
Databricks 客户黑客松是如何运作的?
每场黑客松都以一场关于产品及其路线图的赋能会议开始。随后各团队共同构建约一周并提交项目,最优秀的解决方案将获得奖品。本次 Lakebase 黑客松设有两条赛道和十一个客户项目。
- 刚接触 Lakebase?请从 Lakebase 产品页面 和以下文档开始: 分支.
- 想把湖仓数据引入你的应用?了解同步表和 Lakehouse Sync.
- 正在构建搜索或实时机器学习?查看支持的 Postgres 扩展 以及 由 Lakebase 驱动的在线特征存储.
- 准备好试用了吗? 开始免费试用 并创建你的第一个 Lakebase 项目。
- 订阅我们的博客,最新文章将直接发送到你的收件箱。
获取最新文章,直达您的收件箱
订阅我们的博客,最新文章将直接发送到您的收件箱。