 AI 热点
人工智能
Amazon SageMaker HyperPod Slurm 推出用于可观测性和用户管理的托管集群扩展要让用于基础模型开发的共享 Slurm 集群保持同步,需要确保多个独立维护的配置项与节点上的实际运行状态相匹配。集群的形态分散在多个配置文件中,软件由自定义脚本管理,网络拓扑记录在必须随节点变化而编辑的文件中,用户则列在一份需要管理员维护并重新运行的名册中。随着时间推移,这些配置会逐渐偏离实际运行状态,而出现偏差时不会有任何提示。
我们认为,集群配置应当像其他 AWS 基础设施一样进行管理。您通过 API 或控制台声明所需状态,AWS 在应用前进行验证,集群持续保持该状态,而您可以查看它是否正常运行。2026 年,Amazon SageMaker HyperPod 将这种方式引入 Slurm 集群,提供由 API 驱动的 Slurm 配置、基于 AMI 的配置、持续预置、自动拓扑管理和深度运行状况检查。今天,我们推出了集群扩展,将同样的方式应用于运行中节点上的软件和设置,并提供用于可观测性和用户管理的托管扩展。与此同时,您仍然拥有对集群中每个节点的完整访问权限,包括控制器节点。您可以通过 SSH 登录、直接配置节点并运行自己的生命周期脚本。API 可以减少您的维护工作,直接访问则提供更多控制权,二者如何平衡由您决定。
本文将介绍我们在 2026 年推出的功能,并解释为什么运行中节点上的软件需要一种不同的机制。随后,我们将通过 API 和控制台展示集群扩展的工作方式,并跟踪一个平台团队在一个季度内使用这些扩展管理集群的过程。
Slurm 集群运维的声明式基础
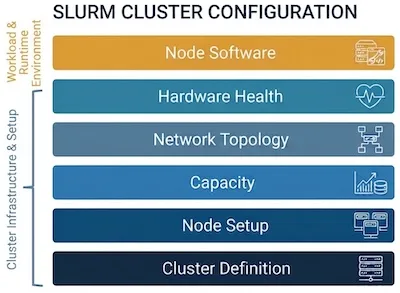
我们可以将 Slurm 集群的配置分为六层。其中五层描述集群本身:集群定义、节点设置、容量、网络拓扑和硬件运行状况。第六层涵盖节点上运行的软件,我们将在下一节讨论。下图展示了这六层。
2026 年早些时候,我们将声明式管理引入了前五层。借助 由 API 驱动的 Slurm 配置,管理员可以在 CreateCluster 和 UpdateCluster 请求中定义节点角色、分区,以及 Amazon FSx for Lustre 和 Amazon FSx for OpenZFS 挂载,并连接 外部记账数据库。HyperPod 会更新分区设置,同时保留控制器节点上的其他 Slurm 自定义配置。 基于 AMI 的配置 使用预配置了 Slurm、Docker、Enroot、Pyxis 和主目录的映像来取代常规设置脚本。 自定义 AMI 或 OnInitComplete 脚本可处理组织特有的软件。 Slurm 的持续预置 会在后台重试容量请求; 基于 AMI 的配置可与其配合使用, 最低容量要求 允许团队指定 MinInstanceCount,而 集群操作 则会跟踪扩缩容请求。
自动拓扑管理 会在节点扩缩容或被替换时维护网络布局。在 Slurm 25.11 或更高版本中, 分区级拓扑 支持为每个分区设置树形或块状拓扑。在硬件运行状况方面, 按需深度运行状况检查 会对 GPU 进行压力测试,并测试 NVIDIA Collective Communications Library(NCCL)连接,而 结合持续预置的深度运行状况检查 会在节点预置过程中运行。接受检查的节点会一直处于 Slurm 维护预留状态,直至检查完成,从而防止作业在这些节点上运行。
集群扩展简介
目前所述的五层配置都可以由 HyperPod 推导得出,或在预置节点时一次性应用。第六层,即节点上运行的软件,则有所不同,因为它会在集群的整个生命周期中持续变化。研究人员会加入或离开,团队可能会要求在一周内收集更深入的 GPU 指标,导出器也会发布修复版本。迄今为止,生命周期脚本一直是管理这一层的主要机制,但当软件不断变化时,这些脚本存在缺点。脚本只在节点预置时运行,因此每次更改都意味着需要编辑脚本,然后替换节点或在整个节点群中重新运行脚本。错误只有在脚本实际运行到某个节点时才会暴露,而且没有任何机制报告已安装的内容,因此各节点会随着时间推移逐渐出现差异。
我们希望软件能够在一个位置进行声明,在提交时接受检查,在各节点间保持一致,并可在之后查看其状态。2026 年 11 月,我们推出了集群扩展。这些扩展是由 AWS 管理的软件包,您可以通过 API 或 Amazon SageMaker AI 控制台安装、配置、更新和移除。首批软件扩展涵盖可观测性和用户管理,包括目录集成。与脚本相比,扩展具有以下优势:
- 预先验证: 当您通过 API 或控制台提交扩展设置时,HyperPod 会依据扩展的架构对其进行检查,因此拼写错误的设置会在到达任何节点之前被拒绝。
- 每个节点保持一致: HyperPod 会将扩展应用于每个节点,包括扩容或替换时添加的节点,并在集群扩缩容和自我修复过程中保持各节点一致。
- 通过 API 或控制台进行更改: 您可以通过 API 调用或 SageMaker AI 控制台更改设置或升级版本,无需编辑脚本和替换节点。两种方式使用相同的已验证配置,本文将把控制台截图与 API 示例一并展示。
- 可见: 每个扩展都会报告自身状态和各节点的运行状况。
当 HyperPod 提供相应的托管软件功能时,请使用集群扩展。对于现有扩展未涵盖的组织特有软件或初始化操作,请使用自定义 AMI 和生命周期脚本。HyperPod 目前支持两种集群托管扩展:
- 可观测性扩展(sagemaker-observability)收集节点、GPU、弹性结构适配器(EFA)、Slurm 作业和 Slurm 集群指标,并将其发送到 Amazon CloudWatch 或 Amazon Managed Service for Prometheus.
- 用户管理扩展(sagemaker-user-management)会在每个节点上创建 ID 相同的用户和组,控制哪些用户可以在各类节点上使用 SSH 和 sudo,并在 Slurm 计费系统中注册用户。它还可以将集群连接到 Active Directory,例如 AWS Directory Service for Microsoft Active Directory.
下图展示了扩展如何部署到您的节点。
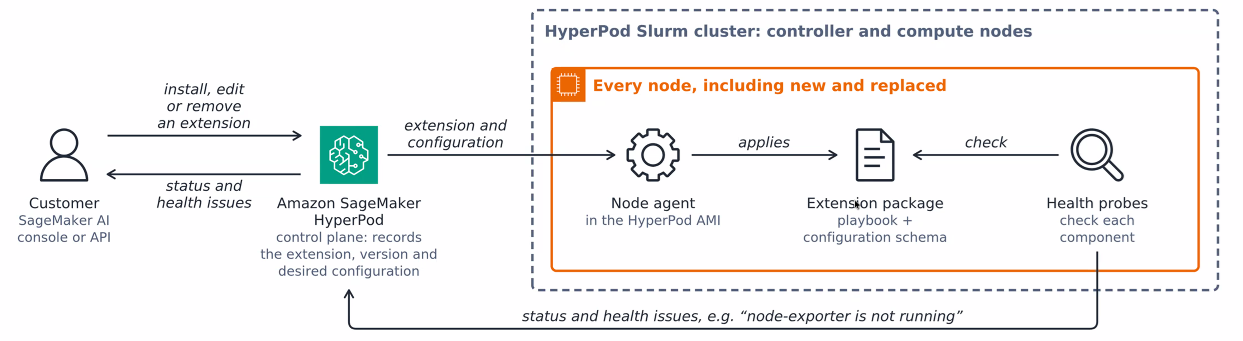
图 2:HyperPod 可以安装、编辑或移除扩展。HyperPod 会记录所需配置,由节点代理在每个节点(包括新增和替换的节点)上应用扩展软件包,并通过运行状况探针回报状态和健康问题
使用集群扩展
您可以通过 SageMaker AI 控制台或 API 使用集群扩展。在控制台中,集群详情页面的“扩展”选项卡会列出每个扩展及其状态、版本和 ARN,您也可以在此安装新扩展。每个扩展都会添加自己的控制项,例如,可观测性扩展提供指标存储设置和“在 Grafana 中打开仪表板”按钮,用户管理扩展则显示用户和组的数量并提供“管理用户”按钮。您还可以通过 AWS CLI 或 SDK 调用 API 来管理每个扩展,以便编写安装脚本、将设置保存在版本控制系统中、在多个集群中重复部署同一配置,或通过自己的工具检查状态和运行状况。下表列出了六个集群扩展 API,涵盖从安装扩展到列出可升级版本的各项操作,并展示了控制台中的扩展视图。

图 3:左侧为六个集群扩展 API 及各自的作用;右侧为用于添加和移除扩展的控制台视图
下图展示了调用其中一个 API 后会发生什么。
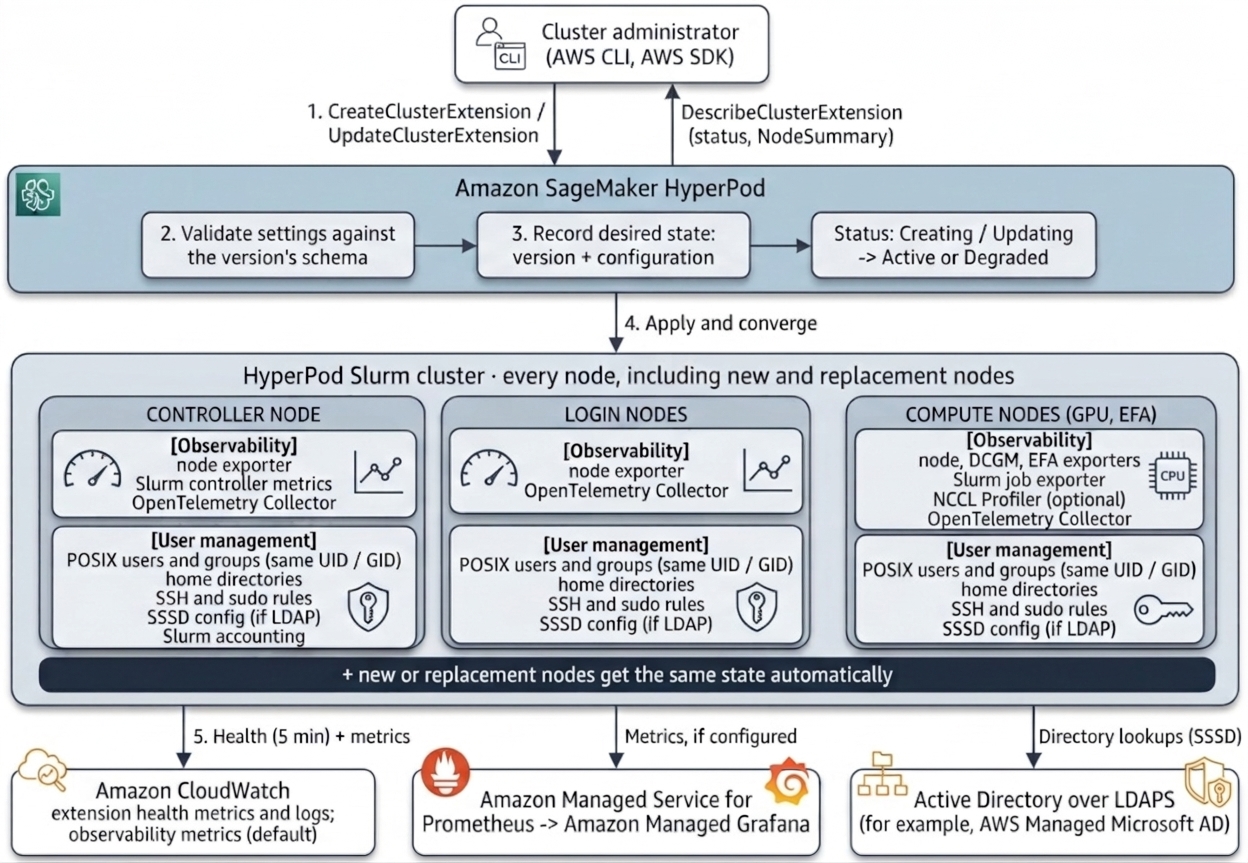
图 4:您通过 API 声明扩展的版本和设置。HyperPod 对其进行验证和记录,根据各节点的角色将其应用到每个节点,并报告状态和运行状况
创建或更新扩展时,HyperPod 会在 API 调用期间依据相应版本的架构验证您的设置,因此拼写错误的设置会立即被拒绝。随后,它会将版本和设置记录为所需状态并加以应用,每个节点只安装其角色所需的组件,例如仅在 GPU 节点上安装 GPU 导出器。新增和替换的节点会在启动几分钟后获得相同状态,而且每个节点都会报告扩展是否已成功应用以及运行状况是否正常。
更新时只需发送您想更改的设置,HyperPod 会将其合并到已存储的设置中。仅在节点上出现的问题,例如端口或用户 ID 已被其他程序占用,会显示在 DescribeClusterExtension 的 Health 字段中,并按原因分组,提供代码、消息和受影响节点数。HyperPod 会自行重试内部故障;对于其他问题,您可以修复原因,然后在不做任何更改的情况下调用 UpdateClusterExtension,以重试受影响的节点。
变更正在部署时,扩展的状态为 Creating 或 Updating;当每个节点都运行所请求的版本和设置且均未报告问题时,状态为 Active;当部分节点失败或报告问题时,状态为 Degraded。每个扩展都有自己的 ARN,因此平台团队可以负责 sagemaker-user-management,而监控团队可以负责 sagemaker-observability。每个健康问题都会指出相应组件、说明其对集群的影响、给出后续步骤并统计受影响的节点数,因此无需登录每个节点即可确定排查位置,如下图所示。
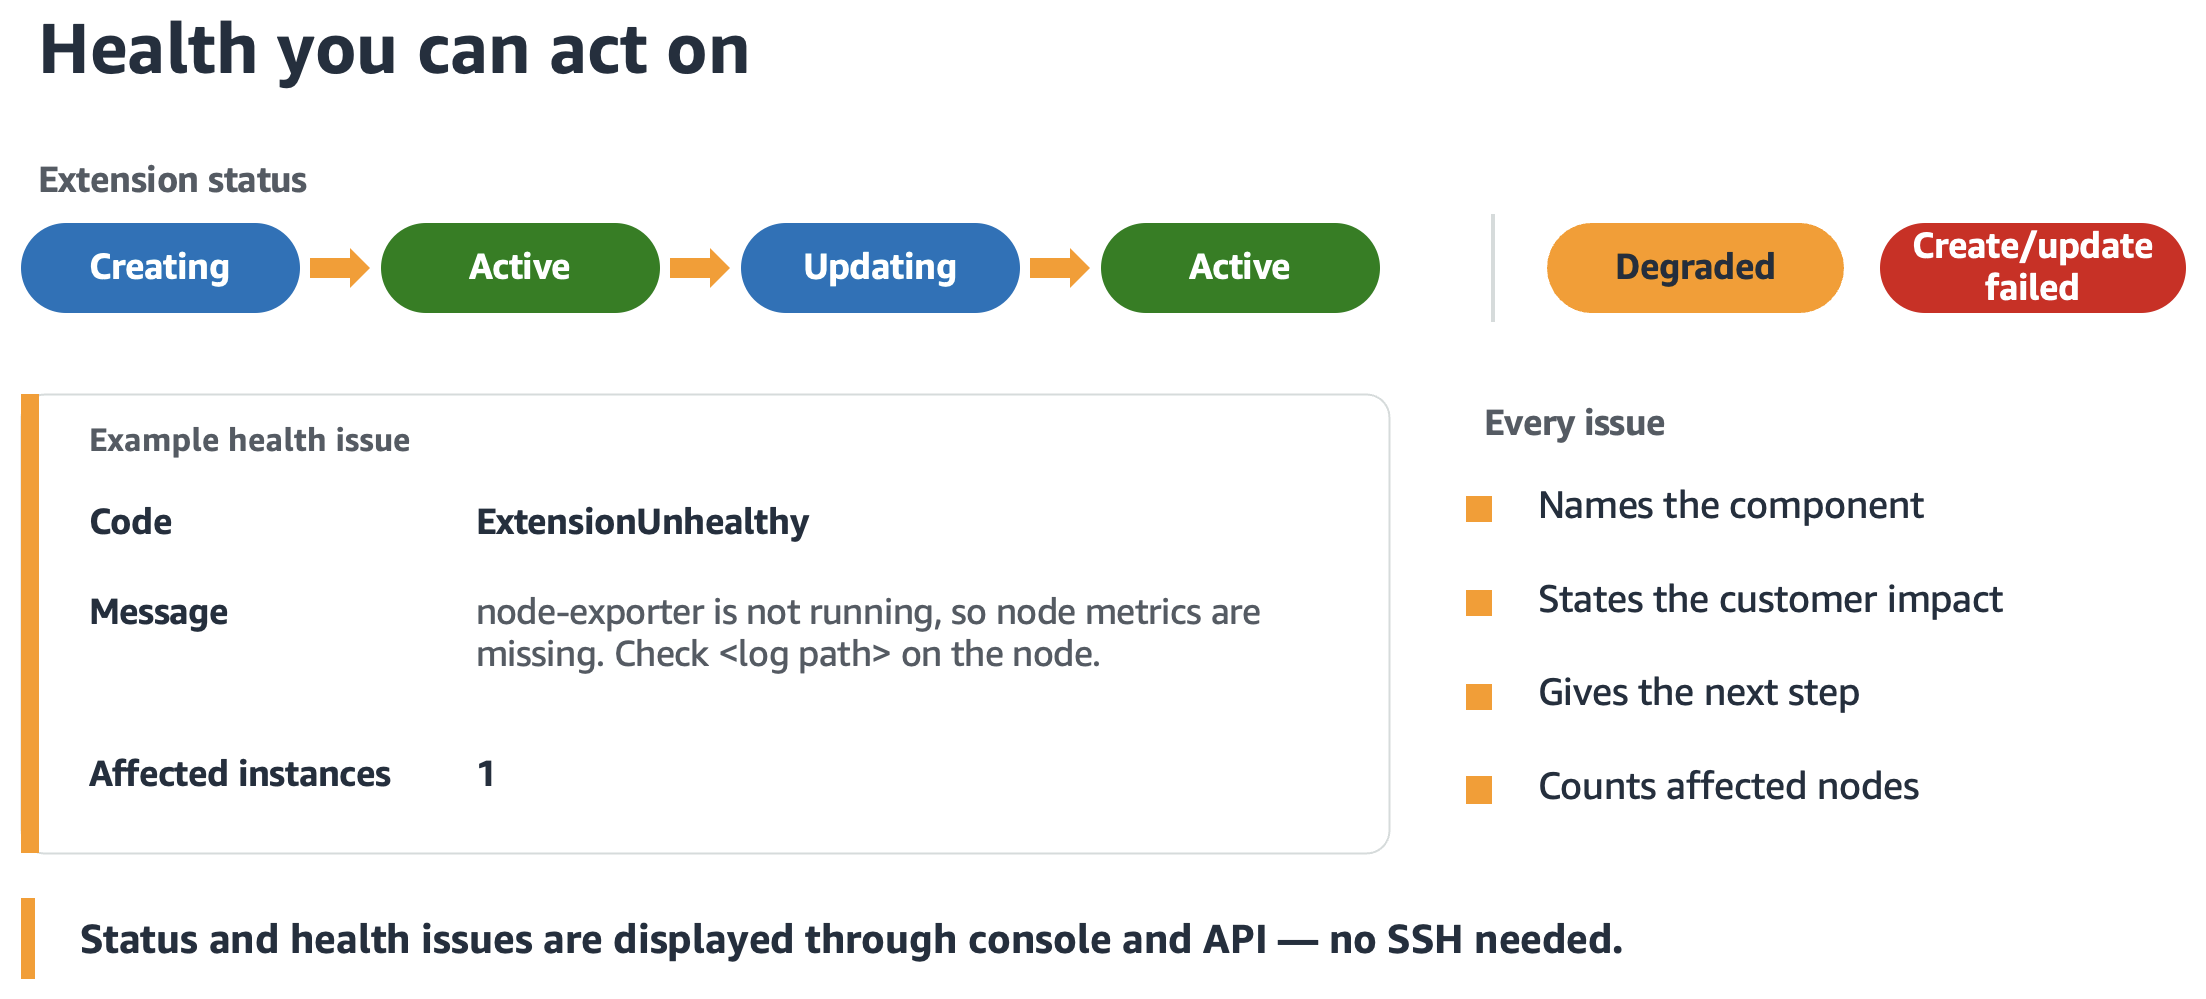
图 5:扩展的状态,以及节点导出器未运行时的健康问题示例
何时使用集群扩展,何时使用生命周期脚本
一种实用的判断方式是考虑软件由谁负责以及更改频率。集群上的部分软件是您的组织特有的,例如安全代理、许可证服务器,以及数据管道所需的存储布局。生命周期脚本和自定义 AMI 是管理这类软件的合适工具,因为只有您的团队了解其具体需求。其余软件则是几乎每个集群都需要的,例如 GPU 和作业指标,以及具有一致 ID 和访问规则的用户账户。这类软件必须在每个节点上保持一致且会持续变化,因此集群扩展更为适合:您只需声明一次,HyperPod 会进行验证,而每个扩展都会报告自身运行状况是否正常。
这两种方式可以共存,但每个组件都应只有一个负责人。请勿同时通过生命周期脚本和扩展管理同一个导出器、用户或服务,因为相互竞争的配置可能造成安装或运行时冲突。集群扩展可与所有生命周期配置选项配合使用。
如果您已经通过脚本运行这些功能,可以一次将一项功能迁移到扩展;迁移期间,脚本和扩展可以并行运行。每项功能的迁移分为四个步骤:
- 调用 UpdateClusterSoftware,将集群迁移到 2026 年 11 月版或更高版本的 HyperPod AMI。
- 在生命周期脚本中关闭该功能,并将脚本上传到您的 S3 存储桶,使新节点跳过该功能。
- 在计划维护时段内,停止并移除每个节点上由脚本安装的代理。这是唯一需要在整个节点群中手动执行的步骤。
- 调用 CreateClusterExtension,在已清理的集群上安装扩展。
如果仍有任何残留项,安装过程会指出具体冲突,例如端口已被占用;DescribeClusterExtension 会在 Health 下显示该冲突。对于用户管理,您可以保留相同的用户名和用户 ID。下图展示了这四个步骤。
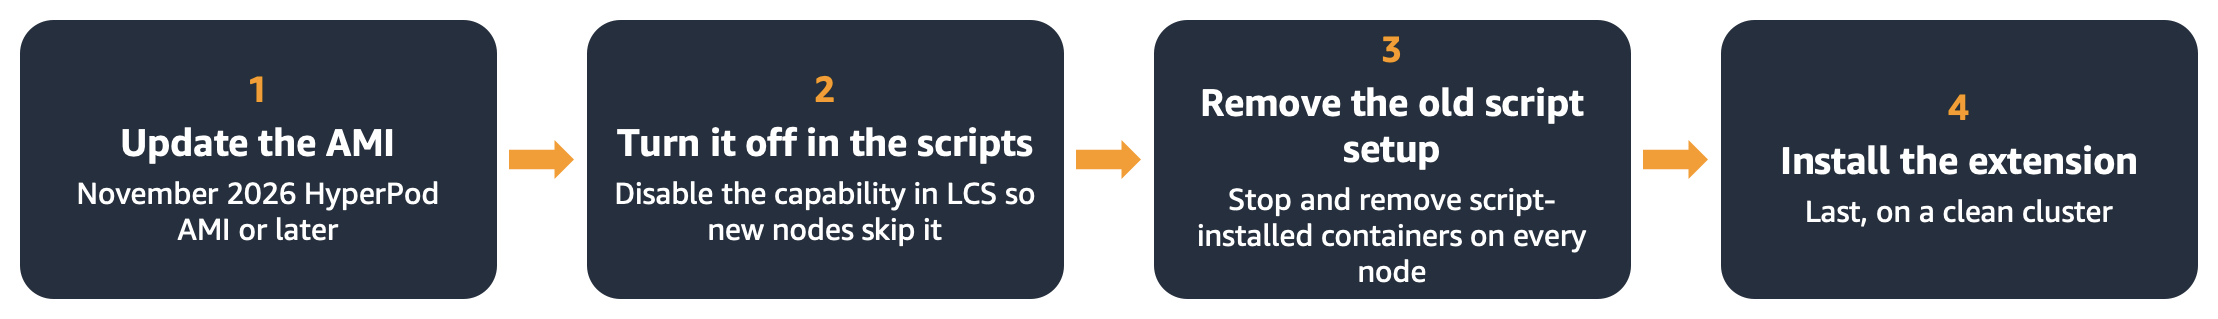
图 6:将现有集群从生命周期脚本逐项迁移到扩展
开始使用集群扩展所需的条件
您需要一个使用 2026 年 11 月 2 日版或更高版本 HyperPod AMI 的 HyperPod Slurm 集群,并且 已启用持续预置。扩展会以 root 身份在每个节点上运行软件,因此应将 CreateClusterExtension、UpdateClusterExtension 和 DeleteClusterExtension 视为管理员权限。建议不要将这些权限授予集群的执行角色,因为任何能够登录节点的用户都可以使用该角色的凭证。该角色确实需要访问扩展所使用的目标位置,即用于可观测性的 Amazon CloudWatch 或 aps:RemoteWrite,以及用于读取用户管理所需 Active Directory 密钥的 secretsmanager:GetSecretValue。如果这些密钥使用客户自主管理的 AWS Key Management Service (AWS KMS) 密钥加密,该角色还需要对该密钥拥有 kms:Decrypt 权限。用户管理还需要使用共享文件系统(例如 Amazon FSx for Lustre)来存放主目录。
有关操作步骤、IAM 策略和配置参考,请参阅 Amazon SageMaker HyperPod Slurm 集群的集群扩展 ,该内容位于《Amazon SageMaker AI 开发人员指南》中。
平台团队使用集群扩展管理共享 Slurm 集群的历程
要了解集群扩展在实践中的使用方式,可以设想一个为多个研究团队管理共享 Slurm 集群的平台团队。该团队需要一份可供审查的集群定义、GPU 和作业指标、企业目录访问权限、合作实验室的本地账户,以及由不同负责人分别管理可观测性和用户管理。以下示例展示了该团队如何配置这些功能,以及如何应对日常变更和故障。
使用一份定义创建集群
管理员在单个 CreateCluster 请求中声明整个集群,包括节点角色、分区、FSx 挂载、最低容量、深度运行状况检查和外部记账数据库。有关完整的请求示例,请参阅 使用 AWS CLI 开始使用 SageMaker HyperPod.
该请求不包含生命周期配置、拓扑文件或 Slurm 配置文件。每个 SlurmConfig 都会为其对应的实例组指定一个角色,GPU 组则加入 train 分区。基于 AMI 的配置负责设置节点,安全团队的合规代理已包含在自定义 AMI 中。GPU 组请求 8 个节点且至少需要 6 个,因此只要有 6 个节点就绪,作业便可开始运行,同时 HyperPod 会继续预置其余节点,并在每个 GPU 节点加入时对其执行运行状况检查。HyperPod 会自行选择适用于 P5 节点的树状拓扑,而记账数据会写入团队自有的 Amazon Relational Database Service (Amazon RDS) 数据库。管理员仍可通过 SSH 登录控制器节点,直接检查或调整 Slurm。
安装可观测性功能
管理层希望获得 GPU 和作业指标,因此管理员安装了可观测性扩展。在 SageMaker AI 控制台的集群 Extensions 选项卡中,管理员选择可观测性扩展,选取指标类别、相应级别和采集间隔,然后从两种指标存储中选择一种:Amazon CloudWatch 或 Amazon Managed Service for Prometheus。以下屏幕截图显示了已选择一种存储的安装表单。另一个选项也可在同一字段中选择。
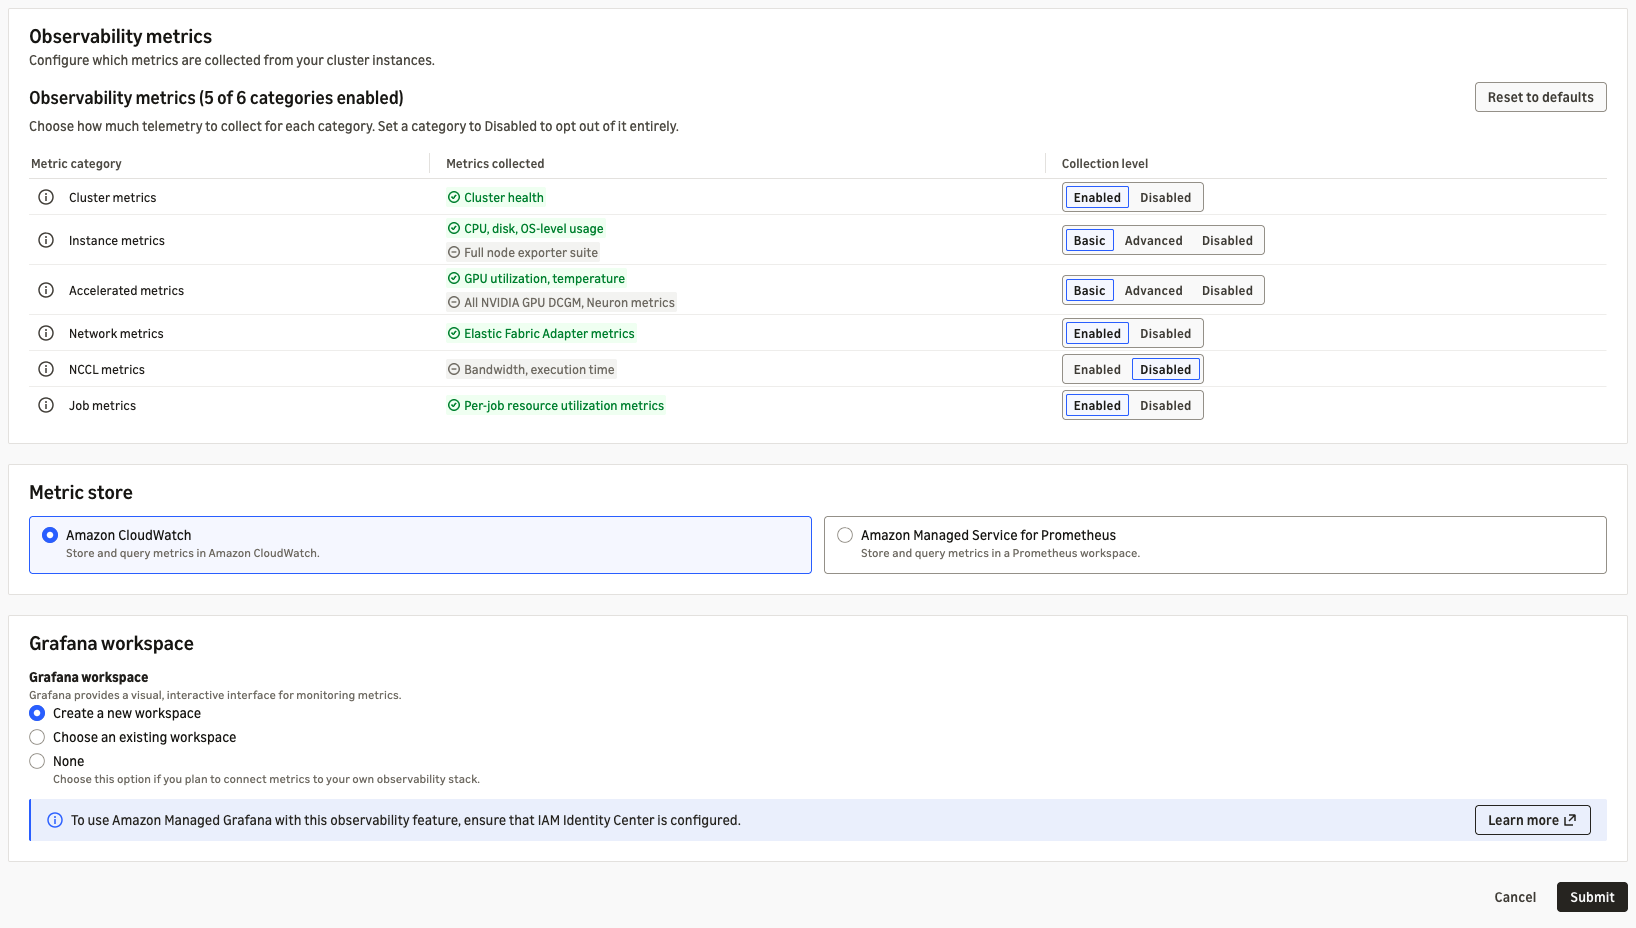
图 7:通过控制台安装可观测性扩展,可配置指标级别并选择指标存储
通过 API 完成相同安装只需调用一次 create-cluster-extension。以下示例使用 Amazon CloudWatch 作为指标存储。如果要改为将指标发送到 Amazon Managed Service for Prometheus,可在同一配置中设置 Prometheus 目标位置。
管理员调用一次 create-cluster-extension 来安装扩展:
aws sagemaker create-cluster-extension \
    --cluster-arn arn:aws:sagemaker:us-west-2:{{111122223333}}:cluster/{{abcd1234efgh}} \
    --extension-name sagemaker-observability \
    --configuration-values file://observability-config.json
该调用会返回扩展的 ARN,管理员将在后续调用中使用它:
{
    "ExtensionArn": "arn:aws:sagemaker:us-west-2:111122223333:extension/sagemaker-abcd1234efgh/sagemaker-observability/0a1b2c3d4e5f"
}
无论采用哪种安装方式,每个节点都只会运行与其角色相关的组件,例如 GPU 节点上的 DCGM 和 EFA 导出器,以及控制器上的 Slurm 集群指标组件。架构错误会在部署前被拒绝,而特定于节点的冲突则会显示在扩展运行状况中。
安装完成后,该扩展会显示在集群的 Extensions 选项卡中,并列出其版本、状态和 ARN。屏幕截图显示了同时安装可观测性扩展和用户管理扩展的集群选项卡,两者的状态均为 Active。
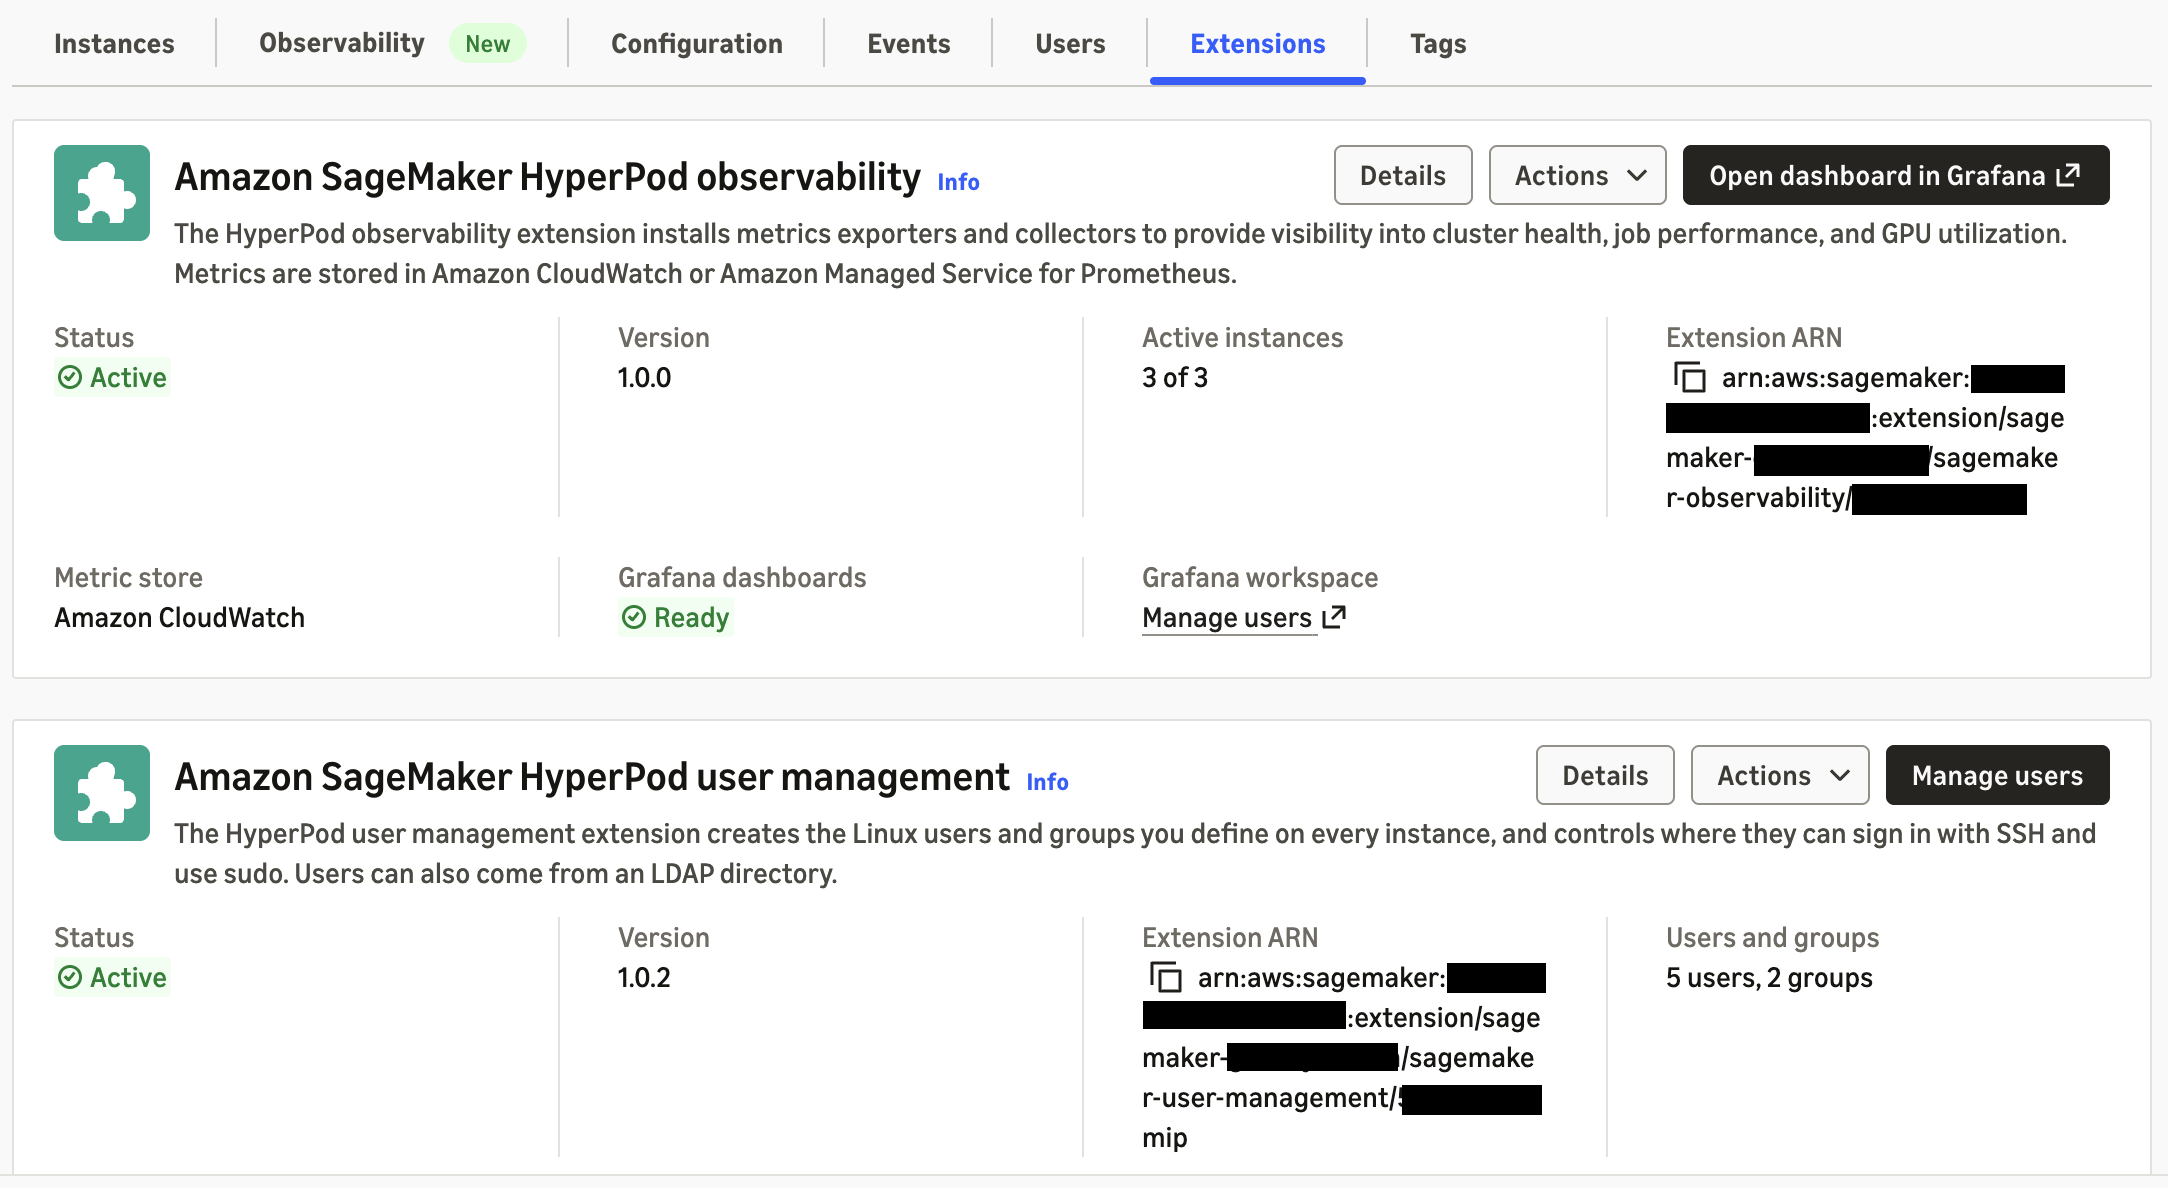
图 8:同时安装可观测性扩展和用户管理扩展的集群 Extensions 选项卡
无论选择哪种指标存储,都可以在安装中添加 Amazon Managed Grafana 工作区,这样团队便无需从头构建控制面板。登录 Grafana 后,他们会看到两个预先创建的控制面板:Clusters 和 Jobs,如以下屏幕截图所示。
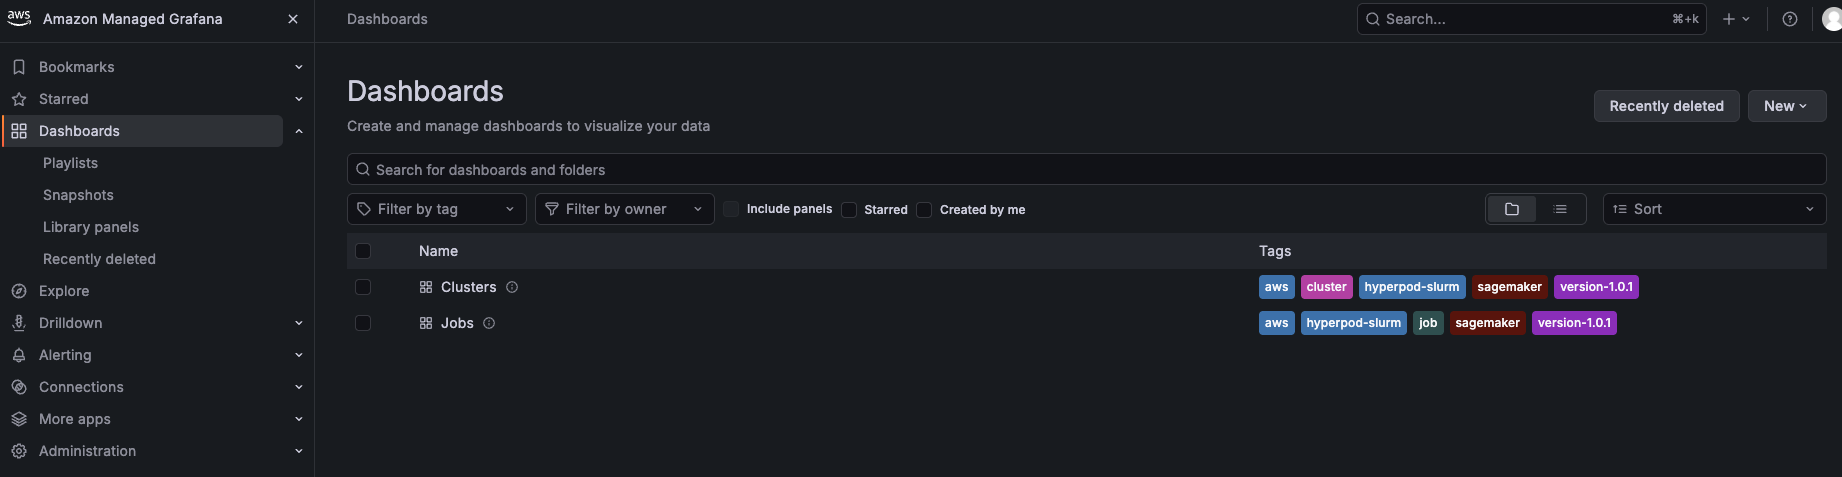
图 9:Amazon Managed Grafana 中随可观测性扩展提供的 Clusters 和 Jobs 控制面板
Clusters 控制面板基于扩展采集并发送到所选指标存储的指标,集中展示您的 HyperPod Slurm 集群。顶部汇总了集群运行状况,包括实例数量及其运行状况、GPU 和 GPU 内存总量、vCPU、内存以及 Amazon FSx for Lustre 容量。它还显示 Slurm 本身的状态,包括节点状态(空闲、已分配、混合、宕机和排空中)、作业队列、失败或被抢占的作业,以及调度程序活动。随后,您可以按集群、节点或 GPU 进行筛选,深入查看 EFA 网络、GPU 性能和错误,以及主机级 CPU、内存、磁盘和网络指标,如以下屏幕截图所示。这样,您无需离开控制面板,就能从“我的集群是否健康?”一路追查到问题的根本原因。
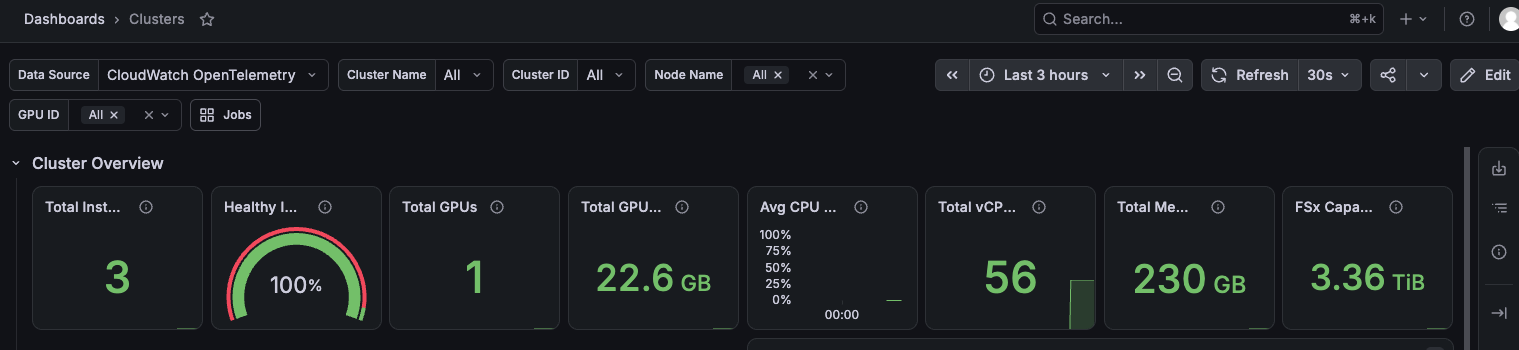
图 10:Clusters 控制面板,从集群整体运行状况和 Slurm 状态深入到各节点的 GPU、EFA 和主机指标
Jobs 控制面板可从集群级运行状况深入到单个 Slurm 作业。它使用任一指标存储中的 Slurm 作业导出器指标,将每个作业的资源使用情况与作业本身关联起来。您可以按集群、作业 ID、作业名称、分区、用户或账户进行筛选,并查看每个作业的 CPU、内存、GPU 利用率、GPU 内存和磁盘 I/O,以及加速器和 NCCL 指标。这样可以更轻松地发现未充分利用的 GPU、卡住的作业或分布式训练中的通信瓶颈,如以下屏幕截图所示。
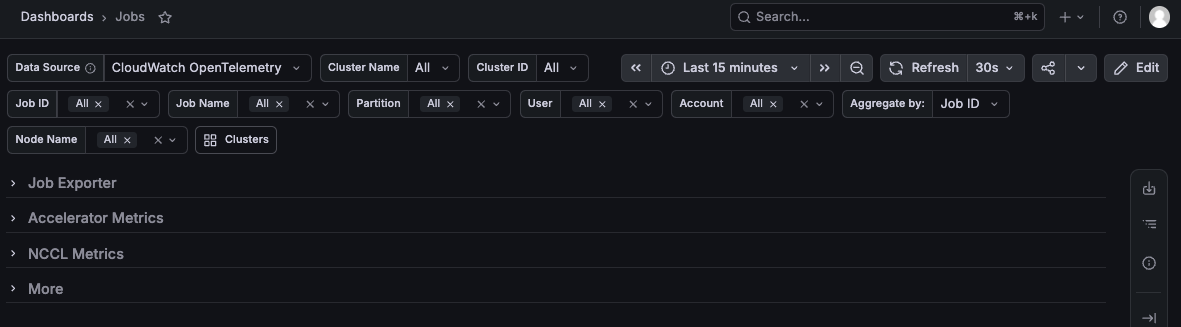
图 11:Jobs 控制面板,显示各个 Slurm 作业的资源使用情况
启用更深入的 GPU 和 NCCL 指标
之后,一个正在调优多节点训练的研究团队要求查看更详细的信息,因此管理员仅发送需要更改的设置:
aws sagemaker update-cluster-extension \
    --cluster-arn {{cluster-arn}} \
    --extension-arn {{observability-extension-arn}} \
    --configuration-values '{"metricsProvider":{"acceleratedComputeMetrics":{"level":"ADVANCED"},"ncclMetrics":{"level":"ENABLED"}}}'
HyperPod 会将这些设置合并到已存储的配置中,并将其应用于每个节点,仅重启设置发生变化的组件。调查结束后,将两项设置均设为 null 即可使其恢复默认值;整个过程中不会替换节点,也不会重新运行脚本。
修复指标传送问题
一天早上,该扩展显示为 Degraded。一个新的实例组所使用的执行角色缺少 aps:RemoteWrite 权限,而 describe-cluster-extension 显示了由此造成的影响:
{
    "NodeSummary": { "TotalCount": 19, "ActiveCount": 11 },
    "Health": {
        "Issues": [
            {
                "Code": "ExtensionUnhealthy",
                "Message": "otel-exporter-health: no successful exports in 5m6s",
                "NodeCount": 8
            }
        ]
    }
}
管理员添加该权限后,节点报告为健康状态,扩展也恢复为 Active,无需重新安装任何内容。
授予人员访问权限
用户管理扩展负责管理每个节点上的 Linux 用户和组,以及哪些人可以登录各类节点并在其上使用 sudo。您只需声明应存在哪些用户以及他们可以执行哪些操作,HyperPod 就会将其应用于每个节点,包括以后添加或替换的节点,因此无需任何人连接到节点或运行脚本来添加或移除用户。用户可以来自配置中列出的本地账户、通过 LDAPS 连接的 Active Directory,也可以同时来自这两种来源;每个组都会指定其成员可通过 SSH 登录以及可获得无密码 sudo 权限的节点类型(控制器、登录或计算节点)。
对于平台团队,安全团队要求使用企业身份,并仅为管理员保留 sudo 权限;与此同时,一个不在目录中的合作实验室需要自己的账户。管理员在一份配置中声明这两种来源,并通过组规则指定各组可登录哪些类型的节点,以及可在哪些类型的节点上使用 sudo:
{
    "sharedFilesystemMount": "/fsx",
    "userSources": {
        "localUsers": {
            "groups": [
                { "name": "cluster-admins", "gid": 3002,
                  "ssh": [ { "nodeTypes": ["controller", "login", "compute"] } ],
                  "sudo": [ { "nodeTypes": ["controller", "login", "compute"] } ] },
                { "name": "partner-lab", "gid": 3101,
                  "ssh": [ { "nodeTypes": ["login", "compute"] } ] }
            ],
            "users": [
                { "username": "admin-1", "uid": 2001, "groups": ["cluster-admins"] },
                { "username": "partner-1", "uid": 2101, "groups": ["partner-lab"] }
            ]
        },
        "ldap": {
            "ldapUri": ["ldaps://{{ad.example.com}}"],
            "ldapSearchBase": "{{dc=example,dc=com}}",
            "ldapDefaultBindDn": "{{CN=ReadOnly,OU=Users,DC=example,DC=com}}",
            "ldapDefaultAuthtokSecretArn": "arn:aws:secretsmanager:us-west-2:{{111122223333}}:secret:{{ad-readonly-AbCdEf}}",
            "ldapTlsCacertSecretArn": "arn:aws:secretsmanager:us-west-2:{{111122223333}}:secret:{{ldaps-ca-GhIjKl}}",
            "domain": "{{example.com}}",
            "useFullyQualifiedNames": "ENABLED",
            "ldapGroups": [
                { "name": "{{ClusterAdmin@example.com}}",
                  "ssh": [ { "nodeTypes": ["controller", "login", "compute"] } ],
                  "sudo": [ { "nodeTypes": ["controller", "login", "compute"] } ] },
                { "name": "{{ml-researchers@example.com}}",
                  "ssh": [ { "nodeTypes": ["login", "compute"] } ] }
            ]
        }
    }
}
访问权限是明确授予的,因此安装扩展后,只有获得 SSH 访问权限的组以及默认的 ubuntu 用户可以登录。目录用户的身份和组成员资格仍保留在 Active Directory 中,而合作实验室的用户则会获得一致的 ID、主目录和默认 Slurm 根账户。
也可以通过控制台管理同一配置。在用户管理扩展上选择 Manage users,会打开集群的 Users 选项卡;管理员可在其中添加、编辑和移除组与用户,并设置每个组可登录哪些类型的节点以及可在哪些类型的节点上使用 sudo,如以下屏幕截图所示。

图 12:在控制台上管理用户管理扩展的组和用户
升级扩展,无需更新 AMI 即可获得新功能
当 AWS 发布扩展的新版本时,管理员可列出能够安装的版本,并在无需更新 AMI 的情况下进行原位升级:
aws sagemaker list-cluster-extension-versions \
    --extension-name sagemaker-observability

aws sagemaker update-cluster-extension \
    --cluster-arn {{cluster-arn}} \
    --extension-arn {{observability-extension-arn}} \
    --extension-version {{new-version}}
HyperPod 会根据新版本的架构检查已存储的设置;如果设置对该版本无效,HyperPod 将拒绝请求且不做任何更改。否则,新版本会部署到每个节点,之后加入的节点也会获得该版本。升级只能向前进行,因此管理员会选择合适的维护时段。随后,可以通过与前文类似的更新来启用该版本带来的任何新设置或功能。
扩展集群并替换故障节点
在季度末运行任务之前,管理员先对 GPU 组启动按需深度运行状况检查,然后使用 batch-add-cluster-nodes 添加节点。HyperPod 接受请求后,该请求便会立即返回,因此管理员将其作为集群操作进行跟踪:
aws sagemaker list-cluster-operations \
    --cluster-name shared-gpu-cluster \
    --status InProgress
随着容量就绪,每个节点都会接受运行状况检查、加入 Slurm、在拓扑中就位,并获得与其他所有节点版本和设置均相同的两个扩展。如果某个 GPU 在任务运行期间发生故障,替代节点也会以同样的方式完成配置并获得这些扩展。
审查谁拥有访问权限
季度末,安全团队询问谁在控制器上拥有 sudo 权限,管理员无需登录节点即可通过 API 作答:
aws sagemaker describe-cluster-extension \
    --cluster-arn {{cluster-arn}} \
    --extension-arn {{user-management-extension-arn}} \
    --query ExtensionDetails.ConfigurationValues --output text |
jq '[.userSources.localUsers.groups[]?, .userSources.ldap.ldapGroups[]?]
    | map(select(any(.sudo[]?; .nodeTypes | index("controller")))) | map(.name)'
答案是 cluster-admins 和 ClusterAdmin@example.com,而该目录组的成员资格在目录中接受审计。由于每个扩展都有自己的 ARN,平台团队的角色只能更新 sagemaker-user-management,监控团队的角色只能更新 sagemaker-observability,而安全团队对两者都只有只读访问权限。这些权限均不应属于集群的执行角色。当扩展处于 Active 状态、ActiveCount 等于 TotalCount 且 Health 为空时,每个节点都在运行完全相同的配置。
可用性和定价
包括可观测性扩展和用户管理扩展在内的集群扩展,自 2026 年 11 月起已在 Amazon SageMaker HyperPod 支持的所有区域推出;本文介绍的其他改进则于 2026 年更早时候发布,每项公告均列出了其适用区域。集群扩展不收取额外费用。您只需为配合这些扩展使用的 AWS 资源付费,例如 Amazon CloudWatch、Amazon Managed Service for Prometheus 和 AWS Secrets Manager。
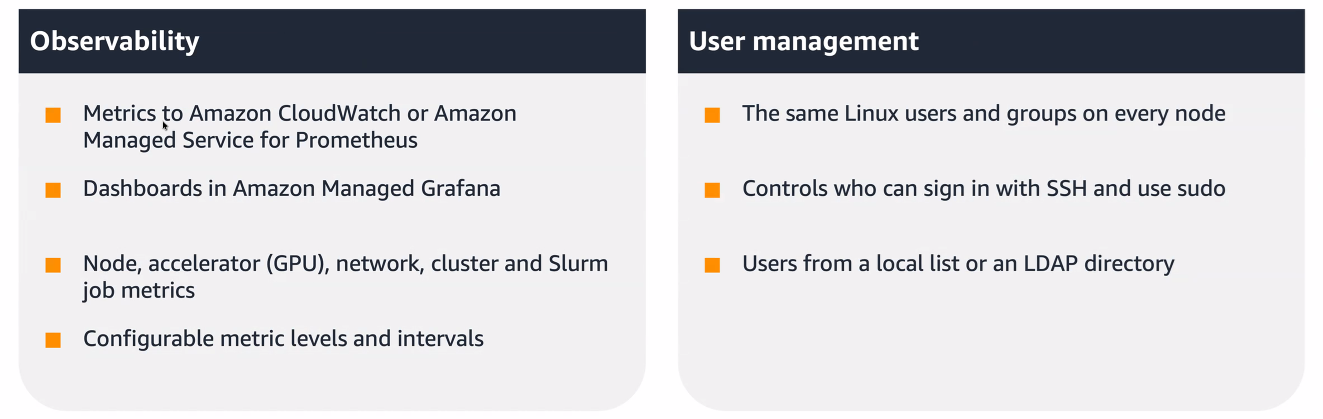
图 13:自 2026 年 11 月起推出的两个扩展
结论
当集群中有更多内容能够以声明方式定义、经过验证、实现收敛并具备可观测性时,集群会更易于运行。今年的改进将这些能力引入了 HyperPod Slurm 集群的定义、节点设置、容量、网络拓扑和硬件运行状况;自 2026 年 11 月起推出的集群扩展,则将这些能力带到了节点上的软件层——也就是变化最频繁的一层。这样,生命周期脚本和自定义 AMI 可以继续专注于贵组织特有的内容,而控制器节点仍由您掌控。
要创建本文所述的集群,请参阅 《使用 AWS CLI 开始使用 SageMaker HyperPod》。要开始使用集群扩展,请参阅 《Amazon SageMaker AI 开发人员指南》中的“集群扩展”。欢迎在评论区或通过您的 AWS 客户团队分享反馈。
致谢
此功能凝聚了多个团队的贡献。参与开发的部分人员包括 Hengyu Lou、Aman Pratap Singh、Karthick Ravi、Shubh Nisar、Nitish Sai Kommasai、Uday Singamala、Min Badar、Devanshi Desai、Yahya Hassan、Connie Chen、Kashish Tayal、Oleg Talalov、Takuma Yoshitami、Kiran Penta、Dhawal Parkar、Pradeep Cruz。