人工智能
使用 Amazon Bedrock 和 Spring AI 构建自主 AI 智能体Java 团队已经建立了 JVM 工具链、持续集成与持续交付(CI/CD)流水线以及运维模式,但将 AI 智能体从原型推向生产仍然困难:智能体框架默认并不解决可扩展性、治理、安全和运维方面的问题。Amazon Bedrock 和 Spring AI 填补了这些空白,使 Java 团队能够构建自主 AI 智能体,这些智能体可以规划、调用工具和 API,并在多轮对话中保持上下文。智能体式 AI 正从提示-响应交互转向执行复杂多步骤任务的自主系统。
Java 仍然是企业软件中广泛使用的编程语言之一。团队拥有现有的 CI/CD 流水线、运维专业知识和围绕 JVM 建立的成熟模式。 Spring AI 通过熟悉的 Spring 模式将 AI 能力引入 JVM:自动配置、依赖注入和可组合的 advisor。开发者可以使用与 REST API、安全和数据访问相同的惯用方式来构建 AI 智能体。
Amazon Bedrock AgentCore 是一个平台,可使用任意框架或模型大规模构建、连接和优化智能体。借助 AgentCore,您可以大规模构建、部署和运营 AI 智能体。它与框架无关、与模型无关:您可以自带首选的智能体框架和基础模型(FM)。借助 AgentCore,您可以访问所需的生产基础设施:托管运行时、记忆、浏览器自动化、代码执行和身份管理。
在本文中,我们将展示如何使用 Spring AI、Amazon Bedrock 和 spring-ai-agentcore在 Java 中构建自主 AI 智能体。我们探讨两个系统的关键实现模式。第一个是单智能体旅行助手,演示工具调用和记忆。第二个是多智能体智能文档处理(IDP)系统,展示专家智能体、规则引擎和告警如何协同工作。
先决条件
要跟随本演练操作,您需要以下内容:
- Java – JDK 21(必需)
- Spring Boot – 4.1(含 Spring AI 2.0 和 spring-ai-agentcore 2.0)
- Maven – 3.9+.
- Node.js – 18+(用于 React 前端)
- Terraform – 1.5+.
- Docker – 带 Buildx,用于多架构构建。
- AWS 命令行界面(AWS CLI) – v2,已配置凭证。
- 一个 AWS 账户.
什么使系统成为智能体
聊天补全调用可以生成文本,但它无法决定下一步做什么、访问外部系统或记住昨天发生了什么。智能体可以做到,因为它结合了三种能力:
- 规划 – 给定目标后,模型将其分解为步骤、确定优先级,并在新信息到来时修订计划。
- 工具使用 – 除了生成文本,模型还可以选择和调用外部函数,例如 API、数据库和代码解释器,以在现实世界中采取行动。
- 记忆 – 上下文跨轮次(短期)和跨会话(长期)传递,因此每个决策都建立在此前的基础上。
检索增强生成(RAG)应用具有有限的工具使用(检索),但没有规划循环。智能体具备全部三种能力,在目标导向的循环中运行,直到任务完成或确定无法继续。
下图展示了这些能力在端到端智能体流水线中的运作,从请求到有依据的答案。
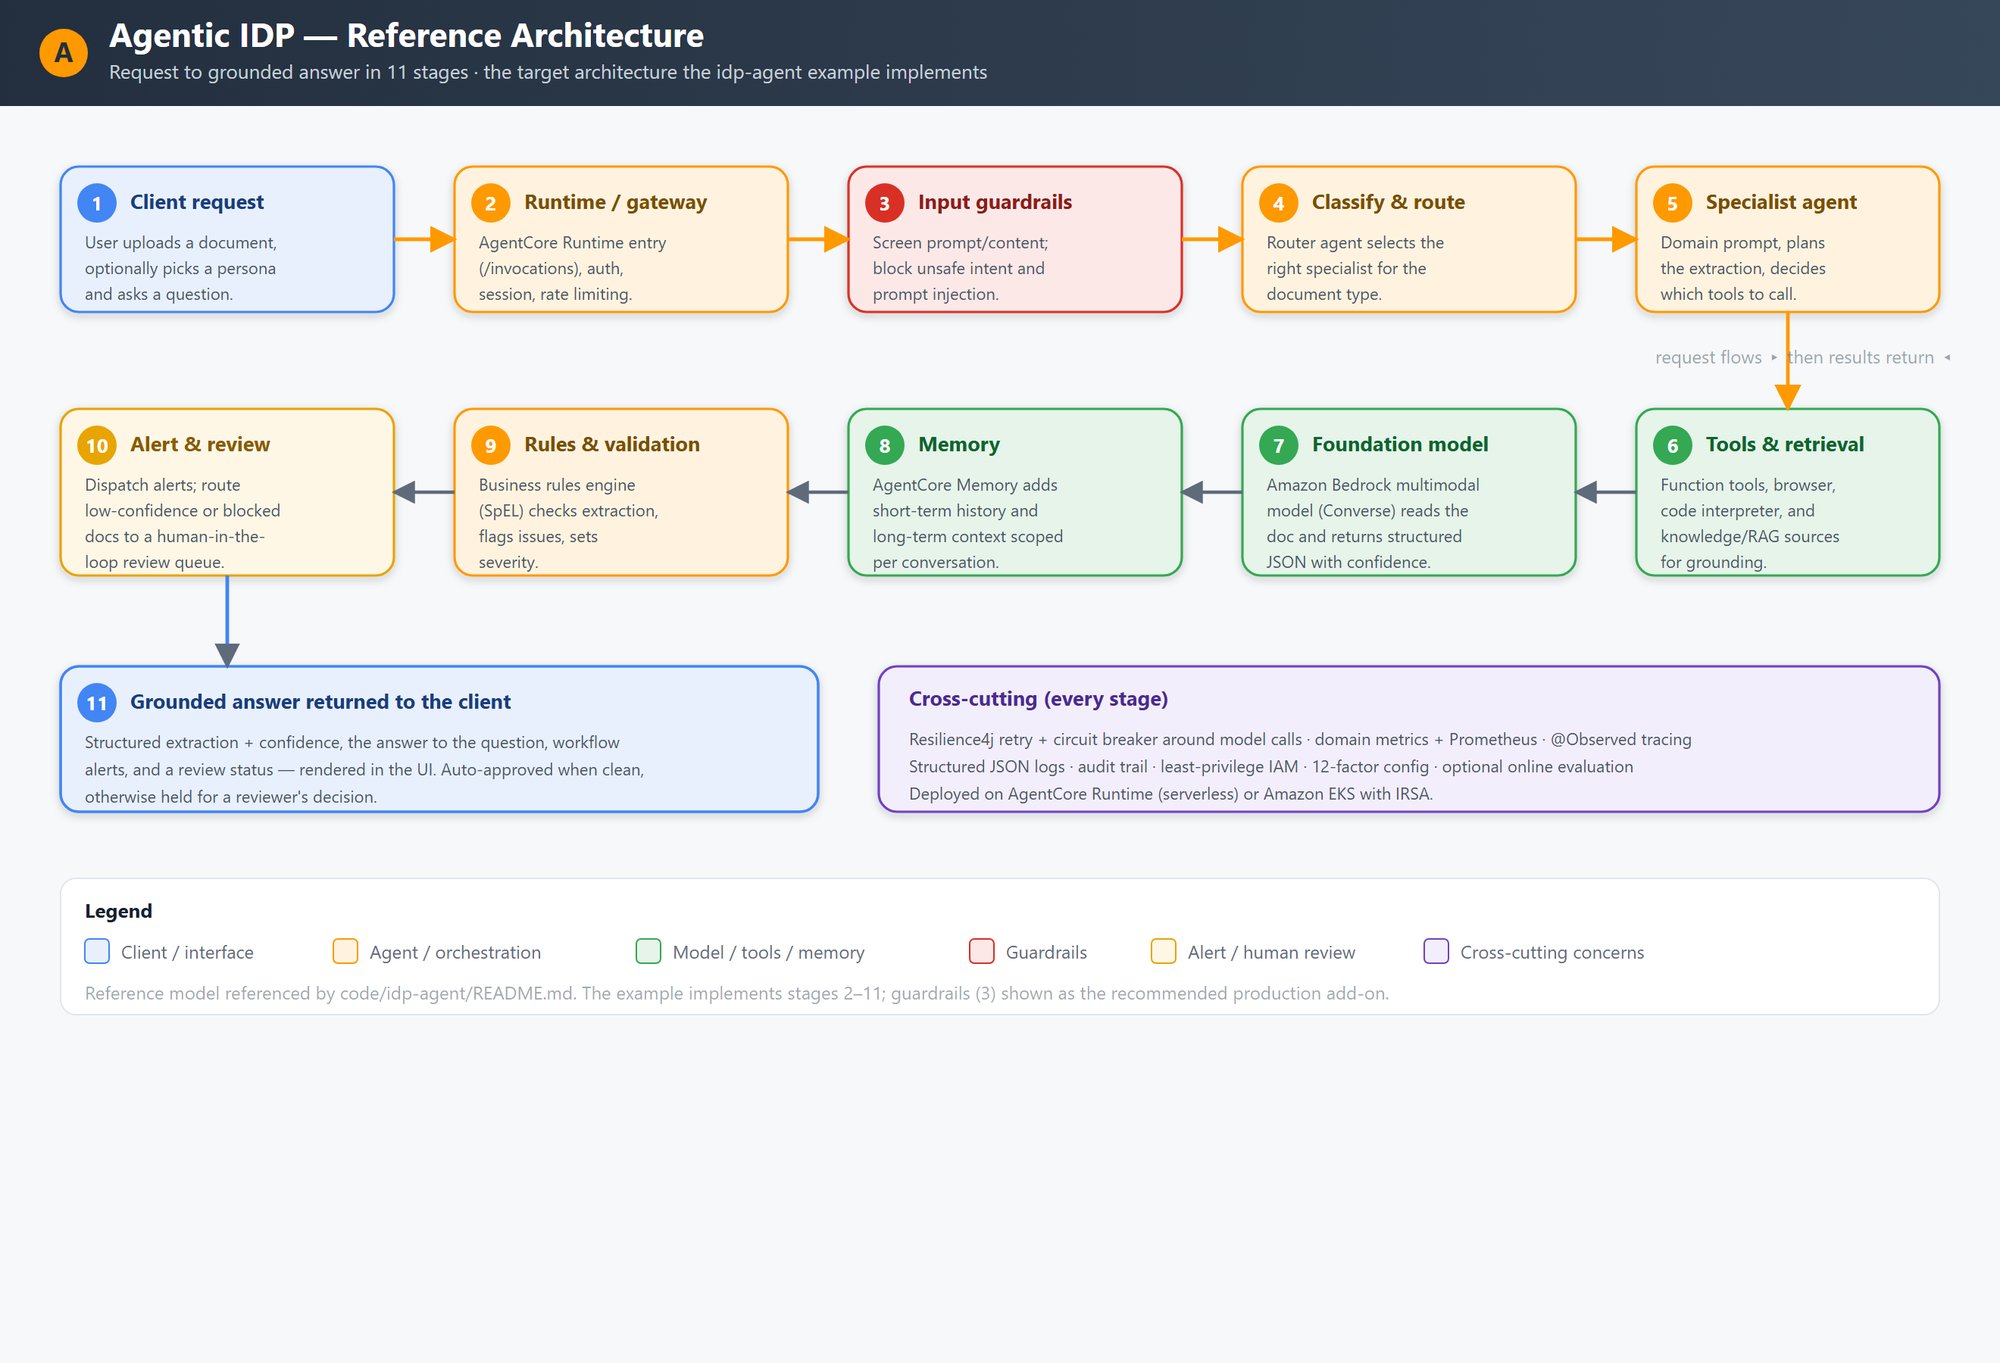
图 1:智能体参考架构。请求流经运行时、护栏、分类、专家智能体、工具、基础模型、记忆、规则和人工审核,最终得到有依据的答案,韧性和可观测性作为横切关注点
该流水线有 11 个阶段。客户端提交文档和问题。请求经过运行时网关进行身份验证和速率限制,然后输入护栏筛查有害内容。路由器对文档进行分类并将其路由到专家智能体,后者规划其工作流并按需调用工具、Amazon Bedrock 基础模型、记忆和规则引擎。低置信度或被标记的结果进入人工审核队列,之后有依据的答案返回给客户端。韧性、可观测性、日志记录和最小权限 AWS 身份与访问管理(IAM)适用于所有阶段。
解决方案概述
该解决方案由两个可部署系统组成,它们共享通用模式:
- 旅行助手 – 一个具有工具调用(天气查询、行程搜索)、流式响应、对话记忆和韧性模式的单一自主智能体。这是推荐的起点。
- IDP 多智能体系统 – 一个多智能体智能文档处理平台,包含五个专家智能体(Lawyer、Mortgage、Insurance、Tax、General)、规则和工作流引擎、告警和可观测性。这展示了规模化下的生产模式。
两个系统共享以下架构:
- 使用 Spring AI ChatClient、Spring AI agentcore 和 Amazon Bedrock Converse API 的 Spring Boot 应用。
- AgentCore runtime(Amazon Bedrock AgentCore 的一项能力)定义了托管部署的契约(POST
/invocations、GET/ping)。 - 通过 AgentCore memory(Amazon Bedrock AgentCore 的一项能力)实现对话记忆,用于短期和长期上下文。
- 使用
@Tool注解方法进行工具调用。 - 映射到 Java record 的结构化输出。
- 针对 AWS Graviton 优化的 ARM64 容器镜像。
- 用于基础设施供应的模块化 Terraform。
旅行助手是推荐的起点。下图展示了 Spring Boot 智能体如何与 AgentCore runtime、工具、记忆以及 Amazon Bedrock 上可用的模型交互。
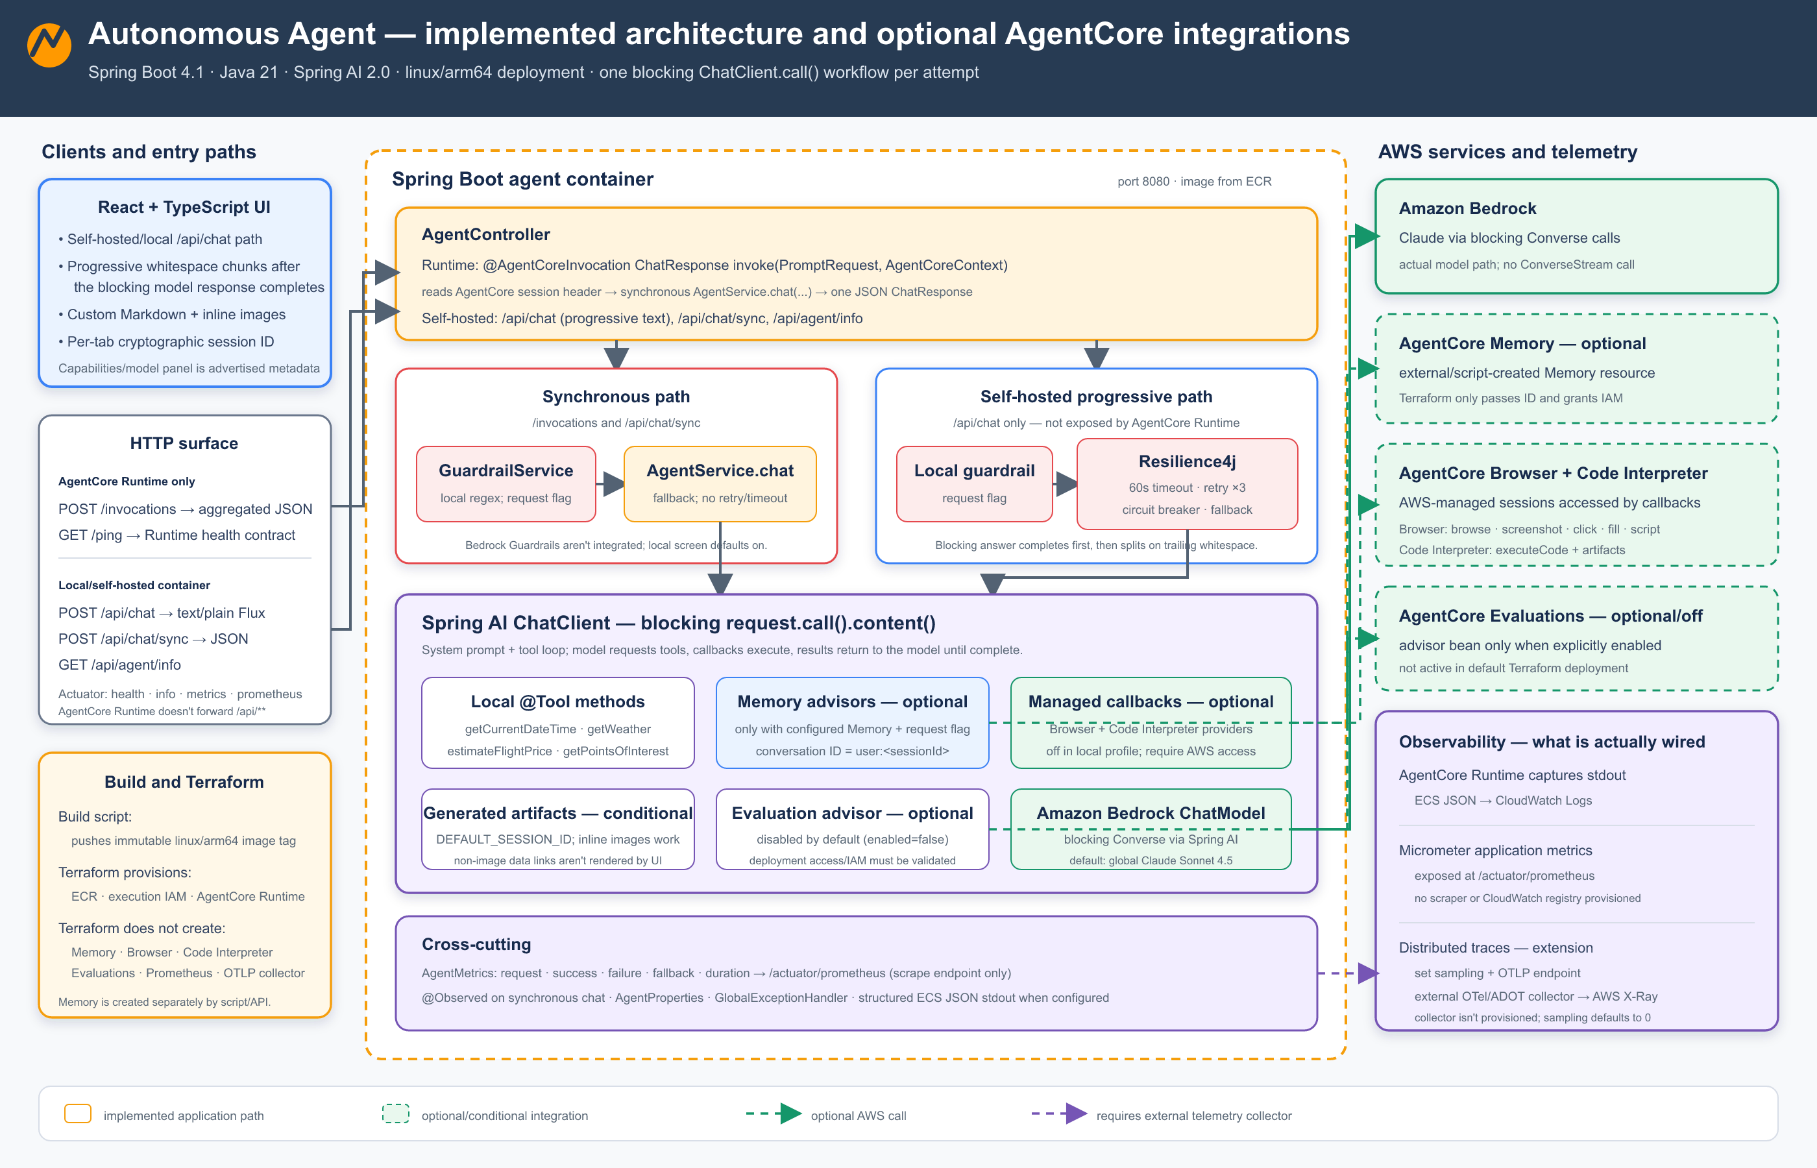
图 2:单智能体旅行助手。Spring Boot 应用同时暴露用于 React UI 的 REST 端点和 AgentCore runtime 契约,通过 Converse API 调用 Amazon Bedrock,而工具调用、流式传输和记忆在同一代码库中运行。
旅行助手运行一个具有两个入口点的 Spring Boot 应用,即 /invocations 和 /ping AgentCore runtime 所需的契约。Spring AI 通过 Converse API 编排对 Amazon Bedrock 的调用,并在同一进程内本地解析工具调用。Server-Sent Events 在令牌生成时将其流式传输到客户端。AgentCore memory 提供会话内的短期上下文和跨会话的长期上下文,因此智能体无需外部状态管理即可保留对话历史。
下图展示了 IDP 多智能体系统的架构。
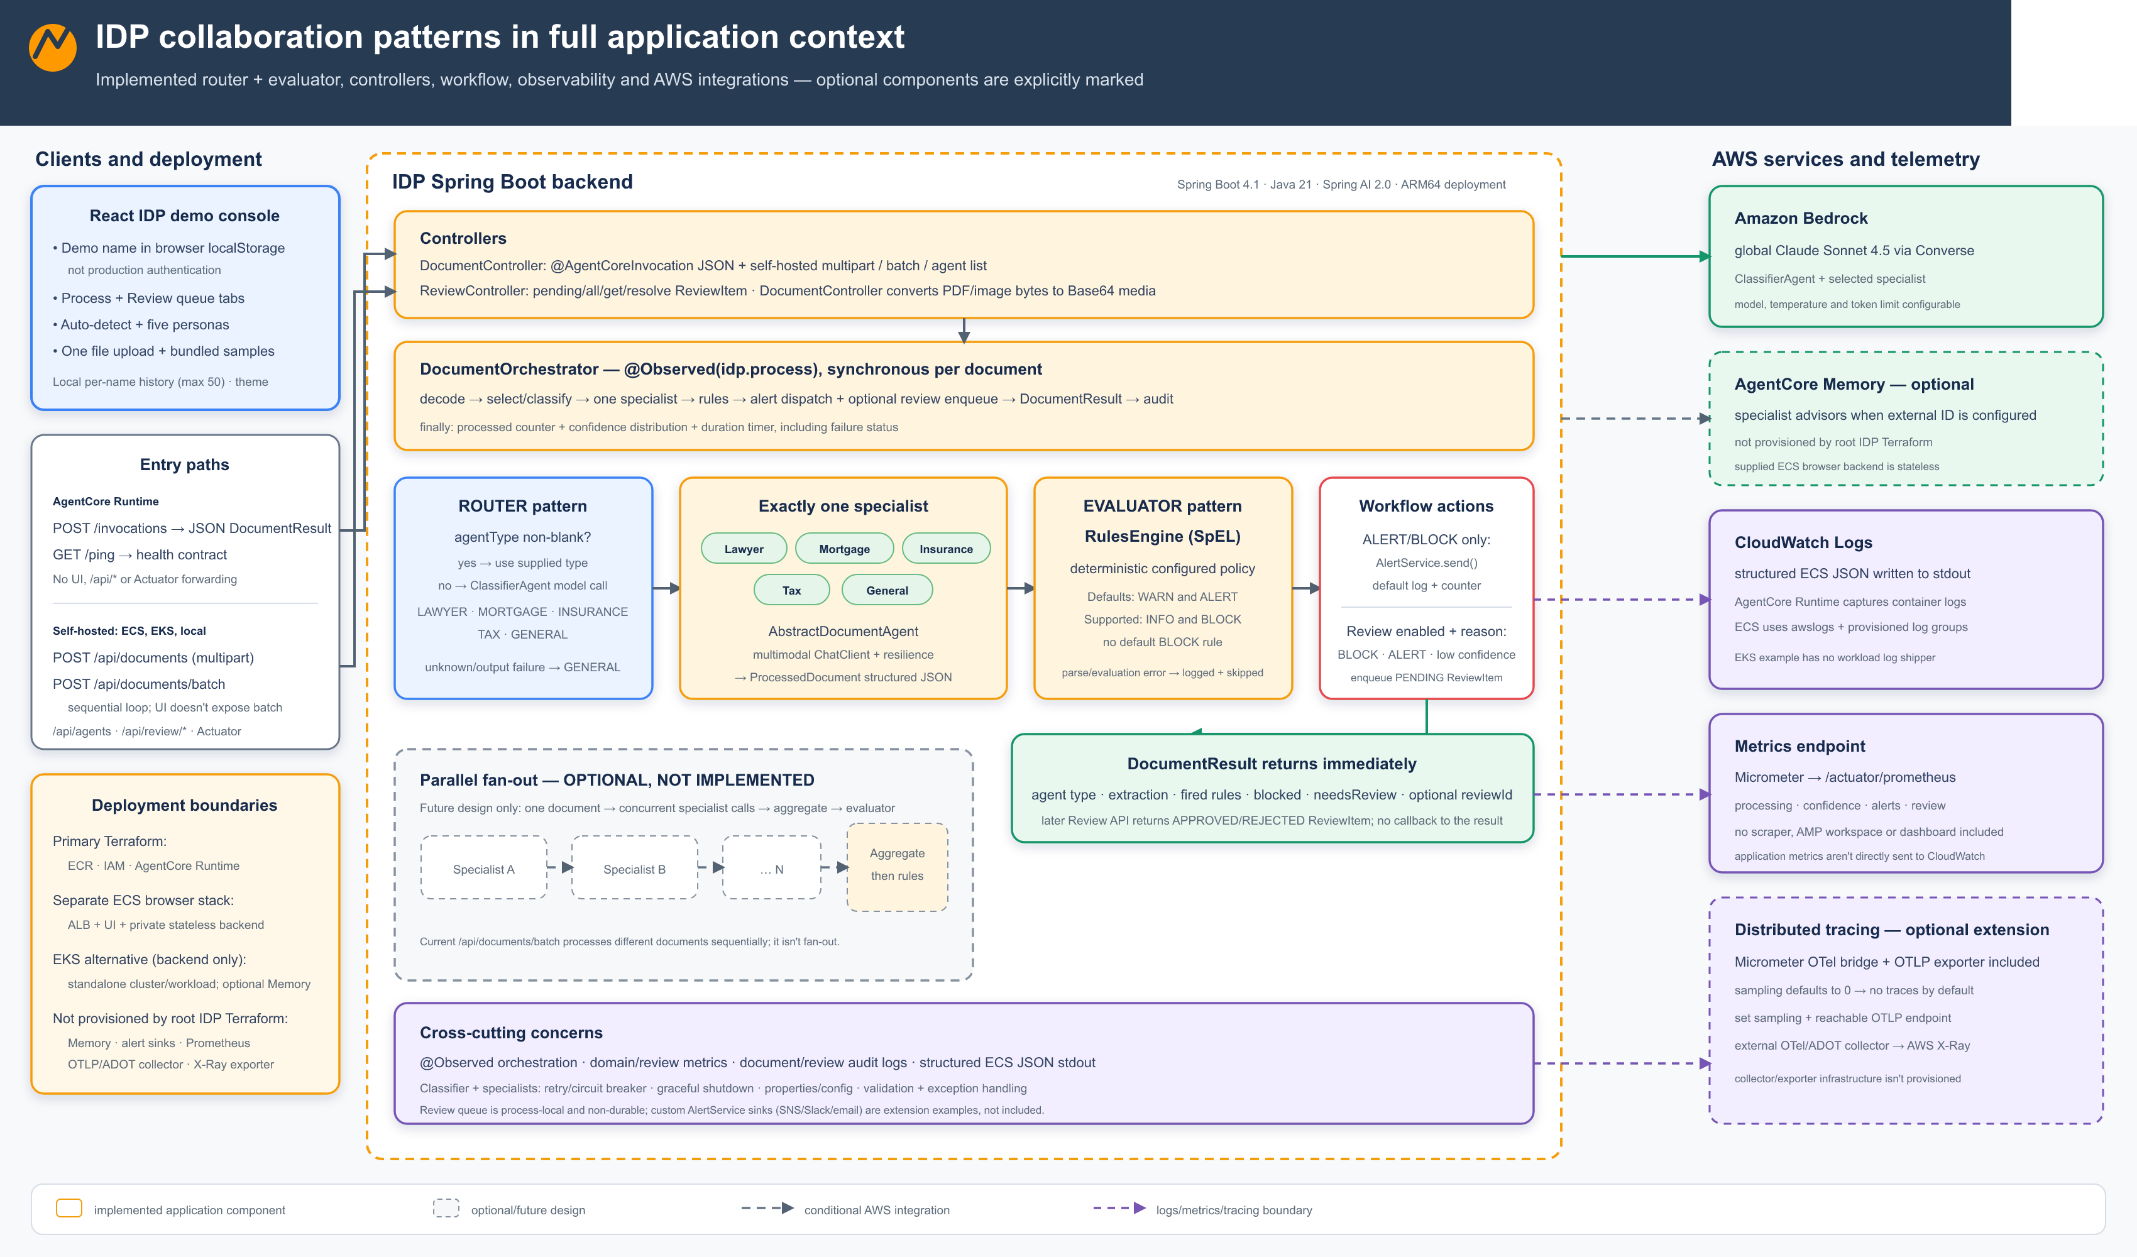
图 3:IDP 多智能体系统架构。专家智能体通过共享的 ChatClient 模式处理文档,结果流经规则引擎和告警服务。
IDP 多智能体系统通过五个专家智能体(Lawyer、Mortgage、Insurance、Tax 和 General)路由文档,每个专家智能体都构建在一个共享的 AbstractDocumentAgent 模板。一个 ClassifierAgent 读取每个文档并将其转发给相应的专家。专家使用 Amazon Bedrock 的多模态 Converse API 提取带有置信度分数的结构化 JSON。规则引擎评估来自 application.yml 的提取结果执行规则。 ALERT 或 BLOCK 严重性规则通过 AlertService低置信度文档转人工审核。指标、审计追踪、韧性和可观测性贯穿所有阶段。
智能体协作模式
当多个智能体协同工作时,它们的协调方式决定了系统行为。本解决方案采用三种模式:
下图比较了本解决方案中使用的三种协作模式。
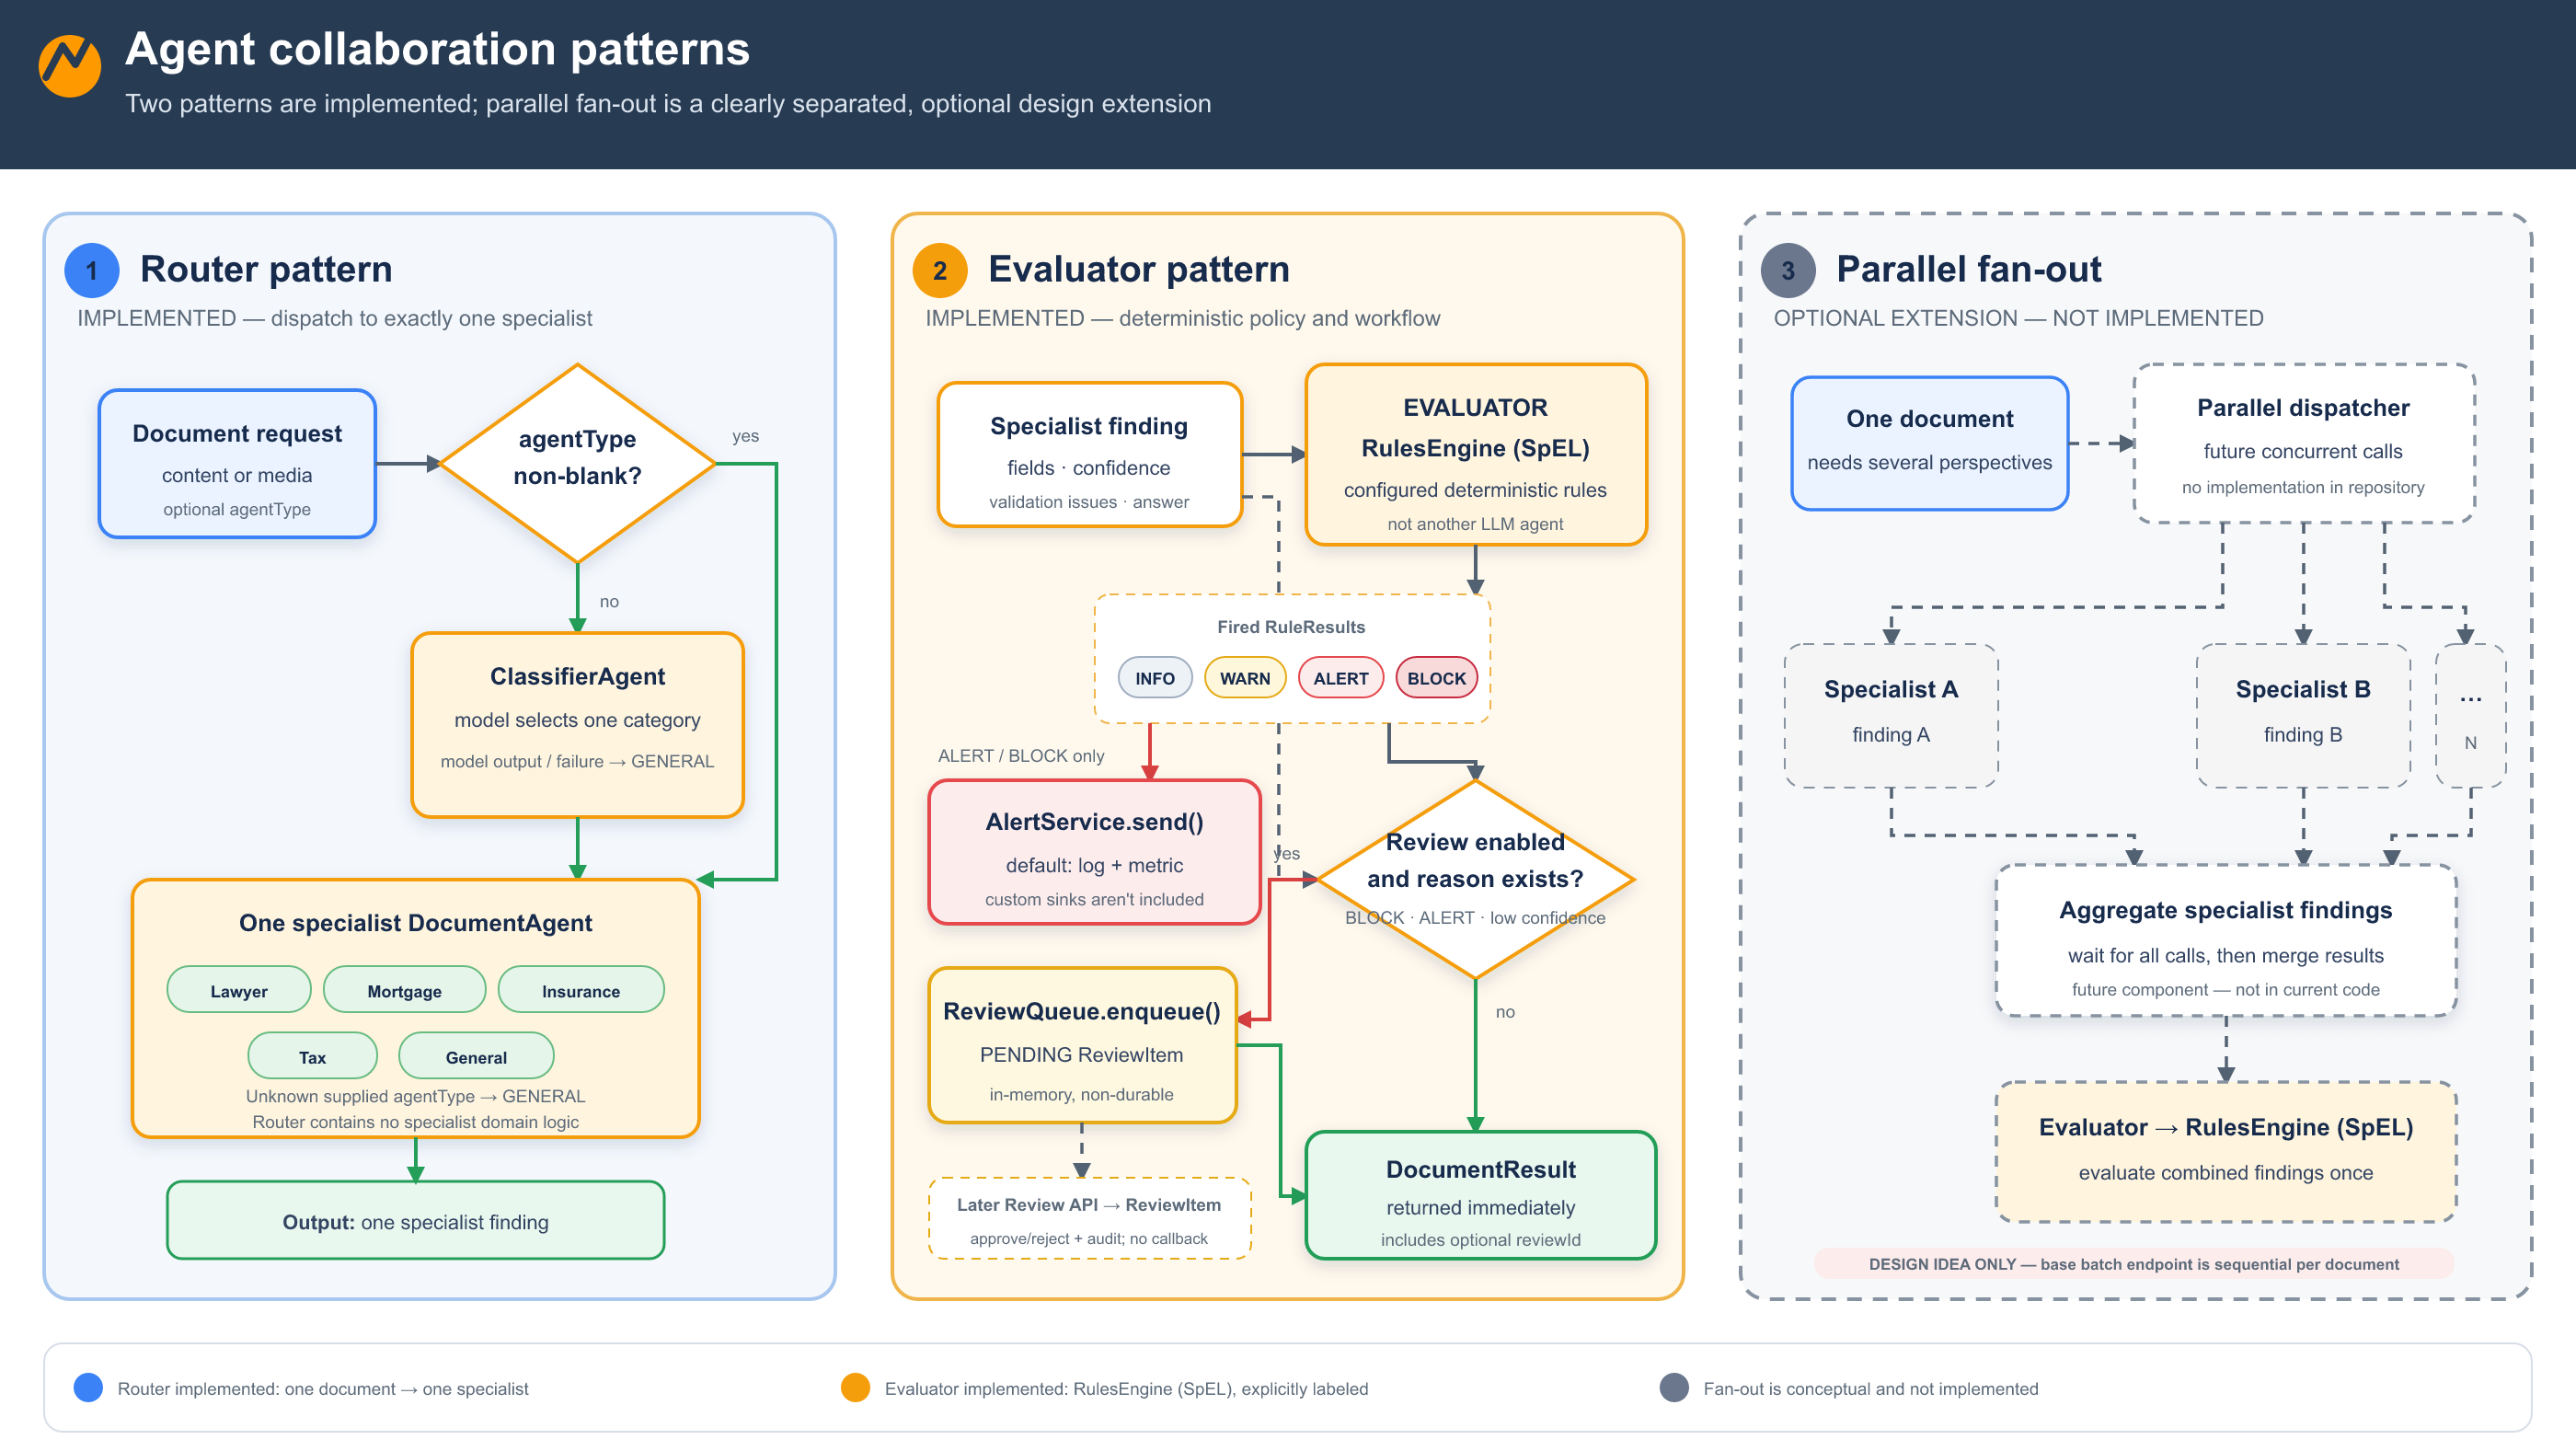
图 4:智能体协作模式
三种模式并排展示。路由器按文档类型将每个请求分派给一位专家。评估器将专家发现结果传入规则引擎,该规则引擎适用于严重性级别,并分派告警或阻止以进行人工审核。并行扇出将单个请求同时发送给多位专家,并在规则引擎运行前汇总结果。
路由模式: 轻量级编排器检查传入请求,并将其路由到相应的专家。在 IDP 多智能体系统中,路由器检查文档类型元数据,并将其转发给 Lawyer、Mortgage、Insurance、Tax 或 General 智能体。路由器不持有任何领域逻辑。它只是一个分派层。
并行扇出(可选扩展): 基础解决方案实现了路由器和评估器模式。批处理端点按顺序处理文档。当一份文档需要同时从多个视角分析时,你可以添加并行扇出作为即插即用的扩展。并发分派给专家智能体,并在规则引擎运行前汇总它们的结果。这样,组合分析的实际耗时便取决于最慢的单次智能体调用,而不是所有调用耗时之和。
评估器模式:专家返回其发现结果后,规则引擎会根据可配置的业务规则评估合并后的输出。触发 ALERT 或 BLOCK 严重性告警通过可插拔的 AlertService 分派,供人工审核。
演练
以下各节将带您了解关键的实现模式,从 AgentCore 运行时契约开始,逐步介绍工具调用、记忆、韧性和多智能体编排。
履行 AgentCore 运行时契约
Amazon Bedrock AgentCore 运行时负责管理智能体的生命周期和扩缩容。有关当前费率,请参阅 Amazon Bedrock AgentCore 定价和 Amazon Bedrock 定价。运行时将传入请求路由到您的智能体,并监控其健康状况。您的智能体必须公开两个端点:
- POST
/invocations– 接收请求并以 JSON 或 Server-Sent Events (SSE) 流式返回响应。 - GET
/ping– 报告健康状态(Healthy或HealthyBusy)。长时间运行的任务必须发出忙碌状态信号,否则运行时可能会缩减该智能体的规模。
下图展示了 Spring AI 开发者模型如何映射到 AgentCore 运行时、Memory、Browser、Code Interpreter 和 Evaluations。
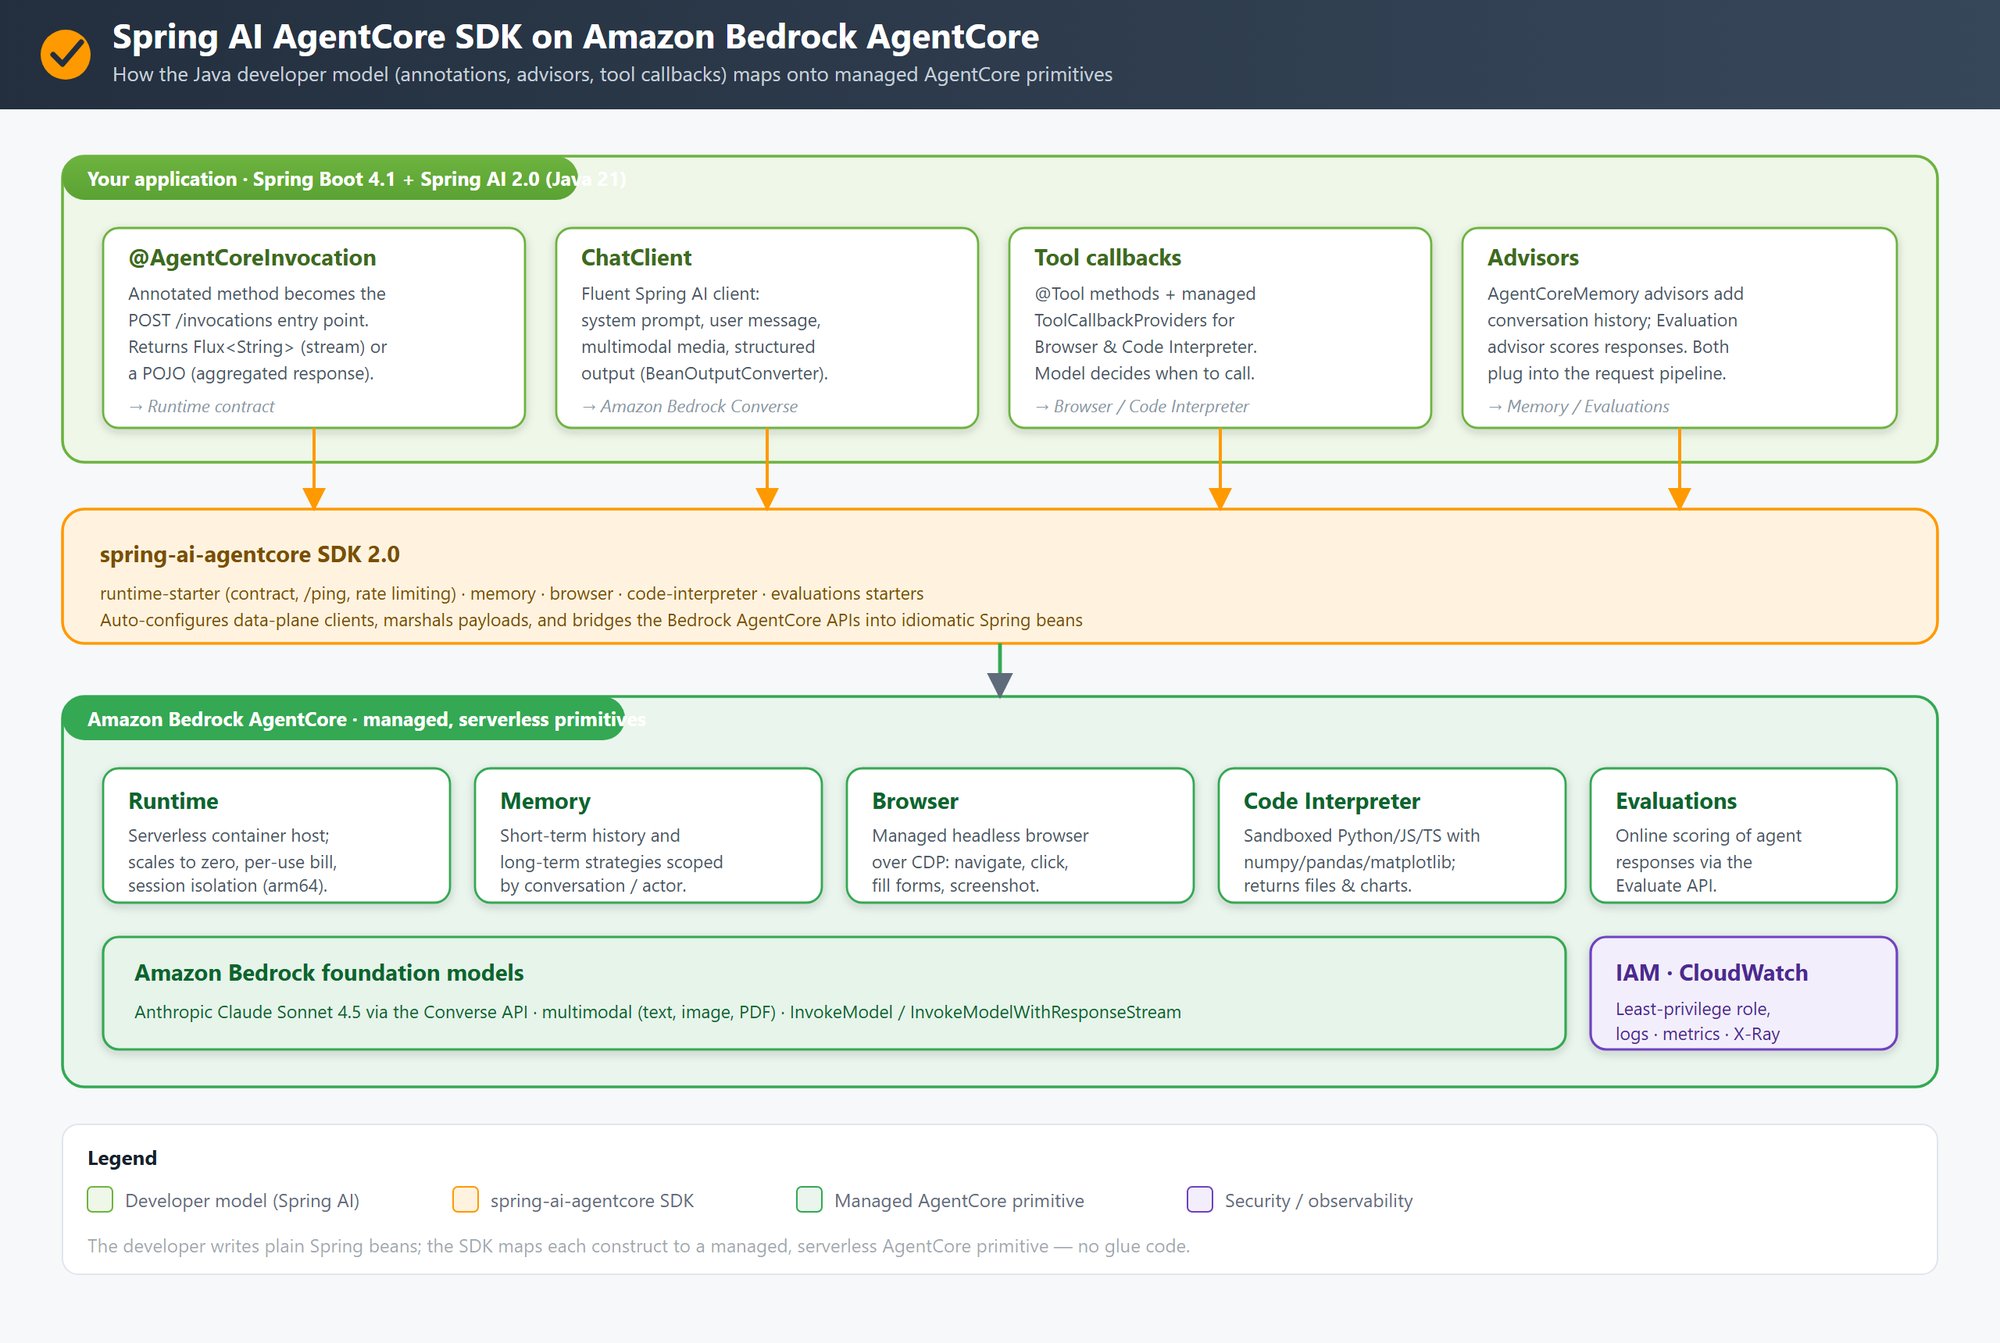
图 5:Amazon Bedrock AgentCore 上的 Spring AI AgentCore SDK。注解、ChatClient、工具回调和 advisors 通过 spring-ai-agentcore SDK 映射到 AgentCore 运行时、AgentCore 记忆、AgentCore Browser、AgentCore Code Interpreter 和 AgentCore Evaluations。
由 spring-ai-agentcore SDK 连接的两个层。应用层使用 Spring AI 组件: @AgentCoreInvocation 用于端点接线, ChatClient 用于模型交互, @Tool 回调以及用于记忆和护栏的 advisors。基础设施层提供 AgentCore 运行时、AgentCore 记忆、AgentCore Browser、AgentCore Code Interpreter 和 AgentCore Evaluations,这些都是 Amazon Bedrock AgentCore 的能力。SDK 连接这两层,因此开发者编写标准的 Spring AI 代码,而由 AgentCore 处理生产基础设施。
借助 Spring AI AgentCore SDK,只需一个注解即可自动处理这一约定:
@Service
public class TravelAgent {
    private final ChatClient chatClient;

    public TravelAgent(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }

    @AgentCoreInvocation
    public Flux<String> chat(PromptRequest request) {
        return chatClient.prompt()
                .user(request.prompt())
                .stream()
                .content();
    }
}
该 @AgentCoreInvocation 注解会自动配置 /invocations 和 /ping 端点、处理 JSON 序列化、管理流式响应的 SSE 帧封装,并报告健康状态。同一个项目还为 React UI 暴露 REST 端点,因此该智能体从同一套代码库同时服务于 AgentCore 运行时和浏览器。
关于流式传输的说明:前面的最小示例直接返回模型流,这非常适合聊天 UI。当智能体进行多参数工具调用时,请用阻塞式方式组装响应, call() 然后对结果进行分块以便流式传输,这样工具参数就能可靠地绑定。旅行助手通过同一个服务方法同时为 AgentCore 运行时和 React UI 提供服务:
@RestController
public class AgentController {
    private final AgentService agentService;

    public AgentController(AgentService agentService) {
        this.agentService = agentService;
    }

    // One annotation wires up POST /invocations + GET /ping, JSON/SSE framing, and health.
    @AgentCoreInvocation
    public Flux<String> invoke(PromptRequest request, AgentCoreContext context) {
        String sessionId = context.getHeader(AgentCoreHeaders.SESSION_ID);
        return agentService.streamChat(request.prompt(), sessionId,
                request.guardrailsEnabled(), request.memoryEnabled());
    }

    // The same app also serves the React UI from the same code base.
    @PostMapping(value = "/api/chat", produces = MediaType.TEXT_PLAIN_VALUE + ";charset=UTF-8")
    public Flux<String> chatStream(@Valid @RequestBody PromptRequest request) {
        return agentService.streamChat(request.prompt(), request.sessionId(),
                request.guardrailsEnabled(), request.memoryEnabled());
    }
}
实现工具调用
借助工具调用,模型可以在推理过程中调用外部函数。在 Spring AI 中,你用一个注解标注方法, @Tool ,模型决定何时调用它以及使用什么参数:
@Tool(description = "Get a short weather forecast for a city")
public String getWeather(
        @ToolParam(description = "City name") String city) {
    return forecastService.lookup(city);
}
你在 ChatClient 上注册工具,由模型决定何时调用它们:
ChatClient chatClient = chatClientBuilder
        .defaultSystem(properties.getSystemPrompt())
        .defaultTools(new DateTimeTools(), new TravelTools())
        .build();
对于结构化输出,请请求 Java record 类型。对于多模态输入,请将媒体附加到用户消息中:
ProcessedDocument review = chatClient.prompt()
        .system(personaSystemPrompt)
        .user(u -> u.text(question).media(mimeType, fileResource))
        .call()
        .entity(ProcessedDocument.class);
注意: 我们在 Amazon Bedrock 上使用 Anthropic Claude Sonnet 4.5 验证了这一示例。Spring AI 会将 record 的 schema 添加到提示中,并将回复解析回 Java 类型。其他模型系列的行为可能有所不同,因此请参阅 Spring AI 结构化输出文档和 Amazon Bedrock 文档以了解当前支持情况。这是尽力而为的机制,意味着模型偶尔可能返回不符合 schema 的输出。如需更严格的结果,请使用具备原生 schema 强制能力的提供商,或使用 Spring AI 的校验与重试机制。
模型将工具定义作为其上下文的一部分接收,推理何时调用工具有助于满足用户请求,并返回结构化的工具调用响应。Spring AI 拦截该响应,调用带注解的方法,并将结果反馈给模型以进行进一步推理。
添加对话记忆
真实世界的智能体必须记住用户在对话早些时候说过的话(工作记忆)以及它们随时间学到的东西(持久记忆)。Spring AI AgentCore SDK 通过 advisor 模式与 AgentCore memory 集成:这些拦截器在提示到达模型之前用上下文对其进行丰富。
chatClient.prompt()
        .advisors(agentCoreMemory.advisors)
        .advisors(a -> a.param(
                ChatMemory.CONVERSATION_ID, "user:" + sessionId))
        .user(prompt)
        .stream()
        .content();
会话 ID 会以 actor:session 的形式成为对话 ID,因此每个用户的历史记录保持隔离。对于面向用户的部署,应从经过验证的 OAuth 2.0(JWT)身份中派生 actor,而不是使用客户端提供的值,这样用户就无法访问彼此的历史记录。
此外,AgentCore memory 提供长期记忆支持,采用以下策略来识别和捕获对话中的关键洞察:
- 语义 ——关于用户的事实信息(例如,“用户从事金融工作”)
- 用户偏好 —— 显式设置与选择(例如,“首选公制单位”)
- 摘要 —— 精简的对话历史,用于跨会话保持连续性。
- 情景记忆 ——过往交互与经验教训。
长期记忆提取是异步且可选的。你可以在创建记忆时选择启用哪些策略,AgentCore 会在每次对话结束后在后台提取并整合记录,因此它绝不会阻塞智能体的响应。按工作负载选择策略:为旅行助手使用用户偏好,以便它记住单位和座位选择。当会话跨越多个轮次时使用摘要。当智能体应复用过往任务中的经验时使用情景记忆。并使用语义记忆来保留关于用户的持久事实。
配置规则引擎
阅读文档只是工作的一半,根据发现的内容采取行动是另一半。IDP 多智能体系统包含一个规则引擎,使操作人员无需改动代码即可添加业务检查。这是一个进程内规则评估器,将 SpEL 条件应用于提取结果,而不是像 AWS Step Functions 这样的工作流编排服务。规则位于 application.yml ,每个条件都是一个针对提取结果求值的 SpEL 表达式:
idp:
  review:
    enabled: ${REVIEW_ENABLED:true}
    confidence-threshold: ${REVIEW_CONFIDENCE_THRESHOLD:0.7}
    rules:
      - id: legal-unsigned
        agentType: LAWYER
        condition: "field('signaturePresent') == 'false' || missing('signaturePresent')"
        severity: ALERT
        message: "Document appears unsigned; get all parties to sign before relying on it."
      - id: mortgage-high-dti
        agentType: MORTGAGE
        condition: "field('dtiRatio') != '' && T(java.lang.Double).parseDouble(field('dtiRatio')) > 0.43"
        severity: WARN
        message: "Debt-to-income ratio exceeds 0.43; likely needs manual underwriting."
      - id: low-confidence
        agentType: ALL
        condition: "confidence < 0.6"
        severity: WARN
        message: "Low extraction confidence; consider human verification."
严重级别控制引擎的行为。 INFO 和 WARN 会被记录,而 ALERT 通过可插拔的机制进行分发 AlertService默认实现会记录日志并发出指标,但你可以替换为 Amazon Simple Notification Service (Amazon SNS)、Slack 或电子邮件,只需提供你自己的 bean。 BLOCK 保存文档以供人工审核。由于规则是操作员配置而非最终用户输入,它们提供了一个安全且可审计的扩展点。添加新工作流属于配置变更,而非部署。
评估器模式由规则引擎和一个可插拔的 AlertService默认实现会记录告警并发出指标。你可以提供自己的 bean,将告警路由到 Amazon SNS、Slack 或电子邮件:
public class LoggingAlertService implements AlertService {
    @Override
    public void send(RuleResult result, AgentType agentType, ProcessedDocument document) {
        registry.counter("idp.alerts.sent",
                "severity", result.severity().name(), "type", agentType.name()).increment();
        logger.warn("ALERT [{}] rule={} type={} message=\"{}\"",
                result.severity(), result.ruleId(), agentType, result.message());
    }
}
生产就绪模式
以下模式解决了原型通常会跳过的常见生产环境需求。
弹性
每次模型调用都使用带指数退避的 Resilience4j 重试、一个在模型调用反复失败或超时时快速失败的断路器,以及一个超时设置。流式路径会发出回退消息,而不是原始错误。当流量超出你的账户和区域服务配额时,AgentCore 运行时返回 HTTP 429 ,重试机制会处理该响应。有关当前限制,请参阅 Amazon Bedrock AgentCore 配额文档.
十二要素配置
每个可配置值(区域、模型 ID、记忆 ID、超时、速率限制、系统提示)都是绑定到类型化 @ConfigurationProperties 类。该应用无状态、启动迅速、在缩容时会排空进行中的轮次,并以单个不可变的 ARM64 镜像交付,从开发到生产原样晋级。
安全与身份
Agentcore 运行时默认使用 AWS Identity and Access Management(IAM)身份验证。对于面向用户的智能体,请添加 OAuth 2.0(JWT)授权器(例如 Amazon Cognito),并从已验证的身份中派生记忆参与者 ID(actorId)。IAM 执行角色遵循最小权限原则:
- Amazon Elastic Container Registry(Amazon ECR)拉取。
- 限定范围的 Amazon CloudWatch Logs 和 AWS X-Ray。
- Amazon Bedrock InvokeModel 操作。
- 用于智能体工作负载身份的限定范围工作负载访问令牌(
GetWorkloadAccessTokenForJWT),用于智能体的工作负载身份。 - AgentCore 记忆操作仅限于特定的 Memory 资源 ARN。
AgentCore Gateway 是 Amazon Bedrock AgentCore 的一项能力,它强制执行入站身份验证(作为 OAuth 2.0 资源服务器,通过 Cognito、Okta、Auth0 或你自己的 OIDC 提供程序验证 JWT 持有者令牌),并支持在网关层配置速率限制。速率限制默认采用故障开放(fail-open)策略,因此它们应当补充而非取代你的核心安全控制。
负责任的 AI 控制措施
采取真实世界行动的自主智能体需要将安全控制作为首要关注点。该示例附带了一个轻量级进程内预检查的替代演示,称为 GuardrailService。该服务会筛查提示词中是否存在不允许的意图和提示词注入,并按请求通过该标志进行切换。 guardrailsEnabled 标志进行切换。生产部署使用 Amazon Bedrock Guardrails 作为应用于每个请求的标准控制,而非按请求切换的开关。
要为生产环境升级该演示服务,请使用 Amazon Bedrock Guardrails 为智能体提供前置防护。Guardrails 在模型调用之外应用可配置的策略,同时覆盖输入和输出:
- 内容过滤。基于可配置的阈值,对提示词和响应中的有害或偏离主题的内容进行拦截。
- 拒绝主题。防止智能体接触你定义为超出范围的主题。
- 敏感信息过滤。检测并脱敏提示词和响应中的 PII,支持 GDPR 和 HIPAA 等要求。
对于检索外部知识的智能体,请启用接地检查,以在智能体基于具有真实世界副作用的工具调用采取行动之前降低幻觉风险。
要将 Bedrock Guardrails 接入 Spring AI,请实现 CallAdvisor 和 StreamAdvisor 调用该 API 并在 上将其注册到 。 ApplyGuardrail API,并在 . 上将其注册到 defaultAdvisors 在 ChatClient由于策略存在于护栏中,安全团队可以独立于应用程序发布周期更新过滤器。
可观测性
使用 Micrometer Observation API 的示例工具(@Observed),从而在添加追踪桥接(OTLP 到 AWS X-Ray)后生成成为分布式追踪跨度的计时器。系统会发出领域指标:
idp.documents.processed{type,status}
idp.extraction.confidence{type}
idp.alerts.sent{severity,type}
idp.processing.duration{type}
这些指标通过以下方式暴露: /actuator/prometheus应用程序还会将结构化 JSON 日志输出到标准输出,Amazon Bedrock AgentCore 运行时会在 Amazon CloudWatch Logs 中捕获这些日志。
本文未实现的可选扩展:示例包含 Micrometer OpenTelemetry 桥接和 OTLP 导出器依赖,但本文的部署未配置 OpenTelemetry 收集器,也未启用追踪采样。你可以通过设置一个非零的 TRACING_SAMPLING 值,指向 OTLP_TRACES_ENDPOINT 一个 OpenTelemetry 或 AWS Distro for OpenTelemetry 收集器,并配置该收集器将追踪数据转发到 AWS X-Ray。
本文未实现的可选扩展:示例未实现自动化评估或优化反馈闭环。你可以通过将应用程序指标、追踪、审计事件和人工审核结果持久化为评估数据集来添加一个。随后,AgentCore 评估或单独的评估流水线可以依据质量、安全、延迟和成本阈值,比较带版本的提示词、模型、工具和路由规则。只有在评估和人工批准之后才推广变更。
部署该解决方案
本文未实现的可选扩展:示例未实现自动化评估或优化反馈闭环。你可以通过将应用程序指标、追踪、审计事件和人工审核结果持久化为评估数据集来添加一个。随后,AgentCore 评估或单独的评估流水线可以依据质量、安全、延迟和成本阈值,比较带版本的提示词、模型、工具和路由规则。只有在评估和人工批准之后才推广变更。部署该解决方案 GitHub 仓库 包含两个 AI 智能体应用,演示自主 AI 的不同用例。本指南介绍如何使用 Amazon Bedrock AgentCore 运行时将它们部署到 AWS。
下图展示了部署架构:单个 Arm64 镜像通过模块化 Terraform 推广到 AgentCore 运行时,并可选地通过 Amazon Elastic Kubernetes Service(Amazon EKS)路径部署。
可选:在 Amazon EKS 上运行。 已经标准化使用 Kubernetes 的团队可以在 Amazon EKS 上运行相同的 Arm64 镜像,利用其现有集群对 /ping 端点,并使用 IAM Roles for Service Accounts (IRSA) 实现范围受限、最小权限的 Pod 级访问,以访问 Amazon Bedrock 和 AgentCore 内存。容器完全相同,因此应用程序中无需任何更改。
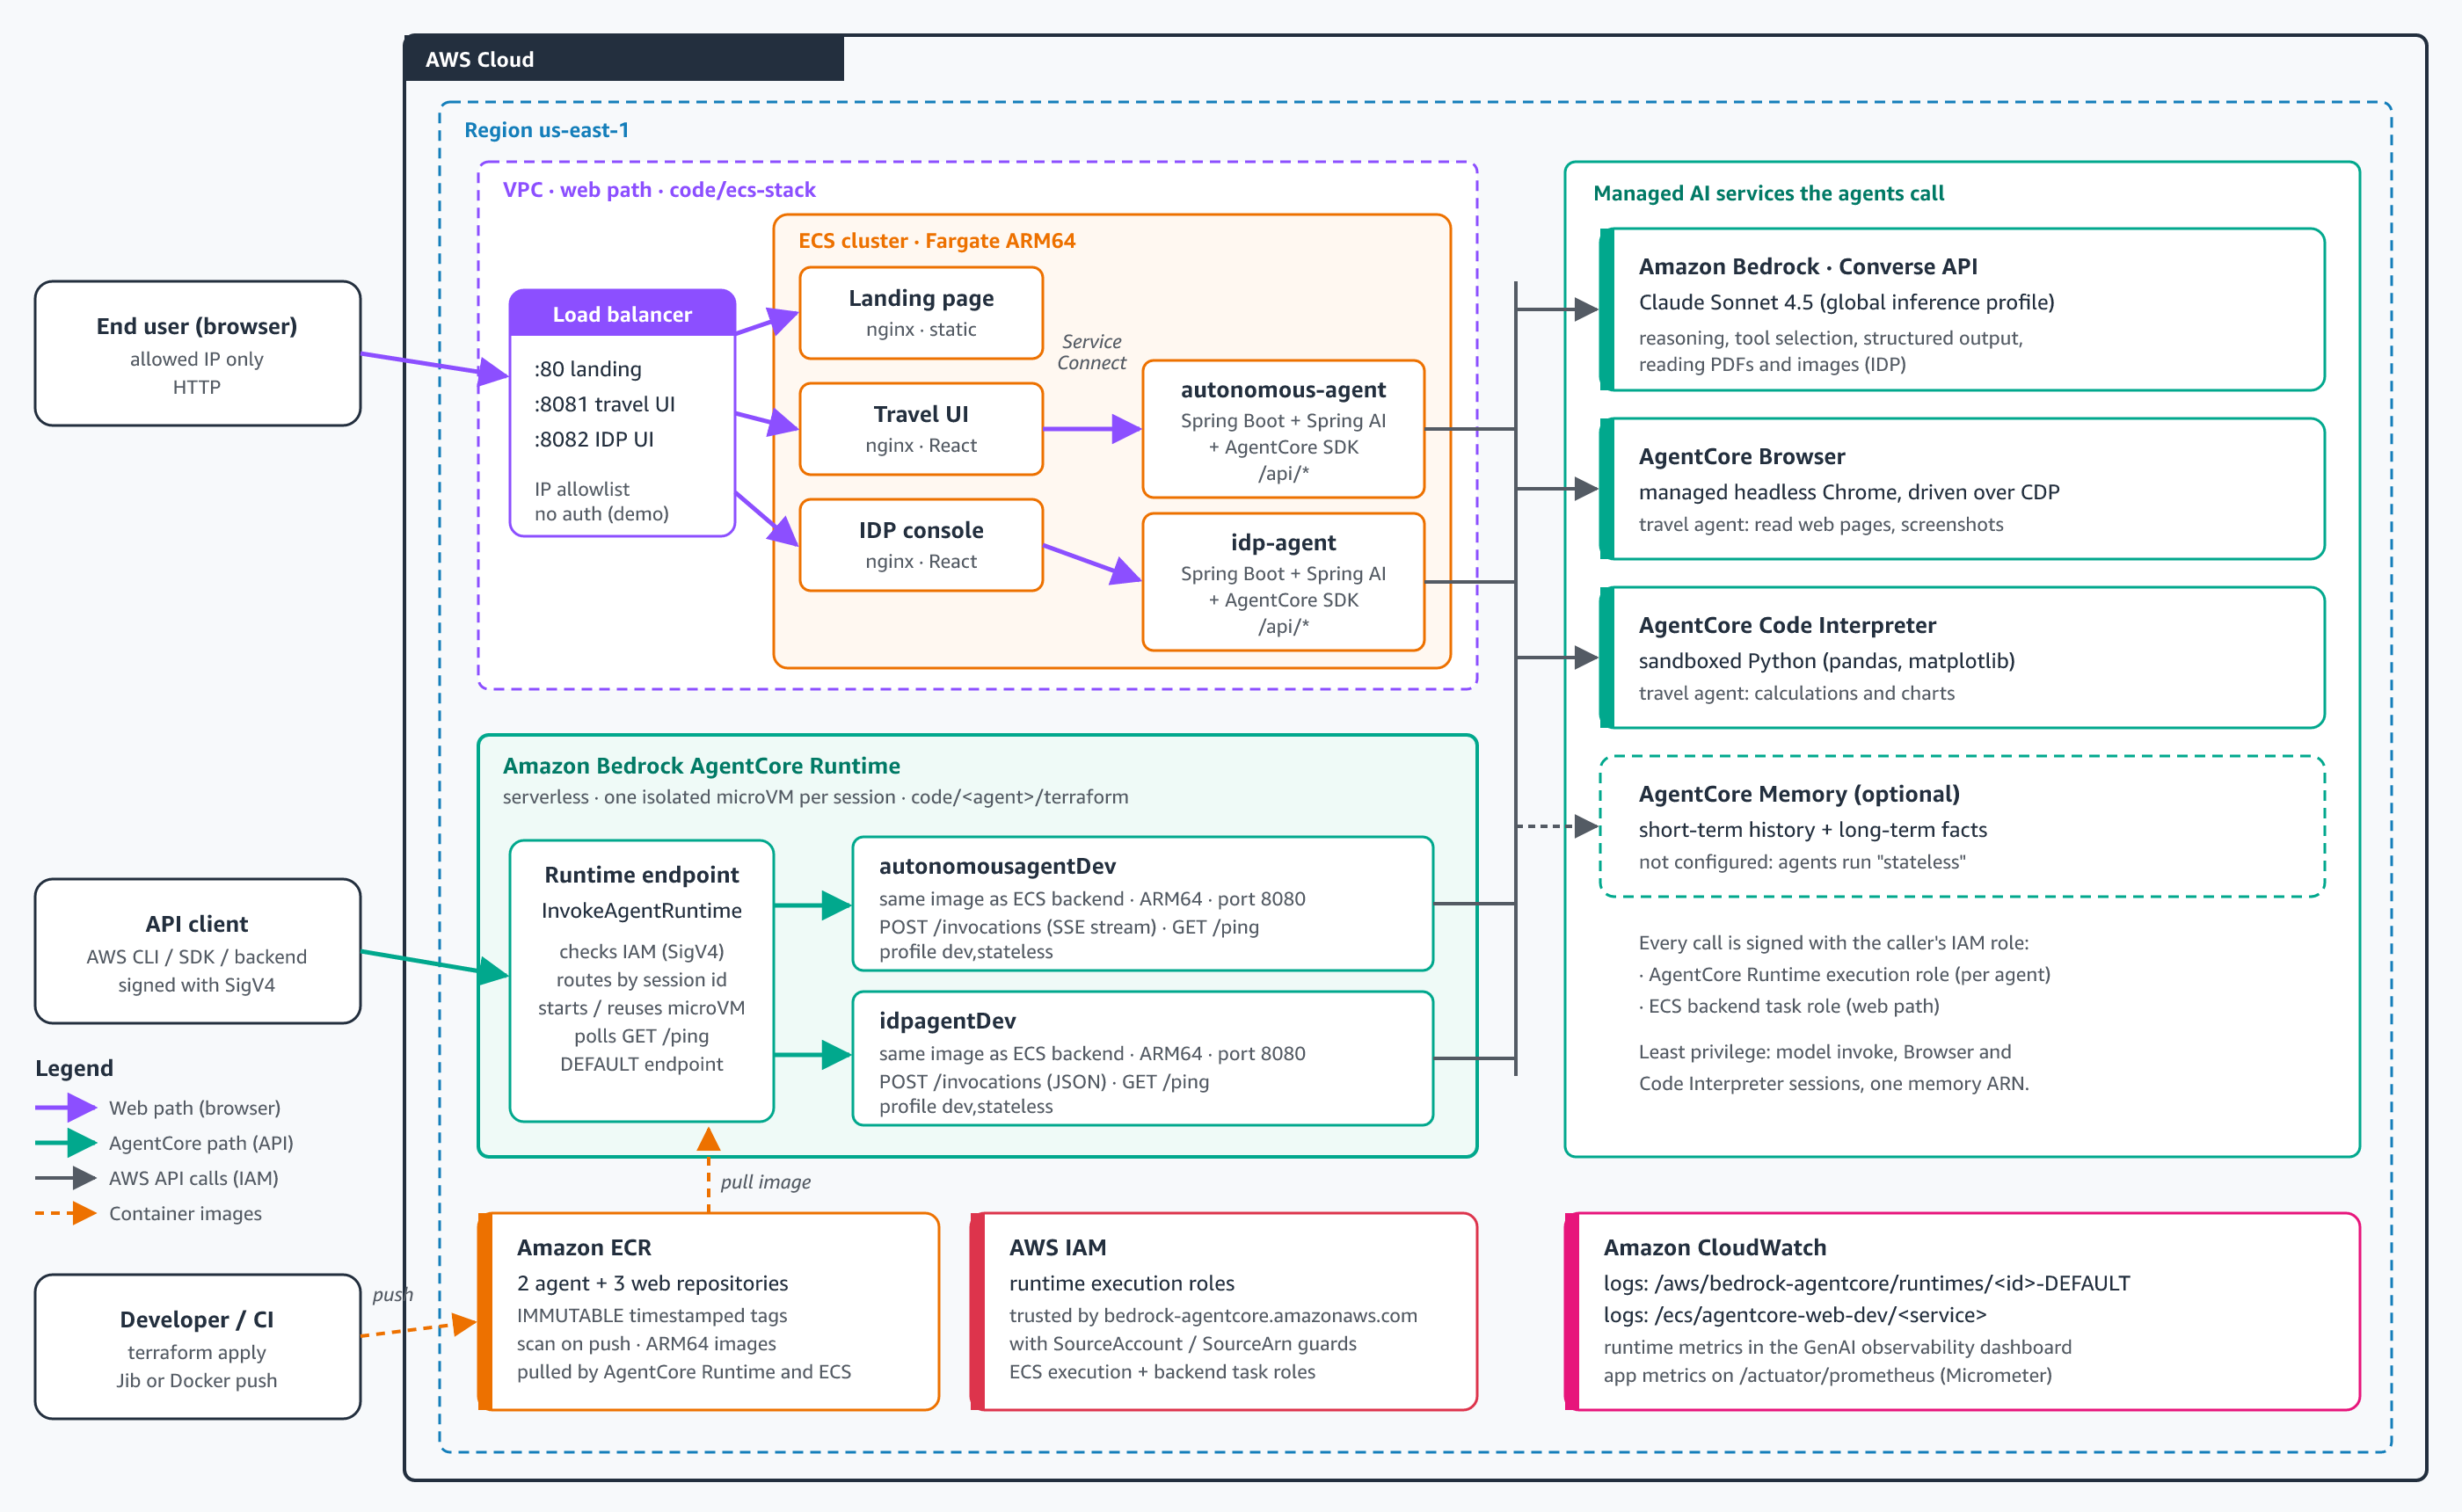
图 6:部署架构。模块化 Terraform 预置 Amazon ECR、最小权限 IAM 执行角色和 Bedrock AgentCore 运行时,并提供可选的 Amazon EKS 与 IRSA 路径,复用同一 Arm64 镜像。
三个阶段:构建与发布、Terraform,以及在 AWS 上运行。CI 流水线将应用打包为 linux/arm64 镜像,并以不可变标签推送到 Amazon ECR。三个 Terraform 模块分别预置 ECR 仓库、最小权限 IAM 执行角色和 AgentCore 运行时。智能体在 AgentCore 运行时上以无服务器方式运行,调用 Amazon Bedrock 和 AgentCore 内存。可选的 Amazon EKS 路径复用同一镜像,并通过 IRSA 实现范围受限的 Pod 级凭证。
按照以下步骤部署任一应用。
步骤 1:克隆仓库
打开终端并运行:
git clone https://github.com/aws-samples/sample-build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai.git步骤 2:导航到要部署的智能体所在目录
- 部署自主智能体:
cd build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai/code/autonomous-agent - 部署 IDP 多智能体系统:
cd build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai/code/idp-agent
步骤 3:配置 Terraform 变量
在部署基础设施之前,请在 terraform 目录下的 terraform.tfvars 文件中配置 Terraform 变量。
基本配置
该解决方案对大多数设置使用默认值,但你可以在你的 terraform.tfvars 文件中自定义以下内容:
- AWS 区域:部署资源所在的 AWS 区域。
- 环境:环境 ID(例如
dev)用于资源命名。:Amazon Bedrock 基础模型(例如:)。有关各区域模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型。步骤 4:运行部署脚本对于 Linux/macOS:对于 Windows PowerShell:部署脚本执行以下操作:创建 Amazon ECR 仓库。构建 Java 应用程序。创建并推送 Docker 容器镜像。创建 IAM 执行角色。部署 AgentCore 运行时。步骤 5:运行应用程序部署完成后,prod)用于资源命名。 bedrock_model:Amazon Bedrock 基础模型(例如:global.anthropic.claude-sonnet-4-5-20250929-v1:0)。有关各区域模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型.
步骤 4:运行部署脚本
对于 Linux/macOS:
./scripts/deploy.sh dev对于 Windows PowerShell:
.\scripts\deploy.ps1 dev部署脚本执行以下操作:
- 创建 Amazon ECR 仓库。
- 构建 Java 应用程序。
- 创建并推送 Docker 容器镜像。
- 创建 IAM 执行角色。
- 部署 AgentCore 运行时。
步骤 5:运行应用程序
部署完成后,你可以使用以下命令运行应用程序。
对于 Linux/macOS:
./scripts/run.sh dev对于 Windows PowerShell:
.\scripts\run.ps1 dev清理
AgentCore 运行时可以缩减到零并按调用次数计费,因此空闲智能体几乎不产生费用。你的主要可变成本是 Amazon Bedrock 的 token 用量,外加少量 Amazon CloudWatch 和 Amazon ECR 存储费用。有关当前费率,请参阅 Amazon Bedrock AgentCore 定价和 Amazon Bedrock 定价。为避免产生未来费用,请在完成后拆除基础设施:
对于 Linux/macOS:
./scripts/cleanup.sh dev对于 Windows PowerShell:
.\scripts\cleanup.ps1 dev使用 AWS CLI 删除不再需要的 AgentCore 内存资源和 Amazon ECR 镜像。
结论
在本文中,你学习了如何使用 Spring AI 和 Amazon Bedrock 在 Java 中构建自主 AI 智能体。我们介绍了将模型转变为智能体的三项能力:规划、工具使用和记忆。我们还展示了 Amazon Bedrock AgentCore 服务如何将智能体带入生产环境。Spring AI AgentCore SDK 通过注解和熟悉的“ ChatClient最后,我们概述了多智能体协作的架构模式。这些模式包括路由器模式、由规则引擎实现的评估器模式,以及作为可选扩展的并行扇出。
对 Java 团队而言,关键要点是:你无需离开自己的环境就能构建生产级质量的智能体。你早已信赖的模式(依赖注入、配置属性、advisor、Actuator、Micrometer)可以直接沿用到智能体领域。AgentCore 提供了生产环境所需的运行时、记忆、身份和治理能力。
作为后续步骤,请考虑以下几点:
- 通过以下方式连接企业系统: AgentCore Gateway 以及 模型上下文协议(MCP)
- 添加 Amazon Bedrock Knowledge Bases(全托管的 RAG 能力)和 Web 搜索,让智能体能够基于你的数据进行推理。
- 使用 Amazon Cognito JWT 身份验证实现按用户隔离的记忆。
- 自定义 Amazon Bedrock Guardrails 策略:添加特定领域的拒绝主题、收紧内容过滤阈值,并启用针对你的知识源调优的接地检查。
- 使用 AgentCore Evaluations 对生产环境中的追踪记录进行评分,并在审核后推广提示词或模型变更。
每一项都是对您在此处所构建基础的增量补充,而非重写。