发布于 2026/11/16
我们在 Together AI 如何做智能体评测对我们的文档、技能和 API 错误做的小修正,将任务完成率从 75% 提升到了 97%。
作者
Hassan El Mghari、Sam Barrowclough、Zain Hasan、Mo King
目录
今年早些时候,我们开始看到越来越多的开发者使用编码智能体来基于 Together AI 进行构建。
原因不难理解:开发者要手动把一个应用接入生产推理,可能需要几天甚至几周,尤其是当他们刚接触这个平台时。但对于使用我们 SDK 和 CLI 的智能体来说,这只需要几分钟——至少在理论上如此。
而在实践中,我们完全不知道指向我们平台的智能体是否能够高效地与 Together 协作,也不知道它们是否遇到了障碍、钻进了死胡同,或者直接失败,并在这一过程中浪费 token。
随着开发者将越来越多的工作交给智能体,开发者体验(DX)正日益与智能体体验(AX)画上等号。你的软件对智能体来说越容易使用,开发者就越容易将其集成到自己的产品和工作流中。
GitHub 是优秀 AX 的教科书级范例:过去一年里该平台上的活动量增长了两倍,2026 年所有 PR 中约有 40% 是由智能体提交的(而且我们敢打赌,在所有提交中,智能体编写的代码行数远超 40%)。这要归功于 GitHub 出色的 API、CLI 和文档,它们让智能体使用起来格外容易。 (本文作者甚至都不知道 GitHub 有 CLI,直到智能体开始替他使用它,而现在他大概每天要用 1000 多次)。
为了提升 Together AI 的 AX,我们需要一种方法来衡量我们的平台究竟有多适合智能体使用。在本文中,我们将介绍我们如何运行智能体评测、评测发现的两个问题以及我们如何修复它们,还有我们学到了什么。
我们如何在 Together 运行智能体评测
构建任务列表
在开始评测之前,我们需要知道智能体实际被要求做什么……这样我们才能,你懂的,弄清楚它们能不能做到这些事。我们开始构建一份开发者在 Together 上处理的常见任务列表,比如运行批量推理作业、构建语音智能体,或管理推理端点的自动扩缩容。
所谓 任务, 其实就是一个提示词,也就是你会让智能体去做的事情——例如:
列出可用的 GPU 集群区域和实例类型,打印最便宜的选项,并展示你为按需预留它一小时而会运行的确切命令。不要实际预留它。
要通过评测,智能体必须:
- 找到最新的定价信息。
- 调用 regions API 端点以列出可用区域。
- 将两者结合以找出最便宜的选项。
- 生成一条用于创建集群的有效 CLI 命令。
该提示词同时询问可用性和定价,却没有提及这些细节分别位于两个不同的地方。这很贴近现实,因为普通用户一开始可能并不知道每条信息在哪里,这很容易让人类和智能体都栽跟头。
三种配置
构建好任务列表后,我们以三种方式运行每个任务:
- 基线: 智能体只收到提示词,没有任何特殊配置,模拟普通开发者的工作流。它可以使用所有默认工具,比如从网上获取文档,但我们不会给它任何特定的 MCP 连接器或技能。
- MCP: 智能体通过我们的 MCP 服务器直接访问我们的 文档 ,因此当它遇到障碍时,确切知道该去哪里搜索。
- 技能: 我们给智能体提供 Together 技能包,其中包含专门为智能体编写的、关于如何使用我们服务的说明和示例。
运行矩阵
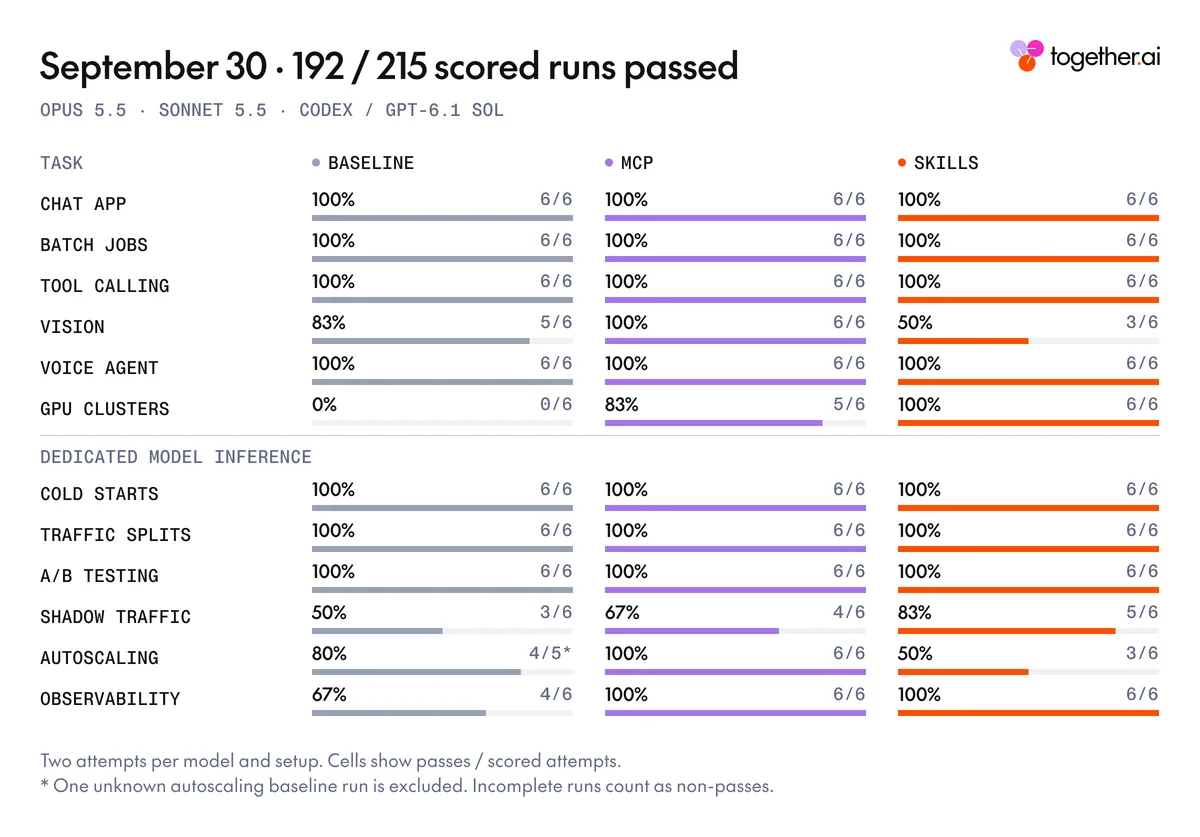
每次完整评测都会使用三个模型,针对每种智能体配置运行每个任务,每个任务尝试两次——因此每种配置下每个任务有六次尝试,如下方我们 9 月 30 日的运行所示:
自动化运行
当我们开始构建评测时,一切都是手动运行的:打开一个新终端,把提示词粘贴到 Claude Code 中,让智能体做它该做的事(或者做不成它该做的事),然后对每种配置重复这一过程。这既手动又繁琐,所以一旦我们想清楚所需系统的形态,就开始将其自动化。
现在我们在 Together 沙箱 中运行每个智能体,这样它们就不会干扰我们的本地环境或彼此。GitHub Actions 负责环境搭建、启动智能体、事后清理并保存结果,而一个代理负责处理智能体对 Together API 的请求并记录活动,这样我们就能看到智能体调用了哪些端点以及返回了什么。
为一次运行评分
一次运行结束后,一个 LLM 裁判会审查任务提示词和录制的会话,然后给出三种判定之一:
- 通过: 任务的每一项要求都得到了满足。
- 未完成: 智能体尝试了任务,但某些必需步骤未完成或未经验证。
- 失败: 智能体过早放弃、违反了明确的约束,或产生了错误结果(RIP)。
失败和未完成的判定并不一定能告诉我们问题出在智能体、API 还是证据缺失上。它们只是告诉我们该从哪里开始排查。
我们也会调查通过的运行。智能体往往能绕过令人困惑的响应并仍然完成任务,而这些恢复过程向我们展示了该修复什么以提升 token 效率。
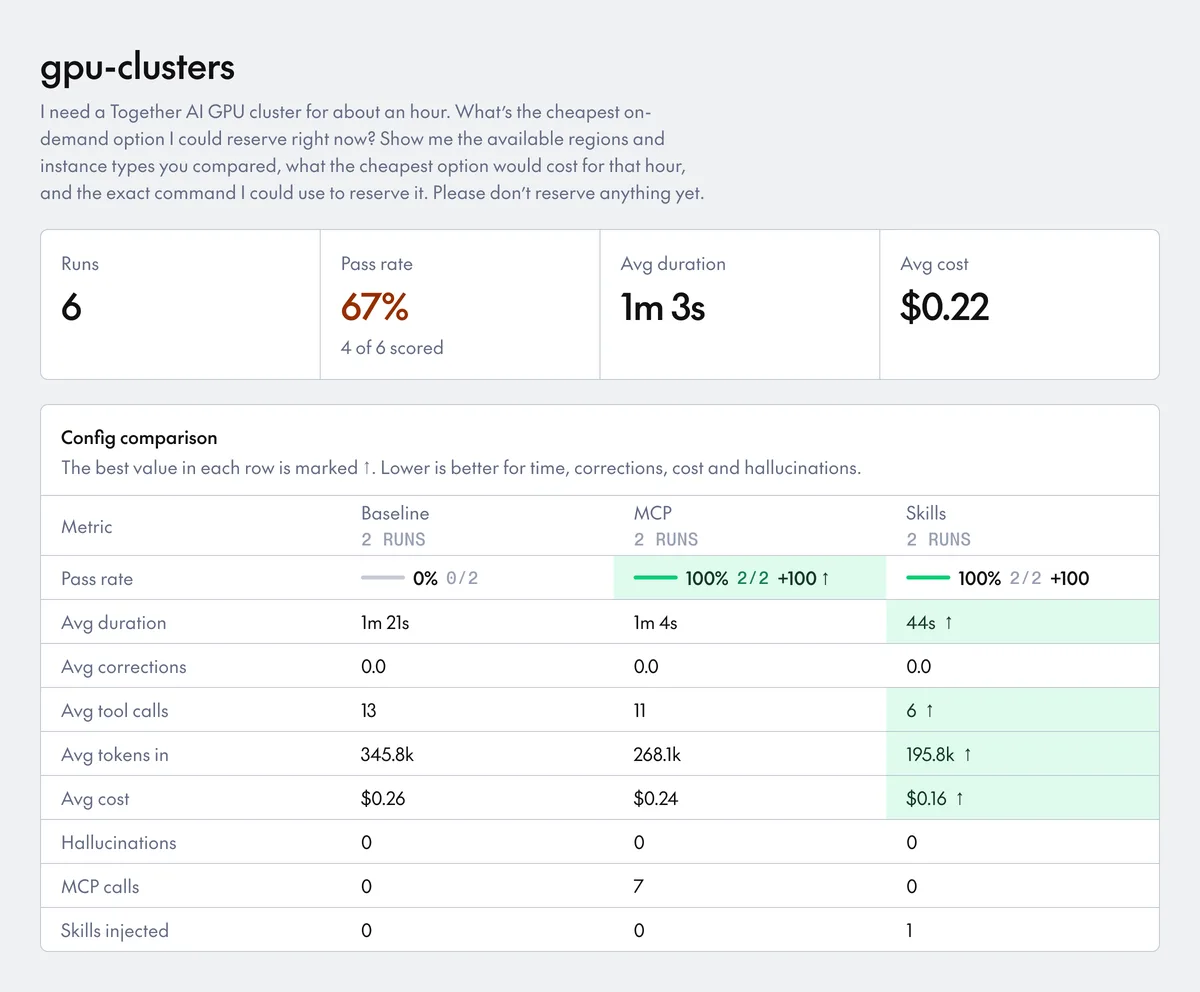
为了让这种审查切实可行,我们构建了一个结果查看器,用于比较不同模型和配置的表现。对于每次运行,它会显示提示词、智能体使用的工具、它收到的响应以及任何 API 活动:
案例研究 1:GPU 集群定价
还记得前面提到的 GPU 集群任务吗?
列出可用的 GPU 集群区域和实例类型,打印出最便宜的选项,并展示你会在按需预留一小时时运行的确切命令。不要实际预留。
看起来相当简单,但去年初夏我们运行评测时,Sonnet 4.6 在这项任务上 15 次尝试中只通过了 4 次,即使启用了技能也是如此。
我们的复盘显示,失败的运行中都出现了同样的模式:Sonnet 把我们 CLI 参考文档中的示例输出(其中列出了一个区域和两种 GPU 类型)当成了实时库存。它还跳过了区域查询,直接说出它认为最便宜的选项,却从未查看定价页面。
问题出在我们这边。首先,示例输出没有正确标注,因此没有任何信息告诉智能体去运行命令以获取相关数据。其次,我们的技能文件链接到的是 GPU 集群的营销页面,而不是定价表,于是 Sonnet 打开了营销页面,没有看到任何真实价格,就只是尽力猜测最便宜的可用 GPU。
能力更强的模型能够绕过这个问题。在同一时期,Opus 4.8 使用相同配置在 14 次尝试中通过了 13 次。根据对话记录,它注意到那个 list_regions 响应中没有包含价格,于是它继续搜索,直到在我们的文档中找到了价格。这就是为什么用能力较弱的模型测试你的产品至关重要;如果我们只用 Opus 测试,发现这个缺口会花上长得多的时间。
隔离故障
为了修复它,我们通过把 GPU 集群技能从完整技能包中单独抽出来隔离了故障,并写了一个更窄的提示词,只复现这个问题。针对旧技能文件测试时它每次都失败,因此我们有了可靠的重现步骤(使用旧技能),也有了测试每个新版本的简便方法(更新技能)。
我们经过了几轮迭代,最终确定了一个小改动:在技能中新增两句话,引导智能体前往定价表,并说明如何结合实时区域 API 使用它:
查询 GET <https://api.together.ai/v1/compute/regions> 或运行 tg clusters list-regions --json 以获取实时区域清单、支持的实例类型以及兼容的 CUDA/驱动组合。打开 GPU 集群定价表 查看当前的按需和预留费率。
这一改动之后,在我们测试的所有模型上,使用启用技能的配置时,该任务 100% 通过。
在我们的 API 中发现问题
同一个 GPU 任务还暴露了我们 API 中的一个问题。在最近的一次基线运行中,Opus 5.5 得到了未完成的判定,对话记录显示它撞上了两个并非模型过错的死胡同。
这次运行开局顺利。智能体调用 /v1/compute/regions 来获取区域和实例类型。随后,为了查找价格,它调用了 /v1/compute/instance-types,而 API 返回了 400 以及这条消息:
Region is required. Example: us-central-8。使用 /v1/clusters/regions 来获取区域列表。
于是智能体按照错误信息的指示去做了:
- 它用第一次查询得到的一个区域重试了请求。结果得到的不是实例类型,而是一个
404. - 它调用了
/v1/clusters/regions,错误信息建议的路由……但那个路由并不存在,所以它又收到了另一个404.
我们自己的错误信息把智能体引向了一条不存在的路由,而本应奏效的重试也失败了。开发者如果照着这条信息手动操作,同样会卡住。我们后来已经修正了错误信息,使其指向 /v1/compute/regions,以及第一个问题背后的路由缺陷。 404.
案例研究 2:重建我们的技能包
我们过去维护着14个独立的Together技能,每个产品界面一个。它们用起来很麻烦:你必须事先知道哪些技能适用于你的工作流程,然后逐个安装并调用。这些技能还相互重叠,重复着相同的SDK指南和设置说明,而且每个都足够长,以至于同时加载几个就可能让智能体的上下文膨胀。
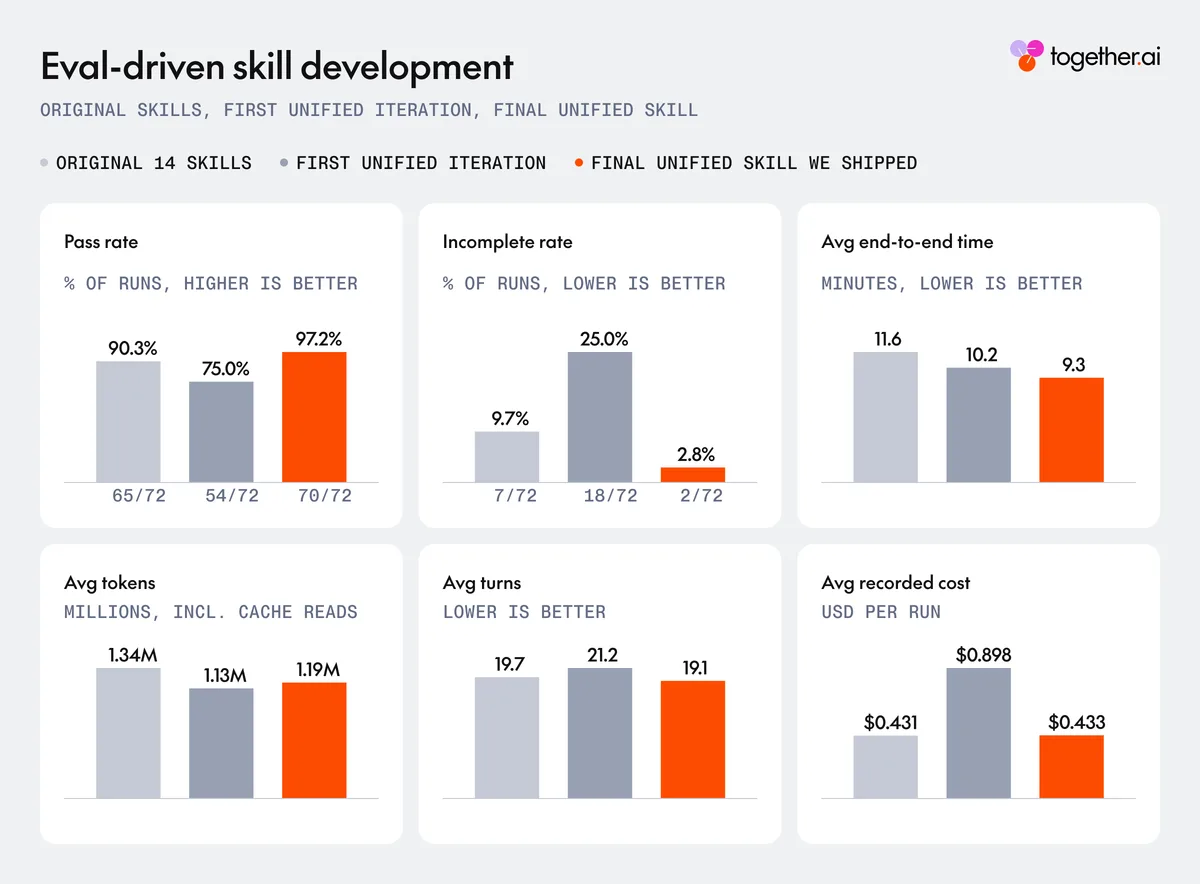
上个月,我们把这14个技能合并成了一个统一的版本。 。它在底层仍然是模块化的:为避免上下文膨胀,智能体先读取一个简短的路由器,只有当路由器判断相关时,才会打开各个产品指南、参考文件或示例脚本。我们希望一个技能能胜过 14 个技能,但为了确认,我们在启用技能的情况下用评测任务运行了这个统一技能。我们的基准是 9 月 30 日的结果,即使用 14 技能配置时所有运行的整体通过率为 90%。但新技能表现不佳——它只通过了 72 次运行中的 54 次(75%),还有 1它在底层仍然是模块化的:为避免上下文膨胀,智能体先读取一个简短的路由器,只有当路由器判断相关时,才会打开各个产品指南、参考文件或示例脚本。
我们希望一项技能就能胜过 14 项技能,但为了确认,我们在启用技能的情况下用评测任务运行了这个统一技能。我们的基准是 9 月 30 日的结果,即使用 14 技能配置时所有运行的整体通过率为 90%。
但这项新技能却失败了——它仅在72次运行中通过54次(75%),有18次未完成而非7次,且每次运行的成本是原来的两倍多。
于是我们梳理了评测记录,只在运行结果指向问题的地方修改了技能。有三个问题反复出现:
- 上下文过载: 第一个统一路由器大约有14,000个字符,会在每个任务中加载,并指示智能体完整阅读每一份指南。(这样一来,避免上下文膨胀的努力就白费了……)结果,运行结束时加载的技能内容比使用14个独立技能时多了57%。我们把路由器缩减到6,000个字符以下,并在每份产品指南末尾加了一个菜单,简要说明每个参考文件和脚本包含的内容,这样智能体就只打开自己需要的内容。
- 过时的产品信息: 代码示例中使用的一些模型已不再在无服务器平台上提供,还有一份产品指南涉及已弃用的功能。智能体白白浪费轮次去恢复或重试那些永远不会成功的请求。我们把每个示例都迁移到已确认可用的模型上,指示智能体改为检查目录而不是重试,并创建了一个云智能体,在产品变更时自动更新该技能。
- 示例代码中的缺陷: 脚本中的小问题,例如把 JPEG 字节保存在一个
.png名称,会让每个使用它们的智能体偏离正轨。我们在源头修复了这些问题,并添加了一项自动化,定期对代码示例进行实时测试,以保持其最新状态。
完成这些修复后,统一技能在 72 次运行中通过了 70 次,比我们第一次尝试高出 22 个百分点,也比我们最初使用的 14 个技能高出 7 个百分点。平均而言,运行耗时也比使用原始技能时减少了 20%,单次运行成本也回落到了最初的水平。
经过四个月的评测,我们目前所处的位置
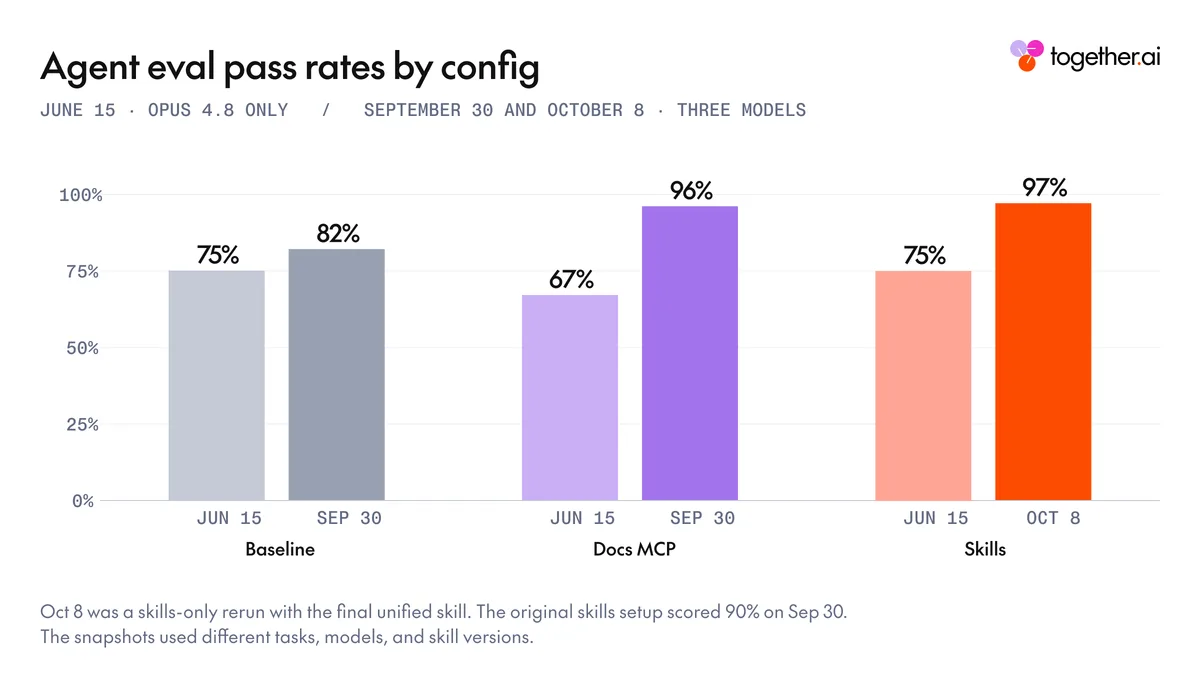
今年六月,我们的文档和技能对智能体的帮助微乎其微。6月15日,运行Opus 4.8时,基线通过了75%的运行。文档MCP(67%)和技能(75%)都没有提升表现。
到9月30日,在三个模型上,基线已攀升至82%。文档MCP达到96%,技能达到90%,而新的统一技能在10月8日达到了97%。
这并不是一次受控对比——这些快照使用了不同的模型和任务,因此其中一些提升无疑来自底层模型的改进,以及我们对 CLI 和 SDK 所做的改进。这大概能解释基线那 7 个百分点的上升,但引导式配置提升了 20 多个百分点,我们将这部分额外提升归功于评测所发现的文档和技能修复。
我们学到了什么
如果你只是快速浏览这篇文章,这里是 TL;DR:
- 智能体可访问性提升使用率: 像 GitHub 那样:开发者能通过网页 GUI 手动完成的一切,也应该能从你的 CLI 或 SDK 中以编程方式实现。我们发现智能体最适合搭配 CLI,因为 CLI 会通过帮助文本自我说明。说到这个——
- 文档是产品的核心部分: 如果你的平台没有准确的文档记录,或者你的文档无法被访问(例如通过 llms.txt、技能包或 MCP 服务器),那么你的平台对智能体来说可能无法使用。CLI 帮助文本和 API 错误信息也算在内,而这些通常是智能体遇到问题时最先查看的地方。
- 指引比使用哪个前沿模型更重要: 9月30日,三个模型(Claude Sonnet、Opus 和 GPT Sol)的成绩彼此相差仅几个百分点。加入我们的文档/技能后,通过率分别从 82% 提升到 96% 和 97%。
- 反过来,只使用强模型有时会掩盖问题: Opus 能够绕过我们 API 和技能包中的一个缺口,而 Sonnet 却一头撞了进去——我们正是通过这种方式发现并修复了这个问题。在运行评测时,请务必在能力谱系上对各个模型进行测试。
- 改进 AX 往往只需要做一点小修补: 我们在技能文件里加了两句话,就让 GPU 集群评测从 15 次中通过 4 次(Sonnet 的成绩)提升到三个模型全部 100% 通过。修复很小,但如果不是通过评测流程,我们可能永远都发现不了它。
运行你自己的评测
如果你在运营一个开发者平台,而智能体正在使用你的产品——或者至少它们肯定在尝试使用——那么了解情况进展如何的最佳方式,就是构建你自己的评测系统。
为了帮助解决这个问题,我们将用于构建评测的开源包公开。你创建一个任务列表(智能体提示词),并决定如何为你的运行评分(通过代码测试或 LLM 裁判)。该包会启动智能体、运行任务,并在本地仪表盘中跟踪所有内容,这样你就可以比较不同配置和过去的运行。它将于下周推出,同时还会有一篇关于如何使用它的博客文章。