人工智能
使用你的编码智能体迁移到 Amazon Bedrock Managed Knowledge Base在 Amazon Bedrock 上使用客户管理的知识库时,你需要为每个新数据源预置和扩展向量存储、调整嵌入模型和索引设置,并规划容量。Agent Toolkit for AWS 中的迁移指南可帮助你迁移到 Amazon Bedrock Managed Knowledge Base。Managed Knowledge Base 会接管这些工作并新增检索能力,而你的团队仍掌控内容以及使用该内容的应用。 迁移生产知识库意味着你的团队需要梳理其配置、创建替代知识库、摄取内容、更新应用的检索调用,并在切换流量前验证检索。为提供帮助,我们在 Agent Toolkit for AWS 的技能中新增了知识库迁移指南。该指南为你的编码智能体提供与你共同规划迁移所需的上下文,从只读发现和你逐行审阅的计划开始。在你批准后,智能体会在原知识库旁创建新的知识库及其数据源,或为你的流水线编写迁移后的基础设施即代码(IaC)模板。摄取内容以及更新应用的调用仍由你负责,你的智能体可以引导你完成这两项工作。在本文中,我们解释为什么 Amazon Bedrock Managed Knowledge BaseManaged Knowledge Base 会接管这项工作并新增检索能力,而你的团队仍掌控内容以及使用该内容的应用。
Agent Toolkit for AWS 的技能中。 amazon-bedrock 技能中新增了知识库迁移指南。 Agent Toolkit for AWS该指南为你的编码智能体提供与你共同规划迁移所需的上下文,从只读发现和你逐行审阅的计划开始。在你批准后,智能体会在原知识库旁创建新的知识库及其数据源,或为你的流水线编写迁移后的基础设施即代码(IaC)模板。摄取内容以及更新应用的 Retrieve 调用仍由你负责,你的智能体可以引导你完成这两项工作。
在本文中,我们解释为什么推荐这一迁移、迁移指南如何运作,回顾前提条件、安装该技能、规划迁移、更新应用的检索调用,并在切换前验证检索。
为什么要迁移到 Managed Knowledge Base
我们推荐使用 Managed Knowledge Base,因为它在易用性、检索准确性和成本之间取得了平衡。
AWS 负责运行该存储
借助托管知识库,Amazon Bedrock 负责摄取、存储、索引和检索,并且存储会随内容增长自动扩展。混合搜索结合了关键词匹配和语义匹配,始终开启,无需配置索引。该知识库包含托管嵌入模型、托管重排序器,以及针对多模态文件类型的内置解析器。
创建知识库时,你仍然可以自带 Amazon Bedrock 嵌入模型。在每次检索请求中,你可以选择托管重排序器、Amazon Bedrock 重排序模型,或不进行重排序。托管重排序器需要配合托管嵌入模型使用。
内置功能
托管知识库包含了你原本需要自行构建的能力:
- 原生连接器 直接从 Amazon Simple Storage Service(Amazon S3)、Microsoft SharePoint 和 Atlassian Confluence 等来源摄取内容。当前列表请参见 支持的连接器首次完整同步后,后续同步仅按需或按计划获取变更。Managed Knowledge Base 包含删除保护机制,有助于防止意外批量删除已索引内容。
- 访问控制列表(ACL)感知 会随内容一并摄取文档权限,因此检索只会返回已登录用户有权访问的内容。对于支持这一功能的连接器(例如 Microsoft SharePoint 和 Atlassian Confluence),还会对源进行实时检查,以捕获自上次同步以来发生的权限变更。ACL 感知不会对用户进行身份验证,因此你的应用程序必须验证并传递用户身份。
- 智能体检索 能够通过处理多部分问题并迭代检索,回答单次搜索无法回答的问题。它可以在单个请求中搜索多个知识库。
- 与 AgentCore Gateway 集成是 Amazon Bedrock AgentCore 的一项能力,可将你的知识库作为目标公开。任何支持模型上下文协议(MCP)的客户端随后都可以查询该知识库,而网关负责处理身份验证。
- 基于资源的策略 让其他 AWS 账户中的应用程序使用某个团队的知识库。将每个策略限定为调用该知识库的特定角色,并且只授予它们所使用的操作,例如
bedrock:Retrieve.
智能体检索、AgentCore Gateway 集成和基于资源的策略在客户托管知识库上不可用。有关提供托管知识库的 AWS 区域,以及 AWS GovCloud (US-West) 不支持的功能,请参阅 支持的 AWS 区域.
更高的配额
截至本文撰写时,更高的默认配额会改变你组织内容的方式。每个知识库支持 200 个数据源,因此你可以将相关内容归入同一个知识库。每个账户在每个区域支持 10,000 个知识库,因此每个团队或产品线都可以使用单独的知识库。
| 默认配额 | 客户托管 | 托管 |
| 每个账户、每个区域的知识库数量 | 100 | 10,000 |
| 每个知识库的数据源 | 5 | 200 |
| 每个知识库的并发摄取作业数 | 1 | 50 |
| 查询输入字符 | 1,000 | 10,000 |
有关当前值,请参阅 Amazon Bedrock 端点与配额 以及 托管知识库的服务配额.
按存储和检索量付费
成本是团队在考虑这一迁移时权衡的三件事之一,另外两件是可定制性和对向量存储的直接控制。在 客户托管知识库你可以自行选择、配置、扩展和更新向量存储与文本存储,并为你所选择的基础设施单独付费。而在托管知识库上,这些阶段都属于服务的一部分,存储和检索直接按用量计费。
定价模式也可能不同。对于客户托管知识库,存储和检索费用取决于你选择的向量存储。有些存储会对预置容量或最低容量收费,而另一些(例如 Amazon S3 的一项能力 Amazon S3 Vectors)则只按实际用量收费。托管知识库按你存储和检索的内容定价,因此成本与实际使用情况一致。按用量定价适合以低利用率运行的企业问答、政策和支持知识库。有关当前费率,请参阅 Amazon Bedrock 定价。有关客户托管知识库上可用的解析器以及每种解析器的计费方式,请参阅 数据源的解析选项.
| 成本驱动因素 | 客户托管知识库 | 托管知识库 |
| 向量存储 | 由你选择的存储单独定价。预置的检索服务即使在低用量下也可能产生最低闲置成本 | 包含在每月每 GB 5 美元的基础存储费率中 |
| 多模态文档解析 | 需要 Amazon Bedrock 数据自动化(按页或按图像计费),或基础模型(按 token 计费)。纯文本解析免费。 | 包含在每月每 GB 5 美元的基础存储费率中 |
| 嵌入生成 | 按你的嵌入模型费率单独计费 | 包含在默认模型中。仅当您选择自定义模型时才收取费用 |
| 摄取、同步和重新同步计算 | 重新嵌入、编排代码和索引计算会在每次同步时出现峰值,从而增加经常性成本 | 包含在内,增量同步仅处理新增和变更的内容 |
| 连接器 | 构建和运行自定义连接器会增加计算成本 | 原生连接器已包含在内 |
| 标准检索 | Amazon Bedrock 不按查询收费。你的向量存储可能会按查询收费,Amazon S3 Vectors 就是如此。 | 每 1,000 次检索请求收费 $1 |
| 重排序 | Amazon Rerank 按每 1,000 次查询 1 美元收费。自定义重排序模型按其自身费率计费 | 包含在每 1,000 次检索请求收费 $1 中 |
| 智能体检索 | 你在 Bedrock 模型上构建智能体工作流,在开发和维护之前,每 1,000 次查询的成本约为 18 至 24 美元。由于模型使用按 token 计费,每次查询的价格会有所不同。 | 在底层检索调用(包括多轮检索、重排序和答案生成)的费用之上,智能体检索每 1,000 次查询额外收费 4 美元。根据底层检索调用的次数,总费用大约在每 1,000 次查询 6 至 9 美元之间。 |
费率只是总拥有成本的一部分。在客户托管的知识库上,你的团队需要将每个阶段作为单独的资源进行预置、扩展和运营。Managed Knowledge Base 将它们整合为一个资源,并默认提供嵌入模型、基础模型和重排序器,且默认按知识库设置速率限制。你负责管理内容以及使用该内容的应用程序,而 Amazon Bedrock 负责运营托管存储、嵌入模型、基础模型和重排序器。
解决方案概述
客户管理的知识库使用 VECTOR 类型,并使用你配置的向量存储。Managed Knowledge Base 使用 MANAGED 类型。迁移指南会指示你的智能体在迁移期间创建一个新的知识库,与原始知识库并存,且不修改或删除原始知识库。 MANAGED 在迁移期间,在不修改或删除原始知识库的前提下,与原始知识库并存。使用指南中的映射表,你的智能体会编写一份计划,列出哪些设置保持不变、哪些设置由 Managed Knowledge Base 以不同方式处理,以及你需要进行哪些应用程序更改。如图 1 所示,在你的团队摄取内容、进行验证并执行切换的过程中,原始知识库会继续处理每一个请求。
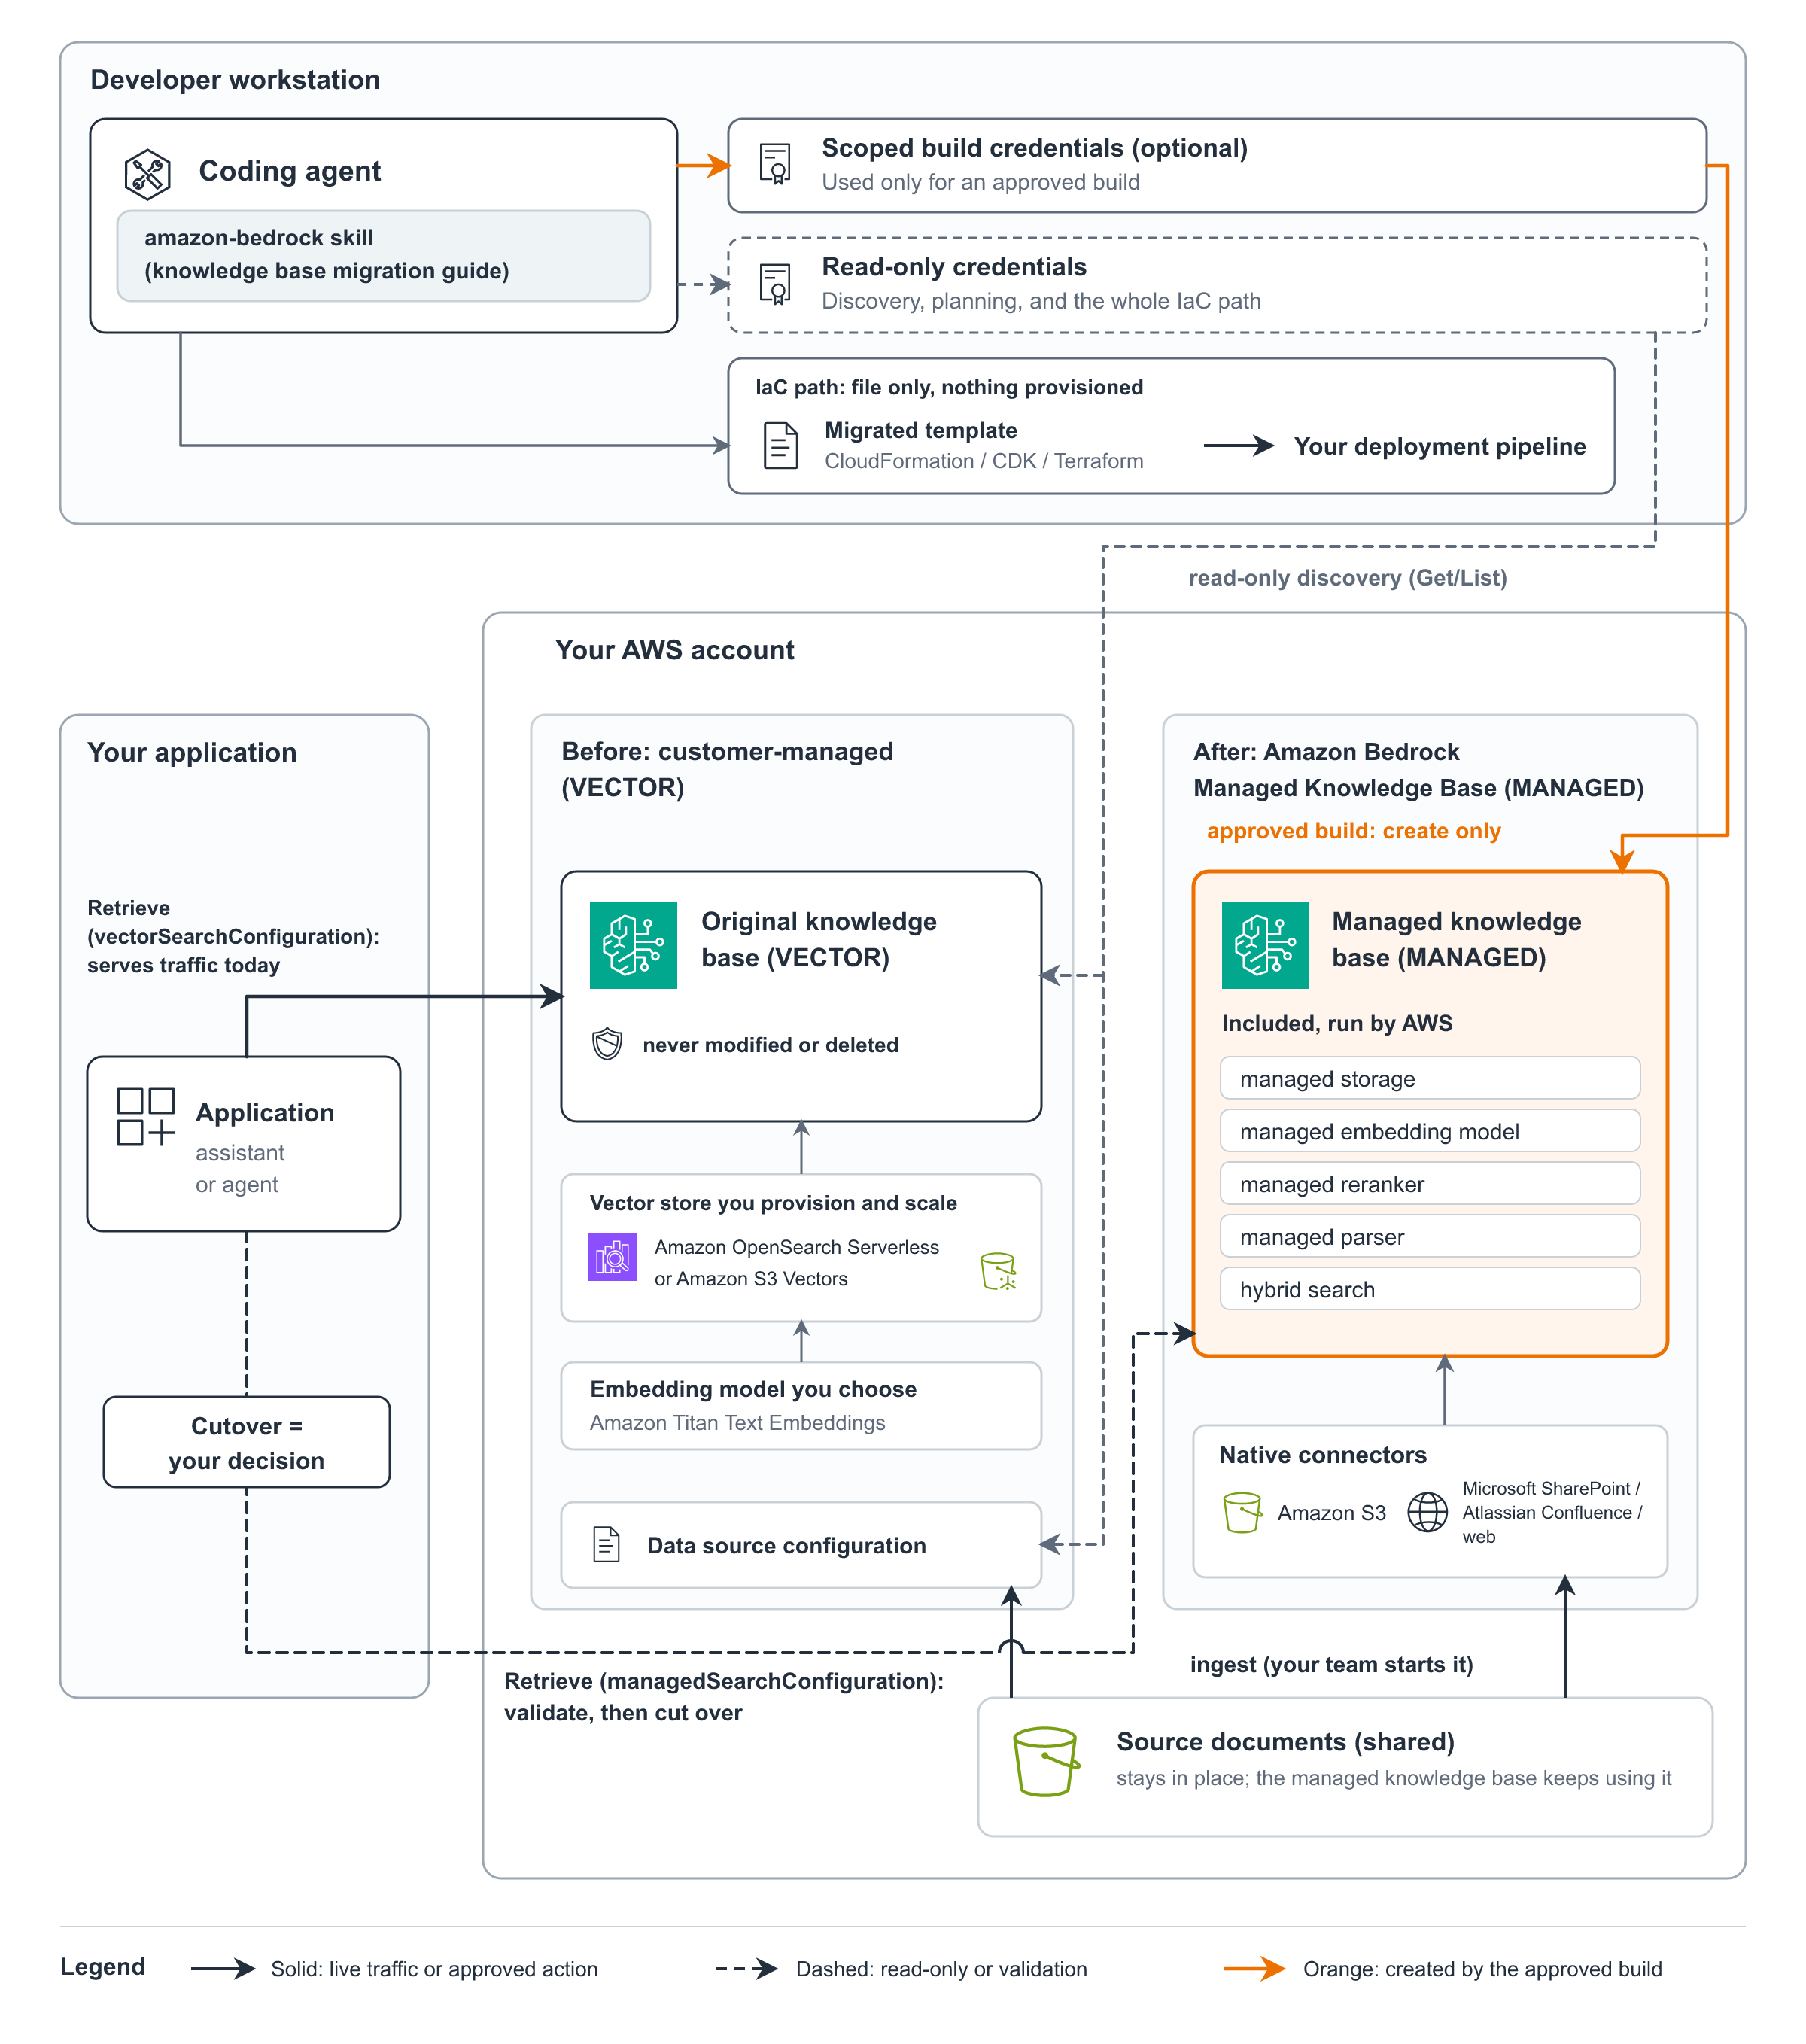
图 1:在原始知识库旁创建托管知识库或迁移模板,然后在切换前进行验证
迁移指南的工作方式
该指南将规划与实施分开。在 Explore 模式下,你的智能体回答有关 Managed Knowledge Base 的问题,并可通过只读调用检查你的配置,以便你估算工作量。在 Migration 模式下,该指南会带领你的智能体依次通过各个检查点:
- 介绍并选择。 你的智能体将说明它会处理哪些内容、不会触碰哪些内容。选择模式(实时知识库或 IaC 源),以及解释风格(简明(默认)或技术性)。
- 确认账户和 AWS 区域。你的智能体将标记权限过宽的凭证,询问你是否需要成本分析,并创建一个输出目录。发现。你的智能体通过只读调用读取知识库和数据源,或读取你的模板文件。规划。审阅计划和应用程序更改。默认情况下,你的智能体在此处停止。如被要求,则实施。对于实时构建,批准预置脚本的确切预览,如果脚本发生变化则再次批准。对于 IaC,你的智能体将编写 确认账户和 AWS 区域。你的智能体会标记权限过宽的凭证,询问你是否需要成本分析,并创建一个输出目录。
- 发现。 你的智能体通过只读调用读取知识库和数据源,或读取你的模板文件。
- 规划。 审阅计划和应用程序更改。默认情况下,你的智能体在此处停止。
- 如被要求,则实施。 对于实时构建,批准预置脚本的确切预览,如果脚本发生变化则再次批准。对于 IaC,你的智能体将编写迁移后的模板,并报告运行了哪些架构检查。
- 交接。 审阅已生成的内容以及你的团队剩余的步骤。
如图 2 所示,资源创建与摄取和切换保持分离。
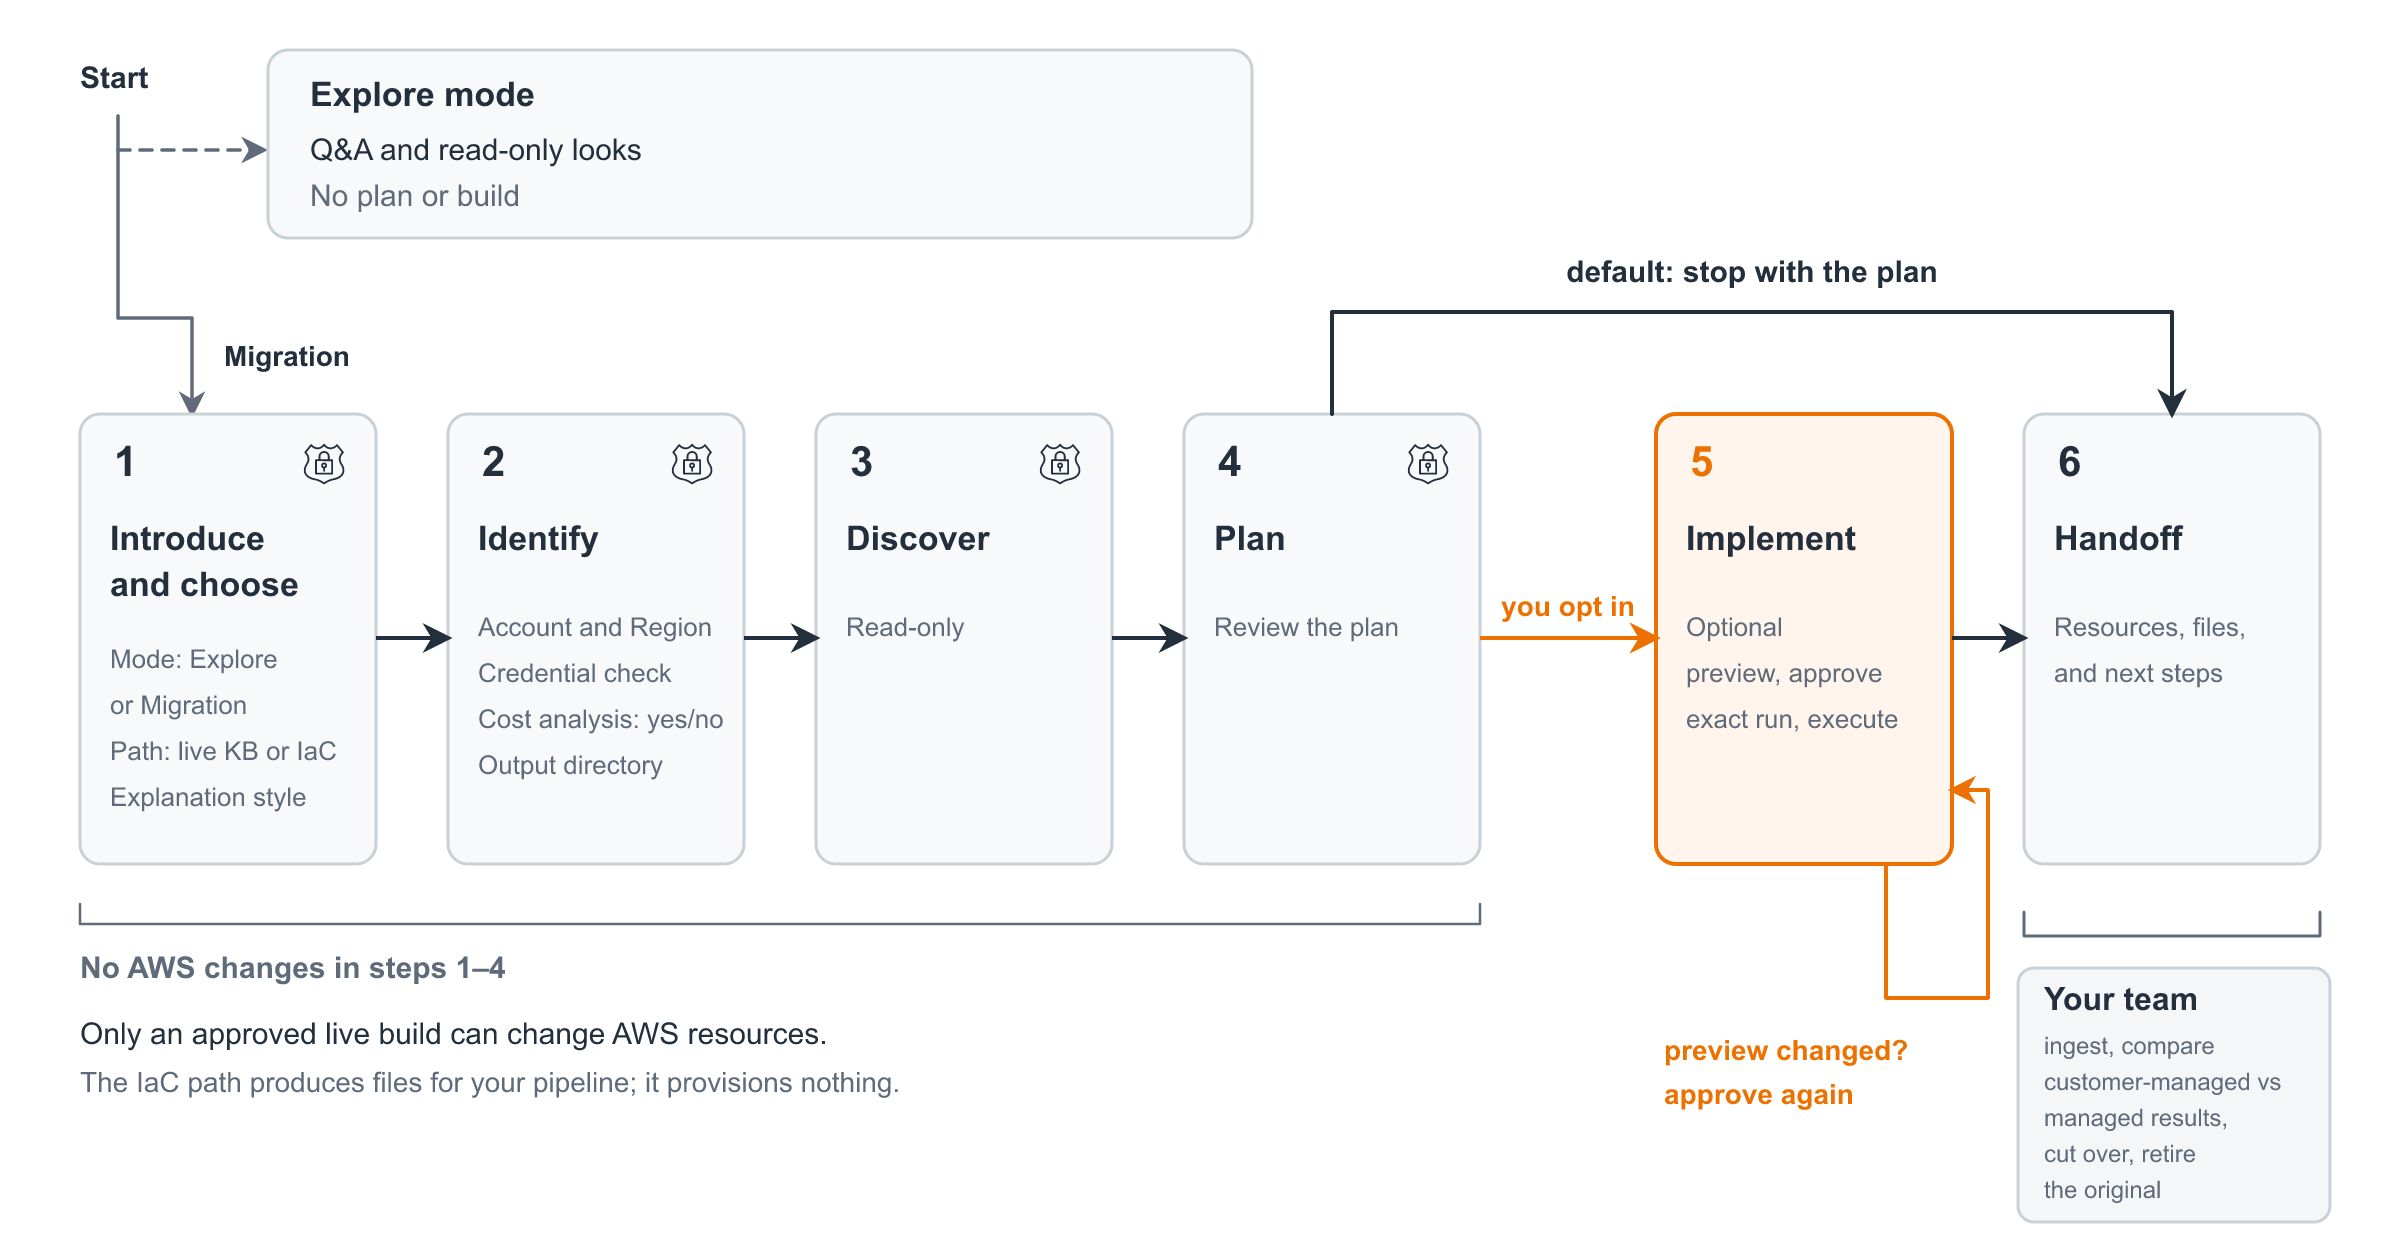
图 2:迁移检查点。实施是可选的,由你的团队负责摄取和切换。
审阅配置映射
该指南会映射每一项设置,以便在托管类型使用不同配置时保留你的数据源、筛选条件和分块行为。该计划会对每一项设置进行分类:
- 1:1. 新的知识库使用相同的设置。
- 已调整。 Managed 对同一结果使用不同的设置,而计划会应用这种替换。
- 已阻止。 目前没有托管路径。你的智能体会将该知识库排除在构建之外,说明原因,并指引你联系 AWS Support。同一次运行中的其他知识库可以继续。
在验证时,请在你自己的内容上比较分块效果。
审阅权限和生成的更改
发现、规划和整个 IaC 路径只需要只读凭证。对于实时构建,指南会指示你的智能体提出一项限定范围的策略,明确拒绝对原始知识库的更改,并且绝不请求管理员或完全访问权限。它还会指示你的智能体只更改其创建的资源,通过 Amazon Resource Name (ARN) 引用密钥,并忽略其读取的数据中发现的指令。在批准运行之前,请审阅生成的 AWS Identity and Access Management (IAM) 策略和预置脚本。构建完成后,请在 AWS CloudTrail 事件历史记录,它会保留 90 天的管理事件。每个事件都会记录 API 调用,例如 CreateKnowledgeBase以及造就它的身份。
对于可选的成本分析,你的智能体会使用当前 AWS 价格,将当前支出与 Managed Knowledge Base 估算值进行比较。它使用只读输入,包括 Amazon CloudWatch 指标、Amazon S3 对象大小和 AWS Cost Explorer。每个数字都会标注为实测、由你提供或估算。
先决条件
规划与任何已获批准的资源配置请使用单独的凭证。
- 与 Agent Toolkit for AWS 兼容的开发环境。
- AWS 命令行界面(AWS CLI),并配置了最小权限的只读配置文件。
- 访问原始知识库配置或其 IaC 文件。
- 对于可选的实时构建:
- 使用指南所推荐的策略的限定范围构建配置文件。
- 用于新知识库的 IAM 服务角色。指南会为你的智能体提供信任策略和权限,以帮助你创建该角色。
- 用于生成预置脚本的 Python 3 与 boto3。
适用于 AWS 的 Agent Toolkit 可与兼容的开发环境配合使用,其 GitHub 上的仓库 列出了可用的技能。本文中的示例使用 AWS CLI 2.37 和 boto3 1.43.32。
安装该技能
请遵循 适用于 AWS 的 Agent Toolkit 入门说明 供你的编码智能体使用。该 add-skill 命令会将其安装到检测到的编码智能体中。 amazon-bedrock 添加 --agent 以定位到一个目标,例如 --agent kiro.
aws agent-toolkit add-skill \
    --skill-name amazon-bedrock
安装完成后,当你描述迁移任务时,你的智能体会加载迁移指南。以下提示是示例输入,并非对话记录。
规划迁移
选择与您维护源的方式相匹配的路径。
| 路径 | 你的智能体读取的内容 | 它会生成什么 | AWS 变更 |
| 探索 | 文档,以及可选的知识库(只读) | 对话中的答案 | 实时知识库你的知识库和数据源(只读)一份计划,以及可选地在原始知识库旁新建一个 Managed Knowledge Base仅在你批准确切的预览之后基础设施即代码你的 AWS CloudFormation 模板、AWS Cloud Development Kit(AWS CDK)合成模板或 Terraform 配置以相同格式迁移的模板无。你的流水线会部署它要从 Explore 模式开始,请提出一个问题:准备好后,选择实时或 IaC 路径。迁移实时知识库 |
| 实时知识库 | 你的知识库和数据源(只读) | 一份计划,以及可选地在原始知识库旁新建一个 Managed Knowledge Base | 只有在你批准确切的预览之后 |
| 基础设施即代码 | 你的 AWS CloudFormation 模板、AWS Cloud Development Kit(AWS CDK)合成模板或 Terraform 配置 | 以相同格式迁移的模板 | 无。你的流水线会部署它 |
要开始使用 Explore 模式,请提出一个问题:
What would change if I moved knowledge base <your-kb-name>
in <your-region> to a Managed Knowledge Base? Use Explore mode.
准备好后,选择实时或 IaC 路径。
迁移实时知识库
在授权创建资源之前,先要求提供一份计划:
Plan a migration of knowledge base <your-kb-name> in <your-region>
to a Managed Knowledge Base. Stop after the plan.
确认账户和区域,然后审阅计划的映射关系和应用变更。默认情况下,新知识库会沿用原知识库的名称,并附加一个 -managed 后缀。要构建它,请确认服务角色存在,切换到构建配置文件,检查预置脚本及其预览,然后批准。你的智能体会运行该脚本,创建知识库和数据源,并报告它们的状态。
迁移基础设施即代码
将你的智能体指向源模板或配置:
Review <path-to-source-template> and plan a migration to a
Managed Knowledge Base.
你的智能体将迁移后的文件写入输出目录,不部署任何内容,并向你展示差异。若要保留该差异,请让你的智能体将其保存。运行 terraform init -backend=false ,并在部署前运行 terraform validate 部署前。你的智能体可以引导你完成这两条命令,但指南将这两项检查留给你,因为 terraform init 会下载大型 AWS provider。在应用部署计划之前,请检查它是否保留了回滚所需的原始资源。
迁移以对话方式进行。在读取任何内容之前,你的智能体会说明其范围并询问如何继续:计划摘要会显示每个映射、调用方变更以及你需要做出的决定:对于实时构建,你的智能体会在预览处停止,而批准命令需要计划的哈希值:示例对话经过轻微编辑,标识符已替换。更新应用程序的检索调用你的应用程序对两种类型使用相同的操作。托管请求以 n 为目标
迁移以对话方式进行。在读取任何内容之前,你的智能体会说明其范围并询问如何继续:
It never changes or deletes <your-kb-id>, never starts ingestion,
and never cuts your application over; every AWS change is shown to
you and approved first. Nothing has run against your KB yet.

1. Mode: Explore (read-only Q&A about Managed KBs and your KB, no
   plan or build) or Migration (run the phases: identify, discover,
   plan, and optionally build)?
2. Target type, if Migration: migrate the live KB <your-kb-id> (kb
   path, which can build a new Managed KB on approval), or migrate
   the Terraform/CloudFormation that defines it (iac path, which
   only emits a migrated file and provisions nothing)?
3. Explanation style: plain or technical. I'll use plain unless
   you say otherwise.
计划摘要会显示每个映射、调用方变更以及你需要做出的决定:
Phase 3, Plan: written (plan.md)
- Mapping:
  - Vector store becomes auto-provisioned (adjusted, Yes).
  - SEMANTIC chunking is dropped for the managed default
    (adjusted, Partly).
  - Parsing becomes SMART_PARSING (adjusted, Yes).
  - The S3 prefix and metadata sidecars carry over 1:1.
- Changes for callers:
  - New KB id.
  - managedSearchConfiguration replaces vectorSearchConfiguration.
  - overrideSearchType: SEMANTIC can't be sent; search is hybrid.
Your input needed before this can go further.
- D1 embeddingModelType: MANAGED (recommended): keeps the managed
  reranker. CUSTOM Titan v2 1024/FLOAT32: turns off the managed
  reranker.
- D2 aclEnabled: recommend false, since the source has no ACLs.
  On S3 this can't be changed after create.
- Next step: stop with this plan (the default), or opt into Phase 4?
对于实时构建,你的智能体会停在预览阶段,而批准命令需要计划的哈希值:
If you approve, the command to run is the following. It is MUTATING:
  AWS_PROFILE=build-profile AWS_REGION=<your-region> \
    python3 provision_managed_kb.py --execute \
    --expect-plan-sha256 <plan-sha256>
--execute refuses to start unless it is given --expect-plan-sha256
and the hash matches.
What the preview would create:
- Knowledge base (CreateKnowledgeBase, MANAGED): support-docs-managed
- Data source (CreateDataSource, managed connector, deletion
  protection ENABLED/15): support-docs-s3-managed
The script never calls StartIngestionJob, Retrieve, Update*,
Delete*, or a standalone TagResource.
示例对话经过轻微编辑,标识符已替换。
更新应用程序的检索调用
你的应用程序对两种类型使用相同的 Retrieve 操作。托管请求以新的知识库 ID 为目标,并替换 vectorSearchConfiguration ,并替换 managedSearchConfiguration迁移到托管知识库会返回验证错误。 vectorSearchConfiguration 迁移到托管知识库会返回验证错误。托管检索始终使用混合搜索,因此托管请求结构没有 overrideSearchType 和 运算符。完整语法请参阅 Retrieve API 参考。该示例假设两个知识库都包含筛选器所使用的 元数据。验证检索并切换在应用程序仍使用原知识库时评估新知识库。如果使用 IaC,请通过你的流水线审阅并部署目标配置。同步每个数据源并审阅任何失败。请参阅同步数据源。在新知识库 ARN 上为应用程序的运行时 IAM 角色授予 ,并保留其访问权限 startsWith 以及 stringContains 运算符。完整语法请参阅 检索 API 参考.
该示例假设两个知识库都包含筛选器所使用的 locale 筛选器所使用的元数据。
# Illustrative: the managed request shape was checked with boto3 1.43.32; adapt the IDs and filter to your knowledge base.
import boto3

client = boto3.client("bedrock-agent-runtime")
query = {"text": "How do I return an online order?"}
locale_filter = {"equals": {"key": "locale", "value": "en-US"}}

# Customer-managed (VECTOR) knowledge base.
original_response = client.retrieve(
    knowledgeBaseId="<original-kb-id>",
    retrievalQuery=query,
    retrievalConfiguration={
        "vectorSearchConfiguration": {
            "numberOfResults": 5,
            "overrideSearchType": "SEMANTIC",
            "filter": locale_filter,
        }
    },
)

# Managed target: different ID and search configuration.
managed_response = client.retrieve(
    knowledgeBaseId="<managed-kb-id>",
    retrievalQuery=query,
    retrievalConfiguration={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
            "filter": locale_filter,
        }
    },
)
验证检索并切换
在应用程序仍使用原知识库时评估新知识库。
- 如果使用 IaC,请通过你的流水线审阅并部署目标配置。
- 同步每个数据源并审阅任何失败。请参阅 同步你的数据.
- 为新知识库 ARN 上的应用程序运行时 IAM 角色授予权限,并保留其对原知识库的访问权限,以便回滚。
bedrock:Retrieve为新知识库 ARN 授予权限,并保留其对原知识库的访问权限,以便回滚。 - 使用该角色对两个知识库运行代表性查询。
Retrieve,并使用该角色。这两种类型使用不同的分数刻度。托管分数还取决于rerankingModelType,其默认值为MANAGED使用托管嵌入模型,并NONE并使用自定义阈值。按模式调整阈值,并在比较时保持模式不变。 - 测试元数据筛选器和权限感知检索(在适用处),包括已登录用户不应接收的内容。在启用了 ACL 的数据源上,不带
userContext.userId(用户的电子邮件)不返回任何结果。 - 接受后,部署新的知识库 ID 和请求结构。在回滚期内,保留原始知识库(含当前内容)以及应用程序配置。
对于每个查询,检查两者是否返回相同的顶部文档,以及结果重叠程度如何。一个简短的脚本可以根据以下标准报告通过或失败,例如至少 90% 的查询顶部文档匹配,以及托管知识库上没有零结果查询。请根据你的工作负载调整该阈值。有关其他检索质量指标,例如上下文相关性和上下文覆盖度,请参阅 使用指标来了解 RAG 系统的性能.
比较结果时,请注意以下差异:
- 比较前先规范化源位置。 客户自管的知识库可以返回
s3://bucket/key,而托管知识库可以返回一个 URL。按对象键进行比较。比较顶部结果,而不是假设结果数量相等。两种知识库类型可能返回不同数量的结果,而 设置的是上限而非保证。比较顶部文档,并逐一审阅每个结果发生变化的查询。详情请参阅 为托管知识库配置和自定义查询。映射重命名的系统元数据键。例如,在比较代码中将 替换为 。你自己的元数据属性location.s3Location.uri,而托管知识库可以返回一个https://URL。按对象键进行比较。 - 比较顶部结果,而不是假设结果数量相等。 这两种知识库类型可能返回不同数量的结果,而
numberOfResults设置的是上限而非保证。比较顶部文档,并逐一审阅每个结果发生变化的查询。详情请参阅 为托管知识库配置和自定义查询. - 映射重命名的系统元数据键。 例如,在比较代码中将 替换为 。
x-amz-bedrock-kb-data-source-id替换为_data_source_id在比较代码中。你自己的元数据属性保留其名称。详情请参阅 为托管知识库配置和自定义查询.
清理
如果完成迁移,请在回滚期结束并完成依赖关系审查后,再停用原始知识库。保留托管知识库从中摄取数据的源文档和存储桶,以及其他工作负载使用的存储。通过其所属模板清理由 IaC 管理的资源。
如果你改为结束评估,请保留原始资源,并按以下顺序删除你创建的资源:
- 删除每个托管数据源,并等待其完全删除。
- 删除托管知识库,并等待其完全删除。
- 如果你仅为本次评估创建了服务角色,请先删除其内联策略,然后删除该角色。
- 对于客户管理密钥,请检查 Amazon Bedrock 创建的授权,这些授权在知识库删除后可能仍然存在。保留其他知识库仍在读取的任何 S3 存储桶。托管数据源上的删除保护限制的是单次同步可以删除的数据量,而不是你能否删除该数据源。删除原始知识库不会删除其向量存储,在你移除它之前,该向量存储会继续产生费用。请参阅删除 Amazon Bedrock 知识库。结论借助 Amazon Bedrock Managed Knowledge Base,你的 t
aws kms list-grantsAmazon Bedrock 创建的授权,这些授权在知识库删除后可能仍然存在。 - 保留其他知识库仍在读取的任何 S3 存储桶。
托管数据源上的删除保护限制的是单次同步可以删除的数据量,而不是你能否删除该数据源。删除原始知识库不会删除其向量存储,在你移除它之前,该向量存储会继续产生费用。请参阅 删除 Amazon Bedrock 知识库.
结论
借助 Amazon Bedrock Managed Knowledge Base,你的团队不再需要运行向量存储或管理底层检索基础设施。借助迁移指南中的 amazon-bedrock 技能,你向你的智能体索取一份计划,审阅它,并且只批准你希望构建的资源。
首先,请设置 Agent Toolkit for AWS 并向你的智能体索取一份对知识库的只读评估。迁移完成后,探索 智能体检索 以获取多部分问题的解答。如需了解更多信息,请参阅 使用 Amazon Bedrock Managed Knowledge Base 为智能体构建企业搜索 在 AWS 机器学习博客上。