 AI 热点

- 现在每个模型都能读取文本,因此我们按结构能力排名
- 最佳表格 OCR 模型:分数差距出现在哪里
- 嵌套表头、合并单元格和长表格
- 图表就是没有网格线的表格
- 会改变含义的格式
- 托管式 OCR API:你的每页费用究竟买到了什么
- 搭载 OCRia-1 的 LlamaParse
- Reducto
- Extend
- Azure 文档智能
- Google Document AI
- AWS Textract
- Mistral OCR 4.1
- Unstructured
- 前沿 VLM 表格读取能力出色,收费也与之相称
- 值得自行托管的开放权重模型
- 对于表格密集型文档,专用模型如今也是便宜的选择
目前最适合表格、图表和复杂结构化文档的 OCR 模型是专用文档解析器,其中表现最强的是 OCRia-1——这款拥有 40 亿参数、运行于 LlamaParse中的模型。它在 ParseBench 的表格维度获得 91.5 分,并且 在表格评测中领先 四项基准,其中三项由 LlamaIndex 以外的机构构建。
如果你的页面大多是纯文本,其他选择在价格上更占优势。AWS Textract 和 Google Document AI 均能以每 1,000 页 1.50 美元的价格读取文本,而 Azure 文档智能支持的印刷体语言数量在三大云服务商中最多。必须自行托管的团队可以通过企业版方案,在自己的云账户或数据中心运行 LlamaParse,也可以从 LightOnOCR-3 或 Chandra OCR 2 等开放权重模型入手。
纯文本已不再是这些模型拉开差距的地方。在 ParseBench 的内容忠实度评分中,OCRia-1、dots.mocr 和 Mistral OCR 4.1 在 OCRia-1 技术报告中均获得 0.90 分。差距出现在结构处理上:横跨三列的表头、保险承保明细表中的合并单元格、没有数值标签的堆叠条形图。本排名衡量的正是这些能力,而多数“最佳 OCR”榜单恰恰在这里止步。
| 模型或 API | 最适合 | ParseBench 综合得分/表格得分 | 语言 | 托管服务 p50 延迟 | 每 1,000 页标价 | 集成方式 |
|---|---|---|---|---|---|---|
| LlamaParse(OCRia-1) | 表格、图表、金融和保险申报文件 | 82.83/90.90(智能体档) | 支持多种语言,未公布具体列表 | 2.2 秒 | 3.75 至 4.50 美元(经济档),12.50 至 15 美元(智能体档) | Python 和 TS SDK、REST、Web UI、VPC 或本地部署 |
| Extend | 带审核层的提取 | 73.50 / 85.26 | 未公布 | 未公布 | 5 至 20 美元 | API、自带云(BYOC)或混合部署 |
| Reducto | 带边界框的引用 | 70.87/80.20(智能体档) | 未公布 | 未公布 | $10 | REST、异步作业、Webhook |
| Mistral OCR 4 | 便宜、快速,适合文本密集型页面 | 58.38 / 74.03 | 170 | 1.8 秒(4.1) | 4 美元(批处理 2 美元) | API、Python 和 TS SDK |
| Azure 文档智能 | 语言覆盖范围 | 56.76/85.97(布局) | 约 300 种印刷体语言、12 种手写体语言 | 未公布 | 读取约 1.50 美元,布局约 10 美元 | SDK、Studio UI |
| AWS Textract | AWS 内的纯文本 | 48.31 / 84.46 | 40 多种印刷体语言(表单支持 6 种) | 未公布 | 文本 1.50 美元,表格 15 美元 | AWS SDK、控制台 |
| Google Document AI | GCP 上广泛的语言覆盖 | 48.66 / 54.95 | 200+ | 未公布 | OCR 1.50 美元,布局解析器 10 美元 | GCP SDK、Workbench |
| LightOnOCR-3 4B(开放权重) | 快速自行托管 | 75.60 / 83.63 | 未公布 | 自行托管 | GPU 成本 | Hugging Face、vLLM |
| Chandra OCR 2(开放权重) | 自行托管的表格处理 | 70.59 / 89.20 | 90+ | 自行托管 | GPU 成本,或使用 Datalab API | Hugging Face、Datalab API |
ParseBench 分数来自 公开排行榜 (读取于 2026 年 11 月 2 日),其中“综合”是包括视觉定位在内的五个维度的平均分。延迟数据是 OpenDocRouter 的模型页面所列的典型页面 p50。价格均为各供应商公布的标价。LlamaParse 的价格区间从专业版费率(每 1,000 个积分 1.25 美元)到按量付费费率(1.50 美元)不等。Azure 的数据来自微软的语言表格和问答页面,因为其费率表未能正常呈现。
现在每个模型都能读取文本,因此我们按结构能力排名
本排名主要依据 ParseBench,这是由 LlamaIndex 构建并发布的一项基准测试。它涵盖约 2,000 个经人工核验的页面,取自保险 SERFF 申报文件、财务报告和政府文件,并依据超过 169,000 条测试规则评分,过程中不使用 LLM 评审。它评估五个维度:表格、图表、内容忠实度、语义格式和视觉定位。我们通过同一套测试框架对所有供应商进行了评测,包括 Reducto、AWS Textract 和 Claude,结果以公开 CSV 的形式发布在 GitHub上。该基准、相关论文和 OCRia-1 报告均可在我们的 研究页面.
查看。由供应商为自己的模型评分存在利益冲突,因此我们使用三套并非由 LlamaIndex 构建的 OCR 准确率基准 套件核查了每一项表格相关结论:
- olmOCR-bench 由艾伦人工智能研究所推出,包含针对 1,403 个页面的 7,010 项通过/失败单元测试
- PulseBench-Tab 由 Pulse 推出,包含九种语言的 1,820 个经人工标注的表格
- fr-bench-pdf2md 由 Pulsia 推出,包含 721 个经过刻意设计、难度较高的法语页面
我们使用相同的页面渲染方式,亲自让每个模型运行了全部四套测试, 发布文章中的图表 展示的就是这些测试结果。“由 LlamaIndex 以外的机构构建”是指数据集和测试规则均为公开内容,且并非由我们制作;ParseBench 的数据集、评分代码和结果 CSV 也全部开放,因此本文引用的每次测试都可以复现。唯一完全没有经过我们参与的核查是 Unstructured 的基准测试,其自有流程位居榜首,而 LlamaParse 以 0.835 分成为其他供应商中表现最佳者,领先于得分 0.812 的 Reducto。对于本文中的每个数字,还需遵循一条解读原则:几分之差属于不同测试集之间的误差范围(同一模型在不同轮次中的得分也会相差几分),因此应将接近的分数视为并列,并根据您自己的页面做出选择。
我们有意未纳入 OmniDocBench。如今其最高分都集中在 95 分稍上的区间(PaddleOCR-VL-1.6 为 96.3,MinerU 2.5-Pro 为 95.69),不适合用来区分领先者;我们曾在以下文章中分析过这一问题: OmniDocBench 已趋于饱和.
其他各列遵循简单规则。每页 OCR 价格采用各供应商公布的标价,并以每 1,000 页为单位显示。仅在供应商公布语言数量时列出语言覆盖范围;仅在有人基于托管基础设施进行测量时列出延迟。供应商自行开展的基准测试仅作为背景信息,绝不作为主要评分。还需注意一点:OCRia-1 发布时公布的数字是四个维度的平均值,且未包含视觉定位,因此我们在下方为其单独制表,而没有将其与排行榜共用一列。除 OmniDocBench 外,我们还特意排除了一类产品:平台型智能文档处理(IDP)套件(ABBYY Vantage、Hyperscience、Tungsten TotalAgility)采用企业合同定价,而非按页计费,并且未出现在本排名所依据的任何公开排行榜中,因此我们没有将其纳入。
最佳表格 OCR 模型:分数开始拉开差距的领域
从 PDF 中提取表格,正是这些模型表现开始出现分化的任务。发布文章使用相同的页面渲染方式,通过同一套测试框架评测了每个模型,因此这是目前最可靠的直接对比:
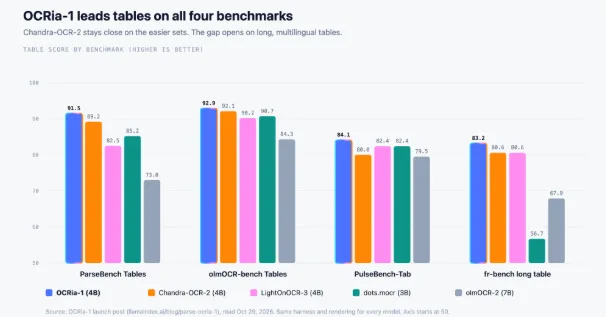
Chandra-OCR-2 在此同样值得肯定。它在 ParseBench 表格维度上落后 OCRia-1 2.3 分,在 olmOCR-bench 表格维度上落后 0.8 分;差距足够小,换用一个测试集就可能逆转排名,不过在采用 1,288px 页面渲染的 olmOCR-bench 表格维度上,两者相差 6.2 分。随着表格难度提高,差距会进一步扩大。
嵌套表头、合并单元格与长表格
一份财务报表中,“2025”横跨三个季度列;或一张保险责任表中,一项免赔额适用于四行——只有解析器保留这些关系,表格才能正确呈现。漏掉其中任何一个关系,得到的转录结果就会数字全对、比较关系全错。在 fr-bench 的第二个长表格类别中,OCRia-1 得分 81.9,Chandra 得分 77.8。在 PulseBench-Tab 上,它完整复现了 1,820 个表格中有 485 个被完美复现,而排名第二的模型为 431 个(技术报告)。关于这一机制,我们曾在一篇文章中介绍过: 表格 OCR.
图表就是没有网格线的表格
整个数据集中差距最大的是图表维度。OCRia-1 在 ParseBench 的图表维度得分为 85.1,排名第二的模型得分为 66.1,而 dots.mocr 和 Surya OCR 2 分别仅得 0.1 和 1.2。传统 OCR 会读取坐标轴标签和图例,却丢掉柱形。OCRia-1 则会返回包含各数据点的 HTML 表格,将每个数值置于正确的系列和标签之下;这也是唯一真正能够用于数值运算的形式。
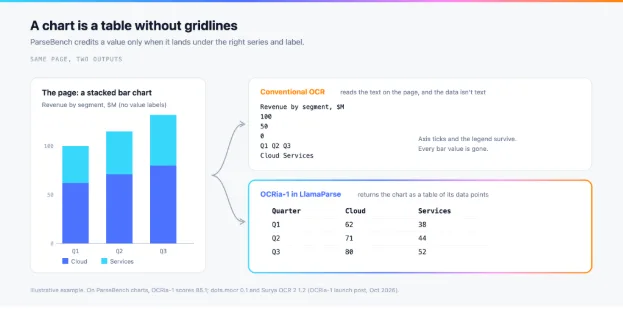
ParseBench 只有在图表数值位于正确的行标题和列标题之下时才会计分,因此模型无法靠堆砌看到的所有数字来得分。关于这一任务为何如此困难,详见《从图表中提取数据》。 从图表中提取数据.
改变含义的格式
上标、删除线和复选框看似只是装饰,直到其中某一项缺失。收入项目上的脚注标记、合同中被划掉的条款,或理赔表上未勾选的复选框,都会改变文档表达的含义。OCRia-1 会在 Markdown 和 HTML 中保留这些标记,并用 LaTeX 编写数学公式;其 ParseBench 格式维度得分为 83.4,而排名第二的系统为 67.9。
这正是传统 OCR 和超大规模云服务商 API 通过对结构化解析单独收费而掩盖的差距。Textract 读取文本的价格为每 1,000 页 1.50 美元,而 表格解析则收费 15 美元;在 ParseBench 上,其格式维度得分为 4.65。布局感知解析会将网格、图表数据和行内标记本身视为输出,因此你无需事后重新构建它们。
托管式 OCR API:你的按页付费究竟能买到什么
大多数团队以 API 形式购买 OCR 服务,因此在 OCR 模型对比中,这一部分将按页价格与得分放在一起考量。以下得分来自 ParseBench 排行榜。若你要比较解析器的结构化处理能力,我们的 顶级文档解析 API 汇总文章则更广泛地介绍了集成细节。
搭载 OCRia-1 的 LlamaParse
最适合: 表格、图表,以及将两者结合在一起的混合型金融与保险申报文件。OCRia-1 默认运行于 LlamaParse 的 cost_effective 层级(每页 3 个积分;Pro 套餐每 1,000 页 3.75 美元,按量付费则为 4.50 美元)和 agentic 层级(10 个积分;每 1,000 页 12.50 美元或 15 美元),每当你请求时 version="latest",如层级文档中所述 层级文档。无需设置模型名称,价格也没有变化。唯一的例外是使用自定义提示词的作业,它会改为路由至通用模型。在排行榜上,LlamaParse 的 Agentic Plus 层级(每页 25 个积分,每 1,000 页 31.25 美元起)在全部 155 个参评项目中总体得分最高(86.69),Agentic 层级则为 82.83。
表格会以 HTML 形式返回到解析后的输出中,并完整保留表头行,因此无需使用正则表达式即可加载到 dataframe 中:
from io import StringIO

import pandas as pd
from llama_cloud import LlamaCloud

client = LlamaCloud()  # reads LLAMA_CLOUD_API_KEY from the environment
file = client.files.create(file="10-q-financial-statements.pdf", purpose="parse")
result = client.parsing.parse(
    file_id=file.id,
    tier="cost_effective",  # OCRia-1 runs here and on agentic with version="latest"
    version="latest",
    expand=["markdown"],
)

for page in result.markdown.pages:
    if "<table" not in page.markdown:
        continue
    for table in pd.read_html(StringIO(page.markdown)):
        print(f"page {page.page_number}: {table.shape[0]} rows x {table.shape[1]} cols")
        print(table.head(4).to_string(index=False))
我们用 OCRia-1 技术报告中的一个基准测试结果页面进行了测试。它成功返回了两个 9×10 的结果表格,所有分数均与原始内容一致。在托管环境中,每页延迟中位数为 2.2 秒。在一块 B200 GPU 上同时处理 64 个请求时,该模型可持续达到每秒 10.21 页,约合每天 860,000 页。对于报表密集型工作负载,请参阅 财务报表 OCR 和 保险文档自动化 页面。
你也可以在我们的 SaaS 之外运行 LlamaParse。企业版套餐支持将其部署到你自己的 AWS、Azure 或 Google Cloud 账户中,也可部署在自有数据中心,并通过 Helm chart 安装到 Kubernetes 上,因此文档和处理结果都会保留在你的环境中。推理由 LlamaIndex 管理,也可以在你自己的 GPU 上运行。使用本地模型时,Cost Effective 和 Agentic 层级会让每一页内容始终留在你的网络内,包括在隔离网络环境中。我们的 部署指南 逐一介绍了每种方案。
Reducto
Reducto 的 Agentic 层级在 ParseBench 上得分为 70.87,但格式处理得分较弱,仅为 45.4。它的优势在于可追溯性,因为每个解析后的文本块都带有位置信息,每个提取值都有边界框引文。标价为 每 1,000 页 10 美元。我们的 LlamaParse 与 Reducto 对比 页面提供了并排对比。
Extend
Extend 2.0 的总体得分为 73.50,表格维度得分为 85.26。其营销宣传主打 在 RealDoc-Bench 上实现 95.7% 的字段级问答准确率,这是 Extend 自行运行的一项基准测试。根据服务层级不同,解析费用为每 1,000 页 5 至 20 美元。请参阅 LlamaParse 与 Extend 对比.
Azure 文档智能
Azure 文档智能在大型云服务商中拥有最长的印刷体语言支持列表,根据我们对 Microsoft 支持情况表的统计,约为 300 种,但手写文字仅支持 12 种。如果公开的语言覆盖范围是决定性因素,那么这里应选择 Azure:LlamaIndex 并未公布 OCRia-1 的 OCR 语言列表;虽然 LlamaParse 确实能够处理手写表单(我们在《 最适合手写表单的 OCR》中比较了所有这些工具),但没有可列入表格的数量。其 Layout 模型在表格维度得分为 85.97,在图表维度得分为 1.27。请留意计费,因为 Read 每 1,000 页的费用约为 1.50 美元,而 Layout 约为 10 美元。更多信息请参阅《 LlamaParse 与 Azure 文档智能对比.
Google 文档 AI
Google Document AI 支持 200 多种语言,并列出了 企业版 OCR 每 1,000 页 1.50 美元,Layout Parser 每 1,000 页 10 美元。其总体得分为 48.66,表格维度得分为 54.95,在结构化文档的商业产品中接近垫底。
AWS Textract
Textract 在表格维度的 84.46 分尚属可观,但格式维度的 4.65 分和图表维度的 4.47 分将其总体得分拉低至 48.31。文本和表格提取覆盖 40 多种印刷体语言,但 Forms API 最多仅支持六种语言,手写文字也仅支持英语。对于 AWS 流水线中的纯文本处理而言,它是个不错的选择。对比详情请参阅《 LlamaParse 与 Amazon Textract 对比.
Mistral OCR 4.1
对于文本密集型页面,Mistral 是兼顾价格与速度的首选:支持 170 种语言, 每 1,000 页 4 美元,批量处理则为 2 美元 ,与 OCR 4 的标价相同,而且是我们找到的托管方案中 p50 速度最快的,仅需 1.8 秒。它在 OCRia 发布时的评测中得分为 67.5(上表排行榜中的一行是较旧的 OCR 4),图表是其薄弱项,得分为 40.1。
Unstructured
Unstructured 未被纳入 ParseBench。在其自有的 SCORE-Bench 上,它将自家流水线排在首位,并将 LlamaParse 评为其他供应商中的最佳方案,得分为 0.835,领先于得分 0.812 的 Reducto(非结构化基准测试)。前 10,000 页免费,之后每页收费 0.015 美元,而选择它的真正理由是其 ETL 连接器。请参阅 LlamaParse 与 Unstructured 对比.
前沿 VLM 表格阅读能力出色,收费也与之相称
通用视觉模型的表格阅读能力比大多数榜单所承认的更强。在 ParseBench 排行榜上,Claude Opus 5.5 在高推理强度下的表格维度得分为 94.26,GPT-6.1 Terra 为 93.07,Gemini 3 Flash 在高思考模式下为 91.19。对于只有网格表格的页面,三者中的任何一个都能胜任。
真实的申报文件混合了表格、图表、脚注和版面布局,而这正是模型失分的地方。Opus 5.5 的图表维度得分降至 70.89,视觉定位维度得分降至 60.56,使其总分被拉低至 78.80,每页成本为 6.13 美分。GPT-6.1 Terra 更便宜,每页仅需 1.09 美分,但总分只有 73.64。LlamaParse 的 Cost Effective 档位以每页 0.375 美分的成本取得 77.68 分,表现优于它。这就是 VLM OCR 的权衡,一张图即可说明:
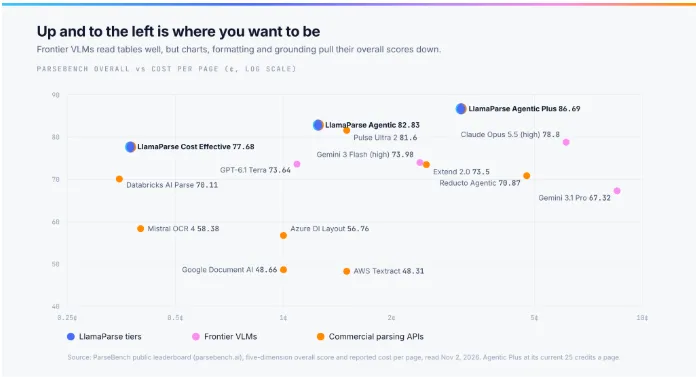
速度进一步拉大了差距。在 OpenDocRouter 上,OCRia-1 也作为独立模型提供;处理一页典型文档需要 2.2 秒,而 Opus 5.5 和 Gemini 4 Argon 分别需要 11.2 秒和 13.5 秒。在 OpenDocRouter 自己进行的 ParseBench 测试中,OCRia-1 得分为 84.67,每 1,000 页成本为 13.04 美元;Opus 5.5 得分为 84.27,成本为 48.82 美元。准确率相同,价格约为四分之一。我们在《 LLM API 并不是完整的文档解析器.
值得自行托管的开放权重模型
该关键词的大多数排名页面只涵盖开放模型。如果文档不能离开你的网络,它们是合理的选择,前提是你将自行托管的成本考虑在内,包括 GPU、服务、监控以及下文所述的差距。如果这是限制条件,LlamaParse 本身也可以部署在你自己的 VPC 或数据中心。
| 模型 | 规模与许可证 | ParseBench 总分 / 表格 | 备注 |
|---|---|---|---|
| LightOnOCR-3 | 4B,Apache 2.0 | 75.60 / 83.63 | 发布于 2026 年 10 月,在单张 H100 上的处理速度约为 3.36 页/秒(LightOn 测量) |
| Chandra OCR 2 | 约 5B,修改版 OpenRAIL | 70.59 / 89.20 | 表格处理能力最接近的开放竞争对手;其许可证设有收入上限 |
| MinerU 2.5-Pro | 1.2B | 69.27 / 77.61 | 开放集视觉定位最佳(74.24) |
| dots.mocr | 约 3B,MIT 许可证 | 54.18 / 85.03 | 表格表现出色,图表得分为 0.84 |
| PaddleOCR-VL-1.6 | 0.9B,Apache 2.0 | 50.90 / 67.79 | OmniDocBench 领先者,得分 96.3,支持 109 种语言 |
| DeepSeek-OCR 2 | 约 3B,Apache 2.0 | 41.2 / 61.7 | 专为词元压缩而构建,而非追求表格保真度 |
| Tesseract | Apache 2.0 许可证 | 未排名 | CPU 上支持 100 多种语言,无表格结构 |
选择一个 文档解析模型 是否自行托管,既取决于运维考量,也取决于准确率。在发布时的测试中,所有模型均采用相同的测试框架和相同的渲染方式进行评估;OCRia-1 在 ParseBench 表格维度获得 91.5 分,至少领先所有开放模型 6 分,唯一的例外是 Chandra(89.2 分);dots.mocr 得分为 85.2,LightOnOCR-3 为 82.5。dots.mocr 和 DeepSeek-OCR 2 在图表维度的得分也接近于零,这类问题往往会在生产环境中暴露,而不是出现在演示页面上。如果开放源代码是一项硬性要求,我们的 开源 OCR 工具 列表对该领域的覆盖更为广泛。
对于表格密集型文档,专用模型如今也是价格低廉的选择
一年前,要准确处理复杂表格,就意味着支付前沿 VLM 的价格,并忍受前沿 VLM 的延迟。如今,一个针对这些模型仍会漏掉的表格和图表训练而成的 4B 模型,已经改变了这笔账。现在,选择最佳 OCR 模型的关键在于哪一档最适合你的页面,而正确的选择取决于页面上的内容:
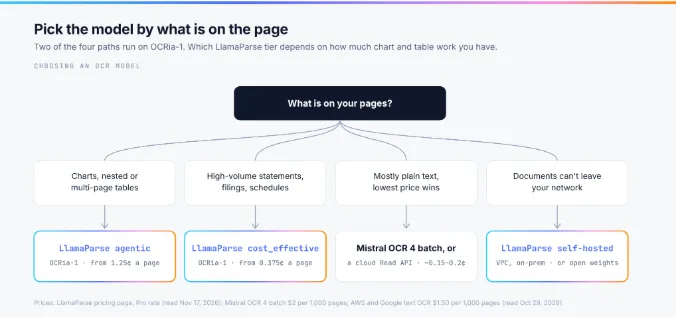
大批量的报表、申报文件和附表适合使用 cost_effective ,每页低至 0.375 美分。包含大量图表的报告和具有多层嵌套结构的表格,正是 agentic 的用武之地。有关财务专用工具,请参阅 最佳财务 OCR 软件. LlamaParse 目前在两个套餐档位均运行 OCRia-1。其免费套餐每月附赠 10,000 个点数,约可处理 3,333 页 Cost Effective 页面,因此你可以 免费创建账户 ,并先用它实际批量处理一批报表,再决定是否花钱。
相关文章
继续阅读
立即开始构建你的第一个文档智能体
LlamaIndex 助你快速将原始数据转化为真正的自动化。