 2026年11月5日
作者: Eduardo Alvarez, Jamie Li 和 Ronil Prasad
讨论 (0)
AI 生成的摘要
- NVFP4 较 FP16 将模型占用缩小约 3.5 倍,较 FP8 缩小 1.8 倍,同时保持精度,从而为 KV cache、更大的批次和更高的并发释放 HBM。
- 宽专家并行在 TensorRT-LLM 将专家分散到八块或更多 GPU 上,为每块 GPU 留出更多 HBM 用于缓存,并通过权重复用提高算术强度。
- NVIDIA Dynamo 将 KV cache 视为集群级资源,通过 KV 感知路由、分离式服务和 KV Cache Runner 实现,后者通过 NIXL 在 GPU、CPU 和存储之间对数据块进行分层管理。
- NVIDIA Vera CPU 提供 88 个 Olympus 核心,单线程性能提升 1.8 倍,并通过 NVLink-C2C 以 1.8 TB/s 与 Rubin 一致连接,最高支持 1.5 TB 的 LPDDR5X,在工具调用期间暂存空闲的 KV cache。NVIDIA CMX 增加了基于 BlueField-4 STX、Spectrum-X、DOCA Memos 和 Dynamo 集成的 pod 级 G3.5 存储层,以跨节点共享和复用 KV cache。这五项协同设计的杠杆共同使 Vera Rubin NVL72 能够提供高达 GB300 NVL72 每兆瓦吞吐量 30 倍的性能 NVIDIA Vera CPU 提供 88 个 Olympus 核心,单线程性能提升 1.8 倍,并通过 NVLink-C2C 以 1.8 TB/s 与 Rubin 一致连接,最高支持 1.5 TB 的 LPDDR5X,在工具调用期间暂存空闲的 KV cache。
- NVIDIA CMX 增加了基于 BlueField-4 STX、Spectrum-X、DOCA Memos 和 Dynamo 集成的 pod 级 G3.5 存储层,以跨节点共享和复用 KV cache。
- 这五项协同设计的杠杆共同使 Vera Rubin NVL72 在每 GPU 288 GB 不变的情况下,实现高达 GB300 NVL72 每兆瓦吞吐量 30 倍的性能。
后续步骤
- 阅读 深入解析 NVIDIA Rubin GPU 架构:驱动智能体 AI 时代 博客文章以了解更深入的架构细节。
- 探索 利用 NVFP4 KV Cache 优化长上下文和大批量推理 博客文章,学习 KV cache 优化技术。
- 阅读 在 NVL72 机架级系统上以宽专家并行扩展大型 MoE 模型 关于专家并行实现指导的博客文章。
在AI工厂中,高带宽内存(HBM)是最快、最昂贵、竞争也最激烈的内存层级。每一个字节,无论是用于冗余的权重副本、空闲会话的KV cache,还是重新计算的前缀,都是未能用于生成token的字节。问题不再是GPU拥有多少内存,而是每个字节能带来多少有效工作。
下方图 1 中的代际数据说明了原因。从 GB300 到 NVIDIA Rubin,容量保持在 288 GB,而带宽提升至 19.2 TB/s。
每兆瓦的智能体吞吐量增长要快得多。在 SemiAnalysis AgentX,它在真实的工具调用间隔和不断增长的上下文下回放已记录的编码智能体会话,NVIDIA Vera Rubin NVL72 随后在每用户每秒 160 个 token 下,提供高达 GB300 NVL72 每兆瓦吞吐量 30 倍的性能。
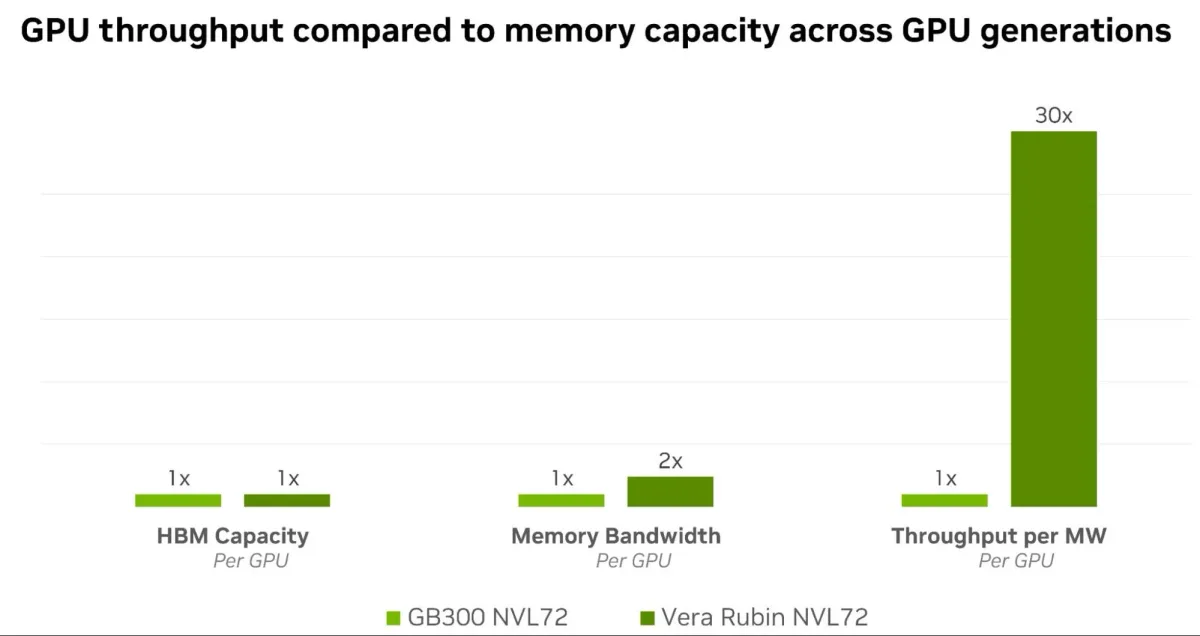
仅靠容量无法解释在每 GPU 288 GB 相同的情况下实现的 30 倍提升。差异在于每个字节能带来多少有效工作。
NVIDIA 将此视为一个协同设计问题,涵盖 GPU 架构、纵向扩展互连、服务软件、CPU 和存储。本文探讨协同设计最大化每个字节内存价值的五种方式,从编码单个权重的比特,到在智能体轮次和节点之间保存并复用上下文的共享存储。
1. NVFP4 如何用更少的字节存储更多智能?
提升一个字节价值的最直接方式,是在不丢失其所编码信息的前提下,让每个值变得更小。 NVFP4 采用 4 位 E2M1 元素和两级缩放来实现这一点:每 16 个值组成的微块共享一个 FP8(E4M3)缩放因子,并在其上叠加一个按张量计算的 FP32 缩放因子。由此得到的格式足够小,可以释放大量 HBM,同时粒度又足够细,能够在朴素 4 位格式难以胜任的地方保持精度。
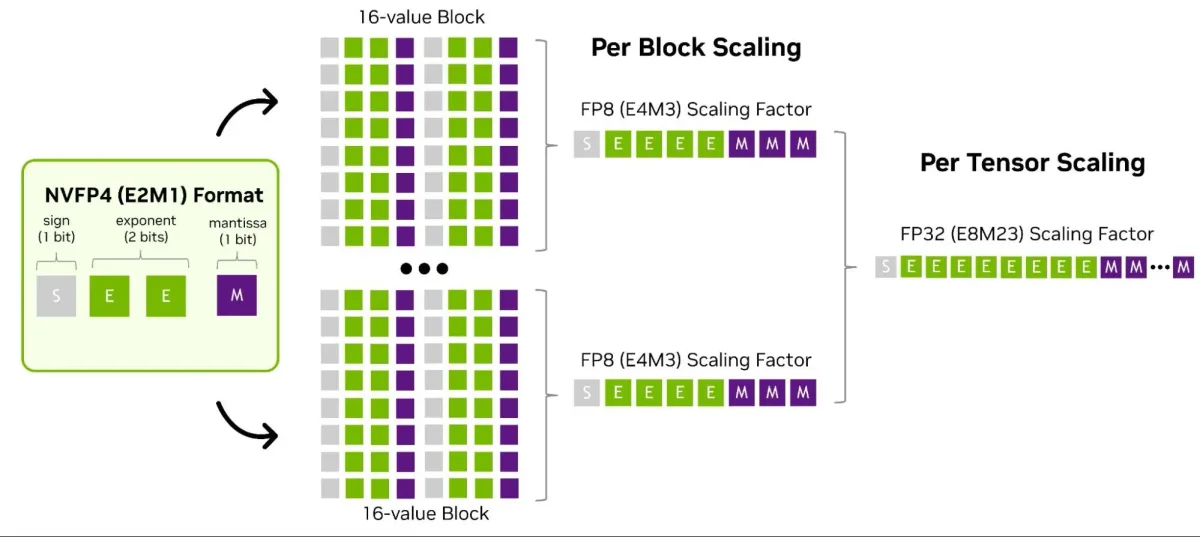
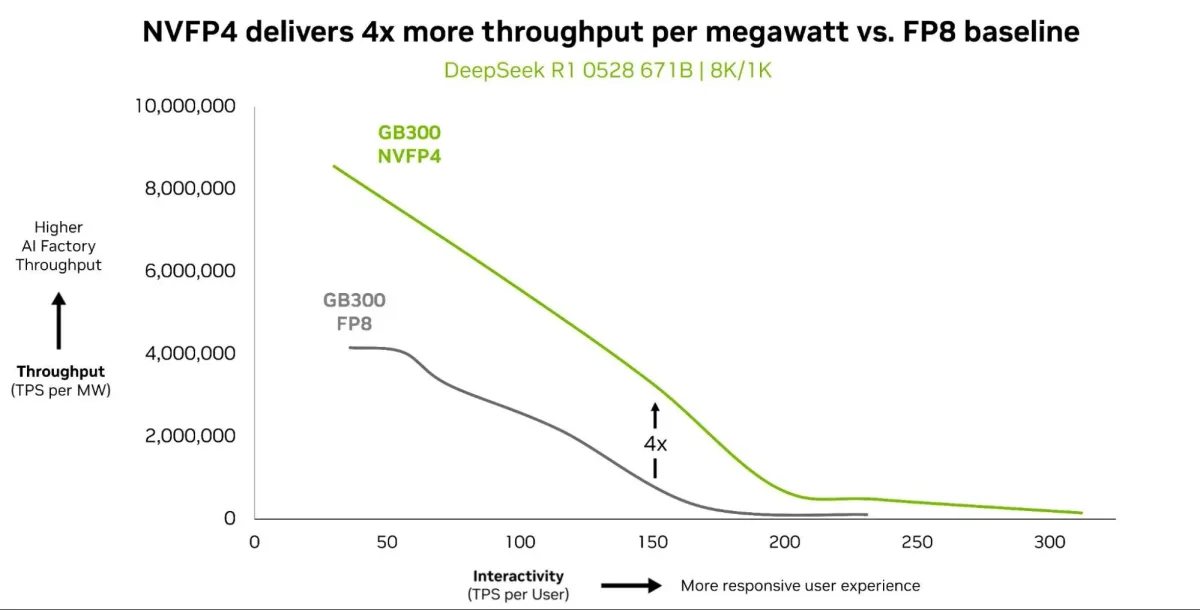
应用于权重时,NVFP4 将模型占用空间较 FP16 缩小约 3.5 倍、较 FP8 缩小 1.8 倍,从而为智能体推理最需要的资源释放内存:更大的 KV 缓存容量、更大的批次以及更高的并发度。NVFP4 已成为具有严格精度要求的开放智能体基准测试的默认精度,包括 AA-AgentPerf、SemiAnalysis AgentX 和 MLPerf Endpoints。在这些基准测试以及领先的混合专家(MoE)架构中,它在相同交互性下可提供高达 FP8 基线 4 倍的吞吐量(下图 3)。
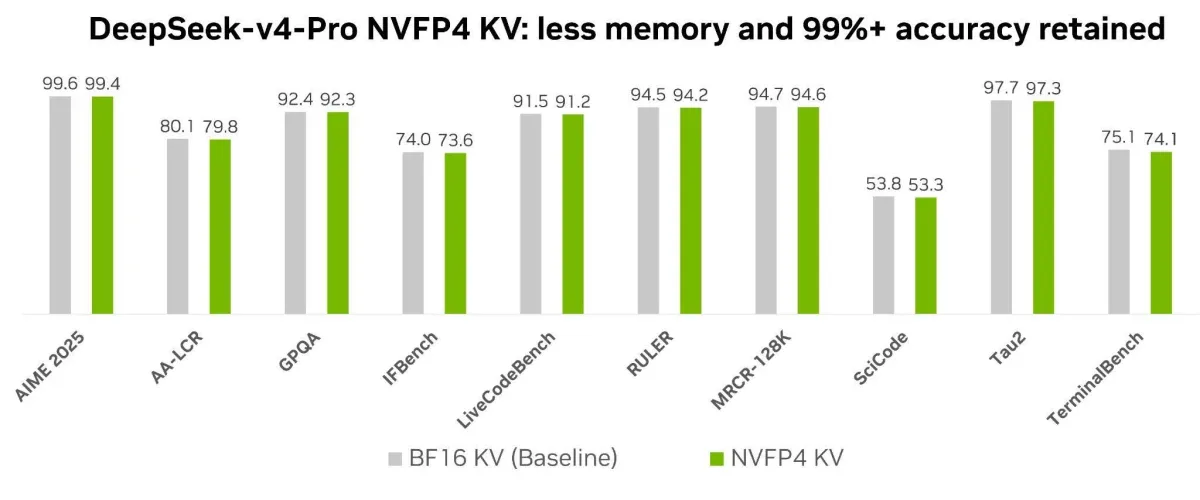
同样的原则也适用于 KV 缓存本身。 NVFP4 KV 缓存 与FP8相比,缓存占用最多减少50%,因此设备上可常驻约2倍的上下文。更少的逐出意味着预填充期间更高的缓存命中率,而更小的缓存意味着解码期间消耗更少的带宽。
NVFP4 缩小了字节。接下来的问题是这些字节存放在哪里,以及 AI 工厂必须保留多少份副本。
2. NVLink 纵向扩展域如何将 72 块 GPU 变成一个内存池?
MoE 模型每个 token 只激活一部分参数,但每个专家的权重仍然必须存放在 HBM 的某个位置。当专家被集中打包到少量 GPU 上时,每块 GPU 都有很大一部分内存用于存放权重,而且每个解码步骤都要为 MoE GroupGEMM 付出沉重的权重加载开销。这些字节虽然常驻内存,却没有被充分利用。
宽专家并行 (Wide-EP)在 NVIDIA TensorRT-LLM 中通过将专家分散到八块或更多 GPU 上来改变这一比例。在 EP64 下运行 DeepSeek-R1 时,每块 GPU 每层持有四个专家,即 58 个 MoE 层中共 232 个专家块,而完整模型中共有 14,848 个。每块 GPU 上的专家权重更少意味着:
- 容量: 每块 GPU 上可留出更多 HBM 用于 KV 缓存、更大的批次和更高的并发度。
- 算术强度: GroupGEMM 内核让每个已加载的权重在更多 token 上复用,从而提高每字节的 FLOPs。
- 平衡: 专家并行负载均衡器(EPLB)在前向传递之间重新分配热点和冷门专家,因此不会出现某块 GPU 的内存被过度占用而另一块却闲置的情况。
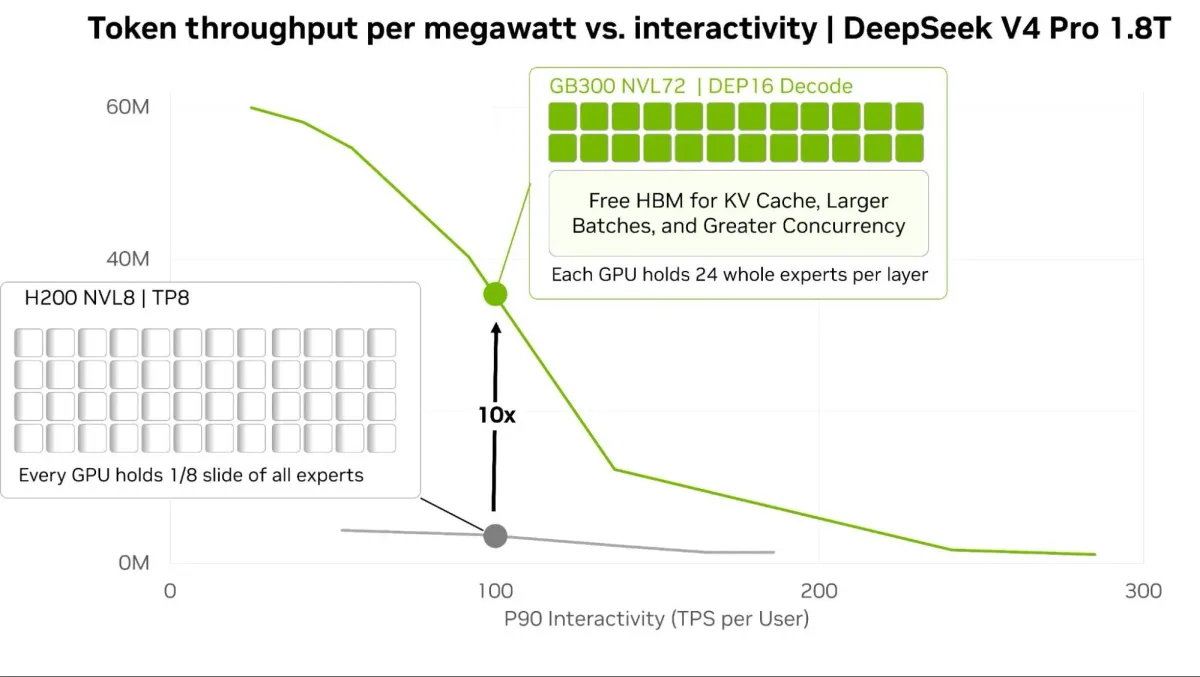
这之所以有效,仅仅是因为纵向扩展域让远程字节几乎和本地字节一样有用。每个 MoE 层都会触发全对全的 dispatch 和 combine 流量,如果没有高带宽互连结构,这些集合通信就会抵消掉这些收益。在 GB200 NVL72 上,130 TB/s 的聚合 NVLink 带宽可以吸收这些流量,并且在每用户每秒 100 token 的条件下,大规模 EP(EP32)相比小规模 EP(EP8)每 GPU 每秒可多输出最多 1.8 倍的 token。
Vera Rubin NVL72 延续了相同的设计思路。每块 Rubin GPU 最高配备 288 GB HBM4 和 3.0 TB/s 的 NVLink 6 带宽,整个机架合计约 20.7 TB HBM4。Rubin 还新增了内联内存张量加速器(TMA)描述符更新,使一个共享描述符能以统一布局服务所有专家,从而减少随专家数量增长而增加的元数据开销。
Wide-EP 决定权重字节存放在哪里。下一个杠杆则决定 KV 缓存字节一旦计算出来,是否还会被再次计算。
3. NVIDIA Dynamo 如何让每个缓存字节都物尽其用?
键值(KV)缓存存储先前已处理 token 的中间注意力计算结果,使模型能够复用这些结果,而不必重新计算。这种推理状态是短暂的,可以在需要时被逐出并重新计算,但 KV 缓存只有在被复用时才有价值。智能体工作负载充满了复用机会:系统提示、工具模式、共享文档,以及多步任务不断增长的历史记录。但是,如果请求落到一块不持有其前缀的 GPU 上,或者该前缀在片刻之前刚被逐出,系统就要再次为预填充付出代价。这些字节曾经存在,只是放错了地方。
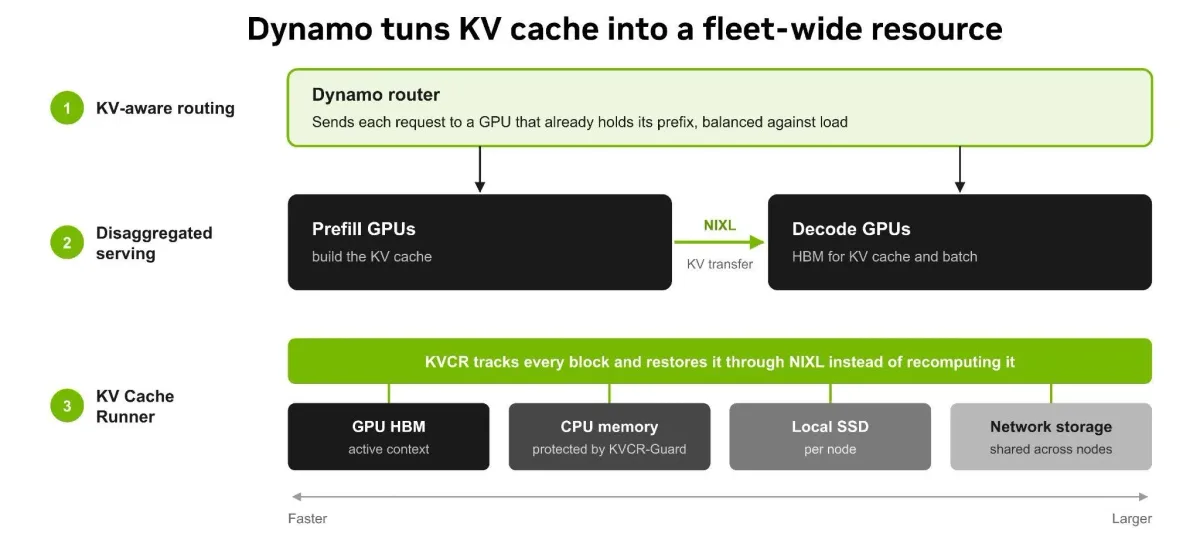
NVIDIA Dynamo 是弥合这一差距的分布式服务层。它将 KV 缓存视为整个集群范围的资源,而非每块 GPU 的附带产物,并通过三项协同设计的能力来实现这一点:
- KV 感知路由: Dynamo 路由器会跟踪 KV 块所在的位置,并在放置请求时同时考虑缓存前缀的重叠情况和 worker 负载。它在现有上下文与将工作发送到已使用 GPU 的成本之间进行权衡,并将潜在的重计算转化为缓存命中。
- 分离式服务: 预填充和解码在独立的 GPU 池上运行,每个池都根据自身的计算和内存配置来确定规模。解码 GPU 可以将 HBM 专门用于 KV 缓存和批大小,而无需为突发的预填充预留余量。
- KV Cache Runner(KVCR): 它跟踪每个块在已配置的 GPU、固定 CPU 和存储层级(包括本地 SSD 和挂载的网络文件系统)中的存放位置。保留在 HBM 之外的前缀可在后续请求需要时恢复,使有用的上下文在 GPU 逐出后仍能存活,并继续节省预填充工作。KVCR 使用 NVIDIA 推理传输库(NIXL) 用于其存储传输路径,使缓存块能够在 GPU 处理其他工作的同时进行迁移。KVCR 还支持分布式复用,由路由器提供的提示帮助选定的 worker 从对等节点检索缓存的上下文,同时推理引擎保留对 GPU 内存和本地主机卸载的控制。额外的 KVCR-Guard 功能可在引擎发生故障时保留已提交的、由 KVCR 管理的主机内存缓存,只要保护服务和主机仍然可用。
Dynamo 的 KV 缓存卸载依赖于快速检索:当加载 HBM 之外保留的前缀比重复预填充更快时,这样做就能节省时间。NIXL 将这条卸载路径连接到外部存储系统。在各自的验证测试中,存储厂商 VAST Data 和 WEKA 分别展示了:使用 GPUDirect Storage 时,单块 H100 GPU 可达 35 GB/s;通过自定义 NIXL 插件,八块 H100 GPU 的聚合读取吞吐量最高可达 270 GB/s。这些测试表明,外部存储能够为受测 GPU 系统提供 KV 缓存,而不会成为传输瓶颈,从而支持超出 HBM 的缓存容量。另一项 VAST 测试展示了响应时间方面的收益:在 DGX H100 系统上使用 vLLM 和 LMCache,加载已存储的 KV 缓存而非重新计算,缩短了 Qwen3-32B 在 130K token 提示下的首 token 时间。
Dynamo 负责协调缓存字节的存放位置以及何时将其取回。接下来的两个杠杆将扩大可用于该上下文的容量,首先是 CPU 内存。
4. NVIDIA Vera CPU 如何防止空闲上下文浪费 HBM?
智能体推理并非以一次不间断的过程运行。单个会话在 GPU 模型步骤与 CPU 侧工作之间交替进行:工具调用、代码执行、检索、数据库查询以及沙箱化评估。在每一个间隙期间,任何保留在 HBM 中的会话 KV 缓存都会占用容量,却不服务于活跃的 token 生成,而其他请求则在争夺同样的字节。
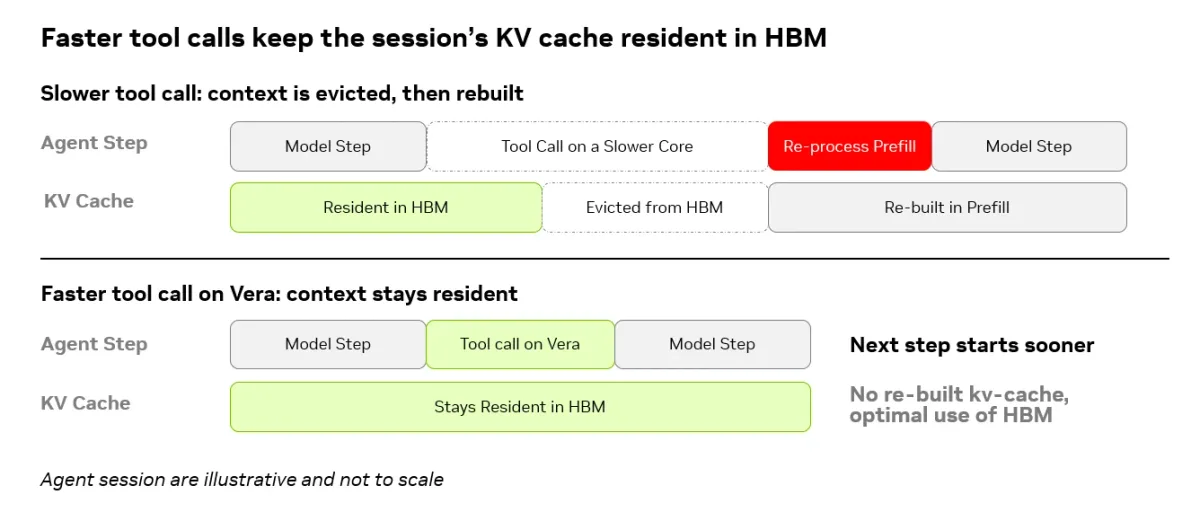
在完全订阅的 AI 工厂中,GPU 不会等待。它在工具调用运行期间接受新请求,而间隔越长,原始会话的 KV 缓存就越可能被逐出以腾出空间。当工具返回时,GPU 可能不得不通过完整的预填充来重建该上下文,而不是从缓存状态恢复。因此,缓慢的 CPU 会让 HBM 付出双重代价:首先是空闲驻留,然后是重新计算。
这一 NVIDIA Vera CPU 同时解决这个问题的两个方面:
- 更短的间隙: 88 个 Olympus 核心带来 1.8 倍的单线程性能提升、比 x86 CPU 低 40% 的峰值负载延迟,以及每核心最高 14 GB/s 的内存带宽。更快、更可预测的工具调用缩短了 KV 缓存暴露于逐出压力之下的窗口期。
- 快速停放上下文的位置: 每个 Vera CPU 最高提供 1.5 TB 的 LPDDR5X,是单块 Rubin GPU 的 HBM4 容量的 5 倍以上。NVIDIA NVLink-C2C 以 1.8 TB/s 的带宽将其与 Rubin 一致互连,约为 x16 PCIe Gen 6 链路 256 GB/s 的 7 倍。
综合来看,这些能力改变了空闲会话的经济性。Dynamo 的 KV Block Manager 不再将 KV 缓存保留在 HBM 中或将其丢弃,而是可以在工具调用期间将其暂存到 Vera 内存中,并在智能体恢复时通过 NVLink-C2C 将其取回。HBM 始终专用于正在积极生成 token 的会话,而暂停的会话则避免了重复支付预填充的成本。
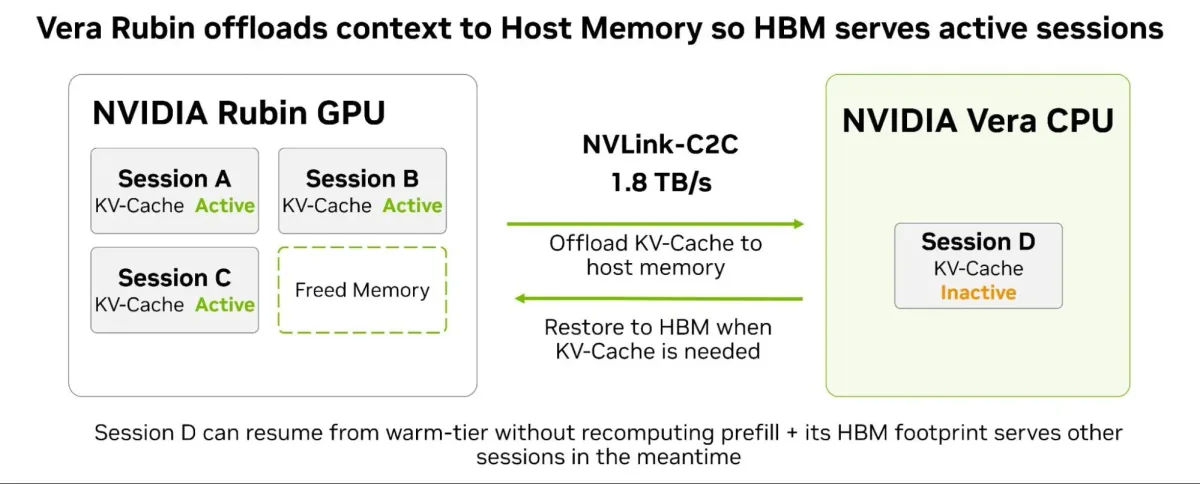
Vera 内存是温层,其容量专为会在一个轮次内返回的上下文而设计。对于必须跨轮次、跨智能体和跨节点存活的上下文,AI 工厂需要一个容量更大的层级。
5. NVIDIA CMX 如何跨 pod 扩展上下文内存?
将每一个可复用的 KV 缓存字节都保留在 GPU 或主机内存中,会限制活跃推理的容量,但将其丢弃又可能迫使重新计算。多轮会话、长周期任务以及共享工作内存的多智能体工作流都会生成 KV 缓存,而这些缓存往往在几分钟后、且常常在另一个节点上还会再次被需要。更长的上下文窗口和更多的并发会话,使 KV 缓存的容量需求超出 GPU HBM(下图中 G1)和主机内存(G2)。传统的层级体系并非为此类数据而设计。本地 SSD(G3)绑定于单个节点,而共享企业存储(G4)是为持久数据而构建的,带有复制和元数据开销,而临时性的 KV 缓存并不需要这些。
NVIDIA CMX 上下文内存存储通过全新的 G3.5 层级弥合了这一差距:以太网连接的闪存,在 pod 级别共享,并专门针对 KV 缓存进行了优化。它基于 NVIDIA STX 参考设计构建,并跨四个层面进行协同设计:
- 存储处理: NVIDIA BlueField-4 STX 存储处理器负责管理 NVMe SSD、运行存储服务,并为 KV 缓存卸载数据完整性与加密处理。
- 网络NVIDIA Spectrum-X 以太网在计算节点与 CMX 存储节点之间提供低延迟、高带宽的 RDMA 访问。
- KV 感知服务: NVIDIA DOCA Memos 在 BlueField-4 上提供 KV 感知服务和 I/O 控制,将上下文视为放置与共享的一等资源。
- 服务集成: Dynamo 和 NIXL 使 CMX 在整个 pod 中呈现为一个无缝的上下文层级,预先暂存上下文并将请求路由到 KV 缓存已驻留的位置。
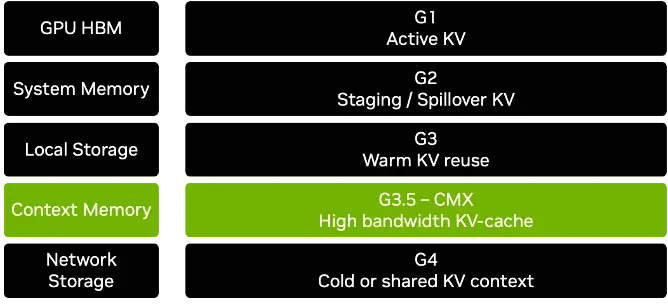
Pod 级设计正是提升每个字节价值的关键所在。在一个节点上计算一次的 prefix 可以在 pod 内兼容的模型实例之间复用,因此共享文档、工具或工作内存的 agent 能够避免重复的 prefill。在 pod 范围内池化上下文存储,可减少 KV-cache 重复以及跨节点的搁浅容量,从而为推理扩展有效的 GPU 内存。通过将可复用上下文预暂存到 GPU 或主机内存中,CMX 减少了推理停顿,而其针对 KV-cache 优化的存储层级则降低了为该上下文提供服务的功耗开销。这些能力共同帮助 CMX 在长上下文推理中,相比传统存储实现最高 5 倍的每秒 token 数以及最高 5 倍的能效提升。
这五个杠杆如何协同工作?
每个杠杆消除不同类型的浪费。NVFP4 去除数值不需要的比特,Wide-EP 去除冗余的权重副本,Dynamo 去除重复计算,Vera 去除工具调用期间的闲置驻留,而 CMX 实现跨节点的 KV 缓存共享与复用。由于这些杠杆被设计为同一个内存系统,而非彼此独立的部件,因此收益可以叠加:4 位 KV 块在 HBM、Vera 内存和 CMX 中都能节省空间。
其结果是这样一个 AI 工厂:它衡量内存时不仅看容量,更看每个字节能产出多少有用 token。Vera Rubin NVL72 展示了这一图景:在每 GPU 288 GB 不变的情况下,每兆瓦吞吐量最高可达 GB300 NVL72 的 30 倍。随着 agentic 工作负载不断增长,每一个字节都至关重要。
了解更多
- 深入解析 NVIDIA Rubin GPU 架构:驱动智能体 AI 时代
- 利用 NVFP4 KV 缓存优化长上下文和大批量场景下的推理
- 推出 NVFP4,实现高效且准确的低精度推理
- 在 NVL72 机架级系统上以宽专家并行扩展大型 MoE 模型
- 如何利用 NVIDIA Dynamo 缓解 KV 缓存瓶颈
- NVIDIA Vera CPU 提升 AI 工厂吞吐量,加速智能体工作负载
- 隆重推出基于 NVIDIA BlueField-4 的 CMX 上下文内存存储平台,面向 AI 的下一个前沿
- NVIDIA BlueField-4 为智能体 AI 工厂赋能全新横向扩展网络基础设施
这项工作得益于 Wei-ming Chen、Shiyang Chen、Chao Ni、Mengdi Wang 和 Jeff Pool 的专业知识与工程贡献。
讨论(0)标签
智能体 AI / 生成式 AI | 数据中心 / 云 | 综合 | BlueField DPU | Dynamo | GB200 | H100 | H200 | NVLink | TensorRT-LLM | 中级技术 | 基准测试 | 深入解析 | DOCA | 以太网 | 精选 | GB300 | GB300 NVL72 | GPUDirect | Rubin GPU | Spectrum-X | Vera CPU | Vera Rubin | Vera Rubin NVL72关于作者
 关于 Eduardo Alvarez
Eduardo Alvarez 是 NVIDIA 的高级技术负责人,专注于大规模 AI 推理、性能优化、工作负载经济分析和应用赋能。他在 AI 系统工程、工作负载优化和加速计算方面拥有深厚背景,致力于将创新转化为实际应用。在加入 NVIDIA 之前,Eduardo 曾在多家半导体和能源科技公司担任工程职位。 查看 Eduardo Alvarez 的所有文章
 关于 Jamie Li
Jamie Li 是 NVIDIA 的高级技术营销工程师,专注于驾驭 AI 推理领域的最新技术。他在 AI 软件工程和客户管理方面拥有深厚背景,善于将创新转化为切实的客户成果。在加入 NVIDIA 之前,他曾在企业科技领域担任多个职位,负责开发、攻破和修复 AI 解决方案。他还从事过医学影像研究,并拥有以 AI 为方向的计算机科学硕士学位。 查看 Jamie Li 的所有文章
 关于 Ronil Prasad
Ronil Prasad 是 NVIDIA 数据中心网络解决方案的高级产品营销经理,帮助企业客户和 AI 客户采用为现代数据中心提供支持的高性能网络平台。 查看 Ronil Prasad 的所有文章