- 简要说明
- 为什么稀疏注意力需要快速、高容量的内存层级
- 带宽与容量瓶颈建模
- 128K:KV I/O 带宽与外部内存容量瓶颈
- 短上下文与长上下文情形
- Netpreme X-Mem™:面向 SGLang HiSparse 的高带宽、高容量内存层级
- 与 SGLang HiSparse 的集成
- XM-Sparse 测试平台与解码性能
- X-Mem™ 在相同批大小下降低解码延迟
- X-Mem™ 提升各上下文长度下的峰值吞吐
- 结论
XM-Sparse 将 Netpreme X-Mem™ 与 SGLang HiSparse 集成。对卸载 KV 缓存的高带宽访问降低了解码延迟,而增加的容量支持更大的批大小和更高的并发度。

简要说明
- X-Mem™ 为 SGLang HiSparse 带来高带宽和海量外部容量,从而实现 更快速地访问卸载的 KV 并支持超出主机 DRAM 限制的更大批大小。
- 相同批大小下更快的解码。 在 16K 上下文、 20% top-k 未命中率 、每 GPU 批大小 192 时,X-Mem™ 相比通过 PCIe 连接的主机 DRAM,将平均每输出 token 时间(TPOT)降低了 49.25% 。在 40% 未命中率时,降幅达到 63.58%.
- 跨上下文长度实现更高吞吐量。 X-Mem™ 实现了 2.09–3.04× 在 16K–1M 上下文、20% 未命中率下,主机 DRAM 的峰值解码吞吐量。
这些结果是在 X-Mem™ Pilot 虚拟机中测得的,该虚拟机现已可通过以下网址获取: https://netpreme.com/xmem/early-accessX-Mem™ 芯片将于稍后推出。
为什么稀疏注意力需要快速、高容量的内存层级
稀疏注意力在每个解码步骤只访问选定的 KV 条目,但仍保留完整的 KV 缓存,因为选择在 token 生成过程中会发生变化。 SGLang HiSparse 使用热 KV 缓冲区来减少外部内存读取,并将索引器键缓存(K-index)保留在 GPU HBM 中(图 1)。
智能体工作负载提高了风险。编码智能体会保持数百个会话处于打开状态,每个会话的 KV 复用率最高可达 95%(参见我们之前的 博客)。对于这些工作负载,持续解码吞吐量比首 token 时间更重要,因为解码吞吐量决定了高并发下的服务容量。
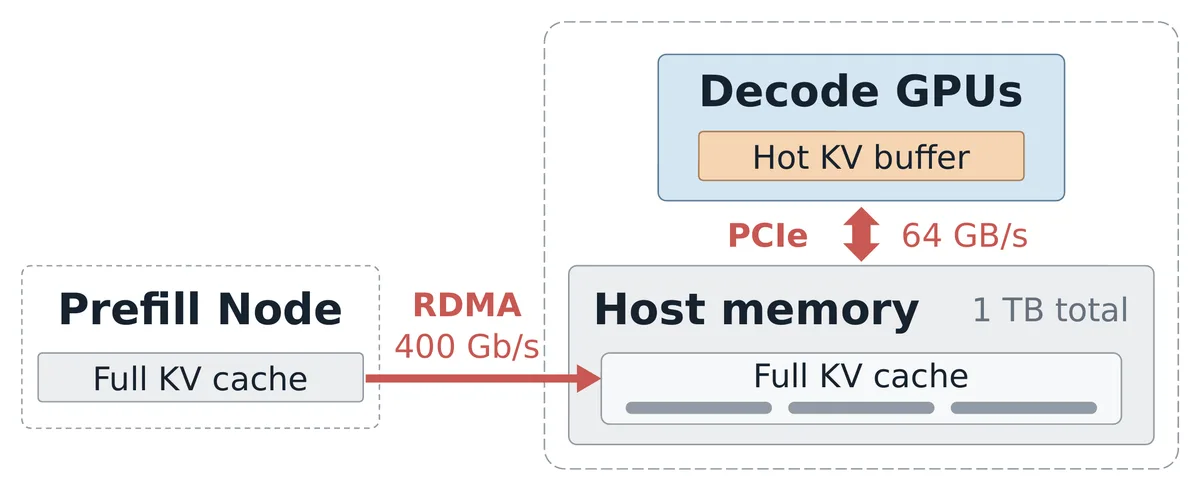
图 1。 现有 KV 缓存卸载架构。完整 KV 缓存驻留在主机 DRAM 中;解码 GPU 在 HBM 中保留热 KV 缓冲区,并通过 PCIe 获取缺失的选定 KV。
这种架构提出了两项关键硬件要求:
- 高带宽互连,以快速获取缺失的选定 KV 条目并降低解码延迟。 高带宽互连 以快速获取缺失的选定 KV 条目并降低解码延迟。
- 充足的外部内存容量 以存放大批量场景下的完整 KV 缓存。
建模带宽与容量瓶颈
我们比较了四种外部内存配置下的建模解码吞吐量:PCIe、CXL、NVLink-C2C 以及 Scale-up 扩展内存对于 PCIe 基线,我们假设每块 GPU 的带宽为 64 GB/s,四 GPU 实例的总主机内存预算为 1 TB,该预算按标准八 GPU DGX 配置按比例缩放得出。CXL 在相同带宽下将容量扩展至 24 TB。NVLink-C2C 在 Grace-Blackwell 中将每块 GPU 的带宽提升至 225 GB/s,总容量仍为 1 TB。在模型中,Scale-up 扩展内存通过高带宽互连结构实现每块 GPU 900 GB/s 的带宽和 24 TB 的总容量。
我们测量不含 KV I/O 的解码计算时间,然后使用具有代表性的 20% 未命中率(基于先前工作中的 trace 分析)加上估算的 I/O 开销。该模型假设每块 GPU 都能维持其建模带宽,且计算与 I/O 不重叠: Tstep(B)=Tcompute(B)+TI/O(B)T_{\mathrm{step}}(B) = T_{\mathrm{compute}}(B) + T_{\mathrm{I/O}}(B)Tstep(B)=Tcompute(B)+TI/O(B) 最大 batch size 同时受 HBM 和外部内存容量限制: Bmax=min(CHBMMhotKV+MKindex,CexternalMfullKV)B_{\max} = \min\left(\frac{C_{\mathrm{HBM}}}{M_{\mathrm{hotKV}} + M_{\mathrm{Kindex}}}, \frac{C_{\math 20% 未命中率 (基于 trace 分析) 先前工作该模型假设每块 GPU 都能维持其建模带宽,且计算与 I/O 不重叠:
Tstep(B)=Tcompute(B)+TI/O(B)T_{\mathrm{step}}(B) = T_{\mathrm{compute}}(B) + T_{\mathrm{I/O}}(B)Tstep(B)=Tcompute(B)+TI/O(B)最大 batch size 同时受 HBM 和外部内存容量限制:
Bmax=min(CHBMMhotKV+MKindex,CexternalMfullKV)B_{\max} = \min\left(\frac{C_{\mathrm{HBM}}}{M_{\mathrm{hotKV}} + M_{\mathrm{Kindex}}}, \frac{C_{\mathrm{external}}}{M_{\mathrm{fullKV}}}\right)Bmax=min(MhotKV+MKindexCHBM,MfullKVCexternal)容量是每块 GPU 的可用预算;内存占用按每个请求计算。采用 4 路 EP 和 DP 注意力时,在扣除权重和其他分配后,我们为每块 GPU 分配 60 GiB HBM 用于热 KV 缓冲区和 K-index。
下图展示了 GLM-5.3 在四 GPU 实例上的建模解码吞吐(注意力采用 DP4 + 专家采用 EP4)。我们以 128K 作为编码智能体工作负载的代表性上下文长度,该长度在 TraceLab,并以 16K 和 1M 作为补充案例。每个请求每层使用 4,096 token 的热 KV 缓冲区,并在每个解码步骤中每层选择 2,048 个 KV 条目。吞吐量(输出 token/秒)和 batch size 均按每块 GPU 报告,每种配置都绘制到其容量上限。虚线 Ideal 曲线使用实测计算时序,假设无 I/O 开销且外部内存容量充足。
128K:KV I/O 带宽与外部内存容量瓶颈
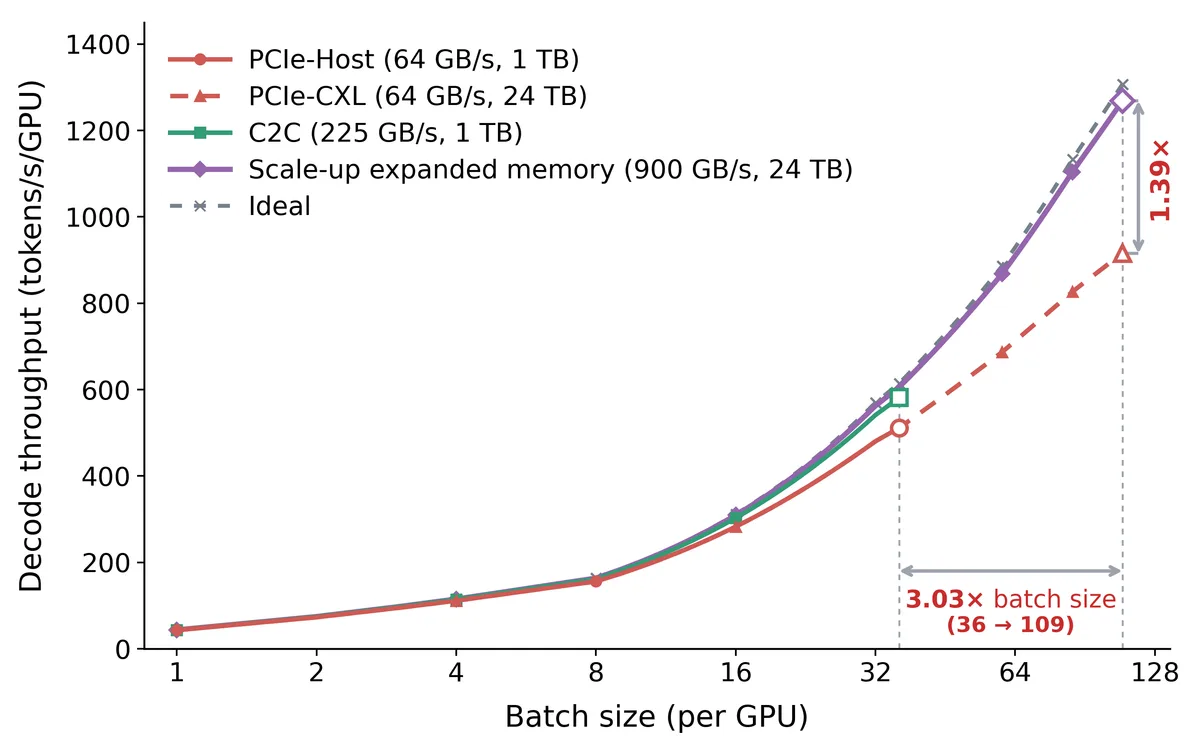
图 2。 128K 上下文长度下的建模解码吞吐量。
在 128K 下,外部内存容量和 I/O 带宽都会限制吞吐量。更大的完整 KV 缓存使 1 TB 配置每 GPU 最多只能达到 batch 36,即使采用带宽更高的 NVLink-C2C 也是如此。将容量扩展到 24 TB 后,batch 可达 109,但增加的 KV 流量使 PCIe-CXL 带宽成为瓶颈。在该 batch 下,900 GB/s 的 scale-up 互连提供的吞吐量是 64 GB/s PCIe-CXL 的 1.39 倍。因此,高吞吐量既需要足够的外部内存容量,也需要高带宽互连。
短上下文与长上下文案例

图 3。 (a)16K 和(b)1M 上下文下的建模解码吞吐量。1M 面板中的两种内存配置均使用每 GPU 64 GB/s。
较短的 16K 和较长的 1M 案例有助于区分在 128K 下同时出现的两种约束。在 16K 下,外部内存容量已经足够:每 GPU batch 241 在四块 GPU 上仅使用 0.85 TB,处于 1 TB 预算之内。I/O 带宽是主要瓶颈,在该 batch 下,900 GB/s 的 scale-up 互连提供的吞吐量是 64 GB/s PCIe 的 1.80 倍。在 1M 下,更大的完整 KV 缓存使外部内存容量成为 1 TB 配置的主要约束。扩展到 24 TB 后,可行 batch 从每 GPU 4 提升到 20,并在相同的 64 GB/s 带宽下提供 2.34 倍的吞吐量。每个 batch 下的吞吐量都接近 Ideal,表明 I/O 开销较小。
Netpreme X-Mem™:面向 SGLang HiSparse 的高带宽、高容量内存层级
Netpreme X-Mem™ 内存处理单元(MPU) 专为在纵向扩展域内通过高带宽互连将 GPU 内存扩展数十 TB 而设计。X-Mem™ 在 AI 机架中充当专用内存节点,并支持 GPU 点对点访问。单个节点容纳四个 MPU,最高 24 TB DDR5 内存和约 4 TB/s 的总内存带宽,由机架内的 GPU 共享。添加内存节点可扩展可用容量和总带宽。这使内存层级能够独立于计算进行扩展。
将 X-Mem™ 集成为 SGLang HiSparse 的 prefill 和 decode worker 提供快速、高容量的共享内存。 将 X-Mem™ 集成为 SGLang HiSparse 的 prefill 和 decode worker 提供快速、高容量的共享内存。Prefill GPU 将 KV 缓存发布到 X-Mem™。Decode GPU 将热 KV 缓冲区保留在 HBM 中,并通过 scale-up 互连获取缺失的选定 KV 条目(图 4)。
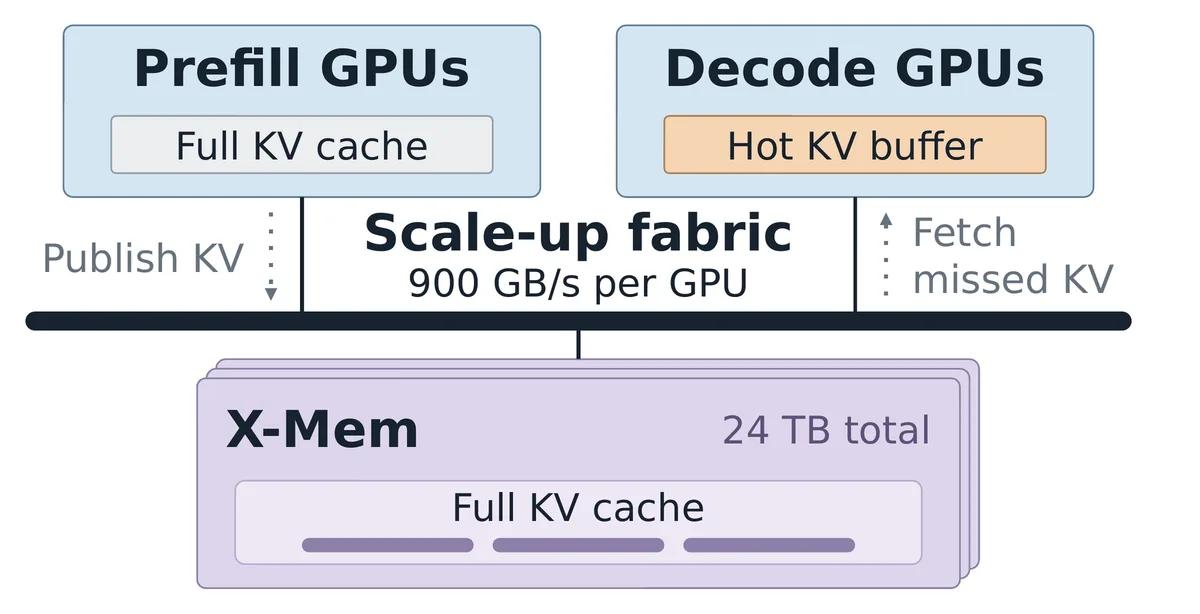
图 4。 使用 Netpreme X-Mem™ 进行 KV 缓存卸载。
与 SGLang HiSparse 集成
X-Mem™ 通过兼容 CUDA 和 PyTorch 的 API 提供可被 GPU 寻址的内存。XM-Sparse 保留了 HiSparse 的稀疏选择、缓存管理和预取机制,并支持针对解码计算和选定 KV 获取的 CUDA Graph 捕获与重放。
具有公共前缀的请求可以在 X-Mem™ 中共享相应的 KV 缓存,从而避免对该前缀的重复存储。所有者进程创建共享内存区域,GPU 进程使用可移植描述符附加到该区域。只有在所有进程都解除其映射后,所有者才会释放物理内存。
KV 管理遵循请求生命周期:
- 发布 KV 缓存。 Prefill GPU 将提示 KV 直接写入 X-Mem™。发布完成后,解码无需先将完整提示 KV 暂存到解码 HBM,即可访问历史记录。
- 获取选定的 KV。 解码 GPU 检查其本地热缓冲区,并仅将缺失的选定 KV 条目从 X-Mem™ 取到 HBM 中用于注意力计算。
- 回写生成的 KV。 在每次成功解码步骤之后,新生成的 KV 会被追加到 X-Mem™ 中的历史记录,使其可供后续步骤使用。
- 释放 KV 存储。 当请求完成时,系统会等待尚未完成的 KV 访问全部结束后,再回收其存储空间以供新请求使用。
XM-Sparse 测试平台与解码性能
我们在四块 NVIDIA B300 解码 GPU 上评估 GLM-5.3,采用 attention DP4 和 MoE EP4。我们将由主机 DRAM 支持的 SGLang HiSparse 与 XM-Sparse(我们的 X-Mem™ 集成方案,在图中标注为“SGLang HiSparse + X-Mem”)进行比较。另外四块 B300 GPU 用作内存库,其 HBM 在与芯片未来所暴露的相同访问路径之后充当 X-Mem™ 内存。X-Mem™ 使用 24 TB 的容量预算,batch size 由建模的容量限制决定,而非四块内存库 GPU 的物理内存。
每个请求在每一层都有一个 4,096 token 的热 KV 缓冲区。我们使用合成的 KV 前缀和固定的未命中率,并采用 预取已禁用。top-k 未命中率是指所选 KV 条目不在 GPU 热缓冲区中、因而需要从外部内存获取的比例。我们采用与分析中相同的 20% 未命中率,并增加一个 40% 未命中率用例,用于评估更高 I/O 压力下的性能我们报告平均 TPOT 和每 GPU 吞吐量。第一项比较在相同 batch size 下测量 TPOT;第二项比较各配置在其最高吞吐量测试 batch 下的表现。
在相同 batch size 下,X-Mem™ 降低了 decode 延迟
在 16K 下,两种配置使用相同的 batch size 和相同数量的外部内存。因此,这一比较评估的是高带宽互连带来的延迟收益,而非额外容量带来的收益。
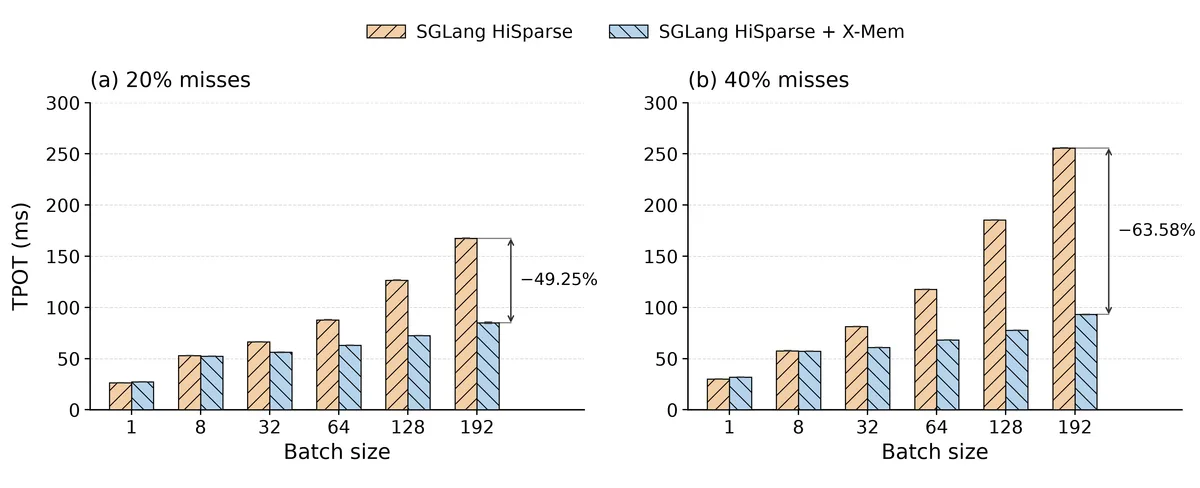
图 5。 在 16K 上下文、预取已禁用时的平均 TPOT(越低越好):(a) 20% 未命中率;(b) 40% 未命中率。batch size 为每 GPU 的值。箭头标记 batch 192 时的降幅。
在每 GPU batch 192 时,X-Mem™ 在 20% 未命中率下将 TPOT 从 167.48 ms 降至 84.99 ms,降幅为 49.25% 的降幅在 40% 未命中率下,TPOT 从 255.69 ms 降至 93.13 ms,降幅为 63.58%。 63.58% 的降幅小批量时差异不大,X-Mem™ 可能略慢;随着批量增大,更快的 KV 访问带来的优势变得更加明显。40% 未命中率时降幅更大,反映出当需要从外部内存获取更多选中的 KV 时,快速外部访问的价值更高。
X-Mem™ 提升了各上下文长度下的峰值吞吐量
接下来,我们在各配置测试过的最高吞吐量 batch 下进行比较,采用 20% 未命中率并禁用预取。Host DRAM 使用 1 TB 的外部内存容量预算,而 X-Mem™ 使用 24 TB 预算,覆盖所有上下文长度.
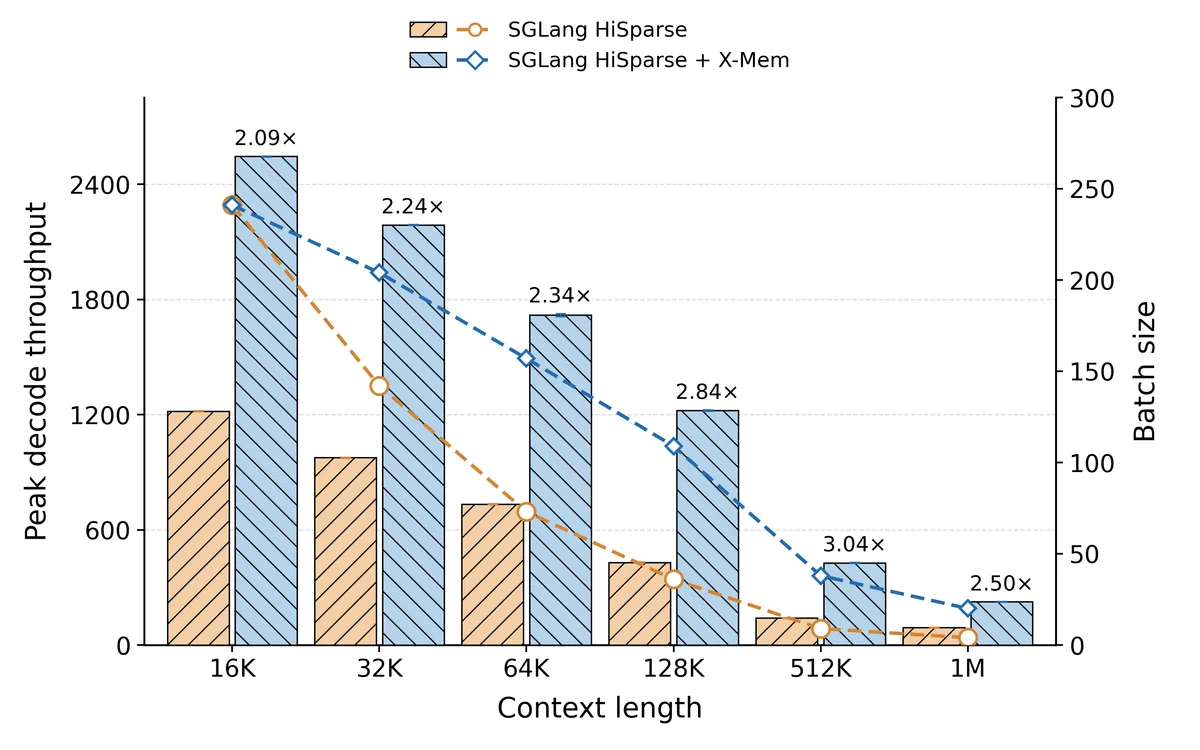
图 6。 柱状图显示在 20% 未命中率下每 GPU 的峰值解码吞吐量(tokens/s);虚线显示每 GPU 的 batch size。蓝色柱上方的标签显示 X-Mem™ 吞吐量相对于 host DRAM 的倍数。
X-Mem™ 达到 是 host DRAM 吞吐量的 2.09–3.04 倍 在不同上下文长度下。在 16K 时,两种配置均以每 GPU batch 241 运行,因此 2.09× 的增益反映的是在相同并发度下高带宽互连带来的收益。在更长上下文下,更大的外部内存容量支持更大的 batch,因此吞吐量增益既反映了更快的 KV 访问,也反映了并发度的提升。
结论
X-Mem™ 为 HiSparse 提供了对卸载 KV 的高带宽访问,并为完整 KV 缓存提供了更大容量。我们的结果表明,在匹配的批大小下 TPOT 更低、峰值吞吐量更高,并且在外部内存容量成为限制时能够支持更大的批。