引言
主要以图像和语言为中心发展起来的深度学习取得了显著成果;然而,工业场景中每天积累的数据仍有相当大一部分以 表格与时间序列数据的形式存在。制造设备的传感器日志、半导体良率数据、金融交易记录以及医院电子健康记录,都是沿行与列或时间轴组织的数字序列。尽管这种 结构化数据 是工业场景中最常见的类型,但矛盾的是,它也是深度学习最晚进入的领域。过去十年左右,XGBoost 和 LightGBM 等基于树的模型一直作为事实标准,便是明证。
然而,过去两三年间这一趋势正在迅速转变。这是因为 基础模型——在大规模合成数据上预训练、无需额外训练即可通过单次推理完成预测——也开始在结构化数据领域产生重大影响。在表格数据领域,TabPFN 发表于 Nature,并展现出超越现有树模型的性能[1],而在时间序列数据领域,能够进行零样本预测的基础模型也相继涌现。长期以来“每个数据集都必须重新训练模型”的假设已开始动摇。
这些变化在 ICML(国际机器学习大会)2026——机器学习领域最负盛名的会议——上清晰可见。LG AI Research 参加了于 2026 年 7 月 6 日至 11 日在首尔 COEX 举办的 ICML 2026,展示我们的研究成果并回顾结构化数据与时间序列分析的最新趋势。本文总结了 LG AI Research 展示的研究,以及会议上值得关注的时间序列深度学习研究。
在首尔举办的 ICML 2026
今年迎来第 43 届的 ICML 2026 是 ICML 首次在韩国举办,地点为首尔 COEX。大会共收到 23,918 篇投稿,其中 6,352 篇被接收(接收率 26.6%)。投稿数量较上一年几乎翻倍[2].
扩散模型 在今年各大奖项中占据中心位置。两项杰出论文奖分别授予“The Flexibility Trap”——重新审视扩散语言模型中任意顺序生成的价值——和“High-Accuracy Sampling for Diffusion Models and Log-Concave Distributions”——研究扩散模型中的高精度采样。时间检验奖授予 2016 年的论文(“Asynchronous Methods for Deep Reinforcement Learning”),该论文是深度强化学习领域的里程碑[3]。尽管生成模型备受关注,结构化数据研究却在悄然稳步扩大其范围。主会议展示了大量关于时间序列的论文,而结构化数据基础模型研讨会今年已是第二届。
LG AI Research 的研究:表格基础模型为何会漏掉少数类?
问题:TabPFN 中的类别偏差
LG AI Research 在 ICML 2026 展示的研究题为 “Mitigating Label Shift in Tabular In-Context Learning via Test-Time Posterior Adjustment”[4]。该研究识别了表格基础模型在类别不平衡下性能下降的现象,并提出了一种在推理时通过简单调整来缓解该问题的方法。
TabPFN 是面向表格数据的基础模型。在大量合成数据上预训练后,它在解决实际问题时将整个训练数据集作为 上下文 ,仅通过一次前向传播即可做出预测。这被称为 上下文学习(ICL) 方法,与现有模型不同之处在于它完全不涉及参数更新。它因在小数据集上超越 XGBoost 而备受关注。
然而,我们发现了该模型一个此前被忽视的脆弱点: 标签偏移。这指的是特征的类别条件概率分布 P(X|Y) 在训练数据和测试数据中相同,但类别比例 P(Y) 不同的情况。在真实工业数据中,这种情况实际上相当常见。这是因为在缺陷检测、异常检测和疾病诊断等许多场景中,待识别的目标都是少数类。
事实上,我们对 OpenML 的 253 个表格 数据集的分析显示,约 85% (214 个数据集)存在类别不平衡。此外,TabPFN 会将上下文中提供的类别不平衡直接纳入其预测。在极端情况下,我们观察到 98.3% 的测试样本被预测为属于多数类,导致少数类的召回率实际上崩溃。这些结果是在同一数据集上进行训练和测试的情况下出现的,这凸显了问题的严重性。
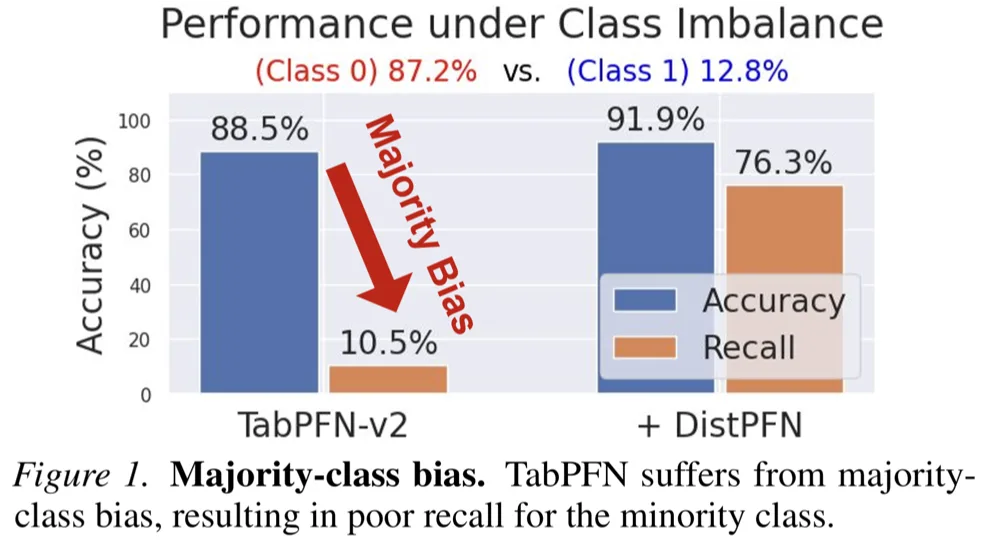
图 1. 在 TabPFN 中,预测偏向多数类,导致少数类召回率显著下降。(来源:Lee [4],图 1)
解决方案:在推理时而非训练时进行校正,DistPFN 为解决这一问题,我们提出了 DistPFN核心思想出奇地简单。TabPFN输出的预测概率会额外乘以一个校正因子,该因子表示“该预测比训练数据中的类别比例高出多少”。对于训练数据中占比较高的类别,该因子会减小;对于占比较低的类别,该因子会增大。因此,训练数据中的类别比例对预测的影响被削弱,模型预测结果被赋予相对更大的权重。用数学方式表示如下。
┌─ 校正因子 ─┐p~_DistPFN(y)=Norm(p∧(y)×p∧(y)/p_train(y))
其中,p∧(y)是TabPFN预测的类别概率(后验分布),p_train(y)是该类别在训练数据中的比例(先验分布),Norm是一种归一化处理,用于调整缩放后数值的总和,使其再次等于1。该方法最大的优势在于,它完全不改变模型架构,无需重新训练,甚至不需要估计测试标签分布。这与现有的标签偏移校正技术(如EME和BBE)形成对比,后者需要单独估计测试先验分布。之所以可行,是因为TabPFN系列模型会显式引用训练数据的上下文。换言之,它们可以直接利用训练数据的类别比例,而无需单独估计。
此外,我们还提出了 DistPFN-T,它根据具体情况调整校正强度。该方法使用预测分布与训练先验分布之间的 交叉熵 作为温度值;两个分布之间的差异越大,预测分布就变得越平滑,从而防止 过度校正.

图2. DistPFN的整体结构。TabPFN偏向多数类的预测(左)
仅通过推理时的分布校正得到缓解(右)。(来源:Lee [4],图4)
实验结果我们使用 16 基线在 253个OpenML 数据集上进行了对比实验。此外,为了能够逐步调整标签偏移的程度,我们使用逆频率过采样设计了一个评估基准(偏移强度β),该采样方式会更频繁地采样稀有类别。关键结果如下。
● 我们在全部三种 表格 基础模型 (TabPFN-v2、TabICL和LoCalPFN)上都观察到了一致的性能提升。例如,在强偏移条件下(β=5),DistPFN将TabICL的准确率提高了12.3%,DistPFN-T将其提高了13.7%(基于相对提升率)。● 在无偏移的典型条件下,它们保持原有性能。相比之下,EME和BBE等现有校准方法在无偏移时实际上出现了最高达1.7个百分点的性能下降。换言之,该方法在有偏移时有效,而在无偏移时不会导致性能下降。● 几乎没有额外的计算成本。基于TabPFN-v2,平均预测时间仅从1.002秒增加到1.003秒。● 模型性能接近 Oracle,后者假设已知测试标签的真实分布。基于六个偏移强度级别的平均准确率,Oracle达到0.796,而DistPFN-T达到0.792。
总之,DistPFN的优势在于,它能够在保持现有表格基础模型不变的情况下,仅在输出阶段添加一个简单的调整,从而提高类别不平衡场景下的可靠性。
ICML 2026时间序列深度学习研究趋势LG AI Research在本届会议上特别关注的领域是时间序列深度学习。今年展示的时间序列研究趋势可以归纳为四大类:①如何对时间序列进行分词,②预测模型实际学到了什么,③如何校正累积预测误差,④如何处理不规则的真实世界数据。
① 重新发现分词:用于高效时间序列预测的字节对编码本研究重新构想了将时间序列划分为token的方法[5]. 迄今为止,大多数时间序列基础模型都使用一种称为“分块(patching)”的方法,即将固定数量的样本归为一个token。然而,这种方法浪费了大量计算资源,因为即使是简单模式(例如数值长时间保持不变的区间),也会消耗相同数量的token。
作者从自然语言处理中广泛使用的 字节对编码(BPE)中汲取灵感,提出了首个以模式为中心的分词技术:通过收集频繁出现的 motif (在时间序列中反复出现的短模式片段)来构建词汇表,并利用该词汇表对时间序列进行自适应压缩。根据论文,这种基于motif的分词将最先进时间序列基础模型的预测性能平均提高了40%,同时还提升了效率。作者报告称,当与 条件解码(一种无需梯度计算或额外计算开销即可应用的后优化技术)结合使用时,MSE最多可降低48%。
这项研究之所以引人注目,是因为它带来了视角的转变,即认识到“时间序列token不一定必须具有相同长度”。它的重要意义不仅在于展示了语言模型中成熟的设计原则如何被扩展到时间序列,还在于它超越了简单的移植,精准地针对了时间序列所特有的反复出现的motif。
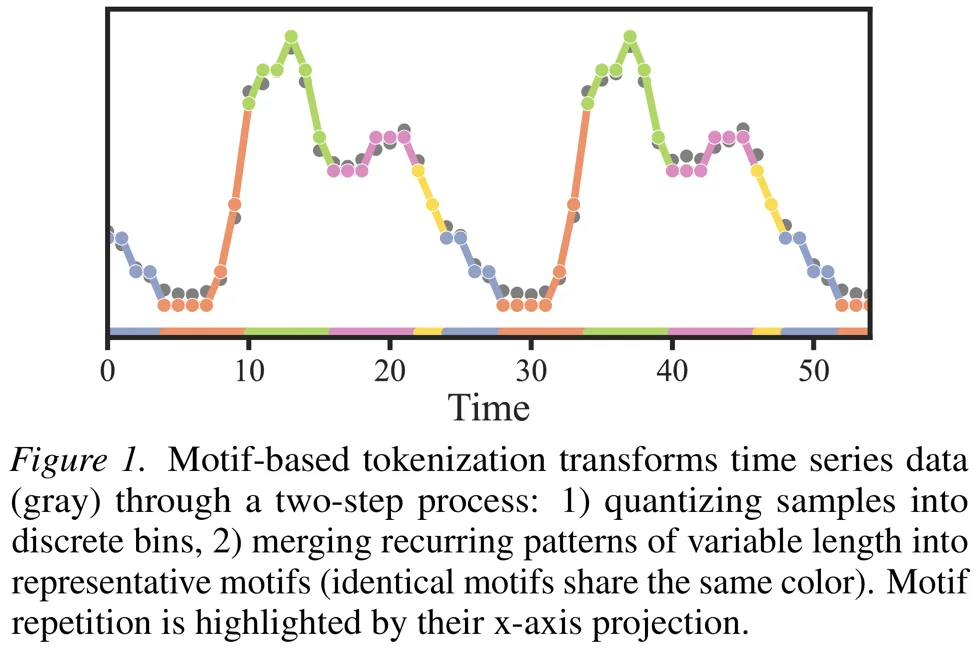
图3. 将时间序列量化为离散符号后,重复的变长模式被合并为单个motif token。(来源:Gotz 等, [5],图1)
② 模型真的在学习“动力学”吗?:从动力学视角看时间序列预测尽管近年来时间序列预测模型架构数量激增,但对于“为什么有些模型表现良好而另一些则不然”一直缺乏解释。本研究试图从 动力学[6].
的视角回答这一问题。作者假设,一个好的预测模型必须学习过去与未来时间点之间的直接联系,即动力学,并提出了一个名为 PRO-DYN 的框架,从这一视角对现有模型进行分类。结果得出了两个关键发现。第一,表现不佳的架构只是部分地学习了这些动力学。第二,模型中负责动力学的模块所在位置至关重要;将其置于模型末端时效果最佳。
本研究并未提出新的最先进(SOTA)模型,而是总结了现有模型共有的设计原则,因此具有很高的实际参考价值。
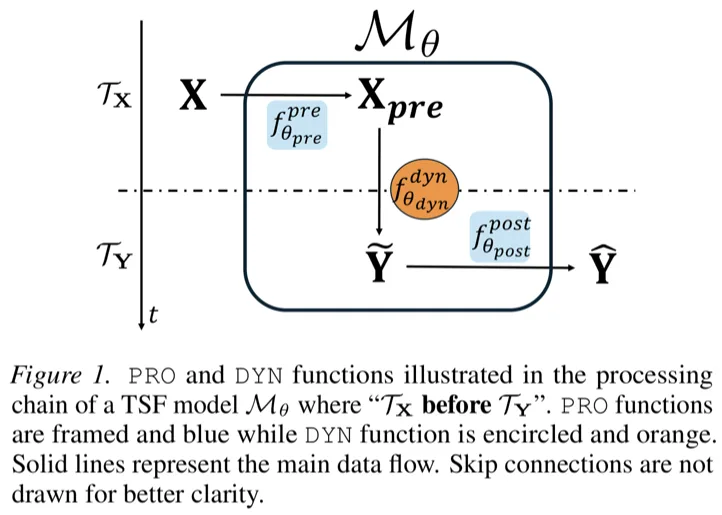
图4. 一个PRO-DYN系统,它将时间序列预测模型分解为通用处理(PRO)函数和动态(DYN)函数的组合。(来源:Brachet 等, [6],图1)
③ 经典技术的回归:在现代深度时间序列预测中复兴误差校正 在进行长期时间序列预测时,通常会采用 自回归 方法,即把模型的预测值作为输入反馈回去,以预测下一个时段。问题在于,先前预测的误差会被纳入后续预测的输入中,导致误差随着序列的推进而不断累积放大。这种误差累积是时间序列分析领域长期存在的难题。虽然经典统计模型拥有 误差校正机制(ECM) 来应对这一问题,但很难将其直接应用于深度学习模型。
本研究重新审视了ECM在现代深度学习背景下的作用与必要性,并提出了 UEC-STD,一种通用误差校正器,它将预测值分解为趋势分量和季节分量,并分别对二者进行校正[7]. 一个关键特性是,它可以被添加到现有预测器上而无需重新训练它们,无论预测模型的结构如何。结果表明,在四个骨干模型和十个数据集上,校准准确性和鲁棒性均有显著提升。
我们此前介绍的研究也共享这一理念:保持预训练模型不变,仅在事后调整输出。尽管存在差异——DistPFN 仅在推理时介入而无需任何训练,而 UEC-STD 则训练一个单独的校正器——但值得注意的是,“在不重新训练模型的情况下恢复性能”这一思路已在表格问题和时间序列问题中同时出现。
④ 面向不规则时间序列的时频组合:桥接时间与频率现实世界中的时间序列并不像教科书里那样按固定间隔观测。医疗记录和物联网传感器数据在不同时间被记录,且不同变量之间是异步的。在这种不规则多变量时间序列 (IMTS)中,不仅难以应用假设等间隔采样的现有模型,也难以应用基于傅里叶变换的技术,而后者在捕捉周期性方面尤为有效。这是因为傅里叶变换同样假设数据按固定间隔观测。
TFMixer 通过同时建模时域和频域来解决这一问题[8]. 首先,它引入了一种可训练的非均匀离散傅里叶变换 (非均匀DFT) ,以构建全局频率模块,即使从不规则的观测时间点也能直接提取频率成分。该模块与基于查询的局部时间模块相结合,后者用于补偿各区间之间信息密度的差异,并选择和聚合有意义的时间片段。最后,将来自两个域的表示相结合以生成预测,并通过逆NUDFT将频域中识别出的周期成分映射回时间轴,从而显式地扩展季节性。本研究并未因不规则性而放弃频率分析,而是通过重新设计变换本身以适应不规则性来解决该问题。
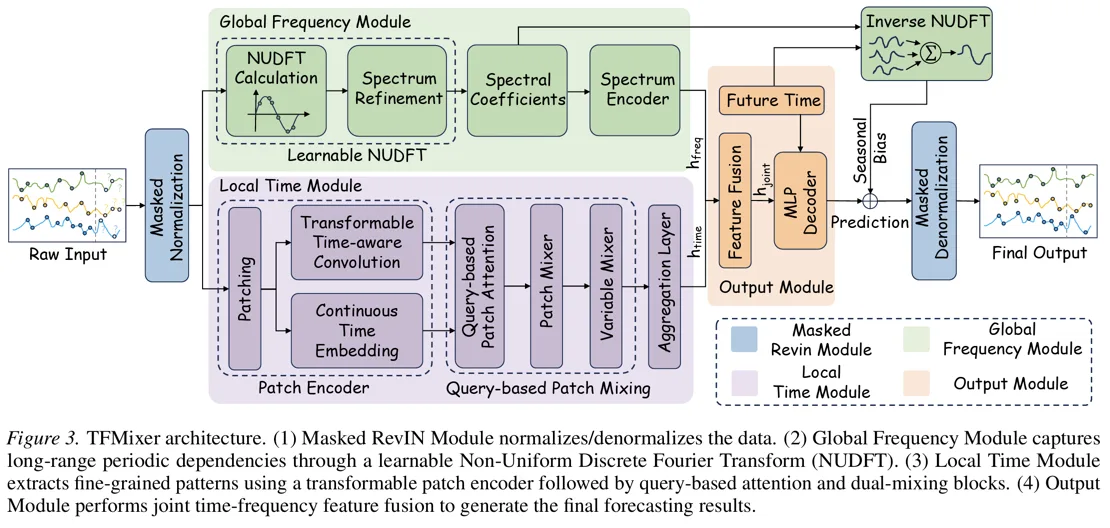
图5. TFMixer的结构。它使用可学习的非均匀离散傅里叶变换(NUDFT)捕捉全局周期性,
并使用基于查询的片段拼接捕捉局部模式。(来源:Qiu等, [8], 图3)
表格与时间序列的交汇:结构化数据基础模型研讨会 7月11日,即会议最后一天, FMSD(结构化数据基础模型) 研讨会聚焦于结构化数据的基础模型,在COEX大宴会厅举行[9]. 继去年在ICML 2025首次举办之后,这标志着该研讨会的第二届。本次研讨会提供了一个观察研究趋势的机会,该趋势将表格数据和时间序列数据视为一组统一的问题,而非彼此独立的领域。特别是,今年的研讨会聚焦于多模态结构化基础模型,这类模型将结构化数据与其他模态相结合,例如在医学诊断中同时使用图像和表格数据,或在心电图(ECG)解读中结合文本和时间序列数据。
其中,以下报告尤其值得关注。
● 基于先验数据拟合网络的时间序列因果基础模型[10] - 本研究将PFN(先验数据拟合网络,一种在合成数据上预训练的结构,在推理时仅根据给定上下文进行预测)——它构成了TabPFN的基础——扩展到时间序列的因果推断。它作为一个示例,表明LG AI Research所研究的表格数据ICL和时间序列预测最终同根同源。● TiViT:用于分类的时间序列表示潜藏于预训练视觉Transformer之中[11] - 本研究从预训练视觉Transformer已包含对时间序列分类有用的潜在表示这一视角,重新审视了跨模态迁移的可能性。● 表格基础模型是学习规则还是记忆样本?[12] / 表格基础模型实际上是浅层的[13] ——这些研究批判性地分析了表格基础模型实际学到了什么。它们展示了该领域日益增长的趋势:理解这些模型如何运作,而不仅仅是性能竞争。● 没有基础的基础:时间序列基础模型中的零样本盲点[14] ——本文被选为“Spotlight”报告,强调了时间序列基础模型零样本性能中的盲点。这与LG AI Research就表格数据中发现的标签偏移脆弱性所提出的担忧相一致。
结论:从性能到可靠性今年ICML 2026的一个显著转变是,结构化数据领域的关注点正从“有多准确”转向“有多可靠”。在表格数据领域,已出现剖析基础模型学到了什么的研究;而在时间序列领域,研究则聚焦于验证模型是否真正学到了动态,或识别零样本学习中的盲点。我们关于DistPFN的报告也符合这一趋势,因为它源于这样一个问题:“在什么条件下TabPFN表现不佳?”
来自真实工业环境的数据总是不平衡且不规则的,其分布会随时间变化。弥合这些仅凭基准平均准确率难以捕捉的差距,正是结构化数据研究创造切实价值之处。LG AI Research将继续开展涵盖表格和时间序列数据的基础模型研究,并将继续开发对数据分布变化具有鲁棒性、在真实环境中可靠的人工智能技术。
参考
[1] Hollmann, N. 等。“利用表格基础模型对小数据实现准确预测。”《自然》,2025年。
[2] ICML 2026会议,韩国首尔,2026年7月6日至11日。https://icml.cc/
[3] “宣布ICML 2026奖项。”《ICML博客》,2026年。https://blog.icml.cc/2026/07/05/announcing-the-icml-2026-awards/
[4] Lee, S. “通过测试时后验调整缓解表格上下文学习中的标签偏移。”ICML,2026年。https://arxiv.org/abs/2605.04363
[5] Gotz, L., Kollovieh, M., Gunnemann, S., Schwinn, L. “用于高效时间序列预测的字节对编码。”ICML,2026年。https://arxiv.org/abs/2505.14411
[6] Brachet, A.-R., Richard, P.-Y., Hudelot, C. “从动力学视角看时间序列预测。”ICML,2026年。https://arxiv.org/abs/2507.15774
[7] Nguyen, M.H. 等。“在现代深度时间序列预测中重振误差校正。”ICML,2026年。https://arxiv.org/abs/2605.21088
[8] Qiu, X., Yan, K., Liu, X., Wu, X., Hu, J. “连接时间与频率:面向不规则多元时间序列预测的联合建模框架。”ICML,2026年。https://arxiv.org/abs/2602.00582
[9] 第二届ICML结构化数据基础模型研讨会(FMSD),2026年。https://icml-structured-fm-workshop.github.io/
[10] Thumm, D. 等。“基于先验数据拟合网络的时间序列因果基础模型。”ICML 2026 FMSD研讨会,2026年。
[11] Roschmann, S. 等。“TiViT:隐藏于预训练视觉Transformer中的分类时间序列表示。”ICML 2026 FMSD研讨会,2026年。
[12] Rezaei Balef, A. 等。“表格基础模型是学习规则还是记忆样例?”ICML 2026 FMSD研讨会,2026年。
[13] Cannistraci, I., Vogt, J.E. “表格基础模型实际上是浅层的。”ICML 2026 FMSD研讨会,2026年。
[14] Ghoroghchian, N. 等。“有基础而无基本原理:时间序列基础模型中的零样本盲点。”ICML 2026 FMSD研讨会,2026年。
查看列表