←搜索结果

按匹配度 · 共 552 条结果 清除搜索

星期四

  1. Qwen Blog精选

    阿里千问发布 Qwen3.6-Plus,主打真实世界智能体能力

    阿里千问发布 Qwen3.6-Plus,通过阿里云百炼 API 提供,默认 1M 上下文窗口,重点提升智能体编码与多模态感知推理能力。官方基准显示其在 SWE-bench Verified 得 78.8、Terminal-Bench 2.0 得 61.6、QwenClawBench 得 57.2,均高于 Qwen3.5-397B-A17B。API 新增 preserve_thinking 参数用于保留多轮思考内容,默认关闭,可接入 Claude Code、Qwen Code、Cline、OpenCode 等编码工具。

    阿里千问发布 Qwen3.6-Plus,通过阿里云百炼 API 提供,默认 1M 上下文窗口,重点提升智能体编码与多模态感知推理能力。官方基准显示其在 SWE-bench Verified 得 78.8、Terminal-Bench 2.0 得 61.6、QwenClawBench 得 57.2,均高于 Qwen3.5-397B-A17B。API 新增 preserve thinking 参数用于保留多轮思考内容,默认关闭,可接入 Claude Code、Qwen Code、Cline、OpenCode 等编码工具。

    匹配字段摘要

星期四

  1. Noam Shazeer

    Gemini 3.1 Flash Live 现已开放使用,面向生产级语音智能体

    Gemini 3.1 Flash Live 现已开放使用,整体质量得到改进,支持开发者和企业规模化构建可完成复杂任务的语音优先智能体。该模型在 ComplexFuncBench Audio 的受约束多步函数调用和 Scale AI AudioMultiChallenge 的含中断长程推理测试中领先,并以多语言能力支持 Search Live 推广。

    Gemini 3.1 Flash Live 现已开放使用,整体质量得到改进,支持开发者和企业规模化构建可完成复杂任务的语音优先智能体。该模型在 ComplexFuncBench Audio 的受约束多步函数调用和 Scale AI AudioMultiChallenge 的含中断长程推理测试中领先,并以多语言能力支持 Search Live 推广。 · Gemini 3.1 Flash Live is now available with improved overall quality, enabling developers and enterprises to build voice-first agents that perform complex tasks at scale. It leads ComplexFuncBench Audio for constrained multi-step function calling and Scale AI’s AudioMultiChallenge for long-horizon reasoning with interrup

    匹配字段摘要

星期日

  1. Cognition 模型 / Devin 博客精选

    Cognition 发布 SWE-1.6 早期预览:SWE-Bench Pro 较 SWE-1.5 提升 11%

    Cognition 公布 SWE-1.6 的早期预览,该模型与 SWE-1.5 基于同一预训练模型做后训练,推理速度同为 950 tok/s,当前 checkpoint 在 SWE-Bench Pro 上比 SWE-1.5 高 11%。团队称通过改进 RL 配方和扩展基础设施获得两个数量级算力,训练步骤比 3 个月前快 6 倍,并使用低至 NVFP4 的精度和 NVIDIA Multi-Node NVLink 加速。目前该模型向少量用户开放早期访问以收集反馈,团队同时指出大规模 RL 带来了过度思考、过多轮次等影响模型使用体验的行为。

    匹配字段摘要

星期三

  1. Zyphra Research

    Zyphra 发布 ZUNA 脑机接口基础模型,推进思维转文本

    Zyphra 发布首个基于脑数据训练的基础模型 ZUNA,这是一个 380M 参数的扩散自编码器,可从有噪声或不完整的头皮 EEG 数据中重建高保真脑信号,并能从稀疏输入和电极坐标预测缺失通道,适配从消费级头戴设备到 256 电极研究系统的多种布局。ZUNA 在更高缩放因子下持续优于 MNE 中实现的球面样条插值这一行业标准方法。模型以 Apache 2.0 许可开源,权重发布于 Hugging Face,推理与预处理代码发布于 GitHub,并提供 pip install zuna 安装包。

    匹配字段摘要

  2. Claude Platform:开发者版本说明精选

    Anthropic 发布 Claude Sonnet 4.6,支持 1M token 上下文

    Anthropic 发布 Claude Sonnet 4.6,在编码、计算机使用、长上下文推理、智能体规划和知识工作等方面全面升级,并支持 1M token 上下文窗口(beta)。该模型现为 claude.ai 和 Claude Cowork 的默认模型,定价与 Sonnet 4.5 相同,起价 $3/$15 每百万 token。早期测试中,用户在 Claude Code 里对 Sonnet 4.6 的偏好度比 Sonnet 4.5 高约 70%,比 Opus 4.5 高 59%。

    匹配字段摘要

星期一

  1. 蚂蚁百灵:Developer Blog

    蚂蚁百灵发布并开源 Ling-2.5-1T 即时模型

    蚂蚁百灵发布并开源旗舰级即时模型 Ling-2.5-1T,总参数 1T、激活 63B,预训练语料从前代 20T 扩展至 29T,支持最高 1M token 上下文。模型采用 1:7 的 MLA + Lightning Linear 混合线性注意力架构,引入正确性与过程冗余复合奖励机制,在 AIME 2026 上平均输出约 5890 token 即接近消耗 15k–23K token 的前沿思考模型水平。官方称其在复杂推理与指令遵循上优于 DeepSeek V3.2、Kimi K2.5、GPT 5.2,可适配 Claude Code、OpenCode 等智能体产品,但在复杂智能体交互和长程任务上仍落后于前沿模型。

    匹配字段摘要、正文

  2. Qwen Blog精选

    Qwen3.5 发布:首个原生多模态智能体模型 Qwen3.5-397B-A17B

    Qwen 团队正式发布 Qwen3.5 系列首个开源权重模型 Qwen3.5-397B-A17B,这是一个原生视觉语言模型,在推理、编码、智能体和多模态理解等基准上给出完整评测结果。模型采用线性注意力(Gated Delta Networks)与稀疏 MoE 混合架构,总参数 397B、每次前向仅激活 17B,语言与方言支持从 119 种扩展到 201 种。托管版本 Qwen3.5-Plus 通过阿里云百炼提供,默认 1M 上下文窗口,并内置官方工具与自适应工具调用。

    匹配字段摘要

星期三

  1. 蚂蚁百灵:Developer Blog

    百灵发布全模态大模型 Ming-flash-omni-2.0 并开源权重

    蚂蚁百灵发布全模态大模型 Ming-flash-omni-2.0,基于 Ling-2.0(MoE 架构,100B-A6B)训练,相比 Preview 版本在全模态能力上有明显提升。该模型覆盖视觉百科识别、可控语音生成与图像生成编辑分割,官方称其为业界首个将语音、音效和背景音乐生成融为一体的模型,并首创将生成、编辑、分割融入单一原生模型。模型权重和推理代码已开源。

    01

    匹配字段摘要、正文

星期二

  1. Qwen Blog精选

    Qwen 发布 Qwen-Image-2.0 图像生成模型

    Qwen 团队发布下一代基础图像生成模型 Qwen-Image-2.0,将此前并行的生图与编辑两条路线合并为统一的生成与编辑模型。该模型支持 1k-token 指令直接生成 PPT、海报、漫画等信息图,原生支持 2K 分辨率,并采用更小的模型体积以提升推理速度。官方称在 AI Arena 盲测中,该模型在文生图与图生图基准上均取得更优表现。

    匹配字段摘要

星期一

  1. LG AI Research 官方博客

    LG AI Research 发布韩国国家级大模型 K-EXAONE

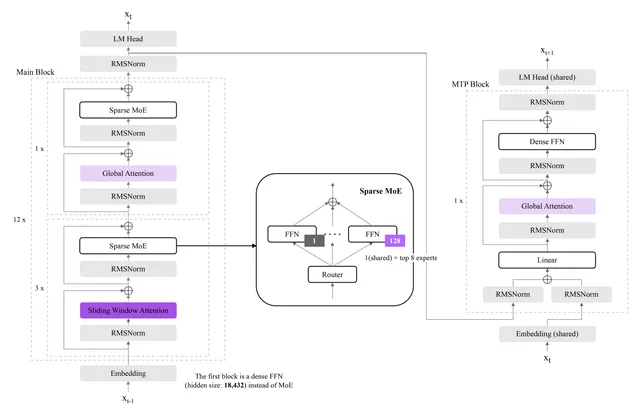
    LG AI Research 发布大规模模型 K-EXAONE,采用 128 专家的 MoE 结构,总参数 2360 亿、实际激活约 230 亿,并引入多 token 预测使推理速度约为现有模型的 1.5 倍。模型支持约 26 万 token 上下文,词表从约 10 万扩展到约 15 万,分词效率平均提升约 30%。后训练采用自研 AGAPO 强化学习算法与 GrouPER 偏好对齐方法,在 Artificial Analysis Intelligence Index 的开源权重模型中排名全球第 7、韩国第 1,模型已在 Hugging Face 和 Friendli AI 上线。

    匹配字段摘要

星期三

  1. Prime Intellect精选

    Prime Intellect 发布 INTELLECT-3:106B MoE 模型经大规模 RL 训练并开源全流程

    Prime Intellect 发布 INTELLECT-3,一个 106B 参数的 Mixture-of-Experts 模型,在 GLM-4.5-Air 基座上进行 SFT 和大规模 RL 训练,在数学、代码、科学和推理基准上取得同规模 SOTA。团队开源了模型权重、训练框架 prime-rl、verifiers 环境库及全部训练与评测环境,训练在 512 张 NVIDIA H200 GPU 上完成。模型可在 chat.primeintellect.ai 或通过 Inference API 使用。

    INTELLECT-3: A 100B+ MoE trained with large-scale RL

    匹配字段摘要

星期二

  1. Claude Platform:开发者版本说明精选

    Anthropic 发布 Claude Opus 4.5

    Anthropic 发布 Claude Opus 4.5,称其在编码、智能体和计算机使用上达到世界最佳,并在日常任务如深度研究和表格处理上有显著提升。模型现已在应用、API 和三大云平台可用,API 定价为每百万 tokens 输入 5 美元、输出 25 美元。同时更新了 Claude Developer Platform、Claude Code 和消费级应用,新增 effort 参数以控制推理强度,并提升了上下文管理和多智能体协调能力。

    匹配字段摘要

星期五

星期三

  1. Cognition 模型 / Devin 博客精选

    Cognition 发布 SWE-1.5 编码模型,与 Cerebras 合作实现最高 950 tok/s

    Cognition 发布面向软件工程的 SWE-1.5 模型,参数量达数千亿,在 SWE-Bench Pro 上接近前沿水平,并已上线 Windsurf。该模型与 Cerebras 合作部署,推理速度最高 950 tok/s,比 Haiku 4.5 快 6 倍、比 Sonnet 4.5 快 13 倍。Cognition 称其基于数千块 GB200 NVL72 芯片训练,并在自建 Cascade agent harness 与高质量编码环境中做端到端强化学习。

    匹配字段摘要

星期一

  1. MiniMax Blog精选

    MiniMax 开源并发布面向 Agent 与编码的 M2 模型

    MiniMax 正式开源并发布 MiniMax M2,定位为面向 Agent 与编码的模型,API 定价为每百万输入 token $0.30、每百万输出 token $1.20,约为 Claude 4.5 Sonnet 的 8%,在线推理 TPS 约 100。模型权重已在 Hugging Face 开源,支持 SGLang 与 vLLM 部署,推荐推理参数为 temperature=1.0、top_p=0.95、top_k=20,免费试用延长至 11 月 7 日 00:00 UTC。同时上线由 M2 驱动的 MiniMax Agent,提供 Lightning 与 Pro 两种模式,目前限时免费。

    MiniMax 正式开源并发布 MiniMax M2,定位为面向 Agent 与编码的模型,API 定价为每百万输入 token $0.30、每百万输出 token $1.20,约为 Claude 4.5 Sonnet 的 8%,在线推理 TPS 约 100。模型权重已在 Hugging Face 开源,支持 SGLang 与 vLLM 部署,推荐推理参数为 temperature=1.0、top p=0.95、top k=20,免费试用延长至 11 月 7 日 00:00 UTC。同时上线由 M2 驱动的 MiniMax Agent,提供 Lightning 与 Pro 两种模式,目前限时免费。

    匹配字段摘要

星期四

  1. Cognition 模型 / Devin 博客

    Cognition 发布 SWE-grep 与 SWE-grep-mini,主打快速上下文检索

    Cognition 发布 SWE-grep 和 SWE-grep-mini 两个专攻高并行上下文检索的智能体模型,称其检索能力追平前沿编码模型,耗时却少一个数量级,现已用于 Windsurf 新的 Fast Context 子智能体。模型每轮最多发起 8 个并行工具调用、最多 4 轮,经多轮强化学习训练后再蒸馏出 mini 版;借助 Cerebras 推理,SWE-grep-mini 超过 2800 tokens/秒,SWE-grep 超过 650 tokens/秒,对比 Haiku 4.5 的 140 tokens/秒分别快 20 倍和 4.5 倍。Fast Context 将随最新版本逐步向 Windsurf 用户开放,无需额外 UI 或命令,也可在 playground.cognition.ai 试用。

    匹配字段摘要

星期三

  1. Liquid AI 模型与工程博客

    Liquid AI 发布 LFM2-Audio-1.5B 端到端音频基础模型

    Liquid AI 发布 LFM2-Audio-1.5B,一个端到端音频与文本生成基础模型,仅 1.5B 参数,支持音频和文本的任意输入输出组合。该模型在 VoiceBench 上取得 56.8 总分,端到端延迟低于 100 ms,推理速度比同类模型快 10 倍以上,可覆盖实时对话、ASR、TTS 和音频分类等场景。

    匹配字段摘要

星期二

  1. Liquid AI 模型与工程博客

    Liquid AI 发布 LFM2-2.6B 模型

    Liquid AI 发布 LFM2 系列目前最大的模型 LFM2-2.6B,参数规模 2.6B,基于 10 万亿 token 训练,在 GSM8K 上达到 82.41%、IFEval 上达到 79.56%,官方称其表现超过 Llama 3.2-3B-Instruct、Gemma-3-4b-it 和 SmolLM3-3B 等 3B+ 级别模型。该模型主要针对英语和日语调优,同时保持法语、西班牙语、德语、意大利语、葡萄牙语、阿拉伯语、中文和韩语的性能。其混合架构交替使用 Grouped Query Attention(GQA)与短卷积层,官方称可带来更快的推理速度和更低的 KV cache 占用。模型已在 Hugging Face 上以 LFM Open License 开放。

    匹配字段摘要

星期二

  1. Liquid AI 模型与工程博客

    Liquid AI 发布 LFM2-VL 视觉语言模型,含 450M 与 1.6B 两个版本

    Liquid AI 发布首个视觉语言模型系列 LFM2-VL,包含 LFM2-VL-450M 和 LFM2-VL-1.6B 两个版本,面向低延迟与端侧部署,支持文本和可变分辨率图像输入。模型基于 LFM2 骨干,视觉塔采用 SigLIP2 NaFlex 编码器,原生分辨率最高 512×512,更大图像按 512×512 分块处理,官方称在 GPU 上推理速度最高可达同类模型的 2 倍。模型已兼容 Hugging Face transformers 和 TRL,训练使用约 1000 亿多模态 token。

    匹配字段摘要

星期三

  1. Claude Platform:开发者版本说明精选

    Anthropic 发布 Claude Opus 4.1,编码与智能体任务升级

    Anthropic 发布 Claude Opus 4.1,在智能体任务、真实编码和推理上较 Opus 4 升级,SWE-bench Verified 达 74.5%。现已向付费用户、Claude Code、API、Amazon Bedrock 和 Google Cloud Vertex AI 开放,价格与 Opus 4 相同。GitHub、Rakuten 和 Windsurf 反馈其在多文件重构、精准修复和初级开发者基准上均有显著提升。

    匹配字段摘要