N全部新闻

星期二63 条

  1. OpenAI:部署安全与系统卡一手模型发布
    AI 评分86

    OpenAI 发布 gpt-oss-120b 与 gpt-oss-20b 模型卡

    OpenAI 发布 gpt-oss-120b 和 gpt-oss-20b 两个开放权重推理模型,采用 Apache 2.0 许可,兼容 Responses API,支持工具调用、完整 CoT 与可调推理强度。gpt-oss-120b 为 36 层 MoE 架构,116.8B 总参数、5.1B 激活参数,MoE 权重以 MXFP4 量化后可放入单张 80GB GPU;gpt-oss-20b 为 24 层、20.9B 总参数、3.6B 激活参数,可在 16GB 内存设备上运行。OpenAI 对 gpt-oss-120b 做了对抗性微调测试,其安全咨询组认为即便使用其训练栈进行微调,模型也未在生物化学与网络安全两个类别达到 Preparedness Framework 的高能力阈值。
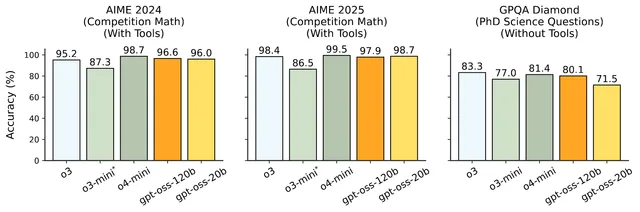
    Figure 1. <em>Main capabilities evaluations</em>. We compare the gpt-oss models
at reasoning level <code>high</code> to OpenAI’s o3, o3-mini, and
o4-mini on canonical benchmarks. gpt-oss-120b surpasses OpenAI o3-mini
and approaches OpenAI o4-mini accuracy. The smaller gpt-oss-20b model is
also surprisingly competitive, despite being 6 times smaller than
gpt-oss-120b. <em>*Note:</em> o3-mini was evaluated on AIME without
tools, see Table <a class="xref-link" data-xref="tab:all_evals" href="/gpt-oss/full-evaluations#tab:all_evals">3</a> for the gpt-oss
models on AIME without tools

    #模型发布#开源生态#推理

  2. OpenAI:部署安全与系统卡一手模型发布
    AI 评分69

    OpenAI 发布 GPT-Live-1 与 GPT-Live-1 mini 语音模型系统卡

    OpenAI 发布新一代语音模型 GPT-Live-1 和 GPT-Live-1 mini,两者均为全双工,可持续聆听并响应,能跟随停顿、打断和语速变化;GPT-Live-1 将作为付费用户默认语音模型,mini 版面向免费用户。系统卡称新模型在语音原生评测中整体安全表现与 Advanced Voice Mode 持平或更好,但 GPT-Live-1 在情感依赖上从 0.88 降至 0.82,mini 在性内容上从 0.97 降至 0.92。OpenAI 还说明 2026 年 8 月 4 日发现评测配置与最终发布模型不一致,已用正确配置重跑并附上原始值与修正值对照,修正后部分指标出现统计显著下降,但均未低于其安全发布标准。

    #安全/对齐#语音#OpenAI

  3. OpenAI:部署安全与系统卡一手模型发布
    AI 评分87

    OpenAI 发布 GPT-6 Sol 与 GPT-6 Luna 系统卡

    OpenAI 在 ChatGPT 免费与付费方案中向全球用户推出 GPT-6,取代 GPT-5.6 Sol 和 GPT-5.6 Luna,Codex 与 ChatGPT Work 中仍使用此前版本。系统卡显示,GPT-6 对越狱(含多轮自适应攻击)的抵抗力更强,不诚实、欺骗和绕过护栏的行为减少,指令层级评测中 GPT-6 Sol 与 Luna 分别达到 99.99% 和 99.79% 的稳健性。同时 GPT-6 Sol 在标准自我伤害类别出现统计显著回退,GPT-6 Luna 在自我伤害、血腥和性内容上出现回退,OpenAI 称人工复核后违规程度总体较低。按 Preparedness Framework,两款模型在网络安全和生物化学领域被列为 High capability,均未达到 AI 自我改进的 High 阈值。

    Figure 1. Safety and non-overrefusal on challenging prompts. Higher is better
on both axes.

    #模型发布#安全/对齐#OpenAI

  4. OpenAI:部署安全与系统卡一手模型发布
    AI 评分91

    OpenAI 发布 GPT-6 Astra 系统卡

    OpenAI 发布 GPT-6 Astra 系统卡,宣布这是其迄今能力最强、已广泛部署的模型,也是首个在 Preparedness Framework 下达到网络安全 Critical 等级的模型。系统卡称 Astra 对越狱和提示注入的鲁棒性显著强于 GPT-5.6 Sol,间接提示注入鲁棒性从 96.23% 升至 99.79%,在 54,218 个内部 Codex 任务模拟中严重度 3 级及以上的错位行为标记减少约 53%。同时 OpenAI 指出 Astra 的 CoT 可监控性相对 GPT-5.6 Sol 下降,在对抗条件下可能规避内部监控,因此将错位监控扩展到全部工具调用推理。

    Figure 1

    #安全/对齐#OpenAI#部署/工程

  5. OpenAI:部署安全与系统卡一手模型发布
    AI 评分80

    OpenAI 发布 GPT-6.1 Sol 系统卡增补:安全评估与 GPT-6 Astra 对比

    OpenAI 发布 GPT-6.1 Sol,称其能力接近 GPT-6 Astra,兼顾速度与成本,并按 Preparedness Framework 将其网络安全定为 Critical、生物化学定为 High,沿用与 Astra 相同的防护措施。系统卡显示,GPT-6.1 Sol 在 Production Benchmarks 的八个类别中有五个高于 GPT-6 Sol,在 HealthBench 四项评测中与 GPT-6 Astra 差距在 0.5 个百分点以内,且未尝试绕过监控。在内部 Codex 流量部署模拟中,其严重度 3 级及以上的错位行为标记为 28 个(0.056%),低于 GPT-6 Sol 的 42 个和 GPT-5.6 Sol 的 63 个。

    #模型发布#安全/对齐#OpenAI

  6. OpenAI:部署安全与系统卡一手模型发布
    AI 评分85

    OpenAI 发布 GPT-5.6 八月更新系统卡

    OpenAI 更新 ChatGPT 默认模型,免费与 Go 用户获得新的日常对话默认模型,Plus 和 Pro 用户获得带 effort 滑块的 GPT-5.6 Sol,这些模型将取代 GPT-5.5 Instant;Codex 与 ChatGPT Work 中的 GPT-5.6 Sol 和 GPT-5.6 Luna 仍为 7 月版本。按 Preparedness Framework,本次 8 月版 GPT-5.6 Sol 和 GPT-5.6 Luna 在网络安全与生物化学两个领域均被定为 High 能力,AI 自我改进未达 High 阈值,并沿用 GPT-5.6 系统卡中的防护措施。系统卡首次纳入面向 18 岁以下用户的 U18 专项评测,覆盖自残、饮食失调、年龄限制商品与服务、暴力内容和不当性内容等场景;GPT-5.6 Sol 与 Luna 在这些类别表现良好,与 GPT-5.5 变体相比无统计显著差异。

    Figure 1

    #模型发布#OpenAI#安全/对齐

  7. OpenAI:部署安全与系统卡一手模型发布
    AI 评分67

    OpenAI 发布 GPT-5.3 Instant 系统卡

    OpenAI 发布 GPT-5.3 Instant 系统卡,该模型是 GPT-5 系列新成员,响应更快、联网搜索时答案上下文更丰富,并减少不必要的死胡同、免责声明和过于武断的措辞。安全评估显示,它在禁用内容评测上平均高于 gpt-5.1-instant、低于 gpt-5.2-instant,在禁用性内容和自残类别上相对前代出现退步,图形暴力与暴力非法行为类别的退步统计显著性较低。HealthBench 上得分为 54.1%(-1.3%),Hard 为 25.9%(-0.9%),Consensus 为 95.3%(-0.5%)。

    #模型发布#安全/对齐#OpenAI

  8. OpenAI:部署安全与系统卡一手模型发布
    AI 评分63

    OpenAI 发布 ChatGPT Images 2.5 系统卡

    OpenAI 发布 ChatGPT Images 2.5 系统卡,介绍 GPT-Image-2.5-Sunburst 和 GPT-Image-2.5-Flare 两个模型。新模型在图像编辑一致性、信息图准确度与排版上有所提升,并新增草图生成、模板和共享提示词等功能。安全方面,OpenAI 称其安全栈沿用 ChatGPT Images 2.0 基础并针对更高真实感带来的深度伪造风险增加防护,同时通过 C2PA 元数据和 Google DeepMind 的 SynthID 水印强化来源标注。

    #安全/对齐#图像生成#OpenAI

  9. Latent Space模型发布
    AI 评分74

    Meta MSL 发布 Muse Wonder 与 Muse Wonder Full 模型

    Meta Superintelligence Labs 发布第二代模型家族 Muse Wonder 与 Muse Wonder Full,前者定位快速前沿模型,后者为完整版本,Meta 称其面向个人与专业智能体工作。Artificial Analysis 的 Intelligence Index v4.3 中 Wonder Full 得 56 分、Wonder 得 52 分,高于 Muse Spark 1.3 的 48 分,Opus 5.5 以 58 分领先。规格为 1M 上下文,输入支持文本、图像、视频和音频,输出仅文本,定价为每百万 token 输入 4 美元、缓存输入 0.20 美元、输出 20 美元。

    #模型发布#Agent#编码

  10. The Elec模型发布
    AI 评分74

    Meta 发布 Muse Wonder 系列模型,主打 Active Memory 与 Active Focus

    Meta 于 10 月 13 日发布前沿模型 Muse Wonder 系列,包含 Muse Wonder 和 Muse Wonder Full 两个版本,均仅通过每月 50 美元或 200 美元的付费订阅提供。Muse Wonder 可通过 SDK 或按量付费 API 供开发者接入,Muse Wonder Full 无对外 API 或 SDK,仅限 Meta 自有环境使用,更适合长周期复杂任务。该系列主打 Active Memory 与 Active Focus 两项能力,前者主动保留历史对话与用户上下文,后者在任务受阻时尝试替代方案。在 Artificial Analysis 评测中,Muse Wonder Full 在 CritPt 科学推理测试和 GDP.pdf 专业文档基准中排名第一,Terminal-Bench 4.0 得分从上一版的 33% 升至 57%;Intelligence Index 上 Muse Wonder 得 52 分、Muse Wonder Full 得 56 分,后者与 Claude Sonnet 5.5 并列第二。AA 称两款模型输出 token 用量比 Muse Spark 少约 10%,Muse Wonder Full 输入 token 比 Muse Wonder 少 16%。Muse Wonder 定价为每百万输入 token 4 美元、每百万输出 token 20 美元。

    同一事件 · 22 条报道

    #模型发布#Agent#推理

  11. 虎嗅模型发布
    AI 评分72

    Meta 发布 Muse Wonder 与 Muse Wonder Full,长程编程测试超过 Claude…

    Meta Superintelligence Labs 于 10 月 13 日推出新一代旗舰模型 Muse Wonder 和 Muse Wonder Full,Full 版在 Artificial Analysis 综合智能指数得 56 分,距 Claude Opus 5.5 的 58 分差 2 分。在 DeepSWE 1.1 长程软件工程测试中,Wonder Full 取得 79.0 分,超过 Opus 5.5 的 74.2 分和 GPT-6 Astra 的 74.1 分,但 Terminal-Bench 4.0 和 ProgramBench 仍落后于 Opus。Artificial Analysis 测算其平均任务成本达 4.52 美元,较上代 Muse Spark 1.3 上涨 183%;开发者同题对比显示其 3D 游戏生成效果明显逊于 Opus,Meta 模型卡已承认 3D 任务为已知局限。

    同一事件 · 22 条报道

    #模型发布#Agent#编码

  12. 虎嗅模型发布
    AI 评分80

    Meta发布Muse Wonder系列模型,主打个人智能体记忆与长程任务

    Meta发布Muse Wonder和Muse Wonder Full两款模型,内部代号西瓜,主攻个人与专业智能体任务,重点提升跨对话记忆和长时间任务执行能力。Artificial Analysis评测显示Wonder Full十项测试有六项进入前三,最高推理强度下Muse Code搭配Wonder Full的编程成绩与Claude Code搭配Sonnet 5.5持平。API定价为每百万输入token 4美元、输出20美元,Wonder Full仅向Muse Code订阅用户开放,Meta AI负责人Alexandr Wang承认编程能力仍不如Opus 5.5。

    同一事件 · 22 条报道

    #模型发布#Agent#编码

  13. David Singleton模型发布
    AI 评分55

    Muse Wonder 模型发布,面向个人智能体并率先向订阅用户开放

    Muse Wonder 模型发布,定位为驱动个人智能体,已率先向订阅用户开放。该模型包含 Active Memory、Active Focus 和领域专长三项能力,官方称其记忆覆盖天、周、月尺度,并在金融与法律领域达到 SOTA、在健康领域表现较强。David Singleton 表示自己已使用一段时间,认为模型在 Active Focus 和 Active Memory 下更努力地工作、调用记忆更精准。

    MUSE WONDER 🍉 this model was developed to power personal agents. three highlights: - ACTIVE MEMORY: best memory across days/weeks/months - ACTIVE FOCUS: gets your tasks done - DOMAIN EXPERTISE: sota in finance &amp; legal, strong in health https://t.co/Zoa66r4WOR

    同一事件 · 22 条报道

    #产品更新#Agent#OpenAI

  14. AI at Meta一手模型发布
    AI 评分66

    Meta 发布 Muse Wonder 与 Muse Wonder Full 两款前沿模型

    Meta 推出 Muse Wonder 系列,包含 Muse Wonder 和 Muse Wonder Full 两款前沿模型,面向个人与专业智能体任务。Muse Wonder 即日起通过 Meta Model API 和 Muse Code 提供,Muse Wonder Full 面向 Muse Code 订阅用户开放,Muse Wonder 后续还将接入个人智能体产品 Muse,先向订阅用户推送。两款模型在个人与专业智能体、记忆和编码等基准上取得 SOTA,并具备 Active Memory 跨对话保留上下文、Active Focus 在任务受阻时尝试替代方案并坚持完成的能力。

    同一事件 · 22 条报道

    #模型发布#Agent#OpenAI

  15. AI at Meta一手模型发布
    AI 评分67

    Meta 发布 Muse Wonder 系列模型,主打个人与专业智能体任务

    Meta 发布 Muse Wonder 和 Muse Wonder Full 两款前沿模型,称其在个人与专业智能体、记忆和编码等关键基准上取得 SOTA。Muse Wonder 即日起通过 Meta Model API 和 Muse Code 提供,Muse Wonder Full 面向 Muse Code 订阅用户;Muse Wonder 还将接入个人智能体产品 Muse,先向订阅用户开放。两款模型引入 Active Memory 跨对话保留上下文,以及 Active Focus 在任务受阻时尝试替代方案并坚持完成目标。

    同一事件 · 22 条报道

    #模型发布#Agent#编码

  16. AI at Meta一手模型发布
    AI 评分62

    Meta 发布 Muse Wonder 与 Muse Wonder Full 两款前沿模型

    Meta 发布 Muse Wonder 系列,包含 Muse Wonder 和 Muse Wonder Full 两款前沿模型,面向个人与专业智能体任务。Muse Wonder 即日起通过 Meta Model API 和 Muse Code 提供,Muse Wonder Full 面向 Muse Code 订阅用户开放,Muse Wonder 后续还将接入个人智能体产品 Muse,先向订阅用户推送。两款模型引入 Active Memory 跨对话保留上下文、Active Focus 在任务受阻时尝试替代方案并推进到完成,官方称其在个人与专业智能体、记忆和编码基准上取得 SOTA 结果。

    同一事件 · 22 条报道

    #模型发布#Agent#OpenAI

星期一1 条

  1. MarkTechPost模型发布
    AI 评分67

    Cloudflare 发布 Clef-omni:30B-A3B 多模态决策模型

    Cloudflare 发布开源权重多模态决策模型 Clef-omni,可在一次调用中对文本、图像、音频和视频打分,基于 Qwen3-Omni-30B-A3B-Instruct 后训练,采用 30B 总参数、3B 激活参数的 MoE 结构,Apache-2.0 许可,定价每百万 token 0.15 美元。它在意图分类任务上领先,CLINC150+OOS 达 97.7 macro-F1,但在推理与工作流评测上落后于 Clef,GPQA Diamond 为 47.4,而 Jev 为 78.3。同批更新将 Clef-flash 价格降至 0.038 美元,并把托管 Clef 迁移到 SGLang,中位延迟从 262 ms 降至 152 ms。

    #模型发布#多模态#开源生态

星期日6 条

  1. Hacker News 热门模型发布
    AI 评分71

    微软发布 Decision-1 决策打分模型,基于 Qwen3.5-9B 后训练

    微软于 10 月 9 日推出 Microsoft-Decision-1,它不生成文本,而是对预设答案选项做单次前向打分并返回每个选项的校准概率,用于路由、分类、优先级排序和验证。该模型基于阿里 Qwen3.5-9B 后训练,已在 Microsoft Foundry 公测并上线 OpenRouter,标识为 microsoft/microsoft-decision-1,权重不对外分发。微软称其在 36 个基准、约 15 万道留出题上取得 83.5% 准确率,并计划后续把底座迁移到 MAI 和 OpenAI 模型;OpenRouter 列表显示价格为每百万输入 token 0.042 美元、输出免费。

    同一事件 · 5 条报道

    #模型发布#推理#部署/工程

  2. MarkTechPost模型发布
    AI 评分57

    OrcaRouter 发布 OrcaCyber Zero 1.5 安全模型,支持 1M 上下文

    OrcaRouter 发布 OrcaCyber Zero 1.5,这是 OrcaCyber Zero 1.0 的后继模型,面向授权漏洞复现、漏洞利用开发和渗透测试,支持 1M token 上下文窗口、原生函数调用和结构化输出。厂商自报成绩为 Cybench 100%(39/39,无限制智能体执行)、CVE-Bench 95.8%(24 个可评估任务中的 23 个)、HumanEval+ 93.9%、SWE-bench Pro V2 76.5%。模型仅通过 OrcaRouter 托管 API 提供,使用 OpenAI 兼容接口,base_url 为 https://api.orcarouter.ai/v1,调用 orca/orcacyber-zero-1.5,访问受 Security Research 层级限制,定价为每 1M 输入 token 3.00 美元、每 1M 输出 token 7.50 美元。

    #模型发布#安全/对齐#Agent

  3. Thinking Machines Lab:官方博客一手模型发布
    AI 评分79

    Thinking Machines Lab 发布开源权重模型 Inkling

    Thinking Machines Lab 发布从零训练的开源权重模型 Inkling,采用 MoE 架构,总参数 975B、激活 41B,支持最高 1M token 上下文窗口,预训练数据为 45 万亿 token 的文本、图像、音频和视频。该模型原生支持文本、图像和音频推理,并可通过可控思考力度平衡性能与 token 效率,今日起在 Tinker 上开放微调,完整权重已上传 Hugging Face。官方同时预览了 12B 激活参数的轻量版 Inkling-Small,称其在多项基准上接近或超过 Inkling,测试完成后将发布完整权重。

    同一事件 · 2 条报道

    #模型发布#开源生态#多模态