←搜索结果

按匹配度 · 共 499 条结果 清除搜索

星期五

  1. 凤凰科技

    OpenAI 基于 GPT-6 Luna 全面开放决策 API

    OpenAI 宣布全面开放基于 GPT-6 Luna 构建的决策 API(Decisions API),面向具有限定答案的问题,响应速度比通过 Responses API 调用 GPT-6 Luna 提升高达 10 倍。该 API 输入每百万 token 收费 0.10 美元,命中缓存的输入每百万 token 收费 0.01 美元,仅按输入 token 计费、输出 token 免费。公测以来新增原生 GPT-Live 集成、Prompt 缓存和美国及欧盟的推理数据驻留支持,单次请求最多可提交 400 个问题。

    匹配字段摘要、正文

  2. IT之家·人工智能精选

    OpenAI 全面开放决策 API,基于 GPT-6 Luna,输入每百万 token 0.1 美元

    OpenAI 宣布全面开放决策 API(Decisions API),该 API 基于 GPT-6 Luna 构建,面向具有限定答案的问题,协助应用与智能体基于文本、图像及结构化输入做出准实时决策,响应速度比通过 Responses API 调用 GPT-6 Luna 提升高达 10 倍。定价上输入每百万 token 收费 0.1 美元,命中缓存的输入每百万 token 收费 0.01 美元,仅按输入 token 计费、输出 token 免费。自公测以来新增原生 GPT-Live 集成、Prompt 缓存和美国与欧盟的推理数据驻留支持,单次请求最多可提交 400 个问题。

    匹配字段摘要、正文
  3. TechCrunch AI

    OpenAI 全面开放 Decisions API,与 TypeSafe 的 Jev 争夺决策模型市场

    OpenAI 于周四向所有客户开放 Decisions API,该产品在 9 月 29 日的开发者日上发布,基于 ChatGPT Luna 重新配置以加快推理并降低成本。OpenAI API 产品负责人 Nikunj Handa 称,延迟从 1 至 3 秒缩短到 100、120、180 毫秒,公开版本新增语音和视觉模态,并按地域部署推理资源以降低延迟。在 Box、Datadog、Ramp、Speak 的初期试用中,Speak 将操作间隔从 1.4 秒降至 0.13 秒;在 AIM System One Index 和 Artificial Analysis Decision Index 上,OpenAI 的决策模型分别排第八和第十四,落后于 Liquid 的 D1 Ultra 和 Base Lab 的 Elephant-1。

    匹配字段摘要、正文

  4. Cohere 产品与研究博客

    Cohere Model Vault 上线机密计算公测

    Cohere 宣布 Model Vault 的机密计算功能进入公开测试,基于 Microsoft Azure 上的 NVIDIA H100 GPU 机密计算能力,为托管模型推理提供硬件级隔离。该功能把加密范围从静态存储和传输中的数据扩展到推理运行中的提示词、文档、响应和模型执行,应用负载端到端加密后只能在通过远程证明的机密环境中解密。客户可在发送敏感数据前用密码学方式核验硬件、固件和软件配置,不符合安全策略时客户端会拒绝发送请求,现有 Model Vault API 和请求格式保持不变。

    Rerank 5 logo

    匹配字段摘要、正文

星期四

  1. Modal 官方工程博客精选

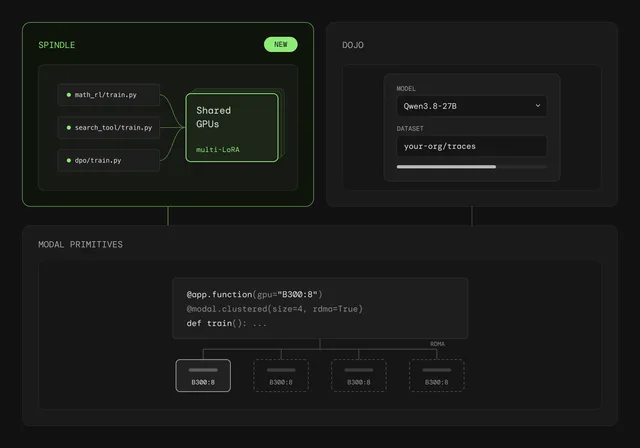
    Modal 发布开源训练服务器 Spindle,兼容 Tinker API

    Modal 发布开源训练服务器 Spindle,可在自家 Modal workspace 中运行,兼容 Tinker API,按 GPU 时长而非 token 计费。部署只需执行 spindle deploy,支持全参数训练和多 LoRA,覆盖多种开源模型。官方给出的对比中,DAPO-math 单轮任务在 8 卡 H200 训练、8 卡 H200 推理、8 个客户端共享时价格为每百万输出 token 1.99 美元,较 Tinker 降低 80%。

    The Modal post-training stack: Modal Dojo for hands-off training, Spindle for writing your own loop, and Modal primitives for full control

    匹配字段摘要、正文

  2. LMSYS Blog

    LMSYS 发布 SGLang AWS Trainium 插件 Beta

    LMSYS 与 AWS 合作发布 SGLang Trainium 插件 Beta,基于新发布的 TorchNeuron 构建,在 Trainium2 和 Trainium3 上支持 LLM 推理服务与 RL rollout 生成。初始覆盖 Qwen3(dense)、Qwen3-MoE-30B-A3B、DeepSeek-V2-Lite、GLM-4 和 GLM-5.2/5.3,并支持数据并行、张量并行、专家并行、Radix Cache、BF16/FP8 和异步调度。首次端到端异构 RL 运行中,SGLang 在 Trainium3 上为 Qwen3-MoE-30B-A3B 生成 rollout,Miles 在单台 H200 节点上用 Megatron 训练 GRPO 策略。Beta 目前仅限少量团队参与。

    匹配字段摘要

  3. MiniMax

    MiniMax M3.1 Flash 上线 Runware,调用串为 minimax:m3.1@flash

    MiniMax 官方表示 M3.1 Flash 已上线 Runware,调用时使用模型串 "minimax:m3.1@flash"。据 Runware 介绍,该模型支持文本、图像和视频输入,上下文窗口 1M、最多 524K 输出 token,推理深度可调,在 Artificial Analysis Intelligence Index 上得 42 分,AutomationBench-AA 为 72.5%,DeepSWE 为 73.7%,单 token 价格低于 MiniMax M3。

    匹配字段摘要

  4. PyTorch Blog

    TorchTitan 更新:新增多款 SOTA 模型支持、TitanRL 与大规模性能提升

    PyTorch 原生训练平台 TorchTitan 发布更新,新增 Muse Spark Open、Muse Glimmer、Qwen3-VL、Qwen3.5、Kimi K2.7、Kimi K3 和 DeepSeek-V4 的完整训练栈支持,并引入强化学习组件 TitanRL。TitanRL 让预训练、后训练到 vLLM 推理共用同一份模型代码,支持异步 rollout 和长上下文、代码执行等智能体任务训练。性能方面,FlexShard 在 256 张 H100 上把 DeepSeekV3 的优化器耗时最多降低 79%,在 Llama3 405B 上把端到端训练步时最多降低 20%。

    匹配字段摘要

星期三

  1. cnBeta

    Perplexity Computer 新增 Mac 本地运行模式

    Perplexity 宣布 Mac 版应用支持 Computer 代理完全在本机运行,任务规划、推理、文件处理和工具执行都在设备端完成,代码与工具执行在隔离沙盒中进行。本地模式使用 Qwen 3.6 或基于 Qwen 训练的 PPLX Pro 模型,面向支持的 Apple 芯片 Mac,建议至少 36GB 内存,目前提供给 Pro、Max 和 Enterprise 订阅用户。另提供混合计算模式,由云端模型负责联网研究、本地模型处理私人文件,官方称可在至少 24GB 统一内存、运行 macOS 15 或更新版本的 Apple 芯片 Mac 上使用。

    匹配字段摘要、正文

  2. MacRumors Apple Intelligence

    Perplexity Computer 支持在 Mac 上完全本地运行

    Perplexity 宣布更新 Perplexity Computer,使其可在受支持的 Apple silicon Mac 上完全本地运行,模型基于 Qwen 3.6 或 PPLX Pro(Qwen 的后训练版本)。本地模式下模型、任务规划、推理和文件处理都在设备端完成,代码与工具执行在隔离沙箱中进行,官方建议 36GB 以上内存,并称可跨 Notes、Messages、Mail、Keynote、Numbers 等原生应用完成任务而无需上传个人数据。对于性能不足的设备,Perplexity 还提供 Hybrid Compute,以云端前沿模型配合本地模型处理信息,最低 24GB 内存即可使用;任务需要实时信息或云端应用时可授权云端访问,也可调用 15 个以上前沿模型。

    匹配字段摘要

  3. Thurrott

    Gemini 个人智能功能登陆 Android Auto 与内置 Google 汽车

    Gemini 的 Personal Intelligence 功能开始向 Android Auto 推送,开启后可连接 Gmail、Google Calendar、Google Photos 和 Google Search 中的用户数据,提供更个性化的回答。该功能在 Gemini 设置中完全由用户主动选择开启,未来几个月还将登陆直接运行 Google 车载系统的内置 Google 汽车。Google 高级产品经理 Karan Daryanani 表示,该功能的两项核心能力是从邮件、照片或 Google Maps 收藏地点中提取具体细节,以及跨复杂来源进行推理。

    匹配字段摘要、正文

  4. The New Stack

    ElevenLabs 推出 Eleven Realtime 托管语音智能体,开发者需让出底层模型控制权

    ElevenLabs 发布 Eleven Realtime,提供 Mini 和 Max 两个托管语音智能体模型,整合语音识别、推理、轮次切换与语音生成,但开发者无法单独选择或配置底层模型。外部测试机构 Artificial Analysis 的数据显示,Max 在 Big Bench Audio 上得分 98.8%,Mini 为 75.9%;工具调用任务完成率 Max 为 87.1%,Mini 为 60.3%,而 Mini 在 Full-Duplex-Bench 上以 95.8% 略高于 Max 的 94.1%。该接口沿用 OpenAI Realtime API 的协议和 WebSocket 传输,但仅支持 WebSocket,WebRTC 应用需先更换传输方式并自行处理 24kHz PCM16 音频的采集与播放。

    匹配字段摘要、正文

  5. Hugging Face精选

    NVIDIA 发布 Cosmos3-H-Dreams 手术生成模拟模型

    NVIDIA 发布 Cosmos3-H-Dreams,基于 160 亿参数的 Cosmos3-H-Embodied-Nano 专门化,用于胆囊切除术的动作条件视频生成。模型使用 28 个动作维度、832 x 480 视频和 10 Hz 动作对齐训练,通过蒸馏得到四步与两步两个学生检查点,两步版本单独训练,推理更快但画质更低。官方同时提供 FlashDreams 流式运行时和适配自有数据与控制器的方法,并说明该模型是研究用模拟器,并非经过验证的临床系统。

    匹配字段摘要、正文

  6. 雷科技

    腾讯元宝搜索升级并通过腾讯云对外开放

    腾讯10月20日宣布元宝搜索升级,并通过腾讯云向企业和个人开发者开放,开发者可通过API、MCP或Skill接入。官方披露向量索引规模超过1500亿、底层检索平均耗时约8毫秒、单位推理成本降低90%,覆盖13个行业157个头部信源,元宝、WorkBuddy、ima、腾讯视频等50多款产品已在调用。腾讯云副总裁马晋称搜索面对的用户已从人变成智能体,元宝搜索用大模型重构排序链路,并以Gist Token压缩和KV Cache复用降低推理耗时。

    匹配字段摘要、正文

  7. PyTorch Blog精选

    Google 与 Meta 联合推出 TorchTPU,让 PyTorch 原生运行在 TPU 上

    Google 与 Meta 的 PyTorch 团队合作推出开源项目 TorchTPU,为 Google TPU 提供原生 PyTorch 后端,迁移只需把 model.to("cuda") 改为 model.to("tpu")。项目支持 eager 与 torch.compile 两种模式,新增 DeferAndFuse eager 模式,覆盖约 450 个 Aten 算子,并已在 4,917 个 Hugging Face 模型上验证开箱运行,其中 Tier 1 通过率 98%、Tier 2 相对 GPU 数值一致性 97%。官方称其已用于部分 Google Cloud 大客户的推理与训练生产负载,并集成 vLLM、SGLang、TorchTitan、Ray 和 TorchRec。

    匹配字段摘要、正文

星期二

  1. 9to5Mac

    Perplexity Mac 应用新增本地优先模式,可离线运行 Computer

    Perplexity 为 Mac 应用加入本地优先模式,让 Computer 完全在设备上运行,包括无网络连接时执行任务。该模式下规划、推理和文件处理都在本地完成,文件仅在用户批准后才上传云端,模型和智能体均运行在 Mac 上。本地模型选项包括 Qwen 3.6 和 PPLX Pro,需 Apple silicon Mac 且至少 36GB 统一内存以获得最佳体验,Hybrid Compute 模式仍保留。

    匹配字段摘要

  2. fal

    Bria Fibo 2.0 上线 fal,支持多图编辑与文生图

    Bria AI 的 Bria Fibo 2.0 已在 fal 平台上线,该模型在 Artificial Analysis 上位列开放权重图像编辑模型第一,同时支持文生图与定向编辑。它最多可接收四张输入图像,支持背景替换、产品重摆与光照调整,并能处理推理密集型提示词;模型仅用授权数据训练,商业权利清晰。

    匹配字段摘要、正文

  3. 集微网

    阶跃星辰发布首款智能体手机 STEPX Neo 先行版,售价 3999 元

    阶跃星辰 10 月 13 日晚在上海发布首款智能体手机 STEPX Neo 先行版,将 Step 系列模型、Step AOS 1.0 系统、Step Studio 工具与手机硬件打包,售价 3999 元,当晚 9 点开启预售,10 月 16 日 10:13 在京东、天猫、抖音首销。该机搭载智能体原生操作系统 Step AOS 1.0 与个人智能体阶跃 Amoo,采用双入口设计,右滑可从 Amoo 界面切回传统 App 桌面,执行上端侧处理轻量任务、云端旗舰模型负责复杂推理与多步规划。阶跃同时提出连接个人智能体与服务智能体的 A to A 网络,通过 MCP、A2A 等协议打通,Amoo 已与支付宝、腾讯、携程、滴滴、剪映、高德、美团等近百家企业或产品达成合作。

    匹配字段摘要、正文

  4. 中华网科技

    商汤实测 GPT-6-Astra 并开源 SenseNova-RoboRSI 框架与 27B 具身模型

    商汤在 12 个模拟评测和 8 款机器人上系统测试 GPT-6-Astra,并开源 SenseNova-RoboRSI 评测框架与 SenseNova-RoboRSI-27B-Preview 具身模型,称其任务完成成本为 GPT-6-Astra 的 1/50。测试显示,解除步数限制并允许访问训练集后,GPT-6-Astra 在 RoboDojo 上任务成功率达 81.9%,但叠碗平均耗时约 131 分钟、估算推理费用约 19 美元,把笔装进笔筒平均耗时 263 分钟、约 55 美元。开源框架将各 Benchmark 封装为独立 Docker 镜像并通过统一 HTTP API 提供环境交互与评分,27B 模型在 RoboCasa365 上成功率由 26.0% 提升至 46.5%,任务 Token 开销减少 73%。

    匹配字段摘要