←搜索结果

按匹配度 · 共 499 条结果 清除搜索

星期二

  1. Google Developers Blog

    Google 完成 Coral NPU 32 位架构并发布 v1.0 编译器

    Google 发布 Coral NPU 完整 32 位架构(含新增 Matrix Execution Unit,可配置至 1 TOPS、推理平均功耗目标 10mW)和基于 IREE/MLIR 的开源 Coral Compiler v1.0,支持 JAX、PyTorch、TensorFlow 模型直接编译到该硬件。完整 32 位 RTL 已在 GitHub 开放,Synaptics 同步推出搭载第二代 Coral NPU IP 的 Astra SR200 系列 MCU(400 GOPS)和 Coralboard SR 开发套件,Coralboard SL(1 TOPS)经 DigiKey 全球发售。两代产品共用同一架构与编译器,模型优化一次即可部署到毫瓦级可穿戴设备或 1 TOPS 板卡。
    blog-header-image-1600x900

    匹配字段摘要

  2. 邵猛

    Viggle 发布 3D 原生世界模型 JST-2

    Viggle 发布 JST-2,将整套模型栈构建在 3D 空间,用携带 xyz 坐标、属性向量和动力学向量的 Physics-Native Token 表示世界,而非从视频像素中隐式推断物理规律。架构分为 JST encoder、JST generator 和 JST decoder 三部分,单次前向推理约 1 秒生成完整 3D 场景,成本低于 $0.01(B200),并支持最多 64 个输入视角作为空间上下文窗口。Viggle 公布的盲测人类偏好显示,角色生成对 Meshy 7.1 胜率 58.4%、对 Tripo H3.1 胜率 73.2%,视频生成运动对 DeepMotion 胜率 89.1%。JST-3 计划把学习到的动力学推广到物体交互。

    匹配字段摘要、正文

  3. Fireworks AI

    Fireworks 推出 Free Weights Club,Muse Glimmer 30B 免费 SFT 训练

    Fireworks AI 推出 Free Weights Club,Muse Glimmer 30B 的 SFT 训练在 11 月 30 日前免费,无需信用卡,推理与评估调用另行计费。用 Kalshi 市场数据训练出的 tuned Glimmer 在未见主题上预测准确率 58.3%,比 Jev 的 47.1% 高 11.2 个百分点;历史回测中假设的 1000 美元在计入模拟手续费后变为 1071 美元,base Glimmer 和 Jev 均为亏损。System One 服务栈在另一项合成基准中,中位服务端处理速度比标准 BF16 chat completions 快 2-3 倍。

    匹配字段摘要、正文

星期一

  1. 邵猛精选

    阿里通义 MAI-UI 团队开源通用计算机使用智能体技术栈 OpenGCUA

    阿里通义 MAI-UI 团队开源通用计算机使用智能体完整技术栈 OpenGCUA,包含 harness、跨设备 SDK、原生 macOS 应用、评测轨迹和参考 agent 实现。其核心设计是代码执行与决策从 harness 转移到模型,模型按需截图、编写带循环和条件判断的 Python 程序编排 GUI 操作、API 调用和 shell 命令,并自行维护 todo 列表。在 OSWorld-v2 上对 8 个前沿模型的评测中,平均 partial score 从 45.3 升至 64.9,每任务步数平均减少 53%;真机 macOS 测试中,同一 harness 下 Qwen3.8-Max 的推理 token 消耗是 GPT-6 Astra 的 19.4 倍,4 个任务完成 3 个。

    匹配字段摘要、正文

  2. Google Developers Blog

    Google 发布 LiteRT Tensor API,支持用 C++ 手写端侧模型图

    Google 发布 LiteRT Tensor API,让开发者在 C++ 中逐算子构建计算图,同一份代码可经 LiteRT 跑在 CPU、GPU(ML Drift)和 NPU 上,或不经模型文件直接通过 XNNPACK 在 CPU 运行。官方用该 API 手写 SAM 2 并部署到浏览器 WebGPU,在 MacBook Pro 上比 Apple MLX 快约 1.5 倍,输出掩码与 Meta PyTorch 参考逐像素一致。该 API 还支持从 .safetensors 直接加载权重,并让预处理、推理与后处理通过共享加速器缓冲区串联,避免数据回传 CPU。

    oct2026_liteRT_tensorAPI

    匹配字段摘要

  3. 智东西

    Conway Research 推出本地个人 AI 助手 Underdog

    成立 8 个月的 Conway Research 亮出首款个人 AI 助手 Underdog,完全运行在用户设备上且离线可用,已推出 Mac、Windows 测试版,并获 a16z、Anthropic 投资联合体等投资。其模型包括基于 Qwen3.8 27B 打造的 Saluki 27B(已开源,权重体积为全精度版本的 1/7、保留 96% 性能)和 Woof 4B,配套推理引擎 Husky 在 MacBook 上让 Woof 4B 每秒最多处理 730 个 token,比 MLX 快 4.5 倍。产品还上线了基于 Qwen-Image Flash、Qwen-Image-2.1-Turbo 的本地图像生成与编辑,以及与 Stripe 合作的设备端智能体支付。

    匹配字段摘要、正文

  4. CTech

    Shashua 新公司 doubleAI 发布 Maxwell 代码执行模型

    Amnon Shashua 的新公司 doubleAI 发布首个产品 Maxwell,称其属于名为 Code Execution Models(CEM)的新类别,在代码与芯片之间优化软件执行效率,且不修改源代码。doubleAI 称 Maxwell 会持续分析运行中的程序、硬件与数据并优化底层机器指令,同时用形式化数学验证每次优化不改变程序原有行为,支持 CPU 和 GPU。公司称 Maxwell 在真实负载上让数据管道提速超过 38 倍、AI 推理 kernel 提速超过 4.5 倍,这些数字未经独立验证;Maxwell 现已通过官网开放早期访问,doubleAI 计划按节省的算力成本向客户收费。

    匹配字段摘要、正文

星期五

  1. OpenRouter

    Krea 3 上线 OpenRouter,支持 1–4 张参考图与原生 2K 编辑

    Krea 3 已在 OpenRouter 上线,这是 Krea AI 的新图像编辑模型,可接收 1–4 张参考图加一段提示词,返回原生 2K 的编辑后图像,多数编辑端到端耗时不到 8 秒。定价为 1K 每张 $0.03、2K 每张 $0.06,参考图 1K 每张 $0.02、2K 每张 $0.07;thinking_mode 默认 fast,需要更多提示词推理时可设为 high,加价 $0.02。该模型沿用 OpenRouter 上其他图像模型共用的 Images API,迁移只需更换模型 ID。

    Krea 3 已在 OpenRouter 上线,这是 Krea AI 的新图像编辑模型,可接收 1–4 张参考图加一段提示词,返回原生 2K 的编辑后图像,多数编辑端到端耗时不到 8 秒。定价为 1K 每张 $0.03、2K 每张 $0.06,参考图 1K 每张 $0.02、2K 每张 $0.07;thinking mode 默认 fast,需要更多提示词推理时可设为 high,加价 $0.02。该模型沿用 OpenRouter 上其他图像模型共用的 Images API,迁移只需更换模型 ID。

    匹配字段摘要、正文

  2. OpenRouter

    Krea 3 图像编辑模型上线 OpenRouter

    Krea 3 已在 OpenRouter 上线,这是 Krea 的新图像编辑模型,可接收 1 至 4 张参考图加一段提示词,返回原生 2K 的编辑后图像,多数编辑端到端耗时不到 8 秒。定价为 1K 每张 $0.03、2K 每张 $0.06,参考图 1K 每张 $0.02、2K 每张 $0.07,thinking_mode 默认 fast,需要更多提示词推理时可设为 high 并加收 $0.02。它与其他图像模型共用同一 Images API,迁移只需更换 model ID。

    Krea 3 已在 OpenRouter 上线,这是 Krea 的新图像编辑模型,可接收 1 至 4 张参考图加一段提示词,返回原生 2K 的编辑后图像,多数编辑端到端耗时不到 8 秒。定价为 1K 每张 $0.03、2K 每张 $0.06,参考图 1K 每张 $0.02、2K 每张 $0.07,thinking mode 默认 fast,需要更多提示词推理时可设为 high 并加收 $0.02。它与其他图像模型共用同一 Images API,迁移只需更换 model ID。

    匹配字段摘要

  3. OpenRouter

    Meta 的 Muse Spark Open 上线 OpenRouter

    Meta 发布的开源权重模型 Muse Spark Open 已在 OpenRouter 上线,OpenRouter 称其为美国实验室最强的开源权重模型,面向智能体编码,支持 1M 上下文,可输入图像、视频、音频和 PDF,定价为每百万 token 输入 1.25 美元、输出 4.25 美元。据 Meta 官方介绍,该模型总参数 816B、激活参数 42B,原生支持文本、图像、视频和音频,擅长长周期任务、复杂软件工程与多步推理。OpenRouter 表示该模型在发布首日即上线,合作方包括 Baseten、Fireworks AI、Nebius 和 Together Compute。

    匹配字段摘要

  4. OpenRouter

    OpenRouter 推出 Armor 插件,为智能体工具调用加规则校验

    OpenRouter 上线 Armor,任何通过 OpenRouter 做推理的智能体都可以添加插件并配置自定义规则来启用,配置形式为 [{ id: "armor" }]。Armor 会结合一组规则和部分对话记录对每次工具调用打分,并以用户意图为优先:用户说了 Push our work,bash 工具执行 git push 会被放行,而用户从未要求过的危险命令会被标记。OpenRouter 称在其为这项任务生成的内部测试集上,Jev 1.13 相比其他 Decisions 模型以及 Claude Code 使用 Sonnet 5 取得了最高准确率和最低成本。

    匹配字段摘要

  5. Thurrott

    Brave Leo 上线端到端加密聊天,与 NEAR AI 合作

    Brave 与 NEAR AI 合作,为隐私优先的 Leo AI 助手带来端到端加密聊天。该功能下,浏览器在设备端用 Oblivious HTTP(OHTTP)加密提示词,只有经过认证的 TEE 才能解密并运行机密 LLM 推理,IP 地址全程隐藏,GLM 5.3 Flash 模型运行在 NEAR AI 运营的 Nvidia 硬件隔离区中,提示词与回复对 Brave、NEAR AI 及基础设施运营方均不可见。该功能已在 Brave Release、Beta 和 Nightly 上线,需在 Leo 中选择 GLM 5.3 Flash 使用;Brave 表示后续会把认证检查移入浏览器并扩展到其他开源权重模型。

    匹配字段摘要

  6. AWS Machine Learning

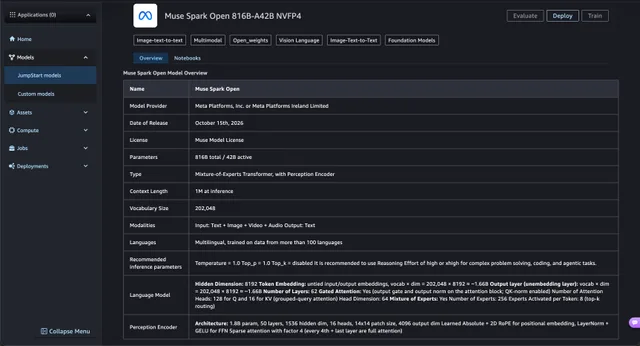
    Meta 的 Muse Spark Open 上线 Amazon SageMaker JumpStart

    Meta 的编码优化开源权重模型 Muse Spark Open 现已在 Amazon SageMaker JumpStart 上线,支持 100 万 token 上下文窗口,可在自己的 AWS 账户中部署到 SageMaker AI 端点。该模型采用 MoE 架构,总参数 816B、每 token 激活 42B,提供 BF16(Muse-Spark-Open-816B-A42B)和 NVFP4 量化(Muse-Spark-Open-816B-A42B-NVFP4)两个变体,分别运行在 ml.p6-b300.48xlarge 和 ml.p5e.48xlarge 实例上。文章给出了通过 SageMaker Studio 和 SageMaker Python SDK 部署、发送首次推理请求以及清理端点的步骤。

    Muse Spark Open model detail card in SageMaker JumpStart with the Deploy option

    匹配字段摘要

  7. Spirit AI 千寻智能:原创开源项目精选

    Physical Intelligence 开源 openpi:π₀ 与 π₀-FAST 两类 VLA 模型

    Physical Intelligence 团队开源 openpi 仓库,包含基于流式扩散的视觉语言动作模型 π₀ 和基于 FAST 动作分词器的自回归 VLA 模型 π₀-FAST,均提供在 10k+ 小时机器人数据上预训练的 base checkpoint。仓库同时给出 DROID、ALOHA 等平台的微调与推理示例,推理需 8GB 以上显存,LoRA 微调需 22.5GB 以上,全量微调需 70GB 以上,目前仅测试过 Ubuntu 22.04,训练脚本尚不支持多节点训练。

    匹配字段摘要

星期四

  1. Modal 官方工程博客精选

    Meta 发布 Muse Spark Open 权重,并上线 Modal Auto Endpoints

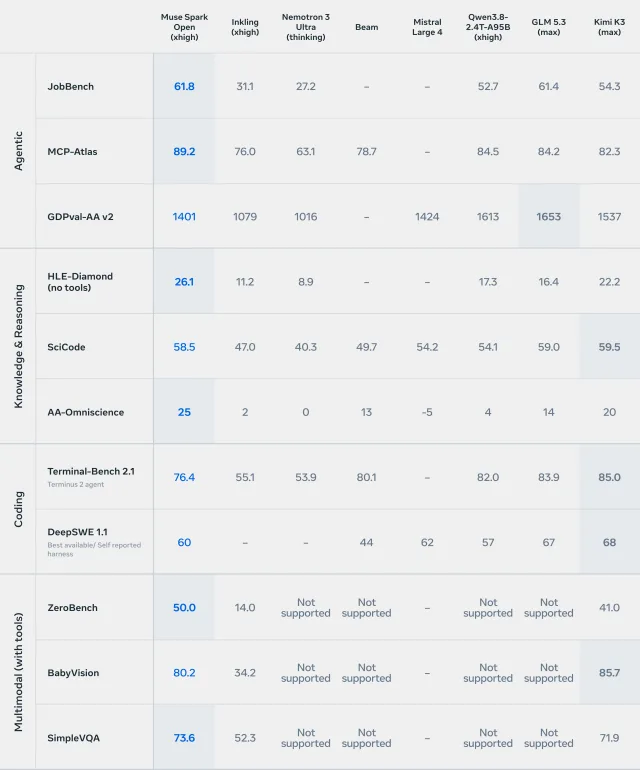
    Meta 发布 Muse Spark Open 的模型权重,该模型已上线 Modal Auto Endpoints。它面向智能体编码和长周期任务,具备原生多模态理解与 1M token 上下文窗口,支持代码编写与调试、多步规划、顺序工具调用以及长流程中的失败恢复。在 Meta 的评测中,Muse Spark Open 使用 Terminus 2 智能体在 Terminal-Bench 2.1 上得分 76.4,使用 Meta 偏好的 harness 在 DeepSWE 1.1 上得分 60,推理强度为 xhigh。该模型在 Modal 上以 Shared Endpoint 形式运行,按 token 计费。

    Benchmark results for Muse Spark Open.

    匹配字段摘要

  2. Rohan Paul

    Grok Voice 3.0 登顶 Artificial Analysis 语音到语音指数

    Grok Voice 3.0 在 Artificial Analysis 的 Speech-to-Speech Index 上排名第一,得分为 86.9,超过 OpenAI 和 Google。该指数综合口语推理、模拟客服通话、盲测偏好投票和任务成功率,GPT-Live-1(Astra,Medium)为 83.2。在 τ-Voice 上,Grok 的成功率从 Grok Voice 2.0 的 56.5% 提升到 71.6%;其响应速度比 GPT-Live-1 快 40%,在 Big Bench Audio 上每任务成本为 0.025 美元,低于 GPT-Live-1 的 0.030 美元和 GPT-Realtime-2.1(High)的 0.055 美元。Grok Voice 3.0 已在 Tesla 中每天处理数百万次对话,并驱动 Grok Bot 的语音模式。

    匹配字段摘要

星期三

  1. The Elec

    Nvidia 发布面向 agentic AI 的 Vera CPU Rack 规格

    Nvidia 于 10 月 12 日发布 Vera CPU Rack 规格,首次推出以 CPU 为核心的服务器机架设计,面向 agentic AI 负载。按其架构,GPU 版 Vera Rubin NVL72 机架负责传统 LLM 训练与推理,Vera CPU Rack 则处理 agentic AI 负载。该机架基于第三代 MGX 架构,并将 Vera Rubin 机架及 MGX 1.2 的抽屉式计算托盘设计提交至 Open Compute Project 的 Open DC Initiative。MGX 1.2 兼容 19 英寸机架设备,单机架支持最高 250kW,并引入机架级液冷。

    匹配字段摘要

  2. Physical Intelligence

    Physical Intelligence 发布 Pi API 测试版

    Physical Intelligence 宣布 Pi API 进入测试版,向更多团队开放。该 API 支持上传机器人数据、微调其能力最强的模型,并把机器人接入云端推理,基础设施由官方负责。此前该公司已与多个行业的企业合作,将模型适配到从采摘草莓到组装服务器的各类机器人上。

    匹配字段摘要

星期二

  1. Computerworld

    微软发布第三代 AI 芯片 Maia 300,计划 2027 年部署

    微软发布第三代 AI 芯片 Maia 300,称其针对最新推理模型和智能体优化,可降低运营成本。微软云与 AI 执行副总裁 Scott Guthrie 表示,Maia 300 每兆瓦 token 数预计比主流 GPU 系统高 40%,公司将从 2027 年起把 Azure Maia 系列扩展到多吉瓦部署,使其成为微软产品与服务的主要推理系统。上一代 Maia 200 于今年 1 月推出,目前支持 Microsoft Copilot 负载,GitHub Copilot 和 Microsoft Foundry 将在 2026 年底前跟进。

    匹配字段摘要

  2. Simon Willison精选

    Simon Willison 发布 llm-meta-ai 0.2,支持 Meta AI 新模型 Muse Wonder

    Simon Willison 发布 llm-meta-ai 0.2 插件,为 Meta AI 新模型 Muse Wonder 和 Muse Wonder Full 增加支持。该插件覆盖 minimal、low、medium、high、xhigh、max 六个推理档位,作者用画鹈鹕的方式对比了 Muse Wonder 与 Muse 1.3、Muse 1.2 的差异,并称 Meta AI 目前每月发布一个新模型。

    匹配字段摘要