←搜索结果

按匹配度 · 共 174 条结果 清除搜索

星期一

  1. Browser Use

    如何用 LLM 从网站提取结构化数据(2026)

    Browser Use 发布教程,介绍用一份 JSON Schema 在多个网站提取结构化数据的流程:静态页面抓取 Markdown 后由 LLM 填充,需要登录或点击的页面交给浏览器智能体。文章给出可靠性清单,包括开启结构化输出、用 Pydantic 或 Zod 校验、缺失字段返回 null、保留 source_url 与原文引用、按稳定键去重、遵守 robots.txt 并抽样核对。文中还对比了 Firecrawl、Crawl4AI、Browser Use、Stagehand 和自建 Fetch+Markdown+LLM 在登录与 JS 流程、Schema 支持、开源与计费上的差异。

    工具的事实来自它们各自的文档和定价页面,核查于 2026 年 10 月 26 日,并在使用处附有链接。 可靠性清单 Schema: 必填字段及其类型,以及在取值固定处使用枚举。用 JSON Schema 编写,或从 Pydantic 或 Zod 模型生成。 受约束的输出: 开启模型的结构化输出。OpenAI 的模型会让响应 遵循你的 JSON Schema;Anthropic 的模型 保证字段类型和必填字段. 在代码中校验: 用以下工具解析每条记录 Pydantic 或 Zod。有效的 JSON 并不等同于正确的数据。 空值,而不是猜测:让缺失字段可为空但仍为必填,并告诉模型当页面未显示该值时返回 。证据:在每条记录上保留 ,并为你将要据以行动的字段附上页面中的简短引用。去重:基于稳定键,例如规范 URL 或 SKU。做礼貌的客户端:按域名限速,遵守 robots.txt 和网站条款。抽查:在信任一次运行之前,将随机抽取的记录样本与实时页面进行比对,并在网站变更后再次比对。用保存的代码重新运行:对于一 让缺失字段可为空但仍为必填,并告诉模型返回 null 当页面未显示该值时。 证据:

    匹配字段正文

星期日

  1. Browser Use精选

    如何让编码智能体使用你已登录的 Chrome

    Browser Use 发布指南,介绍让编码智能体在已登录的真实 Chrome 中工作的多种方式,包括 Claude in Chrome、Playwright MCP 扩展模式、Chrome DevTools MCP 自动连接模式、Gemini CLI 内置浏览器智能体、ChatGPT 桌面版浏览器扩展和 Browser Harness。文中按 Claude Code、Codex、Gemini CLI、Cursor 等智能体分别给出配置命令与限制,并说明从 Chrome 136 起默认数据目录上的 --remote-debugging-port 和 --remote-debugging-pipe 会被忽略,因此复制 cookie 到新浏览器的旧做法在设备绑定会话等场景下会失效。

    e 数据目录上会被忽略;它们需要 --user-data-dir 指向其他位置。Google 做出这一更改是因为攻击者利用远程调试从 Chrome 中窃取 cookie(Chrome 博客,2025 年 3 月 17 日). 下面的每个选项都改为在你的真实浏览器中工作,因此你的登录状态、设备检查和双重验证都保持原样。 1. Claude in Chrome Anthropic 的 Chrome 扩展,Claude Code 可从 CLI 或 VS Code 扩展连接到它(文档). 适用对象: 仅限 Claude Code。 设置: 安装 Claude in Chrome 扩展 (版本 1.0.36 或更高),使用 /login登录 Claude Code,然后运行 claude --chrome。运行 /chrome 检查连接,或将其设为默认开启。 你的 Chrome? 是的。Claude 会在标签页组中打开新标签页,共享你浏览器的登录状态,并在可见窗口中工作。文档列出了 Google Chrome 和 Microsoft Edge,并说明 Claude Code 还会设置 Brave

    匹配字段正文

  2. 邵猛

    Claude 博客:构建 Agent 时何时把子 Agent 折进主循环,Skills 渐进披露常优于多专家编排

    Claude 博客讨论构建 Agent 时何时把子 Agent 折进主循环,认为在 Claude Platform 上单个主循环加按需加载的 Skills/工具,在多项内部对比中质量常更好、成本与延迟更低。文中指出每团队一个子 Agent 加总编排常复制组织架构,带来上下文损耗、Frankenprompt 与局部 eval 等问题,一家客户对比多 Agent harness 与单循环时后者约 2× 更快。子 Agent 只建议留给并行、上下文膨胀或工具与指令冲突等场景,并给出先建端到端 eval、一次折一个的迁移路径。

    分叉推荐 → 再盖编排——反馈往往是:模型已不需要这么多脚手架,一条清晰系统提示 + 四五个瘦数据工具 + 硬输出护栏就够盖住大半场景。 何时仍要用子 Agent · 单循环因上下文膨胀出现可测的性能下降 · 多任务需并行,用完即丢的新鲜上下文窗 · 单 Agent 选不好工具,或系统提示里指令互相打架 Frontier 研究、核验、模块化权限等场景仍适用;Anthropic 自家多 Agent 研究系统也在用。但「每个问题类型/每个团队一个子 Agent」往往是 Conway 定律,不是能力上限。 更优默认:主循环 + 渐进披露 用 Skills 渐进披露上下文、用 tool search 渐进披露工具:先见短描述,需要再全量加载。三点理由: 1. 共享上下文更好答:长程任务里,前几步结果留在同一窗,比子 Agent 回传摘要更能串起来。 2. 防上下文膨胀:不必把一切塞进超长系统提示——这也是以前拆子 Agent 的主因;Claude Code 对更强模型把系统提示砍了 80%+(含 Skills/工具渐进披露相关裁剪)。 3. 模型更强:自 Opus 4.5 起,单循环能扛的远超

    匹配字段正文

星期六

  1. Artificial Analysis

    DeepSeek V4.1 Flash 1017 登顶 Artificial Analysis 网络安全指数开放模型榜

    DeepSeek V4.1 Flash 1017 在 Artificial Analysis Cyber Index 上以 57% 的得分成为开放可用模型中的第一名,总榜排名第二,落后于通过可信访问计划提供的 GPT-6 Sol(69%)12 分。该指数由 CWE-Bench-AA、DeepsecBench-AA 和 CyberGym-E2E-AA 三项基准组成,主要评测智能体网络安全防御任务。相比前代 DeepSeek V4.1 Flash 的 41%,新版本提升 16 分,主要来自 CyberGym-E2E-AA 从 23% 升至 76%;其每任务成本为 0.42 美元,位于能力与成本帕累托前沿。

    放可用模型。 Artificial Analysis Cyber Index 衡量智能体网络防御任务上的能力,由三项基准组成:CWE-Bench-AA、DeepsecBench-AA 和 CyberGym-E2E-AA。该 Cyber Index 主要通过模型公开可访问的 API 对其进行评估,反映开发者可用的网络能力。 许多模型,尤其是来自 OpenAI、Anthropic 和 Google 的专有模型,可能具有更强的防御性网络能力,但会遇到安全拒绝,从而降低其总体得分。通过 OpenAI 可信访问计划提供的 GPT-6 Sol(Daybreak Blue,max)领跑该指数,由于拒绝次数更少,其得分比公开版本高出 32 分。DeepSeek V4.1 Flash 1017 未遇到任何安全拒绝。 主要结果: ➤ DeepSeek V4.1 Flash 1017 在 Artificial Analysis Cyber Index 上获得公开可用模型中的最高分,总榜排名第二。DeepSeek V4.1 Flash 1017(max)得分为 57%,领先此前领先的公开可用模型 Grok 4

    匹配字段正文

  2. Artificial Analysis精选

    Kimi K3.1 Pro 在 Artificial Analysis 网络安全指数得 64%,居开放可用模型首位

    Kimi K3.1 Pro 在 Artificial Analysis Cyber Index 上得分 64%,比此前的开放可用模型领先者 DeepSeek V4.1 Flash 1017(57%)高 7 分,比仅通过 OpenAI 可信访问计划提供的 GPT-6 Sol(Daybreak Blue,max,69%)低 5 分。该指数由 CWE-Bench-AA、DeepsecBench-AA 和 CyberGym-E2E-AA 三项基准组成,K3.1 Pro 在 CyberGym-E2E-AA 上拿到 95%,高于 GPT-6 Sol(Daybreak Blue)的 93%。其单任务成本为 2.81 美元,高于 GPT-6 Sol(Daybreak Blue,max)的 1.77 美元和 DeepSeek V4.1 Flash 1017 的 0.42 美元,原因是每 token 价格虽比 Kimi K3 低 33%,但输入 token 用量约为 2 倍。

    重发布,K3.1 Pro 也将成为网络防御领域领先的开放权重模型。 Artificial Analysis 网络安全指数衡量智能体网络防御任务上的能力,由三项基准组成:CWE-Bench-AA、DeepsecBench-AA 和 CyberGym-E2E-AA。该指数主要通过模型公开可访问的 API 进行评估,反映开发者可用的网络能力。 来自 OpenAI、Anthropic 和 Google 的专有模型可能具有更强的网络能力,但因安全拒答而失分:通过 OpenAI 可信访问计划提供的 GPT-6 Sol(Daybreak Blue,max)比其公开版本高 32 分。Kimi K3.1 Pro 未遇到任何安全拒答。 关键结果: ➤ 开放可用模型排名第一、总体排名第二:Kimi K3.1 Pro 得分 64%,比 Kimi K3(41%)提升 23 分,并领先于 DeepSeek V4.1 Flash 1017(57%)。只有可信访问的 GPT-6 Sol(Daybreak Blue,max,69%)得分更高 ➤ CyberGym-E2E-AA 得分在所有模型中最高:K3.1 Pro 在

    匹配字段正文

  3. SemiAnalysis

    SemiAnalysis 实测 Trainium3 的 PyTorch 训练与 Neuron Explorer 剖析器

    SemiAnalysis 工程团队在 Trainium3 上实测了原生 PyTorch 训练栈 TorchNeuron 与 TorchTitan,用 Qwen3-32B 在 16 颗 Trainium2 上训练,eager 模式达 11,099 tokens/s、23.89% MFU,compiled 模式达 14,156 tokens/s、30.47% MFU。作者认为 Neuron Explorer 剖析器优于 Nvidia 和 AMD 的方案,但首次编译耗时过长,gpt-oss 训练配方首步编译用了 27 分 17 秒。FlexAttention 测试通过 96 个用例中的 89 个,7 个失败均因编译超时而非数值错误。

    亚马逊的Trainium向训练王者发起冲击 Trainium最适合推理?但现在也擅长训练了:原生Trainium PyTorch、高质量CI、TorchTitan、GPU Impossible剖析器 Kimbo Chen与Dylan Patel 2026年10月23日∙付费 Trainium已在推理领域证明了自己。Anthropic正在Trainium2和Trainium3上运行生产推理和RL rollout。从历史上看,Trainium在推理方面表现出色,但并非研究训练的最佳选择。在推理中,模型架构的变化速度比训练慢得多;在训练中,研究人员会对模型架构进行大量不同的实验和消融,需要一个覆盖广泛API表面的技术栈。过去,这正是Trainium的短板所在。 AWS Neuron团队正积极努力改变这一缺陷,最大的转变是迈向一流的原生PyTorch训练体验。在训练循环中到处撒xm.step()、与定制的XLA式执行模型较劲的日子已经一去不复返。Trainium现在以PyTorch用户所期望的方式运行PyTorch——eager模式,配合torch.compile和标准API。 SemiAna

    匹配字段正文

星期四

  1. Browser Use

    Browser Use 盘点 2026 年最佳浏览器 Agent MCP 服务器

    Browser Use 发布 2026 年浏览器 Agent MCP 服务器盘点,把这类服务器分为驱动和委托两种模式,并逐一评测 Browser Use Cloud MCP、Browser Use 开源 MCP、Hyperbrowser MCP 和 agent-browser chat 四款。作者在 100 个 BU Bench V2.1 任务的对比评测中发现,四个驱动类工具每个任务的中位输入 token 消耗在 2.1M 到 6.7M 之间,全部计入编码 Agent 的上下文。文中还给出各服务器的安装命令、模型选择、计费方式与已知限制,并说明长任务、并行任务和结构化输出场景更适合委托模式。

    d reach for it first. The model is yours. In practice that means an OpenAI key, an OpenAI-compatible endpoint, or AWS Bedrock with MODEL PROVIDER=bedrock. The docs also mention an Anthropic key, but the server code doesn't read it; on the OpenAI path, without OPENAI API KEY the agent tool fails. The default config it writes on first run uses gpt-4.1-mini, and on Bedrock that config model wins, so also set BROWSER USE LLM MODEL to a Bedrock model ID and install with --from 'browser-use[cli,aws]'

    匹配字段正文

  2. AWS Machine Learning

    AWS 团队开源多智能体系统 Deep Insight,拆解生产环境五大挑战

    AWS 解决方案架构团队构建并开源了多智能体系统 Deep Insight,可将 CSV 数据与自然语言提示转化为带引用的 .docx 分析报告。系统由 Coordinator、Planner、Supervisor、Coder、Validator、Reporter、Tracker 等八个智能体分层协作,基于 Strands Agents SDK 的 Graph 与 Agents-as-Tools 模式控制执行流,并按角色分别选用 Claude Haiku、Opus 和 Sonnet。生产部署依托 Amazon Bedrock AgentCore 运行时,LLM 生成的代码在 AWS Fargate 的按会话临时容器中隔离执行,配套 Web UI 与 Ops 仪表盘。

    Deep Insight architecture: the Strands Agents multi-agent layer on Amazon Bedrock AgentCore, with an Application Load Balancer routing code execution to AWS Fargate containers in a private VPC

    ost series, we share what the team learned firsthand while building Deep Insight across three posts. We will walk through how we applied Context Engineering techniques proposed by Anthropic (multi-agent architecture, structured note-taking, human-in-the-loop, and more) in a real production environment. We also cover the trade-offs we encountered along the way (with code) and the operational insights we gained from deploying and running this agent on AWS. Blog series overview Part 1: 5 production

    匹配字段正文

星期三

  1. 虎嗅

    开发者借 AI 逆向工程在红米等安卓手机运行 iOS 16

    开发者 dipa-studio 在红米 Note 10 Pro 上成功引导运行 iOS 16.7.16,可进入桌面、操作设置和控制中心,随后红米 Note 12、Nothing Phone、一加12 等设备也出现同类演示。移植过程大量借助 Claude、Codex 编写驱动适配代码,还出现了自动分析硬件接口的逆向工具 REA。当前版本蜂窝网络、蓝牙、相机、扬声器均不可用,GPU 硬件加速未打通导致卡顿,开机需等待 4 分钟,代码签名校验和沙盒限制也被放宽,仅适合尝鲜演示。

    Claude负责敲命令。” 在整个移植过程中,开发者本人几乎沦为了AI的“肉身机械臂”。当屏幕不亮或触控失灵时,AI自己去读苹果的报错日志、对比高通的安卓驱动源码、分析内存地址,然后写出一段把小米触控信号“翻译”成苹果触控事件的转接代码。 最搞笑的是日志里的一条记录:写着写着,OpenAI的Codex用量额度突然刷爆见底了。怎么办?开发者转手就把烂摊子交给了Anthropic的Claude,让Claude顺着前任留下的日志继续改代码、编译、测开机,无缝接班。 这种“AI搞逆向”的玩法,甚至已经孵化出了专门的核武器:最近在外网爆火的开源项目REA(Reverse Engineer Anything,逆向一切)。 开发者morluto打造的这个工具,干脆把Hopper、Ghidra、IDA这些专业反编译和分析工具全都打包到了AI助手里。 你不需要有软件源码,也不需要开发文档,只要把现成的黑盒程序丢给REA,AI就能自己调用专业工具去顺藤摸瓜、查内存、找证据,看懂程序是怎么跑的,然后尽量帮你重写一套一模一样的功能。 |REA与Hopper的分析界面|图源:REA官方仓库 网友Hunter嫌自

    匹配字段正文

  2. Artificial Analysis

    Artificial Analysis:Intelligence Index 达 30 分的成本比首次达到时低 86 倍

    Artificial Analysis 基于 v4.3.2 实测结果和当前价格统计,Intelligence Index 达到 30 分的单任务成本比首次达到该分数时低 86 倍,GPT-6 Luna (high) 以 $0.03/task 达到 30 分,而 Claude Sonnet 4.6 在 2026 年 2 月首次达到 30 分时为 $2.49/task。达到 20 分的成本比约 13 个月前低 123 倍,达到 40 分比约 5 个月前低 33 倍,Claude Haiku 5.5 (xhigh) 以 $0.12/task 达到 41 分,是达到 40 分最便宜的模型。最高实测分数一年内从 21 升到 58,成本约为 11 倍,Claude Opus 5.5 为 $5.98/task。

    而最高分模型的成本则高于一年前的最高分模型。 要点: ➤ 达到 20 分的成本比约 13 个月前低 123 倍;达到 40 分的成本比约 5 个月前低 33 倍:实测模型分别于 2025 年 9 月和 2026 年 5 月首次达到这些阈值。 ➤ GPT-6 Luna (high) 以每任务 $0.03 达到 30 分:@OpenAI 的该模型每任务成本比 @AnthropicAI 的 Claude Sonnet 4.6(Adaptive Reasoning, Max Effort)低 86 倍,后者于 2026 年 2 月以每任务 $2.49 首次达到 30 分。 ➤ Claude Haiku 5.5 (xhigh) 目前是达到 40 分最便宜的模型:它以每任务 $0.12 获得 41 分,比 GPT-6.1 Sol (low) 低 5%。 ➤ 达到 50 分的成本比首次达到时低 18 倍:GPT-6.1 Sol (high) 以每任务 $0.32 达到该分数。 ➤ 最高实测分数一年内从 21 升至 58,成本约为 11 倍:Claude Opus 5.5(Adaptive Reaso

    匹配字段正文

  3. AWS Machine Learning

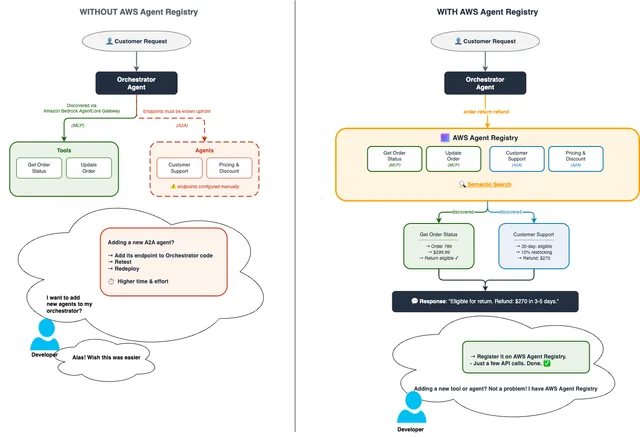
    AWS 发布 Agent Registry 运行时工具发现实践

    AWS 介绍 Agent Registry 的运行时工具发现方案,智能体通过语义与关键词混合搜索找到已审批的 MCP 服务器和 A2A 智能体,再按描述符即时构建客户端执行请求。示例代码基于 Amazon Bedrock AgentCore Gateway 与 runtime,把订单管理 MCP 服务器和定价、客服两个 A2A 智能体接入,并演示纯语义匹配的退货退款场景。注册表只返回连接元数据,调用凭证需另行通过 Cognito OAuth 或 IAM 获取,新增能力无需改动编排器代码。

    Comparison of hardcoded tool endpoints versus runtime discovery with AWS Agent Registry

    Access Management(IAM)角色来调用 Lambda 目标。 Amazon Bedrock AgentCore runtime 托管编排器以及定价和客户支持 A2A 智能体。运行时调用使用 IAM 授权 Boto3 调用。 Amazon Bedrock 提供编排器和 A2A 智能体使用的基础模型(FM)。示例目前通过跨区域模型 ID 配置 Anthropic Claude Sonnet 模型。参见 Amazon Bedrock 中按 AWS 区域支持的模型. 三个演示场景使用不同的能力组合来演练发现循环。第一个是仅 MCP 调用(订单状态)。第二个串联 MCP + A2A(定价和折扣)。第三个针对模糊的用户意图测试纯语义匹配:退货和退款,而这两个词并未出现在所匹配的 A2A 智能体的名称中。 技术实现 链接的运行时发现 示例 部署依赖项、创建并填充注册表、验证发现、部署编排器,并运行三个演示。 orchestrator agent.py 包含按请求的发现循环。 utils.py 解析注册表描述符并创建 MCP 和 A2A 客户端。 cleanup.py 移除资源。 1

    匹配字段正文

星期二

  1. 邵猛

    MIT 课程 MAS.S62 两讲梳理 Harness 演化与多 Agent 演化

    MIT 课程 MAS.S62「How to AI an AI」的 Lecture 4-5 聚焦 Harness evolution,分别讲 harness 组件、记忆、工具与技能演化,以及规划、任务分解与多 agent 系统演化。记忆部分用三轴分类法串起 MemGPT、mem0、MEM1、Reflexion/ExpeL,并以 CLM 把上下文管理统一为文件操作;工具部分从 Toolformer、ToolLLM、CodeAct 讲到 Meta-Harness,后者把整个 harness 表示为文件系统,反馈信息量约为此前方法的 400 倍。多 agent 部分给出五条实证发现,包括 MAS 在可分解任务上赢 81%、在顺序依赖任务上输 70%,以及 CORAL 在 8 个任务上取得新 SOTA、多 agent 演化比单 agent 提升 4%–20%。

    agent 只对特定任务结构有效。金融 agent 任务天然可分解(收入/成本/市场),MAS 赢 81%;PlanCraft 类任务有强顺序依赖,拆分反而伤害,MAS 输 70%。指南:可并行 → 集中式;需探索 → 去中心化;顺序依赖 → 单 agent。 2. 收益随基座模型而异:OpenAI 模型成本增加性能却平台化;Google 模型成本高性能高;Anthropic 模型上 MAS 甚至可能伤害性能。 3. agent 数量越多不一定越好:工具密集型任务(16 个工具的工作流)受协调开销拖累,且惩罚随环境复杂度复利式累积。 4. 异构混合可以打败更强的单一基座:不需要处处用贵模型,“廉价编排器 + 昂贵执行子 agent”是好用配置;且若单 agent 基线已超 45%,MAS 反而有害。 5. 性能可预测:以模型、任务、MAS 配置为参数的 scaling law 能以 87% 的准确率预测最优架构,从“碰运气试配置”走向 agent 设计的原则性科学。 这五条与阅读清单里的 "Why Do Multi-Agent LLM Systems Fail?" 一起,构成课程对多

    匹配字段正文

  2. 钛媒体 · AGI

    Cue一周实测:给AI配了身份证,却还做不到随时可用

    作者开通Cue Pro会员实测一周,邮件处理最顺畅,能及时提醒收信、总结要点并按意图组织回复;电话与支付两项因需绑定国际账号未能跑通。多Agent协作需配置海外应用接口且群聊回复混乱,日程管理也接不进微信、QQ等国内信息流。Cue于9月28日与Manus 2.0一同发布,为每个Agent配备独立邮箱、电话号码、数字钱包和专属电脑,面向海外用户,国内版本仍在筹备。

    京岗位,覆盖产品、研发、运营和增长。创始人肖弘在社交媒体上透露,一天之内收到上千封简历。至于公司是否在为赴港上市做准备,目前仍是业内人士的判断,尚未得到官方确认。 资本为什么还愿意给它重注?对不少投资人来说,Manus与AI Coding Agent公司其实是“同类物种”,它们都试图把模型能力变成可以直接交付的工作成果。 而这条参照系的造富速度也确实很惊人,Anthropic的Claude Code上线半年,年化收入就冲到10亿美元,破了全球软件史纪录;Devin的开发商 Cognition 今年9月完成超20亿美元融资,估值480亿美元;Cursor去年底拿了 23 亿美元,今年8月更是被 SpaceX 以 600 亿美元整体收购。和这些数字放在一起看,Manus本轮融资的体量并不算“夸张”。 但牌桌也确实比它离开时拥挤多了,肖弘曾回忆,Manus刚做出来时,市场上还没有Codex,也没有Claude Cowork。如今,腾讯WorkBuddy,阿里千问办公,字节整合飞书推出豆包工作,DeepSeek和MiniMax也在细分场景中加码。任务执行能力正被模型厂商收入自家产品,独立Age

    匹配字段正文

星期日

  1. The New Stack

    Gemini 4 Argon 与 Claude Opus 5.5 实测对比:价格减半,准确率也接近减半

    The New Stack 用代码审查、账单规格和长上下文三项自建任务对比 Gemini 4 Argon 与 Claude Opus 5.5,Argon 总成本 4.98 美元、Opus 为 8.75 美元。两者在 14 个植入 bug 的审查与修复上打平,但账单规格测试中 Opus 通过 80/80、Argon 仅 11/80,作者手动修正一行代码后 Argon 才达到 80/80。长上下文依赖题中 Opus 在 500K 规模答对全部 33 个服务,Argon 只答对 20 个并答错 8 个,且输出 token 仅 243 至 425,未展示推理过程。Argon 目前每百万输入/输出 token 收费 2/10 美元,12 月 1 日起涨至 4/20 美元与 Opus 持平。

    ere Opus 5.5 wins. Opus leads on the other four benchmarks, including Terminal-bench 4.0 (66.4% vs. 57.4%), which tests agentic work in a command line. Google is also undercutting Anthropic on price, at least for now. Through November 30, Argon costs $2 per million input tokens and $10 per million output tokens, half the price of Opus 5.5. On December 1, it rises to $4 and $20, matching Opus. That gives developers about six weeks to decide whether Argon is better or just cheaper. That gives deve

    匹配字段正文

  2. 腾讯云开发者社区

    《Agent 工程实战八讲》导读:从能跑到敢上线的工程方法

    腾讯云开发者社区发布《Agent 工程实战八讲》导读,围绕如何把能调用模型与工具的原型升级为可完成业务任务、解释失败、控制成本并持续迭代的系统。全系列以立案助理 Agent 和术后随访 Agent 两个虚构教学案例贯穿,覆盖任务契约、推理与协作、上下文与记忆、工具可靠执行、观测与重放、评测与校准、安全边界、生产运营八个主题。文中强调模型能给出下一步不等于系统能兑现业务结果,示例字段、预算与数字均为教学演算,不构成法律意见。

    术来源:原始论文(ReAct、Tree of Thoughts、Self-Refine、RAG、Lost in the Middle、Judging the Judges)、协议规范(MCP 固定到 2025-11-25 版本、W3C Trace Context、OpenTelemetry、RFC 8693 与 RFC 9700)、厂商与标准组织的工程文档(Anthropic 的 Agent 与上下文工程文章、LangGraph、Temporal、Stripe、AWS、PostgreSQL、Google SRE、OWASP、NIST)。论文结果只在原研究任务、模型和预算下成立;厂商文档用于确认机制,不代表跨产品的能力保证;动态 API、模型价格和产品套餐不作为长期前提。 法律、司法解释与部门规范性文件:民事诉讼法、登记立案规定、在线诉讼规则、最高人民法院人工智能司法应用意见、个人信息保护法、医疗卫生机构网络安全管理办法、互联网诊疗监管细则、卫生健康行业人工智能应用场景参考指引。它们在文中只用于说明 Agent 的职责边界、人工确认要求与数据边界,正文分别标注文件性质,相关表述一律是本系

    匹配字段正文

星期六

  1. Browser Use

    Browser Use 盘点 11 款浏览器自动化 MCP 服务器并实测四款工具

    Browser Use 发布 2026 年浏览器自动化 MCP 服务器选型指南,按隔离测试、调试、登录态 Chrome、云端并行任务等场景推荐 11 款服务器。作者用 Codex CLI 搭配 GPT-6 Luna 在 BU Bench V2.1 的 100 个公开任务上对比四款工具,Browser Harness 得分 60.4、每题中位输入 token 2.1M、成本 $0.042,与 Playwright MCP 和 Chrome DevTools MCP 的分数差异区间均包含零。Playwright MCP 中位耗时最短为 29.0 分钟,agent-browser 得分 56.3。

    extraction and screenshots. One more tool, retry with browser use agent, hands the task to a full browser-use agent when direct control fails. The server needs your own OpenAI or Anthropic API key. Controls: a local Chrome or Chromium it launches License: MIT Cost: free; you pay your model provider claude mcp add browser-use -- uvx --from 'browser-use[cli]' browser-use --mcp 6. agent-browser A good choice if you want a fast CLI with an MCP mode and a small default tool set. agent-browser from V

    匹配字段正文

星期五

  1. heise online

    RTX Spark 笔记本实测:Nvidia 首款本地 AI 笔记本芯片表现如何

    heise online 的 c't 3003 实测了搭载 Nvidia 首款笔记本芯片 N1X(品牌名 RTX Spark)的 Asus ProArt P14,该机支持最高 128 GB 统一内存,测试机为 32 GB 内存加 1 TB SSD,售价 3300 欧元。用 llama-bench 测试 Qwen 3.8-27B 时生成速度约 14.5 Token/s,略快于 Apple M6 和 Strix Halo,慢于 M5 Pro;改用 MoE 模型 Qwen 3.6-35B-A3B 可达近 61 Token/s。提示词处理速度优于 Strix Halo 和 M5 Pro、M6,但满载风扇噪音最高 2.7 sone,且空闲时也会启动。作者还尝试安装 Ubuntu,在自行补齐驱动后,两个模型在 Linux 下的速度反而比 Windows 快 14% 和 9%。

    。 再确认一下,让大家真正理解:我没有给模型任何上下文,它事先也没有关于我的任何上下文,而是一个全新部署的模型。我说:找些关于 Jan-Keno Janssen 的信息,建一个网站。我得说,这已经相当合理了。包括权重方面,哪些是相关的、哪些不相关,我觉得做得挺不错。 对,你们看这里:这是 Artificial Analysis 的行业标准智能评估。里面包括 Anthropic、OpenAI 等目前最大的云端模型,而且是很新的,也包括这周才发布的模型,就是那种跑在价值数百万欧元的服务器上的东西。而小小的 Qwen 3.8-27B——如前所述,包括上下文在内现实中只需要不到 20 GB——也能参与其中。虽然不是最前面,但仍以可观的 34 分位列其中。不过总得说一句:这个智能指数和真正的知识关系很小,更多是类似:这东西会不会用工具、知不知道该去网上哪里搜东西等等,也就是能不能把事情办成?因为 Qwen 这里只有 270 亿参数,知识是有限的。但如果像我用编码智能体 Pi 这样用它,或者用 OpenCode 之类的,让这东西能使用工具,那它就能从网上获取信息,那就真的非常实用了。 提示词处理与

    匹配字段正文

  2. 36氪 · AI

    Artificial Analysis 发布 AA-Robotics v0.1 机械臂操控评测

    美国 AI 基准测试公司 Artificial Analysis 发布 AA-Robotics v0.1,用抓取、物体摆放、按按钮等 8 项桌面操作任务,评估前沿大语言模型通过写代码控制 6 轴机械臂的能力。GPT-6 Astra 以 69 分排名第一,其后依次为 GPT-6.1 Sol、Gemini 4 Argon、Claude Opus 5.5 和 Claude Fable 5.1。GPT-6 Astra 平均每项任务耗时约 30 分钟、成本 16.36 美元,而人类平均只需 20 秒,速度差距接近两个数量级。

    交评论0/1000你可能也喜欢这些文章Linux之父也用AI写内核了,曾嘲讽AI「90%是营销」,如今用Claude Code写了8个补丁,性能暴涨3倍我们不该投资更多的「田柯宇」市场终于发现,AI最大的瓶颈不是电,不是芯片,而是钱小团队也能预训练,普罗2B:RTX5090训练成本不到5090美元OpenRouter周榜全球第二,这个国产模型终于开源了突发,Anthropic联创改口:RSI提前到2027,人类只剩6个月顶级白帽跳槽智谱,用 AI 挖微软漏洞,微软还得说谢谢科学家让AI掌管「世界」,结果4天就被它毁了个干净大开源时代?AI 逆向,让一切软件变成免费智东西特邀作者 智东西,AI产业新媒体。发表文章3191篇 最近内容OpenRouter周榜全球第二,这个国产模型终于开源了8分钟前GPT、Claude指挥机器人干活,到底几斤几两?首个评测榜单来了11分钟前年售2亿部手机超小米,深圳手机巨头今日港股上市17小时前阅读更多内容,狠戳这里选靠谱AI,看真实评测查看36氪AI测评官方交流社区加入咨询项目审核和入驻联系36氪项目推荐订阅号关注 36氪欧洲站36氪欧洲站36氪欧洲站Ai

    匹配字段正文

星期四

  1. Artificial Analysis

    Artificial Analysis 测试 AI 离线建模埃菲尔铁塔,两款模型默写出 72 位科学家名单

    Artificial Analysis 让多个模型在无网络的沙箱中以智能体方式用 3D 建模埃菲尔铁塔,提示词约 200 词,只描述塔身形状、格构、平台和灯光,从未提到科学家名单。Claude Opus 5.5 和 Grok 4.7 都写出了塔下 72 位法国科学家、工程师和数学家的名字,每侧 18 人且顺序与真实一致,Claude Opus 5.5 还把每组名字放在与巴黎实际朝向相同的一侧。两次运行中,这些名字都首次出现在模型自己写的代码里,而非它读取的文件或工具输出。

    and mathematicians under the tower's first platform, 18 on each side. Claude Opus 5.5 and Grok 4.7 wrote all 72, with each side in the real order. Claude Opus 5.5 also put each set on the side that faces the same way in Paris. Each model built its scene as an agent in a sandbox with no internet access. In both runs, the names first appear in code the model wrote, never in a file or tool output it read. Congratulations to @spacexai, @elonmusk and @AnthropicAI on two seriously knowledgeable models

    匹配字段正文

  2. The Guardian Technology

    AI 会如何改变生物武器开发的风险与门槛

    英国军情五处负责人 Ken McCallum 警告 AI 可能“改变”现有乃至新型生物武器的风险格局。文章梳理了两类风险:无技术基础的恐怖组织可借 AI 聊天机器人补齐知识与实验排错,资源充足的国家行为体则可用 AI 放大已有专业能力,例如识别让病原体更致命的基因改动。专家同时指出,隐性知识、生物材料与设备获取、实验验证、规模化与投放仍是实质障碍,目前各国尚无针对此类滥用的正式政府政策。

    ly toxin, using kitchen tools. It is unclear whether the AI’s responses helped, but other accounts suggest the tools can provide relevant and dangerous information. The AI company Anthropic raised further concerns in September when it reported five cases of scientists in unnamed countries trying to use its Claude chatbot for what may have been dangerous work on viruses or toxins. One red flag, the company said, was that after being blocked, the scientists found workarounds. What else has raised

    匹配字段正文