报告:2026—2030年中国活跃智能体复合年均增长率将超150%
《2026年中国人工智能计算力发展评估报告》显示,2026年中国活跃智能体已达495万个,预计2030年增至1.97亿个,复合年均增长率151.2%。2030年全球人工智能算力市场规模预计达1.25万亿美元,中国市场达1501亿美元,均为2025年的4倍。报告称AI智能体、多模态模型规模化商用带动Token调用量与算力消耗指数级增长。
匹配字段摘要、正文
《2026年中国人工智能计算力发展评估报告》显示,2026年中国活跃智能体已达495万个,预计2030年增至1.97亿个,复合年均增长率151.2%。2030年全球人工智能算力市场规模预计达1.25万亿美元,中国市场达1501亿美元,均为2025年的4倍。报告称AI智能体、多模态模型规模化商用带动Token调用量与算力消耗指数级增长。
匹配字段摘要、正文
阿里千问发布 Qwen3.8-Omni-Flash,支持图像与音频输入,可通过 DashScope 兼容接口调用,并支持 enable_thinking 与 xhigh、medium、low 三档 reasoning_effort。同系列还提供 Qwen3.8-Omni-Flash-Realtime,支持 WebSocket 和 WebRTC 连接,可开启摄像头和麦克风进行实时音视频对话。官方同时开源 Qwen-MM-Plugins 多模态插件套件,支持 Codex、Claude Code、Qwen Code、Gemini CLI 等 agent harness,提供图像、音视频理解与长视频记忆等能力。
阿里千问发布 Qwen3.8-Omni-Flash,支持图像与音频输入,可通过 DashScope 兼容接口调用,并支持 enable thinking 与 xhigh、medium、low 三档 reasoning effort。同系列还提供 Qwen3.8-Omni-Flash-Realtime,支持 WebSocket 和 WebRTC 连接,可开启摄像头和麦克风进行实时音视频对话。官方同时开源 Qwen-MM-Plugins 多模态插件套件,支持 Codex、Claude Code、Qwen Code、Gemini CLI 等 agent harness,提供图像、音视频理解与长视频记忆等能力。
匹配字段摘要
北京市人民政府印发《北京市“十五五”时期高精尖产业发展规划》,提出到2030年北京成为具有全球影响力的新兴产业高地、建成全球数字经济标杆城市。规划在人工智能方面要求引导大语言模型和多模态模型全球争先、前瞻布局世界模型,并推进RISC-V、芯粒、存算一体等芯片技术及商业航天可重复使用火箭技术。到2030年还将培育5个具有全球影响力的领航级智能工厂。
匹配字段摘要、正文
商汤资本市场负责人 Philip Wong 在国泰君安 2026 秋季策略会上提出重塑 AI 行业的三大范式转变:从单模态走向原生多模态、从 token 消耗走向任务交付、从单点模型走向系统级全栈能力。商汤称其“One Model + One Token Factory + One Agent Harness”框架正是为这些转变而构建,并认为部署与交付成本而非模型 benchmark 才是新的竞争护城河。
匹配字段摘要
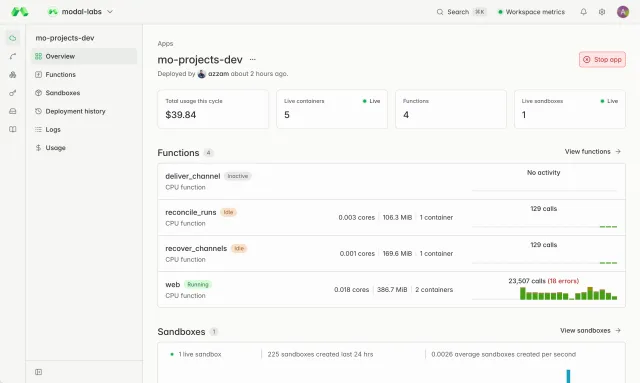
Modal 宣布 Sandbox Sidecars 进入公开 alpha,可在同一主机上运行与主 Sandbox 通过低延迟内网相连的额外容器;VM Sandboxes 进入公开 beta,支持在 Sandbox 内运行 Docker 容器及 eBPF、systemd 等 Linux 特性。平台同时上线 Kimi K3、Qwen3.8-2.4T-A95B、GLM-5.3 与 GLM-5.3-Flash 四款开源权重模型,其中 Kimi K3 为 2.8T 参数多模态模型、支持 1M token 上下文,在智能体负载下达到 460 tokens/秒。广域区域选择价格倍数从 1.5x 降至 1.15x。
匹配字段摘要
DeepSeek 本周发布并开源 DeepSeek-V4.1-Flash,这是一个 552B 参数、8B 激活参数用于 prefill、16B 用于 decode 的多模态 MoE 模型,支持 1M token 上下文窗口,已上线 HuggingFace 与 Baseten Model APIs。它采用 Causal Encoder-Decoder 架构,prefill 只跑 20 层编码器,decode 跑完整模型,官方称全局 KV cache 内存仅为 V4-Flash 的四分之一。在编码与智能体基准上,V4.1-Flash 以约三分之一的总参数量超过 V4-Pro,长程智能体任务提升达两位数,但 Automation-Bench 得分 54.8,复杂工作流仍有约一半失败。

匹配字段摘要
Genspark 与 Fireworks Lab 合作,将开源多模态模型 MiniMax M3 后训练为 Gen-1 Slides,可端到端规划、撰写并自检幻灯片。在 Genspark 的评测中,其幻灯片质量与 Opus 5 相当,输入 token 价格约为 Opus 5 的 1/17,按成品幻灯片计成本低约 90%,并将低评分幻灯片从基座的 18% 降至 3.6%。该模型已在 Genspark AI Slides 的 Standard 模式中作为默认模型上线。
匹配字段摘要
Fireworks AI 提出企业获取专用智能的三阶段路径:先用闭源前沿模型 API 加提示词、RAG、智能体等工程手段,再迁移到更便宜的开源模型优化成本与延迟,最终为真正属于自己的问题训练定制模型。文中以 OSWorld 2.0 多模态 computer use 基准为例,指出 GPT 5.6 Sol 仅以几个百分点领先 Kimi K3,可视为平手并选择更便宜的 Kimi K3。
匹配字段摘要
Unsloth 宣布 GLM-5.3-Flash 的本地 GGUF 推理速度提升 1.6–3.4 倍,配合优化解码与多 token 预测,整体最高快 3.3 倍。用户可在 128GB 设备上通过 Unsloth Desktop 或 llama.cpp 以 3-bit 量化运行,官方同时提供了指南和 GGUF 权重链接。被引用的 Z.ai 发布信息显示,GLM-5.3-Flash 为 320B-A18B 模型,采用 MIT 许可,原生多模态并支持 1M token 上下文窗口。
匹配字段摘要
Google 在 2023 年 7 月发布 RT-2,把多模态 LLM 训练成直接输出机器人动作的视觉-语言-动作(VLA)模型,其泛化能力来自网络规模的视觉-语言预训练。此后 Google、Nvidia、Hugging Face、小米、字节跳动、智元等相继推出用扩散或流匹配生成动作块的 VLA 模型,Physical Intelligence 则通过强化学习、子目标图像和长短期记忆把机器人能力推向折衣服、做咖啡等长任务。作者认为 VLA 与世界模型之争尚无定论,最终胜出的可能是两者的混合架构。
匹配字段摘要
Meta 发布 Muse Voice Transcribe,这是 Meta Superintelligence Labs 的首个实时音频感知模型,今日起通过 Meta Model API、Meta AI for Mac 和 Muse Code 提供。该模型支持实时流式 ASR、20 人以上说话人分离和端点检测,多语言并支持无缝语码切换,可通过语言、关键词和上下文偏置提升准确率。它属于 Muse Spark 家族的自回归多模态 LLM,音频按 80ms 分块(12.5 Hz)处理,每块一个 token,并用词错误率与延迟奖励的 RL 实现自适应延迟。
匹配字段摘要
Muse Voice Transcribe 是 Muse Spark 系列的自回归多模态 LLM。 音频以 80ms 分块(12.5 Hz)处理,每块一个 token,模型在每个分块决定是继续听还是输出文本。 结合词错误率和延迟奖励的 RL 赋予其自适应延迟:在难词上等待更久,在易词上更早确定,逐词权衡准确率与延迟。
Muse Voice Transcribe 是 Muse Spark 系列的自回归多模态 LLM。 音频以 80ms 分块(12.5 Hz)处理,每块一个 token,模型在每个分块决定是继续听还是输出文本。 结合词错误率和延迟奖励的 RL 赋予其自适应延迟:在难词上等待更久,在易词上更早确定,逐词权衡准确率与延迟。
匹配字段摘要
Meta Superintelligence Labs 发布 Muse Voice Transcribe,这是其首个实时音频感知模型,支持实时流式 ASR、20 人以上说话人分离和端点检测,并具备多语言与无缝语码切换能力,可通过语言、关键词和上下文偏置提升准确率。该模型在 ArtificialAnlys 流式语音转文字和公开说话人分离基准上排名第一。它属于 Muse Spark 系列的自回归多模态 LLM,音频按 80ms 分块(12.5 Hz)逐 token 处理,结合词错误率和延迟奖励的 RL 实现自适应延迟,已在 Meta Model API、Meta AI for Mac 和 Muse Code 上线。
匹配字段摘要
中国 AI 周报汇总本周三项焦点:智谱认领神秘模型“Ox Alpha”为 GLM-5.3-Flash,DeepSeek 以接近 $74 billion 的目标估值推进上市前融资,北京举办第二届世界人形机器人运动会。GLM-5.3-Flash 采用 320-billion-parameter、18B active 的多模态架构,并完全运行于中国国产芯片;智谱随后以 MIT license 开放 GLM-5.3 权重。同期还有 Hy4、Qwen3.8-Flash、Ling-3.0-flash-Fin 等模型进展,以及 AI 产品整合、监管和安全动态。
匹配字段摘要
125B/6B,1M 上下文,多模态,现已登陆 OpenCode Go。⚡ 用 Qwen3.8-Flash 快乐编码!
匹配字段摘要
Gemini Omni 1.1 Flash 通过 Partner Nodes 在 ComfyUI 上线,可在 Gemini Video Omni 节点中选择该模型,支持文生视频、图生视频、参考生视频、视频编辑和场景延展,分辨率覆盖 360p 到 4K,每段视频自带生成音轨。该模型原生多模态处理文本、图像、音频和视频,支持用自然语言描述修改并保留画面其余部分,编辑结果可叠加,场景延展会延续原有运动、角色身份和光照。节点提供提示词、分辨率、宽高比、任务类型选择以及可选的图像和视频输入,更新 ComfyUI 至最新版本或使用 Comfy Cloud 即可使用。

匹配字段摘要
Google Research 发布 Google Earth AI 下的实验性研究能力行星预测引擎(PPE),可依据自然语言查询自主完成数据检索、特征工程、模型训练评估并生成报告,把复杂行星级预测建模从数周人工流程缩短到几分钟。在 21 项 CDC 健康指标上,PPE 的平均 R² 为 76.8%,高于人工专家流程的 60.0%;在尼日利亚粮食安全降尺度任务中 R² 达 66.1%,基线为 31.5%;在刚果(金)2026 年 Bundibugyo 埃博拉疫情期间的实时热点预测中 Recall@10 为 83.3%,较已发表的贝叶斯建模基线约 73% 提升 10.3 个百分点。研究还发现统计协变量与基础模型嵌入向量具有互补性,多模态融合加智能数据选择优于基线。
匹配字段摘要
Unsloth 宣布 GLM-5.3-Flash 可通过其 GGUF 量化版本在本地运行,3-bit 量化需要 128GB 内存,并附上使用指南与 GGUF 下载链接。被引用的 Z.ai 发布信息显示,GLM-5.3-Flash 为 320B-A18B 模型,采用 MIT 许可证,原生多模态并支持 1M token 上下文窗口,此前以 Ox Alpha 名义预览,完全运行在中国 AI 芯片上。Unsloth 称该模型在 DeepSWE、编码与智能体基准上可与 Claude Opus 4.8 相比。
匹配字段摘要
Cohere 推出视觉语言模型 Parse,将多模态企业文档转换为结构化数据,现已通过 Cohere API、Model Vault、Microsoft Foundry 和 AWS SageMaker 正式提供。Parse 支持九种主要语言,能够识别表格和嵌入图片并输出 Markdown,在 ParseBench 的三个评测维度中得分 79.2。Cohere API 定价为每 1,000 页 $1.50,8 H100 GPU 节点的处理速度为每秒 36 页。
匹配字段摘要
阿里发布 Qwen3.8-Flash-Next 权重,作为 Qwen4 架构预览供开发者实验评估,这是一个 125B 参数、每 token 激活 6B 的多模态 MoE 模型,原生上下文窗口 262,144 token,借助 YaRN 可扩展至 1M token。NVIDIA 提供 SGLang、vLLM 和 TensorRT LLM 的 Day 0 功能支持,并在 GB300 NVL72 上验证推理,单 GPU 吞吐超过 16K token/秒、单用户超过 200 token/秒。开发者可用 NVIDIA NeMo AutoModel 微调、用 NeMo RL 做强化学习,权重可从 Hugging Face 或 ModelScope 下载。

匹配字段摘要