←搜索结果

按匹配度 · 共 680 条结果 清除搜索

星期五

  1. goose 官方博客精选

    goose 桌面端内置基于 llama.cpp 的本地推理模型

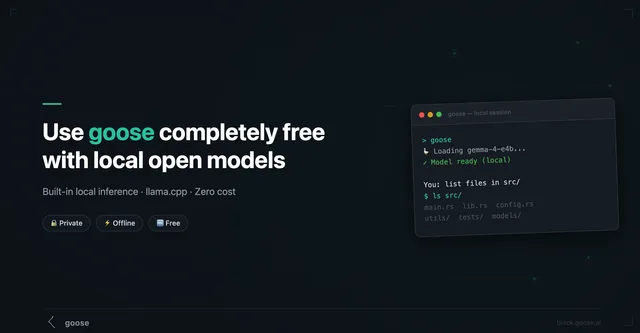
    goose 在桌面应用中内置了由 llama.cpp 驱动的本地推理,选择 Local provider 后可直接从 Hugging Face 下载量化 GGUF 模型并在本机运行,无需 Ollama、Docker 或外部服务器,也无需 API key,可离线使用。官方说明本地模型首次请求需 30–120 秒加载,上下文多为 4K–8K token,工具调用是最大短板,Gemma 4 表现较好而模拟模式仅限 shell 命令;建议从小模型起步并使用 Code Mode。
    blog cover

    匹配字段标题

星期四

星期三

  1. Modal 官方工程博客

    Physical Intelligence 如何在 Modal 上实现机器人实时远程推理

    Physical Intelligence(Pi)将其 Visual-Language-Action(VLA)模型的实时推理跑在 Modal 上,网络开销仅增加约 10-15ms。为避开 TCP 在连续控制回路中的抖动和队头阻塞,双方基于 UDP 构建了 QUIC 传输门户,借助 STUN 与 UDP 打洞实现自动 NAT 穿透,让机器人一次连接即可持续流式传输观测并接收动作输出。Pi 还能按区域固定推理部署、把检查点存入 Modal Volumes,加载检查点耗时不到 30 秒。

    匹配字段标题

星期二

  1. Together AI Blog精选

    Aurora:从实时推理轨迹持续学习的开源推测解码框架

    Together AI 发布 Aurora,通过强化学习从实时推理轨迹持续更新推测解码的草稿模型,相比训练良好的静态模型额外加速 1.25x,更新期间不中断服务。在涵盖五个领域的 40,000 条提示词混合流实验中,从零开始在线训练的接受长度达 3.08,高于静态基线的 2.63 和预训练后微调方案的 2.99,吞吐量稳定在 302.3 tokens/s。

    匹配字段标题

星期六

  1. Redwood Research:Blog

    Redwood Research:AI 能力提升并非源于推理成本下降

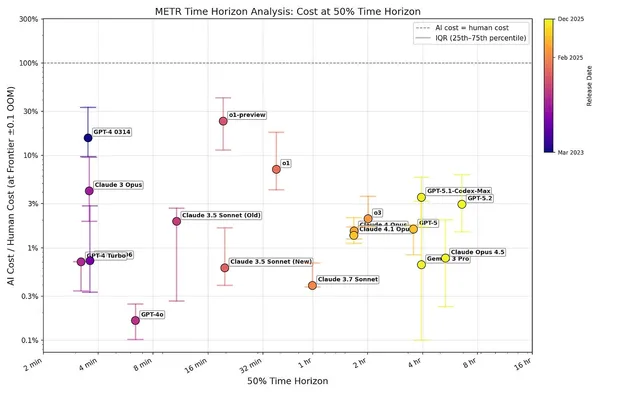
    Redwood Research 分析 METR 数据显示,当前前沿模型在其 50% 可靠性时间跨度上完成任务,推理成本约为人类成本的 3%,且该比例未随能力提升而上升。研究还发现,成功完成的任务中,更长任务并未带来更高的成本比;即使将每任务 AI 支出限制在人类成本的 1/32,时间跨度趋势仍约每 3 个月翻倍。作者认为成本并非能力之外的额外瓶颈,自动化时间点可参照 METR 能力趋势线预测。

    匹配字段标题

星期四

  1. Modal 官方工程博客

    Runway 选择 Modal 为 Runway Characters 提供实时推理算力

    Runway 宣布与 Modal 合作,由 Modal 的无服务器计算平台为 Runway Characters 提供实时推理支持。Runway Characters 是基于通用世界模型 GWM-1 的实时视频智能体 API,可从单张图片生成数字人形象且无需微调,已服务财富 10 强科技公司、好莱坞制片厂等数千家机构。借助 Modal,Runway 团队在 30 天内从概念验证推进到生产环境,并通过一行代码将容器扩展为支持 RDMA 网络的多节点 GPU 集群。

    匹配字段标题

星期三

  1. Together AI Blog精选

    Together AI 扩展微调服务,支持工具调用、推理和视觉

    Together AI 扩展 Together Fine-Tuning,新增工具调用、推理轨迹和视觉语言模型微调支持。升级后的训练栈可更高效处理 100B+ 参数模型,吞吐量最高提升 6×,并支持最大 100GB 的数据集。服务还新增训练前成本估算和训练中 ETA;推理微调支持 Qwen 与 Z.AI,VLM 微调支持 Qwen、Google 和 Meta 模型。

    Screen showing fine-tuning job details with timestamps, events like JOB_PENDING, MODEL_DOWNLOAD, and messages.

    匹配字段标题

星期二

  1. Together AI Blog精选

    Mamba-3:面向推理效率设计的状态空间模型

    Together AI 等机构推出以推理效率为核心的 Mamba-3,通过更强的递归公式、复数状态跟踪和 MIMO 变体提升性能。1.5B 规模下,Mamba-3 SISO 在所有测试序列长度上的预填充加解码延迟均优于 Mamba-2、Gated DeltaNet 和 Llama-3.2-1B;相关 Triton、TileLang 和 CuTe DSL 内核已开源。

    匹配字段标题

  2. Mistral AI精选

    Mistral AI 发布 Mistral Small 4,统一推理、多模态与编码能力

    Mistral AI 发布 Mistral Small 4,这是 Mistral Small 系列的下一个主要版本,也是 Mistral 首个把 Magistral 的推理、Pixtral 的多模态和 Devstral 的智能体编码能力统一到单一模型中的版本,采用 Apache 2.0 许可。模型为 MoE 架构,128 个专家、每 token 激活 4 个,总参数 119B、每 token 激活 6B(含嵌入和输出层为 8B),上下文窗口 256k,支持文本与图像输入,并可通过 reasoning_effort 参数在快速响应与深度推理之间切换。官方称相比 Mistral Small 3,端到端完成时间减少 40%,每秒请求数提升 3 倍;推理模式下在三项基准上匹配或超过 GPT-OSS 120B,且输出更短。

    Performance Comparison Across Internal Models

    匹配字段标题

星期三

  1. LMSYS Blog精选

    SGLang 首日支持 NVIDIA Nemotron 3 Super,面向多智能体系统推理

    SGLang 宣布在发布当天支持 NVIDIA Nemotron 3 Super,并给出安装与推理部署步骤。Nemotron 3 Super 是 120B 参数的混合 MoE 模型,每次前向仅激活 12B 参数,支持 1M token 上下文,官方称其吞吐效率最高可达上一代 Nemotron Super(Llama Nemotron Super 1.5)的 5 倍,并支持 Multi-Token Prediction 与 Thinking Budget。模型权重已在 Hugging Face 提供 BF16、FP8 和 NVFP4 版本,可配合 SGLang 在 4xH200 等配置上部署。

    匹配字段标题

星期五

  1. Sarvam AI Blog精选

    Sarvam AI 开源 Sarvam 30B 与 105B 推理模型

    Sarvam AI 开源 Sarvam 30B 和 Sarvam 105B 两款从零训练的推理模型,预训练分别使用 16T 和 12T token,训练全程在印度完成,采用 IndiaAI mission 提供的算力。两款模型均为 MoE 架构,30B 仅 2.4B 激活参数并使用 GQA,105B 采用 MLA,权重可从 AI Kosh 和 Hugging Face 下载,并支持 Transformers、vLLM、SGLang 本地推理。官方称两者在印度语言基准上取得领先结果,30B 已用于对话智能体平台 Samvaad,105B 用于 AI 助手 Indus。

    匹配字段标题

星期三

星期五

  1. LMSYS Blog

    SGLang 在 NVIDIA GB300 NVL72 上实现最高 25 倍推理性能提升

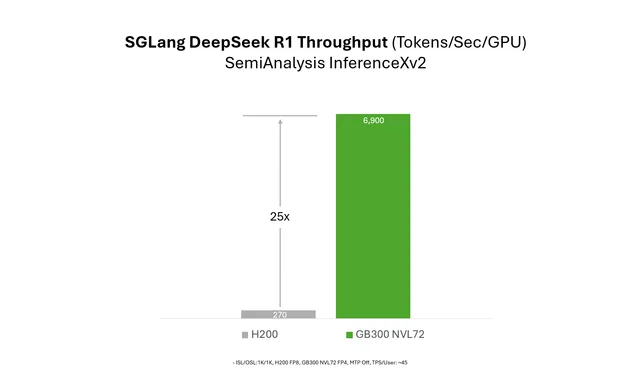
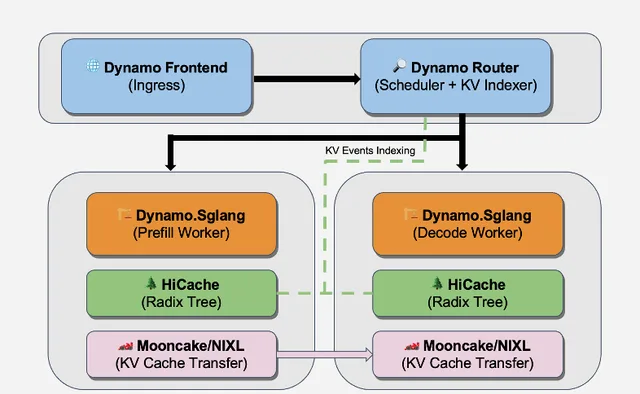
    SGLang 与 NVIDIA 合作,在 InferenceXv2 基准上于 GB300 NVL72 运行 DeepSeek R1 时相比 H200 实现最高 25 倍性能提升,该对比基于 50 TPS/user 的低延迟场景。借助 NVFP4 GEMM、计算通信重叠和 NVIDIA Dynamo 等优化,SGLang 在 GB200 NVL72 上的性能也在不到 4 个月内提升最高 8 倍。后续将推进 GB300 NVL72 的 MTP 支持及 Qwen 3.5 等模型的调优。

    匹配字段标题

星期四

  1. LMSYS Blog

    在 GB300 NVL72 上部署 DeepSeek:长上下文推理大幅提速

    LMSYS 分享了在 GB300 NVL72 上优化 DeepSeek R1-NVFP4 长上下文(128K/8K ISL/OSL)推理的进展,SGLang 实现最高 226 TPS/GPU,较 GB200 提升 1.53 倍。在相同吞吐下 MTP 将单用户吞吐提升 1.87 倍,匹配延迟条件下 GB300 较 GB200 提升 1.38X-1.58X TPS/GPU。GB300 的 288GB HBM 支持 1.6 倍有效解码批大小(40 vs 24 req/GPU),128K 预填充 TTFT 为 8.6s。

    匹配字段标题

星期四

  1. Redwood Research:Blog

    Redwood Research:区分推理扩展与“更大任务消耗更多算力”

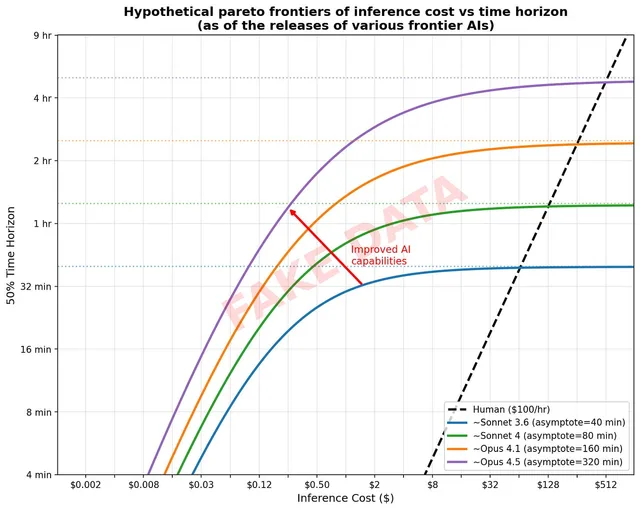
    Redwood Research 指出,推理成本上升有两种原因:LLM 承担了人类耗时更长的更大任务,或在同一任务上消耗了相对人类成本更高比例的算力。只有后者才算推理扩展,前者只是更大任务消耗更多 token。作者以 50% 可靠性时间跨度与人类成本占比构成的帕累托前沿分析,并推测 2025 年前沿主要以前者方式移动。

    匹配字段标题

星期一

  1. Qwen Blog精选

    Qwen 发布旗舰推理模型 Qwen3-Max-Thinking

    Qwen 团队发布旗舰推理模型 Qwen3-Max-Thinking,通过扩大参数规模并投入大量算力做强化学习,在事实知识、复杂推理、指令遵循、人类偏好对齐和智能体能力上均有提升,在 19 项基准上表现与 GPT-5.2-Thinking、Claude-Opus-4.5、Gemini 3 Pro 相当。模型新增自适应工具调用能力,可在对话中自主调用内置的 Search、Memory 和 Code Interpreter,已在 chat.qwen.ai 上线;同时采用经验累积的多轮测试时扩展策略,在 GPQA、HLE、LiveCodeBench v6 等基准上优于标准并行采样。API 模型名为 qwen3-max-2026-01-23,兼容 OpenAI 与 Anthropic 接口协议,可直接配合 Claude Code 使用。

    匹配字段标题

星期六

  1. Ahead of AI

    提升 LLM 推理能力的推理时扩展方法分类

    Sebastian Raschka 将提升 LLM 答案质量与准确性的推理时扩展方法归纳为多个类别,重点讨论不改变模型权重的训练后技术。内容涵盖 CoT 提示、自洽性、Best-of-N 排序、验证器拒绝采样、自我改进和解题路径搜索;相关实验经超参数调优后进行了数千次运行,使基础模型准确率从约 15% 提升至约 52%。

    匹配字段标题

星期二

  1. Liquid AI 模型与工程博客精选

    Liquid AI 发布 LFM2.5-1.2B-Thinking 端侧推理模型,内存占用低于 1GB

    Liquid AI 发布 LFM2.5-1.2B-Thinking,一款完全在设备端运行的推理模型,在手机上内存占用低于 900 MB,已在 Hugging Face、LEAP 和 Playground 上线。该模型为 1.2B 参数,相比 LFM2.5-1.2B-Instruct 在 MATH-500 上从 63 提升到 88、Multi-IF 从 61 提升到 69、BFCLv3 从 49 提升到 57,并在多数推理基准上匹配或超过参数量多 40% 的 Qwen3-1.7B。训练上采用课程式 RL 与模型合并,通过偏好对齐和 n-gram 重复惩罚把 doom loop 比例从 15.74% 降到 0.36%,并获 Qualcomm、Ollama、FastFlowLM、Cactus Compute 等新发布伙伴支持。

    匹配字段标题

星期五

  1. LMSYS Blog

    SGLang-Diffusion 发布两个月:推理速度较初版提升 2.5 倍

    SGLang-Diffusion 自 2025 年 11 月初发布以来,经两个月优化后(docker 镜像 lmsysorg/sglang:dev-pr-17247)比初版快 2.5 倍,在 NVIDIA GPU 上比其他方案最高快 5 倍。新增对 Flux.2、Qwen-Image-Edit-2511、Z-Image-Turbo、GLM-Image 等模型的 Day-0 支持,并集成 Cache-DiT、支持 LoRA 与 ComfyUI 自定义节点。

    匹配字段标题