Gemini 3 Flash 上线,兼具 Pro 级推理与 Flash 级延迟
Gemini 3 Flash 已上线,将 Gemini 3 的 Pro 级推理能力整合进更精简的模型,同时提供 Flash 级的延迟、效率和成本。目前可通过 API、Gemini App 和 Search 使用。
匹配字段标题、摘要
Gemini 3 Flash 已上线,将 Gemini 3 的 Pro 级推理能力整合进更精简的模型,同时提供 Flash 级的延迟、效率和成本。目前可通过 API、Gemini App 和 Search 使用。
匹配字段标题、摘要
Modal 官方工程博客指出,AI 推理中的主机开销表现为 GPU kernel 利用率偏低,即 GPU 因等待 CPU 准备任务而空转。若主机开销达到 50%,推理的 GPU 成本将是原本的 2 倍,而 GPU 成本通常是推理成本的主要来源。文章建议用 PyTorch Profiler 或 Nsight Systems 追踪 CUDA 流中的空隙,并通过在 GPU 上构造张量、减少 CPU 与 GPU 间不必要的数据传输和同步来降低开销。

匹配字段标题、摘要
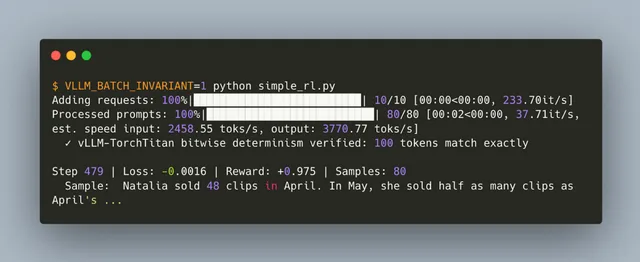
vLLM 与 TorchTitan 开源展示了逐位一致的在线强化学习方案,使 Qwen3 1.7B 的训练与推理数值完全匹配。实验中启用逐位一致性后,模型用更少步骤取得更高总奖励,但当前运行速度比非逐位一致方案慢 2.4x。
匹配字段标题、摘要
Ollama 与 OpenAI、ROOST 合作,将 gpt-oss-safeguard 推理模型引入 Ollama,用于安全分类任务,提供 20B 和 120B 两个规模,采用 Apache 2.0 许可。该模型面向 LLM 输入输出过滤、在线内容标注和信任与安全场景,可读取用户自带的书面策略,并开放完整推理过程供调试,推理强度支持 low、medium、high 三档调节。OpenAI 在内部评测和 2022 年论文发布的审核数据集及 ToxicChat 上对其进行了评估。

匹配字段标题、摘要
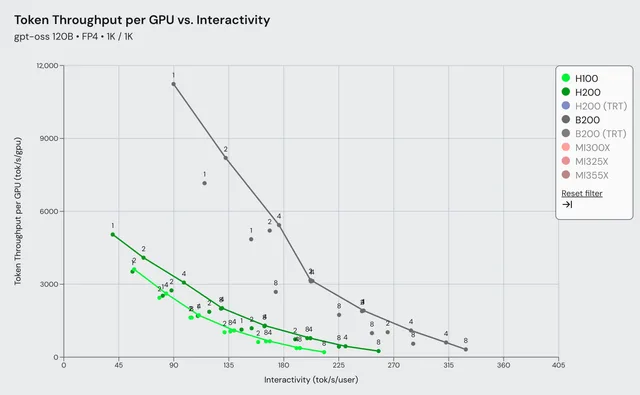
vLLM 与 NVIDIA 针对 Blackwell 优化大语言模型推理,在相近延迟下,gpt-oss 120B 和 Llama 3.3 70B 的吞吐量较上一代 Hopper 最高提升约 4x。双方通过一百多个 pull request 优化注意力、GEMM、MoE 内核、图融合和异步调度,并加入自动量化后端选择与 FlashInfer 自动调优。SemiAnalysis InferenceMAX 每日更新测试结果,以不同输入输出长度和 Pareto 前沿比较吞吐量与响应速度。
匹配字段标题、摘要
Browser Use 发布 0.8.0,推出 ChatBrowserUse 网关,称在保持相同性能的前提下把延迟降低 6 倍,智能体可达每分钟 20 步。官方称 BU 1.0 准确率约 65%,与 Claude Sonnet 4、Claude Sonnet 4.5、Gemini 2.5 Computer Use、OpenAI Computer-Using Model 等计算机使用模型相当,但速度快 4 倍,单条轨迹纯 LLM 推理时间约 68 秒,其他模型约 225 至 330 秒。使用时只需配置 BROWSER_USE_API_KEY 一个环境变量即可接入。
匹配字段标题、摘要
LG AI Research 发文解读阿里通义实验室的 WebDancer 论文,该方法通过网页搜索工具增强大推理模型(LRM)的长链推理,缓解长推理中的信息缺口与模型幻觉。论文提出 CRAWLQA 与 E2HQA 两种合成数据生成方法:前者基于 arXiv、GitHub、Wikipedia 等多跳网页生成 QA,后者将简单事实问题逐步改写为需多步推理的难题。
匹配字段标题、摘要
Jakub Pachocki 团队的推理模型在约 5 小时内解出 2025 ICPC 世界总决赛全部 12 道题,而最佳人类队伍解出 11 道。该模型族此前还在 AtCoder Heuristics World Finals 获得第二名,并在国际数学奥林匹克和国际信息学奥林匹克中获得金牌;团队下一步将研究更开放、时间跨度更长的问题及长期运行模型的安全与对齐。
匹配字段标题、摘要
vLLM Semantic Router 为 vLLM 推理引擎提供开源的意图感知路由层,按查询复杂度选择快速路径或 CoT 推理模式。试验中,该设计使准确率提高约 10%、延迟降低约 50%、token 减少约 50%,并支持通过 Kubernetes 和 Envoy 部署。v0.1 路线图包括语义缓存、多因素路由、性能测试和路由策略可视化。
匹配字段标题、摘要
文章系统解析 vLLM V1 如何从单 GPU 离线推理扩展到多 GPU、多节点异步服务。内容涵盖调度器、PagedAttention、连续批处理、前缀缓存、引导解码、推测解码、P/D 分离及分布式请求链路,并说明如何用 vllm bench 衡量延迟与吞吐量。分析基于 2025 年 8 月 9 日的 commit 42172ad。

匹配字段标题、摘要
vLLM 介绍了如何在 NVIDIA Blackwell 和 Hopper GPU 上加速 GLM-4.5 与 GLM-4.5V 系列推理,其最新主分支已支持两类模型。GLM-4.5 与 GLM-4.5V 均提供 FP8 和 BF16 精度版本,可使用相同命令运行;8x H100 显存不足时需添加 `--cpu-offload-gb 16`,遇到 flash_infer 问题可暂用 `VLLM_ATTENTION_BACKEND=XFORMERS`。GLM-4.5V 还支持根据复杂描述逐步推理并输出目标对象的边界框坐标。
匹配字段标题、摘要
Liquid AI 宣布 Liquid Edge AI Platform(LEAP)原生支持 AMD 最新 Ryzen 和 Ryzen AI 处理器,开发者可在搭载 Zen 5 架构与 Radeon 集成显卡的笔记本上本地运行 LFM 模型,无需依赖云端推理。LEAP 以 llama.cpp 为推理引擎,LFM2-1.2B-Q4_0.gguf 在 AMD 硬件上实现亚 100 毫秒延迟,集成 GPU 的提示词处理速度接近独立显卡,CPU 解码速度在消费级硬件中领先。SDK 已可用,后续将支持 LFM-2-VL 视觉语言模型并扩展至更多推理引擎。
匹配字段标题、摘要
百川智能推出医学增强推理模型 Baichuan-M2,称其在 HealthBench 评测中超过包括 gpt-oss-120b 在内的所有开源模型。该模型已开放在线试用。
匹配字段标题、摘要
Mistral AI 为 Le Chat 新增 Deep Research(预览)、Voxtral 驱动的语音模式、Magistral 驱动的多语言推理、Projects 及与 Black Forest Labs 合作的高级图像编辑。用户可在 chat.mistral.ai 或移动应用中免费试用,无需信用卡。

匹配字段标题、摘要
Jakub Pachocki 表示,思维链忠实性与可解释性显著影响了 OpenAI 从 o1-preview 开始的推理模型设计。随着 AI 投入更多算力处理长期研究问题,隐藏思维链可为监控内部过程和验证模型意图提供途径。OpenAI 正加大对“为可解释性而训练”的研究投入,以兼顾推理解释能力与可验证性。
匹配字段标题、摘要
vLLM 通过内存管理与底层计算优化支持 MiniMax-M1 的混合架构,实现长上下文高效推理与部署。MiniMax-M1 总参数量为 456B,推理时动态激活约 45.9B 参数;其 Lightning Attention 已通过 Triton 集成至 vLLM。文章还提供了使用 vLLM 和 Docker 部署该模型的快速指南。
匹配字段标题、摘要
Liquid AI 基于 1.3B 的 LFM 模型,通过约 4.5M 样本的监督微调和短程强化学习,训练出 LFM-1.3B-Math,使其在有限响应预算下具备简洁数学推理能力。该模型无需数学专用预训练,适合内存和生成速度受限的边缘设备部署。
匹配字段标题、摘要
Mistral AI 发布首款推理模型 Magistral,主打专业领域、透明且多语言的推理能力,提供 24B 参数的 Magistral Small 和企业版 Magistral Medium。两者在 AIME2024 分别得分 70.7% 和 73.6%,采用 majority voting @64 后升至 83.3% 和 90%。Small 以 Apache 2.0 许可开放权重并支持自行部署;Medium 预览版可通过 Le Chat 和 La Plateforme API 使用。

匹配字段标题、摘要
Sarvam AI 基于 24B 的 Mistral Small(Apache 2.0 许可)经 SFT 与 RLVR 后训练,推出混合推理模型 Sarvam-M,在印度语言基准上平均提升 20%、数学基准提升 21.6%、编程基准提升 17.6%,罗马化印度语言 GSM-8K 提升 86%。该模型在多数基准上超过 Llama-4 Scout,与 Llama-3.3 70B、Gemma 3 27B 相当,但 MMLU 等英文知识基准下降约 1 个百分点。团队还用 TensorRT-LLM 完成 FP8 量化与 lookahead decoding,并在 H100 上部署于 NVCF。
匹配字段标题、摘要
Lilian Weng 在 Lil'Log 发文梳理测试时计算与思维链(CoT)推理的近期进展,解释让模型“思考更久”为何有效。文章从心理学双过程理论、计算资源视角和隐变量建模三条路径展开,指出 CoT 让模型按问题难度灵活分配算力,并回顾从 GSM 数据集到 o1-preview、o3 与 DeepSeek R1 技术报告的 RL 训练路线。
匹配字段标题、摘要