←搜索结果

按匹配度 · 共 3160 条结果 清除搜索

星期一

  1. Prime Intellect

    Prime Intellect 开源分布式推理栈,面向消费级 GPU 与公网高延迟

    Prime Intellect 发布分布式推理栈预览,并开源 PRIME-IROH、PRIME-VLLM、PRIME-PIPELINE 三个代码库,目标是让消费级 GPU 通过公网连接运行推理。文章指出流水线并行通信需求最低,适合分布式环境,但同步流水线会因 100ms 级跨洲延迟形成吞吐上限,而异步微批调度在内存带宽受限的解码阶段无法带来训练那样的加速。团队称已可用私有硬件通过公网跑推理,正把组件接入自家栈,用于 SYNTHETIC-2 合成数据运行。

    匹配字段标题、摘要

星期四

  1. Zyphra Research

    Zyphra 推出 ZR1-1.5B:面向数学与代码的小型推理模型

    Zyphra 发布 ZR1-1.5B,一个基于 DeepSeek-R1-Distill-Qwen-1.5B、用强化学习在代码与数学题上训练的小型推理模型。它在 LCB_Generation 上与 Claude3-Opus、Gemma2-27B 持平,在竞赛数学上超过 Qwen2.5-72B,且推理 token 比 R1-Distill-1.5B 少 60%、比 DeepScaleR 少 53.5%。截断到 2048 token 时,其数学评测平均 pass@1 达 40.39%,高于 Qwen-2.5-Math-7B-Instruct 的 37.01%。

    匹配字段标题、摘要

星期二

  1. METR Blog

    METR:为什么 AI 推理应当可读且忠实

    METR 发文主张 AI 系统的推理过程应当既「可读」(人类能读懂)又「忠实」(真实反映模型的决策过程),认为这有助于发现 AI 错误、检测隐藏议程、监控欺骗行为和识别能力造假。文章指出 OpenAI、Anthropic、xAI、Google DeepMind 和 DeepSeek 都在过去四个月里发布了推理模型,其当前产出的推理已具价值、值得保留。

    匹配字段标题、摘要

星期五

星期一

星期一

  1. antirez 原创博客

    antirez:推理模型本质上仍是大语言模型

    antirez 撰文指出,DeepSeek R1 是纯 decoder-only 自回归模型,仍是下一 token 预测,模型内部没有任何显式符号推理或表示。R1 Zero 无需任何监督微调即可获得类似推理能力,仅靠生成思维链并用强化学习优化奖励函数;S1 论文显示少至 1000 个样本就能让模型构建复杂推理步骤。他认为推理模型本质上仍是大语言模型,曾断言 LLM 是死路的人错了。

    匹配字段标题、摘要

星期一

星期三

星期二

  1. Prime Intellect精选

    Prime Intellect 发布 INTELLECT-MATH 数学推理模型与 500 万条推理轨迹数据集

    Prime Intellect 通过 QwQ-32B 生成并校验合成推理轨迹,微调 Qwen-7B-Math 后再用 PRIME-RL 做在线强化学习,训练出 7B 参数数学推理模型 INTELLECT-MATH,其早期 checkpoint 以 47 个 RL step 达到 Eurus-2-7B-PRIME 用 592 步的效果,训练时间缩短 10 倍。团队同时开源代码、权重和 NuminaMath-QwQ-CoT-5M 数据集,该数据集包含 86 万道数学题上的 500 万条经正确性校验的推理轨迹。文章还提出在推理时计算范式下,RL 中大量前向计算会降低通信需求,使全球分布式训练成为可行路径,并计划今年训练 o3 的完全开源复现。

    Distributed Training in the Inference-Time-Compute Paradigm

    匹配字段标题、摘要

  2. vLLM 官方博客精选

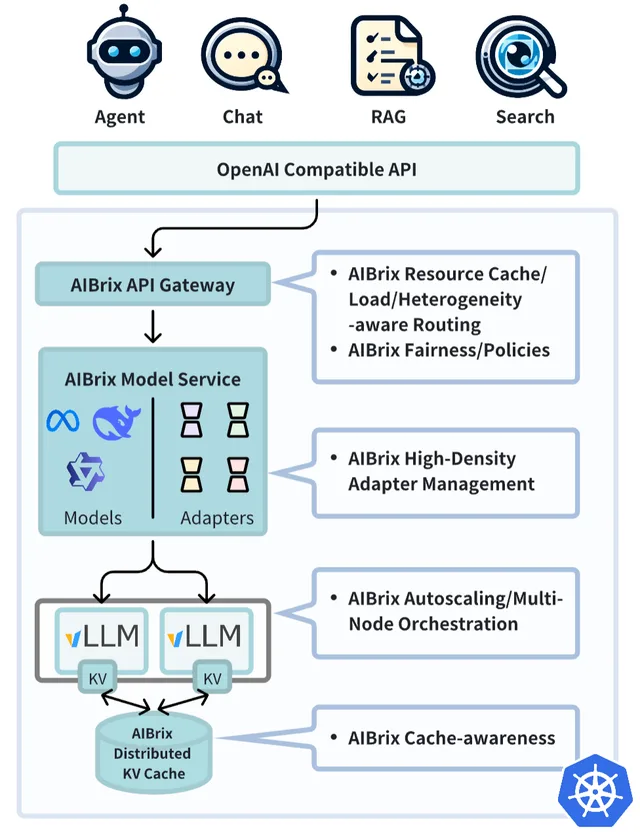
    vLLM 发布面向 Kubernetes 的开源推理栈 production-stack

    vLLM 与 LMCache 团队发布开源参考实现 vLLM production-stack,将单节点 vLLM 扩展为可在 GPU 集群运行的完整推理服务。它支持 KV cache 共享与存储、前缀感知路由、TTFT 和 TBT 等指标观测及自动扩缩容,并可通过 Helm chart 部署到 Kubernetes。多轮问答基准结果显示,该方案在首个 token 延迟和 token 间延迟方面优于 vLLM + KServe 与一个商业端点服务。

    匹配字段标题、摘要

星期六

  1. The Gradient

    神经算法推理:让神经网络学会执行经典算法

    The Gradient 刊文探讨神经算法推理,即用深度神经网络捕捉最短路径、排序等经典算法计算。文章指出,MIT 的《What Can Neural Networks Reason About?》证明算法对齐越好泛化越好,GNN 与动态规划天然对齐,在 DP 执行基准上优于归纳偏置较弱的架构。作者同时提醒,算法对齐并不能让人随意套用任意表达力强的 GNN,分布外表现仍是关键挑战。

    匹配字段标题、摘要、正文

星期二

星期三

  1. Lilian Weng:Lil'Log

    大型 Transformer 模型推理优化:蒸馏、量化与剪枝

    Lil'Log 梳理了大型 Transformer 模型的推理优化方法,涵盖知识蒸馏、量化(PTQ 与 QAT)和剪枝。文章指出推理瓶颈主要来自显存占用与低并行性:batch size 512、上下文长度 2048 时 KV cache 总计 3TB,是模型体积的 3 倍,且注意力机制开销随输入序列长度呈平方增长。DistilBERT 在参数减少 40% 的情况下保留 BERT 97% 的下游任务性能,推理速度提升 71%。

    匹配字段标题、摘要

星期六

  1. Browser Use

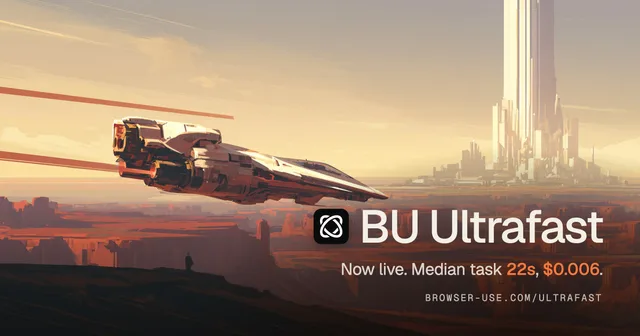
    Browser Use 上线 BU Ultrafast 浏览器智能体,中位任务 22 秒、成本 0.0064 美元

    Browser Use 将最快的浏览器智能体 BU Ultrafast 从等待名单开放到美国所有 Cloud 套餐,免费版也包含。官方数据显示其任务中位耗时 22 秒、单次成本 0.0064 美元,而默认智能体在 GPT-6 Luna 上为 79 秒、0.0098 美元。使用时只需把 model 设为 bu-ultrafast;需要更多逐步推理可改用同一智能体的 bu-fast,后者按标准费率计费。

    BU Ultrafast: a white craft racing over red canyons, median task 22s, $0.006

    匹配字段摘要、正文

  2. AWS Machine Learning

    Amazon Bedrock 成本端到端管理:面向 FinOps 与平台团队的实操手册

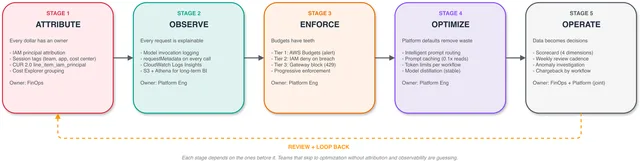
    AWS 给出管理 Amazon Bedrock 成本的五步闭环:按 IAM 主体归因、记录请求可观测性、用预算告警与硬性拦截控制支出、优化模型路由与缓存等平台默认值、按节奏复盘。Amazon Bedrock 已支持将推理成本自动归因到发起调用的 IAM 主体,调用方 ARN 写入 CUR 2.0 的 line_item_iam_principal 列,覆盖 IAM 用户、角色、联合身份与 API key。共享网关场景可按用户设置角色会话名与 session tag,凭证缓存最长 1 小时,恢复按用户和租户的归因。

    Five-stage Amazon Bedrock cost operating model loop: attribute, observe, enforce, optimize, operate

    AWS 给出管理 Amazon Bedrock 成本的五步闭环:按 IAM 主体归因、记录请求可观测性、用预算告警与硬性拦截控制支出、优化模型路由与缓存等平台默认值、按节奏复盘。Amazon Bedrock 已支持将推理成本自动归因到发起调用的 IAM 主体,调用方 ARN 写入 CUR 2.0 的 line item iam principal 列,覆盖 IAM 用户、角色、联合身份与 API key。共享网关场景可按用户设置角色会话名与 session tag,凭证缓存最长 1 小时,恢复按用户和租户的归因。

    匹配字段摘要、正文

  3. OpenAI:部署安全与系统卡精选

    OpenAI 发布 GPT-Rosalind-6 系统卡附录,面向生物科研开放受限访问

    OpenAI 发布 GPT-Rosalind-6 系统卡附录,该模型与 GPT-6 Astra 使用同一套权重,未新增训练数据或后训练,仅通过可信访问提供给经过审核的科研机构、企业和政府合作方。在最高推理预算下,MedChemBench v7 平均评分 49.6%(GPT-Rosalind-5.5 为 28.9%),GeneBench Pro v13 单次尝试成功率 37.7%(前代为 16.7%),LifeSciBench Gold 平均分 61.3%(前代为 44.0%)。按 Preparedness Framework,该发布在生物与化学领域定为 High 能力、未达 Critical 阈值,网络安全领域定为 Critical,AI 自我改进低于 High。

    匹配字段摘要、正文

  4. UCSD Hao AI Lab

    Hao AI Lab 开源 JetSpec++ 投机解码框架

    UCSD Hao AI Lab 开源 JetSpec++,通过因果并行草稿、隐藏状态预测器和锚点 token 解码器,把草稿阶段与验证流水线化,在 Qwen3-8B 上实现 1,361 TPS、较 DSpark 最高 1.54 倍端到端加速、较自回归解码 7.45 倍加速且保持无损。结合 NVFP4 与 kernel 优化后,Qwen3-8B 超过 4,000 TPS、Qwen3.8-27B 超过 900 TPS(两块 GB200 GPU)。模型、代码与推理引擎已全部开源。

    匹配字段摘要

  5. UCSD Hao AI Lab

    Hao AI Lab 开源 JetSpec++ 投机解码框架

    UCSD Hao AI Lab 推出 JetSpec++,通过因果并行草稿与验证流水线化,在 Qwen3-8B 上实现 1.54 倍于 DSpark、7.45 倍于自回归解码的无损端到端加速,BF16 下达 1,361 TPS。GSM8K 上 Qwen3-8B 每轮耗时从 DSpark 的 9.92 ms 降至 6.84 ms,草稿时间由 3.76 ms 压缩到 0.61 ms。模型、代码与推理引擎已全部开源。

    匹配字段摘要

  6. UCSD Hao AI Lab

    Hao AI Lab 提出 JetSpec++:将草稿生成与验证流水化,Qwen3-8B 上达 1.54 倍加速

    Hao AI Lab 提出 JetSpec++,通过因果并行草稿、隐藏状态预测器和锚点 token 解码器,把草稿生成与验证流水化,在 Qwen3-8B 和 Qwen3.8-27B 上实现无损加速。相比 DSpark,端到端最高加速 1.54 倍,相比自回归解码加速 7.45 倍,BF16 下分别达到 1,361 TPS 和 367 TPS;配合 NVFP4 与内核优化,在两块 GB200 上超过 4,000 TPS 和 900 TPS。7 个基准上每轮接受 8.94 个 token,DSpark 为 6.89 个;模型、代码和推理引擎已全部开源。

    匹配字段摘要