MIT 研究员警告:AI 可能在人类中制造虚假记忆
MIT Media Lab 研究员 Pattie Maes 的实验显示,AI 修改过的照片会让 200 名参与者产生更多虚假记忆,且他们对这些错误记忆更加确信。另一项研究中,与生成式 AI 聊天机器人讨论犯罪视频的参与者,虚假记忆数量是其他人的三倍。Maes 认为这一现象在法庭作证和历史记录等依赖准确记忆的场景中尤其危险。
匹配字段摘要
MIT Media Lab 研究员 Pattie Maes 的实验显示,AI 修改过的照片会让 200 名参与者产生更多虚假记忆,且他们对这些错误记忆更加确信。另一项研究中,与生成式 AI 聊天机器人讨论犯罪视频的参与者,虚假记忆数量是其他人的三倍。Maes 认为这一现象在法庭作证和历史记录等依赖准确记忆的场景中尤其危险。
匹配字段摘要
Ben's Bites 作者搭建了一个 all-in-one 站点,把 todos、email、crm、domains 等集中到一处,用于和 grok bot 等个人智能体协同工作,并能看清它做了什么、文件存在哪里。作者录制了短视频并附上可供智能体直接复制粘贴的完整说明,下一步计划加入日历视图来查看智能体运行的自动化任务。
匹配字段摘要
PyTorch 2.15 在 MPS 后端加入 FP8 支持,并让 MoE 模型解码速度比 2.14 快 5–6.5 倍:在 M3 Ultra 上配合 torch.compile,Qwen3.6-35B-A3B 从 9.4 tokens/s 提升到 61.3 tokens/s,LFM2.5-8B-A1B 从 23.6 提升到 123.6 tokens/s。Wan2.2 的 tiled VAE 视频解码峰值驱动内存从约 270 GiB 降到 8 GiB,Qwen-Image-2.1 的 VAE 编码在 MPS 上的图像损坏问题也随 padding 改动修复,编解码往返 PSNR 从 10.06 dB 升到 29.95 dB。该版本要求 macOS 15 或更高版本、Python 3.11 或更高版本。
匹配字段摘要、正文
小米技术宣布 Xiaomi MiMo-V2.6-Pro 正式上线 WorkBuddy,支持 1M 超长上下文、多智能体分工协作,以及图像、视频、音频、文本全模态联合理解。该模型在 Artificial Analysis 智能指数为 46 分,官方称全球开源第一。MiMo-V2.6 系列于 9 月 22 日发布并开源,含 Pro 与 Flash 两个原生全模态模型,Pro 定价为每百万词元输入 3 元、输出 6 元,并提供 99% 缓存折扣。
匹配字段摘要、正文
Ammaar Reshi 称他用 Gemini 4 Argon 在后台运行智能体,两小时内自主查看 Tesla Roadster 官网的样式与文案、查找 Subway Surfers 参考、观看 Roadster 发布视频理解推进器原理,并多次自我批评迭代,还用 Lyria 生成音乐、用 Gemini TTS 生成解说。他本人只花了约 10 分钟调整操控和镜头,随后在 AI Studio 发布,该游戏自上周五起已有超过两万人试玩。他认为一年前这类工作要花整个周末盯代码和测试,如今做游戏和实现想法的方式正在快速改变。
匹配字段摘要
Viggle 发布 JST-2,将整套模型栈构建在 3D 空间,用携带 xyz 坐标、属性向量和动力学向量的 Physics-Native Token 表示世界,而非从视频像素中隐式推断物理规律。架构分为 JST encoder、JST generator 和 JST decoder 三部分,单次前向推理约 1 秒生成完整 3D 场景,成本低于 $0.01(B200),并支持最多 64 个输入视角作为空间上下文窗口。Viggle 公布的盲测人类偏好显示,角色生成对 Meshy 7.1 胜率 58.4%、对 Tripo H3.1 胜率 73.2%,视频生成运动对 DeepMotion 胜率 89.1%。JST-3 计划把学习到的动力学推广到物体交互。
匹配字段摘要、正文
Grok Bot 0.71.2 发布,通知更智能;单条消息支持最多 20 个文件,文件上限 250 MB(视频 1 GB);表单可预填。作者称还有更多更新。
匹配字段摘要、正文
Hao AI Lab 宣布推出全新的 FastVideo FastH3-QAD-v2 以及 H3 NVFP4 VAE 解码器。团队表示,这段 768p 视频在两张 DGX Spark 上生成,使用 QAD-v2 和两款新解码器,采用 8 步视频与音频生成,并使用了 QAD 权重。
匹配字段摘要、正文
Suno 发帖介绍 Studio 2.0 中三个可能被用户错过的功能,并附上视频演示。
匹配字段摘要
Amazon CEO Andy Jassy 向 a16z 联合创始人 Ben Horowitz 表示,Amazon 的算力已用尽,短缺将持续到 2028 年之后。Horowitz 认为这与互联网泡沫不同,当年网络先于足够用户建成,而 AI 领域的需求超过任何供应方所能提供。完整视频见 All-In Podcast 的 YouTube 频道。
匹配字段摘要
奥斯卡摄影师鲍德熹与爱奇艺合作推出「鲍德熹·爱奇艺 AI 剧场」创作营,从编剧、镜头语言到高阶 AI 技巧授课,最终选出 15 支队伍制作 15 分钟以上的 AI 故事片,并计划在一个季度内上线国内首个 AI 剧场。爱奇艺以厂牌方式系列化运营该内容,将其与普通 AI 短视频、AI 漫剧区分,并称会与各家模型公司合作、由创作者选择流程与工具。
匹配字段摘要、正文
AI 芯片初创公司 Tenstorrent 完成 15 亿美元融资,估值达 62 亿美元,较 2024 年底的 26 亿美元翻倍以上。本轮由 Trace Capital 和 Innovation X 领投,Cadence Ventures、Eclipse、Fidelity、SanDisk、T. Rowe Price 参投。CEO Jim Keller 表示,公司在展示 Galaxy 服务器可运行 DeepSeek 模型后决定保持独立并继续融资,新资金将用于扩展面向开源权重模型推理和视频生成的芯片。
匹配字段摘要、正文
纽约市长 Zohran Mamdani 在 AI Now Institute 主办的 The People's AI Assembly 活动上批评联邦政府在 AI 监管上“完全失职”,呼吁纽约人不要接受 AI 冲击就业与教育的“必然性”。他上月已下令禁止小学和初中使用 AI,今夏还推出政策要求房产挂牌照片或视频由 AI 生成时必须明确披露。Mamdani 称当前是“鲁莽地采用技术,却不对其局限做任何清算”。
匹配字段摘要
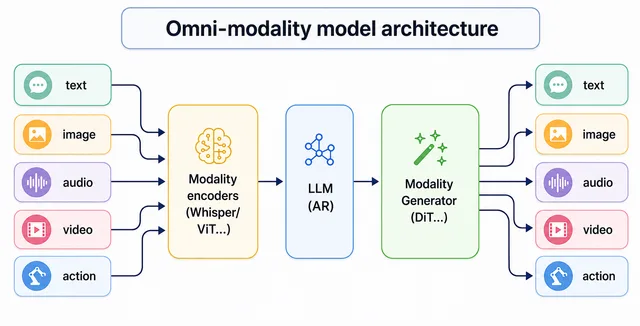
蚂蚁 inclusionAI 在 GitHub 发布 vLLM-Omni 仓库,这是一个在 vLLM 基础上扩展全模态模型推理与服务的框架,支持文本、图像、音频、视频和动作数据处理,并支持 DiT 等非自回归架构。README 显示其已迭代至 0.30.0,对齐 vLLM 0.30.0,新增 MiniCPM-o 4.5 与 AURA 的全双工会话服务、Mooncake AR-to-DiT 跨阶段 KV 与多模态传输,以及在 NVIDIA Blackwell 和昇腾 950 上的 MiniMax H3 Turbo 实时推理。框架提供 OpenAI 兼容 API 服务、流式输出和分布式并行推理,并列出 Qwen3-Omni、MiniMax H3、Wan2.2、π0.5 等已支持模型。
匹配字段摘要
可灵 AI 于 10 月 10 日至 13 日参加 ACFM 2026,与全球电影行业交流,并围绕 Kling 4.0 的模型能力汇聚亚洲一线电影人,探讨故事驱动型 AI 的未来及其对专业电影制作的影响。可灵 AI 表示将持续推动 AI 视频融入专业制作流程,与全球创作者合作把生成式 AI 带入真实工作流。
匹配字段摘要
Nace AI 发布多模态决策模型 Drex Max,可读取文本、图像和视频,单次决策耗时 34 ms,262K token 下响应低于 1 秒,输入价格为 $0.06 / 1M tokens。该模型不生成文本,只从给定选项中返回一个答案并附概率分数,可用于 Computer Use 智能体逐步选择操作、Web 智能体按屏幕内容定位页面元素。Nace AI 称其在 Computer Use 场景下每 token 成本最高比 Claude、GPT 和 Gemini 背后的模型低 167 倍。
匹配字段摘要
面壁智能宣布 MiniCPM-V 4.7 升至 Hugging Face Trending 第二位。该模型包含 35B-A3B MoE 版本,可在 iOS 和 Android 上以约 3GB 内存运行;1B 版本在 OCR、数学和视频理解上表现较强。官方同时给出了 Hugging Face 模型页和 GitHub 仓库链接。
匹配字段摘要
Viggle AI 发布 JST-2,称其为全球首个全栈物理原生世界基础模型。该模型没有在像素或视频空间学习,而是从第一性原理出发把整套模型栈建在 3D 空间,可在数秒内生成 3D 场景并实时扩展,还能通过同一通用架构创建自带动作的角色。
匹配字段摘要、正文
ElevenLabs 孵化的全球 AI 创意赛事 Chroma Awards 第二季开放报名,设电影、音乐视频、广告、游戏和幕后五个赛道,2027 年 1 月 1 日截止。本季提供超 45 万美元现金奖与差旅福利,并新增学生奖;ElevenLabs 另设 2.2 万美元专属奖,奖励使用 ElevenCreative、ElevenMusic 等工具的作品。首季有 122 个国家的 5550 多名创作者提交逾 6600 个项目。

匹配字段摘要、正文
ElevenLabs 发布面向内容创作者的语音转文字工作流指南,介绍用语音转文字生成视频字幕、播客节目笔记、可搜索内容库和内容翻译。ElevenLabs Caption Generator 可生成带词级和字符级时间戳的转录文本,并导出 SRT 和 VTT 文件;Scribe v2 模型默认逐字转录,可在 Playground 开启“Clean Transcript”或通过 ElevenAPI 的 no_verbatim 参数切换为净化转录。

ElevenLabs 发布面向内容创作者的语音转文字工作流指南,介绍用语音转文字生成视频字幕、播客节目笔记、可搜索内容库和内容翻译。ElevenLabs Caption Generator 可生成带词级和字符级时间戳的转录文本,并导出 SRT 和 VTT 文件;Scribe v2 模型默认逐字转录,可在 Playground 开启“Clean Transcript”或通过 ElevenAPI 的 no verbatim 参数切换为净化转录。
匹配字段摘要、正文