AI 教培智能体的开发技术:五层架构拆解
AI 教培智能体通常按感知接入层、大脑推理层、教学动作执行层、知识与存储支撑层、安全与运维保障层五层搭建。大脑层由中央调度控制单元做意图识别与路由分发,并调度主控、语法纠错、出题评估等多个智能体协作。知识层用向量数据库做检索增强生成,并维护学生错题本、发音薄弱点等长时记忆画像。
匹配字段摘要
AI 教培智能体通常按感知接入层、大脑推理层、教学动作执行层、知识与存储支撑层、安全与运维保障层五层搭建。大脑层由中央调度控制单元做意图识别与路由分发,并调度主控、语法纠错、出题评估等多个智能体协作。知识层用向量数据库做检索增强生成,并维护学生错题本、发音薄弱点等长时记忆画像。
匹配字段摘要
作者认为“Agent +”场景中,会搭 Agent 的能力最不重要,熟悉具体业务场景反而更关键;并称当下语境里的 AI engineer 已与 AI 关系不大、不值钱,建议 AI 领域年轻人转向训练、量化、推理或 AI 基础设施建设。
匹配字段摘要
据 WSJ 报道,OpenAI 在安全人员发现 3 名安全研究员与一名外部安全研究员之间存在会消失的 Signal 聊天后,将这 3 人解雇。手机检查始于 9 月的一篇新闻报道,该报道称 OpenAI 最新模型 Astra 采用一种新方法,使其更聪明但写下的思考过程更少,人类能看到的推理过程因此减少。OpenAI 将该报道视为其秘密模型设计泄露,并开始追查信息来源,调查人员将曾协助 METR 分析 7 月 Hugging Face 被黑事件日志的 Ryan Greenblatt 列为疑似泄密者,他本人否认。
匹配字段摘要
DeepSeek将Harness与网页、App、开放平台团队整合为产品部,由崔添翼负责,官网已挂出AI产品经理和Agent Harness两个方向的招聘岗位。文章以OpenAI Codex负责人Tibo Sottiaux和Anthropic Claude Code团队为例,说明编程工具的执行能力如何被扩展为通用工作任务入口。DeepSeek一边开源Harness和推理框架DeepInfer,一边面对长任务带来的缓存与传输成本压力。
匹配字段摘要、正文
上海市经济和信息化委员会发布《上海市加快推动人工智能赋能工业服务业高质量发展行动方案(2027-2028年)》,提出到2028年工业服务业中人工智能应用普及率达到85%以上,力争培育10个数智原生的独角兽企业。方案围绕研发设计、供应链服务、柔性制造、嵌入式质检、预测性运维等环节给出最高500万至2000万元不等的资金支持,并明确攻关工业智能体任务规划与群体协同、端云协同推理与轻量化垂直小模型、行业高质量语料库等方向。
匹配字段摘要、正文
云托管平台 Railway 在 10 月 21 日发现存储客户环境变量的系统出现异常活动,称未经授权的第三方可能访问了加密的环境变量并解密了其中一部分,已建议所有用户更换 API key 等凭据。Railway 认为此次攻击可能是近期针对平台公司、意在入侵 AI 推理服务商的一系列攻击的一部分,并已通知上游供应商吊销可能泄露的密钥。公司还针对 OpenAI、Anthropic 和 GitHub 用户发布安全指南,建议删除可能暴露的 API key、生成新密钥并检查用量记录;10 月 23 日其构建与部署已恢复,但新用户注册仍暂停。
匹配字段摘要、正文
MiniMax于10月23日宣布开源M3.1 Flash模型,该模型上线72小时处理超过100万亿Token。相较上一代M3,M3.1 Flash能力全面提升,使用成本降低70%,线上推理速度提升近3倍。MiniMax称将携手华为昇腾、NVIDIA、AMD等芯片厂商及vLLM、SGLang、Hugging Face等推理框架与社区推进开源首日接入。
匹配字段摘要、正文
Fireworks AI 的媒体报道汇总页列出多条动态:其 CEO Lin Qiao 在播客中称公司每天处理 40 万亿 tokens,并称这一规模超过 OpenAI;另有报道称这家获 Nvidia 投资的公司估值达到 $17.5B。页面还收录了关于 AI 成本、智能体控制问题以及训练与推理区别的讨论。
匹配字段摘要、正文
OpenAI Codex 发布 0.164.0,新增十个编号 /presets 槽位用于保存可复用提示词和斜杠命令,并支持用内联 /model 和 /permissions 参数直接设置模型、推理强度、速度与权限配置。该版本还支持企业 MCP 连接认证、远程 Bash 与 Zsh 会话凭据掩码,并默认启用 Amazon Bedrock 设置向导。
匹配字段摘要、正文
MiniMax 宣布 M3.1 Flash 从推理到 RL 均已就绪,SGLang 与 Miles 在发布首日即提供支持。据 SGLang 介绍,该模型在 SGLang 上 bs1 decode 超过 1K tok/s,支持 NVIDIA Blackwell 与 Hopper(GB300/B300/B200/H200)以及 AMD Instinct MI350X 和 MI355X,并支持 MiniMax 的 DSpark 草稿模型与 HiCache、多模态输入。
匹配字段摘要、正文
MiniMax M3.1 Flash 权重已公开,总参数 428B,每 token 激活 23B。官方称其在智能体任务、编码和网络安全上大幅提升,BankerToolBench 76.2、DeepSWE v1.1 73.7%、OSWorld V2 61.7、Agents' Last Exam 29.6、CyberGym 82.2。模型采用 MiniMax Sparse Attention 与 DSpark 投机解码提升推理效率,权重已上线 Hugging Face 和 ModelScope,并提供 API 与 MCode 桌面端入口。
匹配字段摘要、正文
OpenAI 宣布全面开放基于 GPT-6 Luna 构建的决策 API(Decisions API),面向具有限定答案的问题,响应速度比通过 Responses API 调用 GPT-6 Luna 提升高达 10 倍。该 API 输入每百万 token 收费 0.10 美元,命中缓存的输入每百万 token 收费 0.01 美元,仅按输入 token 计费、输出 token 免费。公测以来新增原生 GPT-Live 集成、Prompt 缓存和美国及欧盟的推理数据驻留支持,单次请求最多可提交 400 个问题。
匹配字段摘要、正文
OpenAI 宣布全面开放决策 API(Decisions API),该 API 基于 GPT-6 Luna 构建,面向具有限定答案的问题,协助应用与智能体基于文本、图像及结构化输入做出准实时决策,响应速度比通过 Responses API 调用 GPT-6 Luna 提升高达 10 倍。定价上输入每百万 token 收费 0.1 美元,命中缓存的输入每百万 token 收费 0.01 美元,仅按输入 token 计费、输出 token 免费。自公测以来新增原生 GPT-Live 集成、Prompt 缓存和美国与欧盟的推理数据驻留支持,单次请求最多可提交 400 个问题。
匹配字段摘要、正文
OpenAI 于周四向所有客户开放 Decisions API,该产品在 9 月 29 日的开发者日上发布,基于 ChatGPT Luna 重新配置以加快推理并降低成本。OpenAI API 产品负责人 Nikunj Handa 称,延迟从 1 至 3 秒缩短到 100、120、180 毫秒,公开版本新增语音和视觉模态,并按地域部署推理资源以降低延迟。在 Box、Datadog、Ramp、Speak 的初期试用中,Speak 将操作间隔从 1.4 秒降至 0.13 秒;在 AIM System One Index 和 Artificial Analysis Decision Index 上,OpenAI 的决策模型分别排第八和第十四,落后于 Liquid 的 D1 Ultra 和 Base Lab 的 Elephant-1。
匹配字段摘要、正文
Satya Nadella 转发 Mustafa Suleyman 的帖子,介绍团队在 Science 发表的工作:MAI Diagnostic 系统在急诊场景下诊断准确率比医生高 1.7 倍,且成本更低、所需检查更少。Nadella 称该诊断编排器能推理复杂病例,在提高诊断准确率的同时降低检测成本。
匹配字段摘要、正文
Cerebras 用 59 片 WSE-3T 晶圆部署约 3 万亿参数的 Kimi K3,实现 1000-2000+ tokens/秒的推理速度。每片晶圆有 44 GB 片上内存,单层约 16 GB,因此 24 个稠密层各占一片、69 个线性注意力层每片放两层,层间只传激活值,约 2 微秒一跳。稠密层晶圆剩余空间用于 KV cache,决定并发请求上限。

匹配字段摘要、正文
微软公布其 AI 诊断工具 Diagnostic Orchestrator 的研究结果,该工具由多个 AI 智能体协作推理症状、决定检查项目并给出诊断,基于 OpenAI 的 GPT-5。在取自《新英格兰医学杂志》数百份病例报告的测试中,该系统诊断准确率约 83%,使用参考资料的全科医生约 36%,不使用的约 22%;在波士顿 Beth Israel Deaconess 医疗中心的急诊病例上准确率为 80%,人类医生平均 47%,且系统给出诊断的估算成本更低。微软将把自建基准 SDBench 开源,并计划未来几个月与 Beth Israel Deaconess 医疗中心在医院环境中开展测试,但该系统目前只在历史病例上验证过,仍需临床验证。
匹配字段摘要、正文
Aditya Agarwal 分享了 Sergey Levine 在 SPC 的对话:Levine 早年在改造的 Google 会议室里让一屋子机器人整日抓取物体,积累了大量经验却缺乏先验知识,这一瓶颈最终催生了 Physical Intelligence。对话涵盖 Pi Zero 机器人基础模型、从 Pi 0.5 到 Pi 0.7 的推理与泛化能力演进,以及机器人数据难题和世界模型。
匹配字段摘要、正文
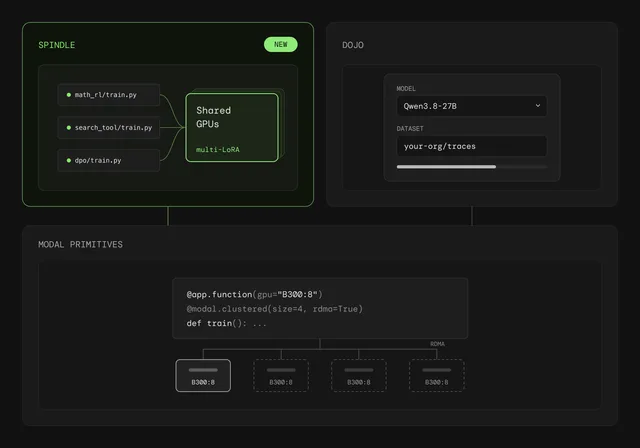
Modal 发布开源训练服务器 Spindle,可在自家 Modal workspace 中运行,兼容 Tinker API,按 GPU 时长而非 token 计费。部署只需执行 spindle deploy,支持全参数训练和多 LoRA,覆盖多种开源模型。官方给出的对比中,DAPO-math 单轮任务在 8 卡 H200 训练、8 卡 H200 推理、8 个客户端共享时价格为每百万输出 token 1.99 美元,较 Tinker 降低 80%。
匹配字段摘要、正文
Bardia Shahali 在 Fireworks AI 将销售团队从约 300 万美元做到约 4 亿美元,现任 Granola 销售副总裁,他指出 AI 基础设施层单笔交易可达数千万美元且两周即可成交,但所有推理提供商争夺同一批客户,竞争更激烈。由于模型能力每 45 天就达到新高度,薪酬计划已从年度改为按季度设定。基础设施层由 FDE、SE 与 AE 配对交付复杂产品,应用层则由 AE 与 CSM 交付软件,但生产力和采用速度更高。
匹配字段摘要、正文