Apple 手工刺绣产品发布,揭示 AI 内容泛滥时代的广告新策略
Apple 在 10 月 13 日“Welcome Home”产品发布中,用悉尼双胞胎姐妹 Maricor/Maricar 手工刺绣的 1977 彩虹 Apple 标志做宣传,并发布缝制过程视频。康奈尔大学营销教授 Stijn van Osselaer 指出,手工制作可能随时间成为奢侈品,人们喜欢人类制作的东西。研究显示,披露 AI 参与会带来惩罚效应,但生产方法与宣传信息需匹配。
匹配字段摘要
Apple 在 10 月 13 日“Welcome Home”产品发布中,用悉尼双胞胎姐妹 Maricor/Maricar 手工刺绣的 1977 彩虹 Apple 标志做宣传,并发布缝制过程视频。康奈尔大学营销教授 Stijn van Osselaer 指出,手工制作可能随时间成为奢侈品,人们喜欢人类制作的东西。研究显示,披露 AI 参与会带来惩罚效应,但生产方法与宣传信息需匹配。
匹配字段摘要
Google 正在让 AI Mode 和 AI Overviews 中的链接更显眼:内联链接会更频繁地出现在回答更靠前的位置,回答末尾的链接也将更醒目,Dive Deeper 板块加入图片缩略图并采用更易点击的设计。及时文章轮播和 Preferred Sources 将扩展到更多地区和语言,该定制功能使用量自推出以来增长 7 倍;Google 还在测试视频结果中可点击的创作者和发布者名称。
匹配字段摘要
NVIDIA 发布 Nemotron 3.5 Super VL,这是一个 120B 参数、每 token 激活 12B 的 MoE 开源视觉语言模型,支持文本、图像、文档和视频输入,上下文最高 1M tokens,权重以 OpenMDW-1.1 许可发布。NVIDIA 报告其在 GPQA-Diamond 得 89.90、SWE-bench Verified 得 71.07,但在 tau3-bench banking 仅 17.78。模型可在 1x DGX Spark、1x H200、2x H100 或 1x GB200 上运行 NVFP4 检查点,并已上线 Hugging Face、OpenRouter、ModelScope 和 NVIDIA NIM,同时发布面向本地智能体的 Nemotron 3.5 Bolt 74B-A9B。
匹配字段摘要
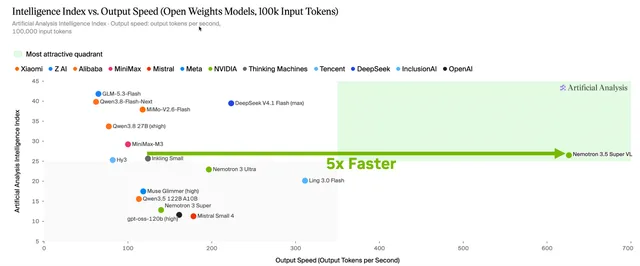
英伟达推出开放多模态模型 Nemotron 3.5 Super VL,采用 MoE 架构,总参数 1200 亿、激活参数 120 亿,面向持续运行的多步骤智能体任务。英伟达称其在单张 GPU 上执行智能体任务的吞吐量最高可达同规模其他开放模型的 5 倍,并将推理、指令遵循、工具调用与文本、图像、文档、视频理解整合在同一模型中。同期发布的还有 Nemotron 3.5 Bolt 74B-A9B 24GB 端侧模型,通过原生 2 位量化压缩至 24GB,支持 llama.cpp、vLLM、Ollama 等;Bolt E4B 4GB 计划于 10 月 23 日推出。
匹配字段摘要、正文
Meta 发布 Muse Spark Open 的模型权重,这是一个 816B 参数、推理时激活 42.7B 的开源权重全模态 MoE 模型,与 Muse Code 联合训练,面向编码智能体工作流,支持 1M token 上下文和文本、图像、视频、音频输入。它采用压缩 MoE 块和全局/局部混合注意力,在 128K 上下文下把 KV cache 内存降低约 3.7 倍。Baseten 已在其 Model APIs 和 Dedicated Inference 上以 NVFP4 提供该模型,权重体积从约 1.6 TB 降至 540 GB,可运行在单台 4×GB300 节点上。

匹配字段摘要
Nvidia 发布 Nemotron 3.5 Super VL,这是一个 1200 亿参数的开源多模态模型,面向持续在后台运行的企业智能体,处理文本、图像、文档和视频。该模型采用 MoE 架构,每个 token 仅激活 120 亿参数,由 Nvidia 与包含 Mistral AI、Thinking Machines Lab、Perplexity 和 Black Forest Labs 的 Nemotron Coalition 共同开发。同时推出两款面向本地硬件的模型:Nemotron 3.5 Bolt 74B-A9B 24GB 可在本地机器运行智能体任务,更小的 Bolt E4B 4GB 面向语音助手,将于本月晚些时候发布。Nvidia 称 Super VL 从 Nemotron 3 Ultra 蒸馏而来,在智能体指令遵循、工具调用、多步业务流程和图像分析任务上以约五分之一参数达到 Ultra 的准确率,在 Hermes 和 LangChain 的智能体测试中得分高于 Ultra,并在 SWE-bench 和 Terminal-Bench 上超过前代 Nemotron 3 Super。权重以 base、post-trained 和 4-bit 压缩三个版本发布,同时公开数据集、训练配方和强化学习环境,预训练与持续预训练使用超过 25 万亿 token。
Nvidia 发布 Nemotron 3.5 Super VL,这是一个 1200 亿参数的开源多模态模型,面向持续在后台运行的企业智能体,处理文本、图像、文档和视频。该模型采用 MoE 架构,每个 token 仅激活 120 亿参数,由 Nvidia 与包含 Mistral AI、Thinking Machines Lab、Perplexity 和 Black Forest Labs 的 Nemotron Coalition 共同开发。同时推出两款面向本地硬件的模型:Nemotron 3.5 Bolt 74B-A9B 24GB 可在本地机器运行智能体任务,更小的 Bolt E4B 4GB 面向语音助手,将于本月晚些时候发布。Nvidia 称 Super VL 从 Nemotron 3 Ultra 蒸馏而来,在智能体指令遵循、工具调用、多步业务流程和图像分析任务上以约五分之一参数达到 Ultra 的准确率,在 Hermes 和 LangChain 的智能体测试中得分高于 Ultra,并在 SWE-bench 和 Terminal-Bench 上超过前代 Nemotron 3 Super
匹配字段摘要
Meta 发布开源权重模型 Muse Spark Open,称其为美国最强的开源权重模型,面向编码与智能体任务,拥有 8160 亿参数(激活 420 亿)、最高 100 万 token 上下文,支持文本、图像、视频和音频。Meta 称其在 JobBench、MCP-Atlas、HLE-Diamond、ZeroBench 等基准上多个类别领先 Qwen 3.8、GLM 5.3 和 Kimi K3,但仍明显落后于 Meta 付费的 Muse Wonder Full 模型。该模型针对 Apple M5 Ultra 优化,可在两台各配 512 GB 统一内存的 Mac Studio 上本地运行,权重已发布在 Hugging Face;许可免费使用但需标注 Built with Muse Spark Open,年收入超过 2000 万美元且想以 API 形式提供该模型的服务商需与 Meta 另行签约。
匹配字段摘要
Meta 发布编码优化的 816B MoE 模型 Muse Spark Open,每 token 激活 42B 参数,通过 256 个专家中 top-8 路由,支持 1M token 上下文窗口。该模型在 NVIDIA GB300 NVL72 Blackwell Ultra 上训练,面向智能体编码工作流,具备工具调用、子智能体协调与计算机使用能力,并通过 1.8B 感知编码器原生处理交错的文本、图像、视频帧和音频。Meta 生成的 NVFP4 检查点已针对 Blackwell Ultra 优化,权重可从 Hugging Face 下载,NVIDIA 同时提供 NIM 部署方案。

匹配字段摘要
NVIDIA 发布 Nemotron 3.5 Super VL,这是一个开放可定制的多模态模型,采用 120B 参数 MoE 架构,每个 token 激活 12B 参数,面向智能体工作流。该模型在单 GPU 上处理智能体任务的吞吐量最高可达同尺寸其他开放模型的 5 倍,并统一支持推理、指令遵循、工具调用以及文本、图像、文档和视频理解。Scale AI、Ramp、AI21 等机构已对其做后训练,实现最高 40 倍推理成本下降、10 倍延迟下降和 40% 准确率提升,开发者可用 NVIDIA NeMo 进行 SFT、LoRA 和强化学习定制。

匹配字段摘要
9月29日,中国互联网络信息中心政策与国际合作所在2026(第七届)中国互联网基础资源大会上发布《生成式人工智能应用发展报告(2026)》。报告显示,截至2026年上半年,我国生成式人工智能用户规模突破7亿人,普及率超50%。76%的用户表示会让生成式人工智能回答问题,使用其处理图片/视频、文本、工作总结/会议纪要/PPT的用户占比分别为47.8%、37.6%和32.5%;AI综合助手、AI效率办公等应用的使用次数同比增长均超过100%。
匹配字段摘要、正文
Meta 发布开源权重模型 Muse Spark Open,称其为美国最强开源权重模型,采用 8160 亿参数和 100 万 token 上下文窗口,原生多模态,面向复杂编码任务和智能体工作。该模型可本地运行在 Apple 电脑上,但至少需要 1TB 内存,在搭载 M5 Ultra 芯片的 Mac Studio 上运行效果最佳。Meta 将其与 AI 编码终端 Muse Code 配合,用于 Mastodon 客户端的 bug 修复、新功能和完整构建,以及 DaVinci Resolve 的视频素材审阅与裁剪,目前该模型已通过多个 API 平台开放。
匹配字段摘要
Meta 发布开源权重前沿多模态 MoE 模型 Muse Spark Open,总参数 816B,每个 token 激活约 42B 参数,面向编码与智能体任务,支持文本、图像、视频和音频输入,上下文窗口 1M token。模型提供 BF16 与 NVFP4 两种 checkpoint,NVFP4 面向 NVIDIA Blackwell GPU,并已集成 transformers、llama.cpp、vLLM、SGLang 和 MLX,官方还给出在 64 张 H100 上用 TRL 训练 LoRA 适配器的微调配方。
匹配字段摘要
NVIDIA 开源多模态模型 Nemotron 3.5 Super VL 已在 Baseten 上线,这是一个 120B-A12B 的 MoE 模型,面向文本、图像和视频的智能体工作流。它基于 Nemotron 3 Super 架构加入视觉编码器,采用混合 Mamba-Transformer 架构与多 token 预测(MTP),并支持 NVFP4 KV cache 量化以降低长上下文推理显存。NVIDIA 报告称其在 GDPval 上 Elo 为 1190(Nemotron 3 Super 为 493),SciCode 与 GPQA-diamond 也更高;Baseten Loops 在发布当天提供监督微调和强化学习训练支持。

匹配字段摘要
ElevenLabs 在 ElevenCreative 上线 Instant Soundtracks,上传视频后模型会生成原创配乐,并分析画面中的音效触发点,把音效按时间戳自动放到时间线上。该更新还改善了短视频的卡点精度和跨场景情绪切换,并支持以视频原有音频作为参考来塑造新配乐。功能已在 ElevenCreative、ElevenMusic 和 API 开放,API 新增 add_sfx、separate_tracks、use_audio_as_reference 参数,单次请求最多支持 10 个视频、合计 200 MB 和 10 分钟。

ElevenLabs 在 ElevenCreative 上线 Instant Soundtracks,上传视频后模型会生成原创配乐,并分析画面中的音效触发点,把音效按时间戳自动放到时间线上。该更新还改善了短视频的卡点精度和跨场景情绪切换,并支持以视频原有音频作为参考来塑造新配乐。功能已在 ElevenCreative、ElevenMusic 和 API 开放,API 新增 add sfx、separate tracks、use audio as reference 参数,单次请求最多支持 10 个视频、合计 200 MB 和 10 分钟。
匹配字段摘要
Meta 的开源权重智能体编码模型 Muse Spark Open 已在 Together AI 上线,支持 1M token 上下文窗口,可通过 serverless 和专用基础设施调用。Together AI 称其为目前能力最强的美国开源权重模型,面向长时间运行的智能体编码工作流,具备长程自主、computer use 与浏览、文本图像音频视频多模态输入等能力。定价为每 1M 输入 token 1.25 美元、每 1M 输出 token 4.25 美元、每 1M 缓存输入 token 0.15 美元,模型标识为 meta-models/Muse-Spark-Open-816B-A42B。
匹配字段摘要
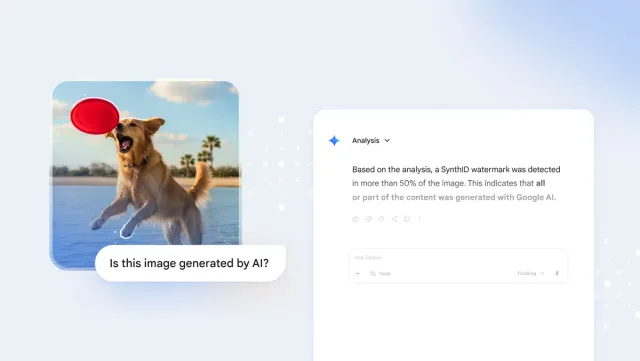
Google SynthID 被 TIME 评为 2026 年度最佳发明之一。该技术可在 AI 生成图像、音频、视频和文本创建时嵌入不可见且持久的数字水印,且不改变内容质量,目前已为超过 1800 亿张图像和视频、24 万年时长的音频添加水印。Google 还在 Search、Gemini 应用和 Chrome 中内置验证工具,并推出 SynthID Detector 供用户核查内容。
匹配字段摘要
The Verge 报道称,一个拥有百万粉丝、带蓝色认证的 Instagram 粉丝账号发布 AI 生成的 Mia Goth 图片,获近 50 万点赞并进入娱乐媒体与 Google 搜索的 AI 概览,Instagram 最终以冒充公众人物为由删除该账号。Meta 允许用户购买蓝色认证,且静态图片不受 AI 标注要求约束;在 The Verge 询问八个发布名人深伪内容的账号后,Meta 移除了部分账号。报道还提到 YouTube 的 likeness detection 已覆盖所有成年用户,2026 年上半年通过该项目举报的视频中超过 95% 被移除。
匹配字段摘要
MIT Tech Review 盘点了六条试图让心智在死亡后延续的路径,包括头部移植、把个人数据上传生成数字分身等。意大利外科医生 Sergio Canavero 主张人类换头可行,并引用其团队在 PLOS One 上让三只断脊髓猪重新站立行走的论文;瑞士神经科学家 Grégoire Courtine 则称这类想法应“零关注”。StoryFile、Afterlife AI、Synthesia 等服务已能让用户生成分享记忆的对话机器人或逼真视频分身。
匹配字段摘要
NVIDIA 发布开源多模态模型 Nemotron 3.5 Super VL,支持文本、图像、文档和视频输入并输出文本,采用 120B 总参数、每 token 激活 12B 的 MoE 架构。SGLang 提供 Day-0 支持,通过连续批处理、前缀缓存和投机解码部署,在单张 RTX 6000 PRO 上借助 MTP 达到 243.9 tok/s。模型权重已在 Hugging Face 提供 BF16 和 NVFP4 两个版本。
匹配字段摘要
LMSYS 发布博客称,SGLang 与 Miles 为 Meta 开源多模态 MoE 模型 Muse Spark Open 提供 Day-0 支持。该模型采用 816B 参数文本 Transformer 主干、每 token 约 42B 激活参数,支持文本、图像、视频和音频输入以及 1M token 上下文窗口,checkpoint 提供 NVFP4 与 BF16 版本。在 8 张 NVIDIA B300 GPU 上以 NVFP4 checkpoint 跑 OpenHands 多轮智能体编码回放,并发 1 时单 GPU 吞吐 14.8K tokens/sec、单用户 543 tokens/sec(p50),并发 128 时为 80.3K tokens/sec、单用户 61 tokens/sec(p50)。支持平台包括 NVIDIA Blackwell(GB300、B300、GB200、B200)、H200、AMD MI350X 与 MI355X,以及 Intel Xeon 6 P-core,并首次通过 SGLang-TorchTPU 为开源权重模型提供 Day-0 TPU 支持。

匹配字段摘要