←搜索结果

按匹配度 · 共 1587 条结果 清除搜索

星期一

  1. TechCrunch AI

    Anthropic 发布 Sonnet 5.5,称更快更便宜的工作助手

    Anthropic 发布中端模型 Sonnet 5.5,称其速度比上一代 Sonnet 5 快 30%,token 消耗速度也明显更慢,定位为适合编码和办公文档等日常任务的助手。Anthropic 的基准测试显示,Sonnet 5.5 在智能体编码上表现优于 Opus 5.5,原因可能是它能在不超成本上限的情况下派生多个智能体。Anthropic 还称 Sonnet 5.5 的网络能力与 Opus 5 相当,因此成为首个适用与 Fable、Opus 相同网络安全防护措施的 Sonnet 模型,并计划在未来几周发布新版 Haiku。

    匹配字段摘要
星期日

  1. METR Notes

    METR 部署基础逐动作监控器以降低评估中智能体造成现实危害的风险

    METR 开发并部署了一个基础实时逐动作监控器,由 LLM judge 在执行前审查智能体的每个动作,超过阈值即暂停评估并转人工复核,目标是可靠检测可能造成现实危害或试图规避监控的行为。METR 在梳理有效性论证时发现多项严重问题:有研究员因误解标准未启用监控就运行了高风险评估,编码智能体可能自行打开人工复核面板并发送按键,监控无法抵御伪造用户轮次等手动红队攻击,早期 Inspect 版本中子智能体的动作不会展示给监控器。

    匹配字段摘要

  2. 量子位

    酉术量子发布 UnitarySpark 与 UnitaryLab 2.5,桌面端跑通量子计算

    酉术量子全球首发异构计算硬件底座 UnitarySpark,并上线自然语言驱动的量子科学计算平台 UnitaryLab 2.5 公测版,把量子模拟、GPU 加速、AI Agent 交互和真机互联集成到一台本地工作站,数据全程不出本地。其底层是上海交大团队的“薛定谔化”算法框架,可将非酉微分方程转为酉演化形式;基于 NVIDIA DGX Spark 的实践入选 NVIDIA 官网成功案例,手动编码约 12 步压缩为约 3 句自然语言描述,交互频次减少约 75%。

    匹配字段摘要、正文

  3. Yuchen Jin

    Yuchen Jin:Opus 5.5 仍不及 Astra

    大家都说 Opus 5.5 疯了。最强模型。巨大飞跃。等等等等。 我仍然不觉得它比 Astra 更好。 在 Opus 4.8 之后,前沿 LLM 的编码能力已经停滞。

    大家都说 Opus 5.5 疯了。最强模型。巨大飞跃。等等等等。 我仍然不觉得它比 Astra 更好。 在 Opus 4.8 之后,前沿 LLM 的编码能力已经停滞。

    匹配字段摘要

  4. Gary Marcus:The Road to AI We Can Trust

    Gary Marcus:AI 智能体事故数量已升至数万起

    Gary Marcus 引用 Axios 记者 Madison Mills 的报道称,AI 智能体相关事故数量至少已达数万起,涉及的不只是 OpenAI,也不只是 Hugging Face 和一家德国网站。他指出多数事故尚未造成现实危害,并称美国政府未展开调查、未发表声明、也未召回产品。他回顾自己此前关于 LLM 与编码智能体安全风险的多次预警,主张在问题理清前对通用智能体实施临时召回。

    匹配字段摘要

星期六

  1. TechCrunch AI

    两名密码分析者用 OpenAI Astra 与 Claude Opus 5 破解未解 Enigma 密文

    两名密码分析者称,他们用 OpenAI 和 Anthropic 的 LLM 破解了两条长期未解的 Enigma 密文。开发者 Carter Leffen 让 OpenAI 最新模型 Astra 检索 Enigma 密文数据库并解码,Astra 自行做档案研究、寻找线索、搭建 Enigma 模拟器,最终还原出一条自 2005 年起无人解出的明文;退休电气工程师 Frode Weierud 上周验证了这一结果。9 月 21 日,网络安全高管 Jack Willis 称他用 Anthropic 的 Claude Opus 5 破解了另一条未解密文,他给模型的引导明显更多,模型最终借助某位军官姓名的已知签名完成破解。Weierud 表示目前仅剩七条未解 Enigma 密文,另有一条明文已知但编码仍未破解。

    匹配字段摘要

  2. TechCrunch AI

    保险公司称 AI 已在推高医疗成本

    Blue Cross Blue Shield Association 的分析显示,医院在提交保险理赔时使用 AI 工具,两年间导致医疗支出增加 9.42 亿美元。该分析发现被记录为患有复杂疾病的患者数量急剧上升,但认为医疗编码与治疗之间存在明显脱节,没有证据表明实际提供的护理有相应变化。纽约时报称这是 AI 推高医疗成本的最新迹象,AI 创业公司 Abridge 创始人 Shiv Rao 承认 AI 可能带来智能体互斗的局面,但也可能降低成本。

    匹配字段摘要

星期五

  1. Sarvam AI Blog

    Sarvam AI 发布 Saaras V4 语音识别模型

    Sarvam AI 发布新一代语音识别模型 Saaras V4,采用音频编码器加 3B 混合状态空间 LLM 解码器,解码器完全自研从零训练。该模型在全部 22 种印度语言上达到 SOTA,并在七个全球英语数据集上取得最低 WER;支持 transcribe、translate、verbatim、translit、codemix 五种转写格式,语言识别错误率在十大印度语言为 2.9%、全部 22 种为 5.22%。

    匹配字段摘要

星期四

  1. LangChain Blog

    LangSmith 上线 Trajectories:按时间顺序查看智能体会话

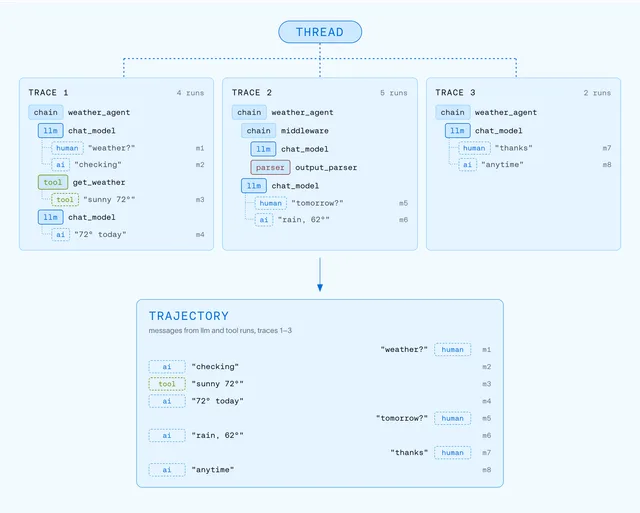
    LangChain 在 LangSmith 中推出 Trajectories,把一次智能体会话中人类、AI 与工具的消息按首次出现顺序聚合展示,去掉嵌套 run 结构,便于定位智能体行为偏离的环节。该功能开箱支持 LangChain、LangGraph、Deep Agents、OpenAI 与 Claude 的 agent SDK,以及 Codex、Claude Code、Cursor 等编码智能体,并可用在线评测器对 trajectory 打分、送入标注队列或数据集,导出用于监督微调。Trajectories 现已在美国所有套餐中可用。

    LangSmith Trajectories thread

    匹配字段摘要

  2. AI at Meta

    Meta 发布 Muse Realtime Voice 与 Muse Realtime Avatar 统一流式架构

    Meta 发布 Muse Realtime Voice 与 Muse Realtime Avatar,二者通过共享语音 token 流组成统一流式架构,前者生成编码内容与韵律的语音 token,后者消费同一流并生成流式视频。系统以固定长度历史作为后续分块的动作上下文,在任意对话长度下保持有界计算,同时生成同步的语音、唇动与表情。团队将带 3-way CFG、每段视频需 120 次评估的 40 步扩散教师模型蒸馏为无引导的 2 步因果学生模型,配合固定长度 KV cache 与 self-forcing,以少 60 倍的评估次数接近教师质量;在自家实时通话产品中与两个商用化身系统对比,Muse Realtime Avatar 在整体偏好上领先。

    匹配字段摘要

  3. NVIDIA Developer · Generative AI

    NVIDIA 发布 NV-Reason-CT 开源 3D CT 视觉语言模型

    NVIDIA 发布 NV-Reason-CT,一个面向 3D CT 分析的视觉语言模型,将思维链推理扩展到全容积 CT,可生成结构化诊断报告并支持多轮追问。模型由 3D ViT 编码器与 Qwen3.5-4B 语言模型组成,在 CT-RATE 基准上取得 Macro-F1 0.614、Macro-AUROC 0.871,超过已发表的 3D 对比学习与 2D/3D 融合基线。权重和配置已在 Hugging Face 开放,训练配方与推理脚本发布在 NVIDIA-Medtech/NV-Reason-CT 仓库,定位为供研究者后训练的研究基础模型,而非获批的临床诊断产品。

    匹配字段摘要

星期三

  1. AIhub

    IJCAI-ECAI 2026 教程与研讨会回顾(上)

    IJCAI-ECAI 2026 的教程与研讨会回顾中,一场教程聚焦图像与表格场景下的缺失数据填补,涵盖从统计基线到自编码器与生成对抗网络的方法;另一场 SAFER 研讨会于 8 月 16 日在德国不来梅举行,数十名研究者共同制定可信智能体 AI 路线图,提出安全、可靠、主权三条推进主线,相关扩展论文与章节计划于 2027 年出版。

    匹配字段摘要、正文

  2. gihyo.jp

    OpenAI 发布 GPT-6 Sol 与 GPT-6 Luna,API 单价较 GPT-5.6 版大幅下调

    OpenAI 于 9 月 22 日发布 GPT-6 系列新模型 GPT-6 Sol 和 GPT-6 Luna,分别面向复杂编码与 AI 智能体作业、大批量处理场景。API 标准单价为每 100 万 token:Sol 输入 2 美元、输出 10 美元,Luna 输入 0.10 美元、输出 0.50 美元,相比对应的 GPT-5.6 版促销价,Sol 输入输出均半价,Luna 输入半价、输出降价约 58%。两款模型上下文长度最大 105 万 token、最大输出 12.8 万 token,将在 ChatGPT Work、Codex 和 API 中提供,Free 与 Go 用户可在桌面应用试用 Luna。

    匹配字段摘要

星期二

  1. Ben's Bites

    用 Jev 能构建什么:Ben's Bites 盘点

    Jev 现已向所有人开放,它不同于常规 LLM,面向构建者、设计为在工具内部使用,可回答“这是广告吗”“该归入哪个文件夹”“相关度多少”这类问题。人们已用它做 YouTube 赞助片段跳过、实时过滤负面评论、按意图搜索 Gmail、语音控制 Mac 等。作者也提醒,把 Jev 接入编码智能体做即时压缩并不划算,会损失 prompt caching 的成本节省。

    匹配字段摘要

  2. NVIDIA Developer · Generative AI

    NVIDIA Isaac ROS 5.0 如何用 AI 智能体加速 ROS 2 节点

    NVIDIA 在 ROS Lyrical 中贡献的 rosidl::Buffer 与 CUDA buffer backend 让 ROS 2 节点在运行时条件允许时以零拷贝方式交换 GPU 常驻数据,同时保留标准 ROS 2 消息与节点边界,Isaac ROS 5.0 的全部节点已改用该 CUDA buffer backend。文章以 Depth Anything 3 TensorRT ROS 2 节点为迁移示例,由 AI 编码智能体借助 migrate-node-to-rosidl-buffer 技能完成审计、最小化接口保持重构,并用 NVIDIA Nsight Systems 验证 ROS 边界不再出现负载大小的主机-设备传输。

    匹配字段摘要、正文

  3. Kimi.ai

    Kimi K3 现已上线 Amazon Bedrock

    Kimi K3 现已上线 Amazon Bedrock! 借助 Bedrock 的访问、加密和审计控制,运行编码、文档分析和扩展智能体工作流。支持显式 prompt caching。 在 AWS 上开始用 K3 构建 👉 https://t.co/vm32dU0TN1 https://t.co/GxEGrgFAwL

    Kimi K3 现已上线 Amazon Bedrock! 借助 Bedrock 的访问、加密和审计控制,运行编码、文档分析和扩展智能体工作流。支持显式 prompt caching。 在 AWS 上开始用 K3 构建 👉 https://t.co/vm32dU0TN1 https://t.co/GxEGrgFAwL

    匹配字段摘要

  4. gihyo.jp

    小米开源多模态模型 MiMo-V2.6 Pro/Flash

    小米于9月21日发布 MiMo-V2.6 系列的 Pro 和 Flash 并公开模型权重,两者均为可处理文本、图像、视频和音频的多模态模型,通过扩大强化学习规模提升编码、PC 操作、3D 空间推理和内容制作等智能体能力。小米称 Pro 在多数智能体基准上达到 Claude Opus 5 和 GPT-5.6 Sol 的水平,在 Artificial Analysis Intelligence Index 上得分 46,为发布时开源模型最高,但与 Claude Fable 5.1、GPT-6 Astra 等顶级闭源模型仍有差距。权重和技术报告已在 Hugging Face 的 MiMo-V2.6 集合发布,同时公开 7000 多个强化学习任务环境、训练框架、轻量智能体运行基座 mini-harnesses,以及基于 Qwen3.5-9B 蒸馏的 MiMo-V2.6-Distill-Qwen-9B。

    匹配字段摘要

  5. TechCrunch AI精选

    Anthropic 发布 Opus 5.5,价格更低并称达到 Fable 级性能

    Anthropic 于周二发布新模型 Opus 5.5,称其在编码和知识工作上创下新的 SOTA,并在多项基准上超过更大的 Fable 模型。Opus 5.5 输出价格为每百万 token 20 美元,低于上一代的 25 美元,运行速度也更快,同时减少了术语使用并把重要信息放在消息开头。该模型在生物学和网络安全能力上与 Mythos 相当,因此沿用 Fable 同款安全限制;Sonnet 5.5 和 Haiku 5.5 将在未来几周发布。

    匹配字段摘要

星期一

  1. Fireworks AI

    Fireworks AI:前沿不在单个模型,而在路由器

    Fireworks AI 在 DeepSWE v1.1 的 113 个任务上测试 18 个模型,发现按任务挑选最优模型可达 97.6% 通过率、每任务成本 1.88 美元,而最好的单模型 GPT-6 Astra 为 74.1%、每任务 6.52 美元。仅限开源权重模型时,路由仍达 90.3%、每任务 1.45 美元。作者指出该数字来自事后挑选的 oracle 路由,真实路由器必须在看到结果前做选择;其 FireRouter 在四周 2334 个生产编码会话中把成本从 Opus 5 单模型的 15.81 美元降到 7.42 美元。

    匹配字段摘要