←搜索结果

按匹配度 · 共 783 条结果 清除搜索

星期四

  1. 智东西

    汤道生预告混元Hy4正式版将首次加入视觉理解

    腾讯集团高级执行副总裁汤道生在2026腾讯全球数字生态大会上宣布,混元大模型Hy4正式版即将发布,相比8月28日开源的Hy4 Preview全面提升,强化长程任务与真实生产力任务能力,显著提升思维链效率,并首次加入视觉理解;主打性价比的Hy4 Flash也将在近期推出。腾讯同时发布跨应用AI协同体系Buddy One和面向Agent时代的腾讯网盘,并升级Agent Runtime,围绕上下文管理、工具调用、安全沙箱、可观测与评测做系统性增强。汤道生还披露,过去一年腾讯云海外活跃客户数量增长约3倍,海外AI需求实现三位数增长。

    将会进入人机共创的新范式:团队讨论完把需求提交给AI,内容由大模型生成,由Agent来整合,团队来验收,然后沉淀到知识库。 今天,借生态大会的机会,我们也正式对外发布Buddy One。 Buddy One以WorkBuddy为工作台,无缝整合腾讯文档、腾讯乐享、腾讯设计等不同工具,通过统一账号、统一积分池、统一数据池,大模型针对不同需求,调用不同工具来生成多模态内容。团队可以在项目中协同修改,共同检验产出物,持续讨论与迭代。Buddy One实现人和AI共同创作,围绕任务协同,而不是围绕文件流转。当然,还要支持好多终端的联动,云与端的Agent无缝切换。 这样的“一体化体验”,需要多个产品共同支撑。腾讯文档负责内容编辑,腾讯乐享提供知识管理,腾讯会议把开会的共识融入代办中,皆为WorkBuddy提供了上下文。 当任务需要补充外部信息时,元宝搜索也会提供实时数据。依托国内外的权威网站、专业的数据资源、腾讯独有的内容生态,如腾讯医典等,元宝搜索沉淀了千亿级的索引,满足各类深度调研的需求。元宝既作为ChatBot给用户提供快而准的答案,也通过API向行业提供搜索能力。 今天,我们也将正式发

    匹配字段正文
  2. heise online精选

    Google 发布 Gemini 4 Carbon,接替 Argon 并主打漏洞利用能力

    Google 发布新模型 Gemini 4 Carbon,取代四周前推出的 Argon,初期仅向美国情报机构及经 Fairwind 计划选定的网络防御方开放。Google 称 Carbon 在 Exploitgym 基准上从 Argon 的 42% 提升到近 55%,在 SEC-bench Pro 上以约 88% 领先 GPT-6 Astra,在 CWE-bench 上达到 71%。定价为每百万输入 token 4 美元、每百万输出 token 20 美元,初期有五折优惠,公开可用时间仅称“很快”。

    与 Argon 相比,最大的进步显然在于开发针对软件的新型攻击。Argon 在 Exploitgym 基准测试中仍达到 42%,略落后于 GPT-6 Astra,而 Carbon 则跃升至近 55%。在 SEC-bench Pro 基准测试中,Gemini 4 Carbon 也以约 88% 领先于 GPT-6 Astra。在修复安全漏洞方面,Carbon 声称以 CWE-bench 的 71% 领先于谷歌所参照的竞争对手语言模型。 此外,该集团还报告称,Carbon 是更好的 AI 智能体,适合需要长时间计算的困难编程任务。公告中写道:“在内部,我们的团队观察到 Carbon 连续运行数天。”此外,该 LLM 在科学任务、Web 开发以及理解多模态提示方面应能取得更好的结果,并能输出缺陷更少的软件代码。 使用 Gemini 4 Carbon 的费用为每百万输入 token 4 美元,每百万输出 token 20 美元。初期有 50% 的 introductory 折扣。谷歌没有说明 Carbon 何时公开可用。据说“很快”就会实现。Argon 当时只用了两周。 广告后继续阅读 (ds)

    匹配字段正文

  3. Analytics India Magazine

    Articul8 推出决策模型 Bivia,帮企业 AI 智能体做结构化决策

    Articul8 发布决策模型 Bivia,通过 API 供企业 AI 智能体在文本、图像、文档等格式上做结构化决策,支持 Choice、Boolean、Score、Set、Span 五种决策类型。它可针对企业数据、行业知识与历史决策做专门化,并提供 Fast、Fast+think、Deep 三种运行模式,证据不足时可选择弃答。Articul8 内部评测称,经领域训练后 Bivia 在部分能源与硬件设计任务上接近满分,并在内部评测中完成约 70% 的工作流,对比方案约为 30%。

    位支持性证据。 Bivia 可分析文本、图像、文档、工程图纸、表格、图表、音频和视频。它可以识别相关的图像区域、文本段落和视频时间戳,从而将其决策建立在源证据之上。该模型还支持多语言应用,包括印地语、古吉拉特语、泰米尔语和梵语。 Articul8 提供三种运行模式:Fast 用于快速决策,Fast+think 用于需要额外计算的决策,Deep 用于需要进一步验证的决策。当可用证据不足以支持可靠决策时,Bivia 还可以选择弃答,而不是返回没有支持的答案。 在内部评估中,Articul8 报告称,经过领域特定训练后,Bivia 在选定的能源和硬件设计任务上达到了接近完美的准确率。该公司还报告称,在内部评估中,Bivia 完成了约 70% 的工作流,而作为对比的评估方案约为 30%。 该公司通过在一次请求中处理一部在国际空间站拍摄的 52 分钟 4K 纪录片的每一帧,展示了 Bivia 的多模态能力。Bivia 通过 API 作为独立产品提供,也可作为 Articul8 企业 AI 平台的一部分提供,旨在与生成式模型协同工作,在整个工作流中处理决策,而由这些模型负责写作、解释和规划等任务。

    匹配字段正文

  4. Analytics India Magazine

    印度企业加速部署 AI 智能体,现有基础设施能否支撑?

    Dell Technologies 与 Vanson Bourne 的 Modern Enterprise Readiness Study 显示,67% 的印度组织认为其现有数据中心环境尚不具备在生产规模上支撑 AI 工作负载的能力。Tesco Technology 工程总监 Vishal Kappanna 指出,AI 智能体从试点走向生产的最大障碍往往不是模型本身,而是与碎片化企业数据、遗留应用、安全控制和业务流程的集成。NetApp 印度及 SAARC 地区董事总经理 Premalakshmi PR 也认为,最大挑战常在于数据而非模型,数据分散在本地、云端和边缘环境中。

    发起行动的软件,”戴尔科技印度基础设施解决方案集团高级总监兼国家负责人Venkat Sitaram表示。 戴尔的客户部署案例展示了组织如何应对不同的基础设施需求。Lakshmikumaran & Sridharan Attorneys正利用戴尔AI Factory在本地运行内部AI助手,从而保持对其专有知识和客户数据的控制。Zoho正借助该平台开发隐私优先的多模态企业级和智能体AI能力。Omega Healthcare已通过戴尔私有云实现基础设施现代化,同时继续支持现有系统。 这些案例反映了不同的优先事项,从保持对敏感信息的控制,到开发AI能力,再到维持现有运营。它们也表明,基础设施就绪并非一次性的升级。它取决于组织需要支撑的工作负载、已经运行的系统,以及这些组件之间协同工作的有效程度。 现代化成为决定性因素 对印度企业而言,将AI智能体投入生产,部分取决于它们能在多大程度上依托现有的数字化投资。已经建立API平台和现代集成架构的组织可能具有先发优势。其他组织则可能需要提升数据质量、通过安全接口连接较旧的应用,或加强支撑其工作负载的基础设施。 任务未必是替换每一个遗留系统,而是找出既有

    匹配字段正文

  5. 半导体产业纵横

    英特尔与腾讯云发布基于至强6+的新一代云实例,加速智能体AI落地

    英特尔与腾讯云在2026腾讯全球数字生态大会上发布基于英特尔至强6+处理器的新一代云实例,综合性能较上一代提升30%以上。至强6+最高288颗能效核,单颗处理器最高可支持超过1000个智能体的稳定部署,并引入英特尔TDX实现硬件级隔离。双方还借助IAA将2M页解压时延拉进微秒级、平均耗时加速16倍,CubeSandbox单机可支持350个沙箱并发创建请求。

    至强的演进并未止步于此。面向下一阶段更高密度的任务调度与并发计算,英特尔将推出专为下一代智能体AI基础设施设计的至强处理器(代号Diamond Rapids),实现多任务高负载的吞吐飞跃。 智能体AI要走向规模化,每一环节都要经得住高密度、高并发的考验。比如,有限的内存要承载更多任务,KV Cache要在不同层级间高效流动、压缩与调度,沙箱要安全且快速拉起,多模态数据还要被高效处理。面对这些贯穿计算、存储与执行链路的新要求,英特尔将至强处理器强大的计算能力、内置硬件加速和软件优化结合起来,与腾讯云共同打通智能体AI运行的关键链路。 腾讯全球数字生态大会英特尔展台 智能体AI越深入真实业务,内存就越显珍贵。高并发和持续运行不断推高内存需求,客户既希望用有限的内存承载更多任务,又不能以牺牲时延、拉高成本为代价。如何在高密度、高并发的业务场景下,同时满足对密度和时延的双重需求,这是软件方案解决不了的问题,也是腾讯云与英特尔推进内存应用创新的出发点。 借助英特尔至强处理器内置的英特尔® IAA(内存分析加速器),腾讯云对内存解决方案进行创新,为内存压缩和解压缩引入了硬件加速,满足客户对解压时延

    匹配字段正文

  6. The Decoder精选

    Google DeepMind 发布 Gemini 4 Carbon,距 Argon 仅两周

    Google DeepMind 在 Argon 发布两周后推出 Gemini 4 Carbon,该模型在 Artificial Analysis Intelligence Index v5.0 上得分 59,高于 Argon 的 50,位列第一。Carbon 面向长周期工程任务设计,在 WebDev Arena 升至 1769 分、排名第四,在 Gray Swan 间接提示注入基准上把攻击成功率从 0.7% 降至 0.0%。模型先向部分网络安全专家开放,定价为每百万输入 token 2 美元、每百万输出 token 10 美元,与 Argon 的 introductory 价格一致。

    程会话而打造 Google Deepmind 表示,Carbon 是为“困难得多、长周期的工程问题”而设计的,这类问题需要持续性的智能体工作流。Google 称,内部团队曾让该模型连续运行数天,在此期间它能够自行走出死胡同,并处理复杂、多步骤的任务,例如大型代码库和底层软件中的根因分析和细微缺陷修复。 Google 还报告称,基于用户反馈,该模型在科学推理、多模态理解和全栈 Web 开发方面有所改进。Web 开发中更高质量的输出和产物使 Carbon 在 WebDev Arena 上提升了 89 个 Elo 分,以 1,769 分位列第四。 在 Gray Swan 的间接提示注入基准测试中,Carbon 将攻击成功率从 Argon 的 0.7% 降至 0.0%,据 Google 称,它拦截了所有测试过的操纵尝试。这并不意味着提示注入问题已经解决,但该测试似乎已经饱和。 独立评估印证了 Google 的数据 根据 Artificial Analysis 的数据,Carbon 在其最高推理层级(“high”)上领跑 Intelligence Index v5,主要得益于在复杂推理、知识检索

    匹配字段正文

  7. Latent Space精选

    Google DeepMind 发布 Gemini 4 Carbon,登顶 Artificial…

    Google DeepMind 发布 Gemini 4 Carbon,在 Artificial Analysis Intelligence Index v5 上以 59 分排名第一,并在 HLE-Diamond、TB-Science 等 9 项评测中的 4 项领先。该模型主打网络安全与长周期任务,宣称在 SEC-bench Pro 上取得 88.2%、ExploitGym 上 54.8%、CWE-bench 上 71.0%,初期仅通过 Fairwind Program 向可信网络安全人员开放。规格上支持 1M token 上下文与 1M 最大输出,输入覆盖文本、图像、视频和语音,输出为文本;Artificial Analysis 列出的标准价格为每百万输入/输出 token 4/20 美元,另有 50% 上线折扣。

    tron 3.5 Lightning(总计 30B,激活 3B)进行了后期训练,包含两个 SFT 阶段和两个 GRPO 阶段。它在 FrontierFinance 上得分为 58.9%,而 Fable 5.1 为 55.9%,成本为 0.61 美元对 6.89 美元(@maithra raghu)。 检索与记忆: EmbeddingGemma 2:这个开放的多模态嵌入模型有 744M 参数,具有模块化编码器,仅文本时以 271M 参数运行。它在 MTEB Multilingual v2 上得分为 61.36(@dair ai)。 EMMA:该系统通过情景记忆改进多智能体设置。它比 GEPA 和 ADAS 最高提升 32.5%(@omarsar0)。 网络上的 AI 文本:截至 2026 年 8 月,约 24% 的可抓取页面包含 AI 生成或 AI 编辑的文本(@omarsar0)。 推理与硬件系统 KV 缓存工程: AKV(清华大学与香港中文大学):该服务引擎新增了“drop”和“repos”缓存操作。它将智能体成本降低 27.7%,并将 P95 延迟改善 1.51 倍(@TheTur

    匹配字段正文

  8. 凤凰科技

    天数智芯天垓300实测对比H200:训练吞吐达H100的1.33倍

    天数智芯在10月28日媒体开放日首次开放天垓300实机演示,称其在GLM-5.3等大语言模型及文生图、文生视频场景的对比测试中整体表现优于H200。训练方面,基于Qwen3-32B的8卡整机FP8精度演示中,天垓300每卡有效吞吐达到H100的1.33倍。天垓300于今年7月世界人工智能大会发布,配备144GB显存,其IXL144超节点在单个标准机柜内集成144颗GPU、约10.1TB显存,每百万有效Token成本较国际主流方案降低约40%。

    5倍,这是国内首个实测性能达到H200水平的通用GPU。 天数智芯性能实验室的实测进一步覆盖典型业务场景: 在64K长上下文下,天垓300的Attention性能为H200的1.05倍; GLM-5.3模型64K规模下,保障同等用户体验的同时,MoE吞吐为H200的1.15倍; 8K至128K长上下文场景下Agent首字延迟较H200降低约10%至30%; 多模态生成推理吞吐较H200提升约2%至5%; 在搜广推等在线业务中,推荐推理吞吐提升21%,轻量计算时延降低26%。 规模化交付侧,天垓300已形成从加速卡、一机8卡服务器到超节点的完整系统方案,天垓300 IXL144超节点在单个标准机柜内集成144颗GPU,约10.1TB显存,每百万有效Token成本较国际主流方案可降低约40%。 “特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。 Notice: The content above (including the videos, pictures and audios if any) is upl

    匹配字段正文

星期五

  1. 钛媒体 · AGI

    字节世界模型曝光:张一鸣的布局与谷歌 Genie 4 的路线差异

    钛媒体文章称,字节跳动已将世界模型列为 2026 年 AI 四大重点之一,目标年底前至少发布一版,对标谷歌 Genie 3,用户可通过 Pico 头显以语音和动作进入云端生成的世界。文章同时梳理了谷歌 10 月 28 日发布的 Genie 4,其支持用自然语言实时改变天气、移动镜头和引入人物,并首次加入声音。文中还提到字节内部评测显示其世界模型综合性能距当时全球 SOTA 约差 10%,生成指标约 20fps。

    情,也都没有解决。 字节早有布局 字节的世界模型和谷歌有异曲同工之处。 2024年,通义大模型技术负责人周畅从阿里加入字节后,负责的就是世界模型相关研究。 不过当时字节内部判断,世界模型的技术路线和商业化场景都不够清楚,更重要的是先打好视频模型这一仗。 到2025年,字节开始小范围组建VLA研究组。字节AI Lab负责人李航团队主要基于仿真数据训练,Seed多模态研究员王文千团队主要基于自然数据训练。 2026年春节后,Seed又新设了一支3D仿真世界模型组,由前Meta FAIR研究员范浩奇负责,向周畅汇报;原来的两个VLA组合并,也统一向周畅汇报。 由此形成两条路线:VLA面向具身智能,追求真实动作与环境响应;3D仿真面向娱乐和游戏。 字节为世界模型准备的训练数据预算达到数千万元,覆盖VLA、长视频和3D等模态。一名数据供应商称,投入能达到其他厂商的3至4倍。 然而钱也花了,人也找了,可成绩就是出不来。据报道,2026年初,字节内部评测显示,其世界模型的综合性能距离当时的全球SOTA仍有约10%的差距。 就和谷歌一样,字节做世界模型也是有技术支撑的。 Seedance 2.5单次可

    匹配字段正文

  2. 钛媒体 · AGI

    GPT-6 Astra 发布 50 天,具身智能行业发生了什么

    钛媒体旗下数智前线梳理了 OpenAI GPT-6 Astra 发布约 50 天来对具身智能行业的冲击:Astra 无需专门机器人数据训练即可直接控制机械臂完成画桥等任务,英伟达 Jim Fan 称其把自家机器人框架的基准刷到约 99%。但商汤联合多家机构的评测认为它已具备完成具身任务的能力,距离实用仍有明显差距,单次推理平均耗时 18.56 秒,把笔放进笔筒的任务耗时 4 个多小时、花费 55 美元。行业已出现三种用法:直接充当策略模型、审核修正 VLA 动作、搭建仿真环境与数据标注,宇树王兴兴称明年 GPT-7 可能直接打穿具身智能问题。

    重新确认。Astra在精细操作上的短板,恰恰指向物理接触数据的缺失,而目前大模型公司开始大量买数据、采数据已经不是新闻。 今年9月具身数据众包平台觅蜂科技CEO姚卯青受访时提到,他们的客户里除了具身公司和世界模型公司,通用大模型公司是他们的第三类客户。而头部的大模型最新版本具备了一定在物理世界里面去决策和规划的一些能力,也是因为它们已经开始把这些数据训到基模多模态的能力里面去了。 大模型公司已经不止于买数据。OpenAI在湾区租下的厂房,电力容量超过1.4万安培,远超普通工业建筑,被外界视为机器人数据工厂的雏形;其机器人数据采集运营岗位的职责里,明确写着协调工作站、操作员和物料的日常运转。字节Seed团队新放出的数据与评测岗位,则要求建设贯穿采集、处理、训练、评测和模型反馈的完整闭环。 一位具身行业从业者告诉数智前线,具身公司过去在数据上投入很大,哪怕别人要采,别人也会花很长的时间才能采出来。但这段时间差能维持多久,没人说得清楚。 仿真是否受益,则观点不一。陈哲认为,如果通用模型需要在虚拟世界里做强化学习,谁能提供更多、更真实的3D场景,谁就有议价权。许华哲则泼了冷水,Astra 做的

    匹配字段正文

  3. 智能制造网

    中科慧灵完成数亿元A++轮融资,在手制鞋机器人订单超4亿元

    中科慧灵近日完成数亿元A++轮融资,由知来投资、涌铧投资、茂天投资、元禾辰坤、国科科智、鲁宁投资等联合投资,资金用于产品量产交付、具身大脑技术研发和市场拓展。公司称今年在手具身制鞋机器人订单总额已突破4亿元,设备排产规模达数千台。其自研具身大模型CAS-brain与轻量化CASBOT PA感知—动作模型,后者计划2027年下半年开源。

    中科慧灵成立于2023年,是中科院自动化研究所重点孵化企业。创始人兼董事长张正涛是中科院自动化所研究员、博导,中科院工业视觉智能装备技术工程实验室主任,核心团队曾参与微靶精密装配、C919大飞机柔顺装配等任务。 依托中科院自动化所的科研积累,中科慧灵搭起了“本体+具身大脑+灵巧手”的全栈技术体系。 大脑端,该公司自研了具身大模型CAS-brain,以视觉语言多模态大模型为基础,结合具身Agents、世界模型与强化学习,把机器人硬件、真实交互数据、模型训练推理和自主进化串成一套体系。 面向工业场景,还推出了轻量化的CASBOT PA(Perception-to-Action)感知—动作模型,链路是“视觉感知→动作生成→运动学处理→真机执行”,支持单张消费级GPU训练,并具备实时纠错和失败重试能力,降低工业场景的部署和迭代门槛。 按照规划,CASBOT PA计划在2027年下半年开源。 本体端,中科慧灵具备从末端执行器到整机的自主研发能力,产品包括全尺寸人形机器人CASBOT 01、CASBOT 02,工业轮臂式机器人CASBOT W2,半尺寸人形机器人CASBOT Mini,以及CASB

    匹配字段正文

  4. OpenAI:部署安全与系统卡

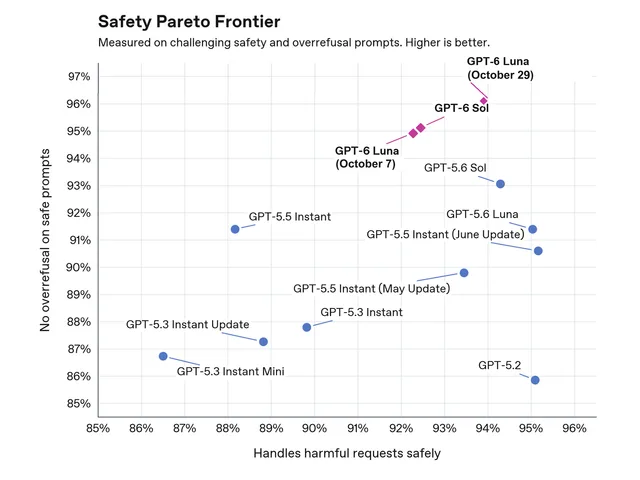
    GPT-6 Luna 10月29日更新:系统卡补充说明

    OpenAI 发布 GPT-6 Luna(October 29)更新,回应更简洁并减少过度迎合性措辞,在 Preparedness Framework 下仍被评定为网络安全与生物化学能力均为 High,沿用 GPT-6 Luna(October 7)的同一套防护措施。该版本在 Production Benchmarks 的 gore 评测上较前版提升,在安全处理有害请求与有用性之间实现帕累托改进;U18 评测中在性内容、饮食失调、情感依赖和 gore 上改善,指令层级评测达到 99.91% 鲁棒性。

    Figure 1. Safety and non-overrefusal on challenging prompts. Higher is better
on both axes

    物与化学领域视为高能力。下文报告了我们在高能力与关键能力评估上的最新结果。有关这些评估的完整说明,请参阅 GPT-6 Astra 系统卡中的生物与化学能力章节。 GPT-6 Astra 系统卡. 表8:生物与化学能力:指示性阈值 表8. 生物与化学能力:指示性阈值 1 评估指标指示性阈值gpt-6-luna(10月7日)gpt-6-luna(10月29日) 多模态故障排查病毒学 pass@1 31% 48.13% 45.85% 协议问答开放式评测 pass@1 54% 34.57% 31.80% 隐性知识与故障排查 cons@32 80% 94.00% 90.80% 故障排查 pass@1 36.4% 41.46% 37.90% 表9:生物与化学能力:指示性阈值 表9. 生物与化学能力:指示性阈值 1 评估指标指示性阈值gpt-6-luna(10月7日)gpt-6-luna(10月29日) AAV 衣壳包装预测 斯皮尔曼等级相关系数(越高越好) 0.60 0.53 SHP2 蛋白功能预测 平均 R²(越高越好) 0.60 0.13 0.21 冠状病毒--ACE2 细胞进入筛选 综合评分

    匹配字段正文

  5. Latent Space

    Elorian 发布 DecoyCount 基准,前沿模型视觉计数准确率均低于 50%

    Elorian 与 Mercor 联合发布 DecoyCount 基准,测试模型是真正数清物体还是依赖视觉捷径,前沿模型准确率均低于 50%,最高为 GPT-6 Astra 的 43.17%。Elorian 称其视觉推理模型 Glimpse 在 1,660 道题上单次运行得分 50.48%,是唯一超过 50% 的模型,但该结果来自内部测试且未使用智能体或工具框架,而论文中的六个模型各取三次运行平均值。Elorian CEO Andrew Dai 表示,该基准同时考察视觉与推理,可区分模型是没看到物体还是数错了。

    标,Dai 认为,对模型所见内容进行推理,对于其在现实应用中的准确性和有效性至关重要。 他举了一个仓库机器人清点箱中物品的例子。 “一个熟悉的 12 槽托盘可能只装 10 个零件,而 24 件装的标签并不意味着箱子里仍有 24 件物品,”Dai 说。“依赖自己预期所见内容的模型,在现实情境中会遇到很多问题,而 Glimpse 的设计初衷是透过图像来工作,而不是急于下结论。我们将 Glimpse 设计为让计数建立在可见证据之上,而不是依赖可能误导其他模型的基本线索。” 为什么 Elorian 认为 AGI 需要视觉推理 Elorian 甚至声称视觉推理是 AGI(通用人工智能)的基础要求。摘自 Glimpse 发布文章: “我们相信,从系统、数据、模型架构到训练构建全栈——从底层开始为多模态智能而设计——能够在物理世界中解锁 AGI。” Dai 承认“人类与机器之间仍存在巨大差距”。但他认为视觉推理是缩小这一差距的关键。 “我认为理解视觉推理的方式是,把它看作人类智能中推理的一个基础步骤,”他说。“而最终,如果我们想构建任何类似 AGI 的东西,就不能跳过视觉。”感谢阅读 保持领先一步。

    匹配字段正文

  6. 新京报

    心言机器人发布具身家庭智能体巴布(Bubbo 1)

    心言机器人10月29日正式发布具身家庭智能体“巴布(Bubbo 1)”,基于自研Bubbo OS实现伙伴式交互。创始人任永亮称技术决定体验下限、交互决定体验上限,希望把自主还给孩子、把空间还给家人。公司成立于2025年,专注家庭情感智能机器人研发。

    常委、国家统计局原副局长贾楠则从适老化方面切入,围绕国情和数据,论证陪伴机器人在居家养老、社区养老场景下扮演的角色和意义。她提出巴布应重点打磨灵活深入、适配不同用户需求的多方位情感交流功能,满足独居老人的精神陪伴需求。 哈尔滨工业大学计算学部长聘教授、博士生导师赵妍妍指出,机器人懂人、理解情绪的技术难度分为三层,分别是情感感知、情感认知、情感交互,需依托丰富多模态信号与充分上下文,须具备主动跟随、移动感知的能力,才能更好完成相关任务。她认为产品核心要做好用户记忆功能,实现精准共情的个性化回应,成为真正懂用户的家庭伙伴。 1 中共中央举行新闻发布会 介绍和解读党的二十届五中全会精神 12.8万 2 新闻8点见丨中共中央今日举行发布会,介绍和解读党的二十届五中全会精神 12.6万 3 第酒局丨汾酒三季报:从渠道重塑迈向消费者驱动新周期 9.0万 4 从洪湖到门店,半天妖五重管控下叉尾鮰鱼如何“游”到餐桌? 6.2万 5 洛阳一卤蛋店爆火老板跪求少来 镇政府人员:有人一次买一百多个 4.0万 最新 小鹏MONA系列首款大五座SUV上市,L05限时售价13.98万元起 13分钟前 特斯拉推出“

    匹配字段正文

  7. 华尔街见闻

    闪迪电话会:客户低估NAND需求,NBM长单已排到2030年

    闪迪2027财年第一财季营收110亿美元,同比增长378%,其中数据中心业务营收48亿美元、环比增长61%。管理层称客户低估了运行AI基础设施所需的NAND容量,2027年约50%、2028年约三分之二的供应已被NBM长单预订,供应渠道可见到2030年甚至更远。首款HBF存储芯片已完成流片,计划明年向客户交付首批样品。

    的盈余现金返还给股东,本财季已豪掷50亿美元用于股票回购。 数据中心业务狂飙:“客户低估了运行基础设施所需的闪存容量” 数据中心无疑是本季度财报中最亮眼的主线。一季度闪迪数据中心业务营收达48亿美元,环比大增61%。 随着AI大模型的演进,推理工作负载正在发生结构性变化。董事长兼首席执行官David Goeckeler在会上指出:“更长的提示、更复杂的推理、多模态输入和持久的用户上下文都会显著增加存储需求。HBM和DRAM支持最高性能层级,而闪存则提供高效保留更广泛上下文所需的容量,并避免代价高昂的重新计算。” 这种战略地位的提升直接反映在客户的订单焦虑中。闪迪推出的长期合作模式——新业务模块(NBM)正受到超大规模云厂商的追捧。Goeckeler直言:“我们从客户那里了解到,他们低估了运行基础设施所需的NAND闪存容量。因此,我们有很多客户再次订购,同时也在努力拓展新客户。” 市场版图正在发生不可逆的转移。管理层估计,“数据中心业务已从十年前约占行业总量的20%增长到如今的近一半。” 面向未来,公司预计2027年数据中心将占据超过55%的市场份额,投标需求将同比增长约40%。Goec

    匹配字段正文

  8. 凤凰科技

    腾讯升级 WorkBuddy 企业版开放战略,Buddy One 打通办公套件

    腾讯在 2026 腾讯全球数字生态大会上宣布 WorkBuddy 企业版开放战略升级,并用 Buddy One 打通腾讯文档、腾讯会议、腾讯网盘和 ima,共享同一 Agent 底座与统一账号、积分池。汤道生披露,WorkBuddy 企业版自今年 3 月上线以来已落地 50 多个行业,覆盖 50% 中国企业 500 强、60% 中国企业 100 强,开放平台伙伴超 5 万家,上架 Skills 超 20 万,累计完成 90 亿次任务请求。WorkBuddy 以智能机器人身份入驻企业微信,由企业管理员配置 AI 可读取的内容与可执行的操作,10 月 13 日上线的可观测中心提供实时观测、会话追踪与轨迹详情。

    e打通腾讯旗下办公套件。 Buddy One打通腾讯文档、腾讯会议、腾讯网盘、ima,共享WorkBuddy Agent底座,统一账号与积分池,让用户一次提问就能跨应用检索已授权内容;腾讯网盘则作为Agent时代的记忆空间,统一存储Agent积累的上下文与生成成果,沉淀为组织资产。 通过统一账号、统一积分池、统一数据池,大模型针对不同需求,调用不同工具来生成多模态内容,团队可以在项目中协同修改,共同检验产出物,持续讨论与迭代。这样一来,人和 AI 共同创作,就是围绕任务协同,而不是围绕文件流转。 而允许WorkBuddy以智能机器人身份“入驻”企业微信,意味着Agent读到的不是用户手动上传的一份文档,而是授权范围内的消息、文档和会议记录。企业管理员可以配置AI能看什么、能做什么、哪些环节必须人工确认。AI产出结果后,自动回传至企微会话或审批流,进入下一环节的工作流。 腾讯希望借此把Agent从外挂工具变成组织内的一个节点,但节点能不能站稳,取决于企业是否愿意把审批流和群聊记录交给它。也就是说,这套逻辑成立的前提是,企业相信“给Agent更多上下文”的收益大于风险。 上下文也不只来自企

    匹配字段正文

星期三

  1. Latent Space

    Anthropic 取消编程面试:Felix Reiseberg 称"Hunger beats tenure

    Anthropic 招聘经理 Felix Reiseberg 宣布不再用传统编程面试考察候选人,理由是 Claude 在 React 挑战和汇编题上都已强于人,真正有影响力的构建者不靠这类测试取胜。他建议初级工程师选能带来业务影响的想法、周末做出可运行原型、只聚焦一个好点子,并发挥对用户的新鲜视角。同日 Google DeepMind 发布 Genie 4 世界模型,Artificial Analysis Intelligence Index v5 榜首为 Claude Opus 5.5(58 分)。

    布还包括 LFM3-VL-2B、LFM3-Audio-2B、LFM3-Omni-2B、决策模型 d1-2B / d1-Omni-2B,以及在 22T token 上训练的 LFM3-1.7B-Base 检查点,llama.cpp 支持已通过 PR 31257、 31252 和 31275 合并。Liquid 将这些模型定位用于边缘推理、结构化输出、工具调用、多模态理解和快速非生成式决策,同时明确警告该小型文本模型不适用于智能体编程或复杂的多步推理。热门评论大多是反应/图片而非技术讨论;主要情绪是对此次发布范围的广泛性以及如此小的端侧模型所展现的明显基准实力感到惊讶。 Ling-3.1-flash-1019 权重已发布,他们也放出了基础模型(活动:292):图片是 Artificial Analysis Intelligence Index v4.3.2 的基准柱状图,突出显示 Ling-3.1 Flash 1019 得分为 44,高于此前报告的 41,位置接近 GLM-5.0、Step 5 Preview 和 Kimi K3 等模型;图中还注明“无公开可用 API”。帖子宣布 incl

    匹配字段正文

  2. Hugging Face精选

    NVIDIA 发布 Nemotron 3.5 Transcribe 与 Granary v2 数据管线

    NVIDIA 在 Hugging Face 和 ModelScope 上发布开放权重模型 Nemotron 3.5 Transcribe,把转写、说话人分离、翻译和音频问答整合进同一个 checkpoint,支持 40 种语言转写、31 种语言与英文互译、13 种语言说话人标注,可处理最长 1 小时录音并标注最多 8 位说话人。该模型在 Hugging Face Open ASR Leaderboard 英语榜的开放权重模型中排名第一,平均 WER 为 5.33%,在 Artificial Analysis 上以约 4B 激活参数取得 2.8% AA-WER。同时发布的 Granary v2 覆盖 48 种语言、463,062 小时语音数据,配套 NeMo Speech 微调配方在医疗案例中把留出说话人的 WER 从 22.44% 降到 12.17%。

    案例研究包含用于复现每个步骤的命令。微调教程涵盖配方、资源需求,以及用于训练、导出和评估的工具,包括新语言和语码转换 ASR。配套的智能体技能让编码智能体能够运行整个工作流,从基线选择和数据检查,到训练验证、适配器合并和评估。 ModelScope 还让开发者能够通过其 ms-swift 框架微调 Nemotron 3.5 Transcribe,以用于专门的多模态应用。 如需跳过自托管,可使用 Baseten、DeepInfra 或 Simplismart 提供的托管端点。 要将其适配到你的领域,请从 Hugging Face 或 ModelScope 上的 Granary v2 清单以及医疗 ASR 案例研究入手,或者让编码智能体借助微调智能体技能来驱动工作流。 模型检查点:Hugging Face、ModelScope 上的 NVIDIA Nemotron 3.5 Transcribe | Hugging Face、ModelScope 上的交互式演示 托管端点:Baseten、DeepInfra 本地 AI:NVIDIA RTX PC、笔记本电脑和 DGX Spark 上本地 A

    匹配字段正文

  3. 凤凰科技

    分子之心MMDesign技术报告:19个项目18个成功,6个GPCR靶点全命中

    分子之心发布AI蛋白质从头设计平台MMDesign的技术报告,覆盖18个靶点、纳米抗体和大环肽两类模态共19个项目,18个获得实验确认的结合分子,项目成功率94.7%,453个受测候选中139个命中,候选命中率30.7%。六个GPCR靶点全部成功,最优亲和力均达纳摩尔级,GPR68最优KD低至12.1纳摩尔,NK3R的30个候选全部确认结合。报告还显示对6个已有结合分子的靶点再设计时5个获得提升,并给出结构预测模型MMFold在FoldBench抗体-抗原界面基准上的结果。

    .4%,高于OpenDDE报告的33.0%与Protenix-v2报告的28.2%;Top-5高质量成功率进一步达45.0%,整体成功率78.8%。 △FoldBench的160个共同界面子集结构预测结果 结构预测的价值不在排名本身,而是让候选分子的评估与优选有了更扎实的计算依据。 结构看得更准,分子设计者才能更快从庞大的计算空间里锁定少数值得实验的候选。 多模态蛋白质基础大模型NewOrigin(达尔文)提供底层能力,MMDesign承担从头生成与候选优选,MMFold专注结构预测,QuantaMind进行动态模拟,AI原生研发操作系统MoleculeOS则把模型工具与研发流程串成“生成-计算-实验-迭代”的闭环。 分子之心创始人许锦波表示: 这次扩展评估的重要意义,在于将一次性的设计成功,逐步转化为可重复、可扩展的研发能力。AI生物药研发的长期价值,不只是单个模型的性能突破,更在于通过自主底层模型与生成、评估、实验验证的协同,让精准分子设计成为能够持续解决不同研发问题的技术基础设施。 从单点命中到跨靶点、跨模态的系统性验证,从底层模型突破到可复用的研发工作流,MMDesign的最新

    匹配字段正文

  4. The Rundown AI

    Google DeepMind 发布 Genie 4 世界模型,可生成音效并与场景角色对话

    Google DeepMind 发布新一代世界模型 Genie 4,可将提示词实时转化为可探索的逼真场景,并首次由 Genie 模型自行生成背景音和音乐,场景中的角色也能进行实时对话。用户通过键盘移动,并用文本提示在场景中即时修改内容,场景在多次输入之间保持连贯。演示中一个模拟的 Apptronik Apollo 机器人下跳棋,每一步由 Gemini 4 Argon 规划,指向 Genie 未来的机器人训练用途。

    评论,以及关于哪些内容有效的备注。在撰写新帖子之前,Claude会审阅完整的帖子历史,对帖子进行排名,并找出哪些模式为我的目标受众带来了触达和互动。这件事之所以有效,是因为分析数据与内容存放在同一张表中,所以每一条帖子都让下一条更聪明。” 在我们的社区工作流程中心查看该工作流程 → 🛠️ 热门AI工具 💧 LFM3 - Liquid AI全新推出的小型设备端多模态模型系列 🎨 MAI-Image-2.7 - 微软升级版图像AI,率先面向编辑功能推出 🔎 Parallel Decisions API - 利用实时网络数据进行分类的决策AI 🌎 GPT-6.1 Terra - OpenAI更便宜、更快的模型,用于日常计算机工作 📰 今日AI其他动态 Anthropic发表论文称,一个内部Claude模型同样否证了指数时间假设,与OpenAI公布自身结果的同一天发布。 美国总统Donald Trump发帖称,他将“在所有相关文件中禁止使用‘AI/人工智能’一词”,这是朝超级智能迈进的又一举措。 AI-for-physics实验室Physical Superintelligence发布了五篇新

    匹配字段正文