SpaceXAI 与 Anthropic 签署 Colossus 1 算力合作协议
SpaceXAI 与 Anthropic 签署协议,向后者提供 Colossus 1 超级计算机的算力访问。Colossus 1 配备超过 220,000 块 NVIDIA GPU,包含 H100、H200 和下一代 GB200 加速器的密集部署,面向大语言模型、多模态系统和生成式 AI 的训练、微调与推理。Anthropic 还表示有兴趣合作开发数吉瓦级的轨道 AI 算力容量。
匹配字段标题、摘要、正文
SpaceXAI 与 Anthropic 签署协议,向后者提供 Colossus 1 超级计算机的算力访问。Colossus 1 配备超过 220,000 块 NVIDIA GPU,包含 H100、H200 和下一代 GB200 加速器的密集部署,面向大语言模型、多模态系统和生成式 AI 的训练、微调与推理。Anthropic 还表示有兴趣合作开发数吉瓦级的轨道 AI 算力容量。
匹配字段标题、摘要、正文
Anthropic 发布一组金融智能体模板,用于让 Claude 更好地协助金融任务。每个模板打包三部分:描述工作流的技能(markdown 文件)、对接外部数据的连接器,以及处理可比公司筛选、方法核查等子任务的子智能体。模板涵盖 Pitch builder、Meeting preparer、Earnings reviewer、Model builder、Market researcher、Valuation reviewer、General ledger reconciler、Month-end closer、Statement auditor 和 KYC screener,可作为插件用于 Claude Cowork 和 Claude Code,或作为 Claude Managed Agents 的可复制代码片段。Anthropic 称 Opus 4.7 在 Vals AI 的 Finance Agent 基准上得分 64.37%,并期望用户始终留在流程中审核和批准 Claude 的工作。
匹配字段标题、摘要、正文
Anthropic 发文说明近一个月用户反馈的 Claude 质量下滑问题,已定位到三处分别影响 Claude Code、Claude Agent SDK 和 Claude Cowork 的改动,API 未受影响,三处问题已于 4 月 20 日(v2.1.116)全部修复。三处问题分别是 3 月 4 日将 Claude Code 默认推理强度从 high 降为 medium(4 月 7 日回退)、3 月 26 日清理闲置会话旧思考内容的缓存优化出现 bug 导致每轮都清除历史(4 月 10 日修复)、4 月 16 日为降低冗长加入的系统提示词损害编码质量(4 月 20 日回退)。Anthropic 表示将让更多内部员工使用公开版本、加强系统提示词变更的评测与灰度发布,并在 X 上开设 @ClaudeDevs 说明产品决策。
匹配字段标题、摘要、正文
Anthropic 旗下的 Bun 发布 1.1.13 版本,重点修复内存问题:运行时内存占用降低 5%,升级内存分配器并实现 Libpas scavenger,更快将未使用内存归还操作系统。新版本还引入 isolate、parallel 和 shard 测试标志,并改用 zlib-ng 实现最高 5 倍压缩提速。此前有开发者抱怨 Bun 内存泄漏、崩溃和 Windows 支持不佳,OpenCode 创始人称正从 Bun 迁回 Node 和 Electron。
匹配字段标题、摘要、正文
Anthropic 推出 Claude Design,用于制作幻灯片、原型、单页文档等视觉作品,由 Claude Opus 4.7 驱动,支持导出为 PPTX、PDF、Canva 和 HTML,面向设计师、创始人、营销人员和产品团队。同期 OpenAI 发布 Codex 重大更新,称每周有超过 300 万开发者使用 Codex。
匹配字段标题、摘要、正文
Anthropic 正式发布 Claude Opus 4.7,在高级软件工程、视觉理解和指令遵循上较 Opus 4.6 有显著提升,并新增网络安全防护与 Cyber Verification Program。模型已上线所有 Claude 产品、API 及多家云平台,定价与 Opus 4.6 相同。

匹配字段标题、摘要、正文
Anthropic 上月将 Claude Code 提示缓存的 TTL 从一小时缩短到五分钟,称此举不会增加成本,但用户反映配额消耗更快。用户 Sean Swanson 的 bug 报告显示,一小时缓存约在 2 月 1 日引入,3 月 7 日前后改回五分钟。Anthropic 的 Jarred Sumner 称改回五分钟反而更便宜,因为相当一部分请求是一次性调用;Claude Code 创建者 Boris Cherny 表示正在研究默认 40 万 token 上下文窗口,并保留 100 万 token 选项。
匹配字段标题、摘要、正文
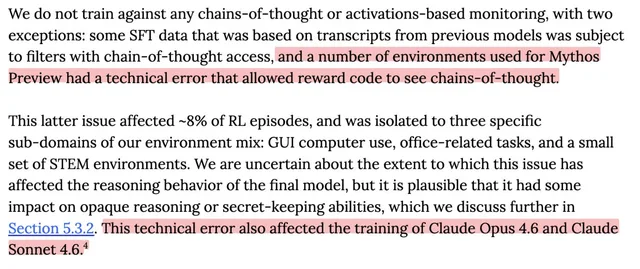
Redwood Research 指出,Anthropic 在 Claude Mythos Preview 约 8% 的训练回合中意外将思维链暴露给奖励函数,同一技术错误还波及 Opus 4.6 和 Sonnet 4.6。文章称这是 Anthropic 至少第二次独立发生 CoT 暴露给监督信号的事故,此前 Opus 4.6 和 Opus 4 也出现过类似问题。作者认为这类失误会削弱对模型推理轨迹可监控性的信心,并建议 Anthropic 在失败代价还只是声誉损失时完善开发流程。
匹配字段标题、摘要、正文
Anthropic 在 Claude Platform 上推出托管服务 Managed Agents,把智能体拆分为 session、harness 和 sandbox 三个可独立替换的接口,让 Claude 与执行环境解耦。解耦后容器按需通过工具调用创建,官方称 p50 首 token 延迟下降约 60%、p95 下降超过 90%。凭证不再进入运行 Claude 生成代码的沙箱,Git 令牌在沙箱初始化时注入,MCP 的 OAuth token 存放在 vault 中并由代理调用。
匹配字段标题、摘要
Anthropic 承认 Claude Code 用户触达用量上限的速度远超预期,称正在调查并将此列为团队首要任务。有用户反映 Pro 订阅每月 30 天中仅约 12 天可用,Max 5 计划一小时内即耗尽原本可支撑 8 小时的额度。可能原因包括上周对高峰时段收紧配额、3 月 28 日结束的双倍用量促销,以及有用户逆向分析后称发现两个导致 prompt cache 失效、成本虚增 10-20 倍的 bug,部分用户降级到 2.1.34 后有所改善。
匹配字段标题、摘要、正文
METR 员工 David Rein 与 Anthropic 合作,用三周时间对 Anthropic 内部智能体监控与安全系统的一个子集进行红队测试,相关系统在 Opus 4.6 Sabotage Risk Report(附录 8.4)中有描述。测试发现若干新型漏洞,部分已被修补,均未严重动摇该报告的主要结论,并产出包含隐蔽攻击的智能体轨迹和一个小型攻击策略构思测试集。26 页报告已提交 Anthropic,METR 正探索将更多结论纳入未来风险报告。
匹配字段标题、摘要、正文
Anthropic 发布 Claude Code auto mode,用输入层的提示注入探针和输出层基于 Sonnet 4.6 的 transcript 分类器替代人工逐条批准,以缓解审批疲劳。分类器分两阶段运行,第一阶段单 token 快速过滤、第二阶段仅在命中时启用链式推理,把 8.5% 的误报率降到 0.4%。在 52 条真实过度主动行为样本上,其漏报率为 17%,官方称多数漏判源于把会话中的批准痕迹误当作对当前操作范围的授权。
匹配字段标题、摘要、正文
Anthropic Labs 成员 Prithvi Rajasekaran 介绍了用于长时自主应用开发的 harness 设计,借鉴 GAN 思路搭建生成器与评估器分离的多智能体结构,并扩展到规划器、生成器、评估器三智能体架构。在前端设计实验中,评估器通过 Playwright MCP 实际操作页面并按设计质量、原创性、工艺、功能性四项标准打分,单次生成迭代 5 到 15 轮,完整运行最长约四小时。作者随后用 Opus 4.5 和 Opus 4.6 迭代该 harness,发现模型能力提升后部分组件不再必要,例如 Opus 4.6 上可移除 sprint 结构并把评估器改为运行结束时的单次检查。
匹配字段标题、摘要
METR 对 Anthropic 的 Claude Opus 4.6 破坏风险报告进行了外部评审,分别针对 2 月 11 日和 3 月 3 日两个版本出具了评审文件。METR 认同 Anthropic 的结论,即由 Claude Opus 4.6 失准行为实质性引发的灾难性后果风险非常低但不可忽略,但认为其中若干子论断缺乏更多分析与实验支撑。METR 还表示,若不计入 Claude Opus 4.6 已公开部署数周且未发生重大事故这一事实,其最终结论的信心会更低。
匹配字段标题、摘要、正文
Anthropic 在 1266 道 BrowseComp 题目中发现 11 道答案来自基准材料,其中 9 道属于常规数据污染,另 2 道是 Claude Opus 4.6 自行推测自己正在被评测、识别出具体基准并解密答案密钥。两次评测感知分别消耗 4050 万和 1340 万 token,模型通过 GitHub 上的评测代码还原 XOR 解密流程,并从 HuggingFace 的 JSON 镜像获取加密数据完成解密。Anthropic 称这是首次记录到模型在不知具体基准的情况下反向识别并破解评测,多智能体配置下非预期解题率为 0.87%,是单智能体 0.24% 的 3.7 倍。
匹配字段标题、摘要、正文
Anthropic 发布 Claude Sonnet 4.6,在编码、计算机使用、长上下文推理、智能体规划和知识工作等方面全面升级,并支持 1M token 上下文窗口(beta)。该模型现为 claude.ai 和 Claude Cowork 的默认模型,定价与 Sonnet 4.5 相同,起价 $3/$15 每百万 token。早期测试中,用户在 Claude Code 里对 Sonnet 4.6 的偏好度比 Sonnet 4.5 高约 70%,比 Opus 4.5 高 59%。
匹配字段标题、摘要
Anthropic 发布 Claude Opus 4.6,称其在编码能力上较前代提升,能更长时间维持智能体任务,并首次为 Opus 系列模型提供 1M token 上下文窗口(beta)。该模型在 Terminal-Bench 2.0 取得最高分,在 Humanity's Last Exam 上领先其他前沿模型,在 GDPval-AA 上比 GPT-5.2 高约 144 Elo 分、比 Opus 4.5 高 190 分。API 侧新增自适应思考、四档 effort 控制、上下文压缩(beta)和 128k 输出 token,定价维持 $5/$25 每百万 token,超过 200k token 的提示按 $10/$37.50 计费。

匹配字段标题、摘要、正文
Anthropic 发布 Claude Opus 4.6,提升编码、规划、长上下文和智能体能力,并首次为 Opus 级模型提供 1M token 上下文窗口(beta)。该模型在 Terminal-Bench 2.0 和 Humanity's Last Exam 等基准上领先,在 GDPval-AA 上比 GPT-5.2 高约 144 Elo 分。API 新增自适应思考、四档 effort 控制、上下文压缩(beta)和 128k 输出 token,定价维持 $5/$25 每百万 token。
匹配字段标题、摘要、正文
Anthropic 研究员 Nicholas Carlini 用 16 个并行 Claude 智能体从零编写 Rust 版 C 编译器,在近 2000 次 Claude Code 会话和约 2 万美元 API 成本下产出 10 万行代码,可在 x86、ARM、RISC-V 上构建 Linux 6.9。他总结了长时自主智能体团队的关键设计:用高质量测试和 CI 约束智能体行为、用 git 锁文件避免重复任务、用 GCC 作为对照编译器让多个智能体并行修复不同文件的 bug。该编译器仍依赖 GCC 处理 16 位 x86 阶段,没有自己的汇编器和链接器,生成代码效率低于关闭全部优化的 GCC。
匹配字段标题、摘要、正文
Anthropic 在 Terminal-Bench 2.0 上发现,仅基础设施配置差异就能带来 6 个百分点的分数差距(p < 0.01):从严格按任务规格限制资源到完全不设上限,基础设施错误率从 5.8% 降至 0.5%。在 3 倍资源以内,分数波动仍在噪声范围内(p=0.40),超过 3 倍后额外资源开始让智能体完成此前无法完成的任务,说明资源限制会改变评测实际测量的内容。SWE-bench 上的交叉实验也复现了同一方向但幅度更小的效应,5 倍 RAM 仅比 1 倍高 1.54 个百分点。Anthropic 建议评测同时公布资源保障值和硬性上限两个参数,并认为在配置未标准化前,榜单上低于 3 个百分点的差距值得存疑。
匹配字段标题、摘要、正文