←搜索结果

按匹配度 · 共 1629 条结果 清除搜索

星期日

  1. 事件2 条新闻 · 2 个事实

    Prime Intellect推算力平台并开源训练框架

    2024年7月1日,Prime Intellect 宣布其聚合与调度全球 GPU 资源的平台 Prime Intellect Compute 全面公开,已接入 12 家云厂商,用户可即时按需获取最多 8 张 GPU,H100 按需价格为每小时 1.5 至 4 美元。官方称当前 H100 在不同供应商间价格从每小时 1.2 到 18 美元不等,高端 GPU 闲置率常达 20-50% 以上。平台后续计划支持 16-128+ GPU 的多节点集群、即时报价与可靠性数据。7月11日,Prime Intellect 开源 OpenDiLoCo,这是 DeepMind DiLoCo 低通信分布式训练方法的可复现实现,代码基于 Hivemind 与 PyTorch FSDP,已发布在 GitHub。团队在加拿大、芬兰和美国两地共四个 DiLoCo worker(各 8 张 H100)上训练 1.1B 参数模型,跨两大洲三国,计算利用率保持 90-95%,all-reduce 仅占训练时间 6.9%。相比原论文 400M 参数规模,该方法被扩展到 1.1B 参数,并验证伪梯度可用 FP16 all-r

    匹配字段摘要

  2. 事件1 条新闻 · 1 个事实

    Cartesia发布Based架构研究

    2024年3月4日,Cartesia团队发布Based架构,通过结合滑动窗口注意力和线性注意力,在召回密集型任务上超越Mamba等次二次方模型,同时实现比FlashAttention-2高24倍的文本生成吞吐量。该架构使用二阶泰勒近似作为特征映射,并提供了IO感知的CUDA实现,代码和检查点已在GitHub和Hugging Face公开。

    匹配字段摘要

星期三

  1. 事件1 条新闻 · 1 个事实

    Ollama 发布 Python 与 JavaScript 库初始版本

    2024年1月23日,Ollama 发布 Python 与 JavaScript 库的初始版本。据 Ollama Blog 当日消息,开发者可用几行代码将应用接入 Ollama,并共享 Ollama REST API 的功能与体验。该消息称,两个库支持 Ollama 的全部功能,示例代码见对应 GitHub 仓库;这些库与主仓库已迁至新的 GitHub 组织 ollama。目前尚无后续发展事实,事件状态停留在初始发布。

    匹配字段摘要

星期二

  1. NVIDIA Developer · Generative AI精选

    NVIDIA 开源 NVIDIA Recovery,自动恢复集群分布式训练任务

    NVIDIA 发布开源工作负载级恢复服务 NVIDIA Recovery,通过应用日志、GPU 指标和调度器信号检测训练中断,并按检测、归因、隔离、重启或停止四阶段循环处理。该服务以 Apache 2.0 许可在 dsx-ai-factory/NVIDIA-Recovery 仓库开放,Slurm 集成通过 Helm chart 部署的 Advisor Controller 实现,支持集群内和 SSH 两种模式。新部署默认处于监控模式,只输出恢复建议不执行调度动作;7 月 9 日至 10 月 9 日在一个训练集群上的监控覆盖每天近 200 个任务,记录约 8,550 次异常检测,平均检测与恢复动作延迟分别为 69 秒和 94 秒。

    Five-layer stack diagram showing where NVIDIA Recovery sits in the health and resilience architecture. From the base up: infrastructure, compute node, cluster, workload (where NVIDIA Recovery and NVIDIA Attribution sit), and framework (NVIDIA Resiliency Extension, or NVRx).

    联呈现异常标记,并为你提供每个工作负载的检测事件和恢复操作时间线。 视频 1:演示在 Kubernetes 上使用 Slurm 的 NVIDIA Recovery 全流程,从环境搭建和作业配置,到作业失败、自动恢复与归因 NVIDIA Recovery 已在 dsx-ai-factory/NVIDIA-Recovery 采用 Apache 2.0 许可证的 GitHub 仓库。让首个工作负载进入恢复流程需要三个步骤: 安装该 chart。NVIDIA Recovery 通过单个 Helm umbrella chart 部署。它附带一个捆绑的 MySQL 子 chart,因此你可以在本地运行快速入门,而无需预置数据库或物理 GPU。对于生产环境,请将该 chart 指向托管 MySQL 服务。仓库中的 operator 部署指南涵盖了这两种路径,以及 Kubernetes、Helm 和 Slurm 的当前版本要求。 验证你的信号。将图表指向你现有的 Loki 或 Victoria Logs 端点以及你的 Prometheus 抓取目标,然后在首次运行工作负载之前运行日志摄取配置器。它会根

    匹配字段正文

  2. NVIDIA Developer · Generative AI

    NVIDIA AICR 让 Kubernetes 在 Day 1 就支持 Vera Rubin

    NVIDIA AI Cluster Runtime(AICR)通过可复用 recipe 固化调优配置、生成部署包并验证运行中的集群,帮助 Kubernetes 环境在 Day 1 就支持 Vera Rubin NVL72。Vera Rubin recipe 系列锁定 R615.23 开源内核模块驱动、DRA driver v0.5.0(含 ComputeDomains)、Ubuntu 26.04 的 64k-page 内核等配置;在参考集群上用 GPU Operator v26.7.0 完成端到端验证,跨节点 NCCL all-reduce 在 16 GiB 下达到 744.71 GB/s 总线带宽。早期芯片验证还发现 go-nvlib 未映射 Rubin 架构值导致 DRA driver kubelet 插件崩溃重启,修复已进入 DRA driver v0.5.0 正式版。

    erator vr200 --os ubuntu --intent training 对于上文所述的 Dynamo 推理变体,以下命令可生成 recipe: aicr recipe --service rke2 --accelerator vr200 --os ubuntu --intent inference --platform dynamo 你可以在 GitHub 上关注进展、审阅代码或提交 issue: NVIDIA/go-nvml NVIDIA/go-nvlib kubernetes-sigs/dra-driver-nvidia-gpu 关于作者 关于 Mark Chmarny Mark Chmarny 是 NVIDIA DGX Cloud 组织的一位首席云架构师,专长于大规模分布式系统、容器编排和 GPU 加速计算。他专注于基于 Kubernetes 的 AI/ML 平台、高性能 GPU 集群,以及用于训练和推理的多云基础设施。 查看 Mark Chmarny 的所有文章 关于 Yuan Chen Yuan Chen 是 NVIDIA 的首席软件工程师,负责为 AI 构建云

    匹配字段正文

  3. AWS Machine Learning

    Circle K 如何借助 Amazon Bedrock 将 DevOps 事件分诊缩短至 15 分钟内

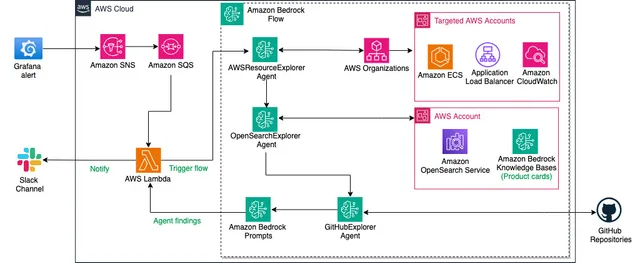
    Circle K 用 Amazon Bedrock 构建智能体式自动分诊系统,把 DevOps 事件平均分诊时间降到 15 分钟以内,按团队内部指标降幅达 67–75%。系统由 Grafana 告警经 Amazon SNS、Amazon SQS 触发 AWS Lambda 调用 Amazon Bedrock Flows,并行调度多个专用智能体查询日志与基础设施,并将结构化摘要推送到 Slack;后续已迁移至 Amazon Bedrock AgentCore。

    Amazon Bedrock Flows triage architecture: a Grafana alert flows through Amazon SNS, SQS, and Lambda to parallel agents that post a summary to Slack

    团队希望帮助值班工程师快速识别哪些信号需要关注,并附上恰当的上下文。 当告警到来时,分诊涉及一系列熟悉的人工步骤:查看 Amazon CloudWatch 中的近期日志,检查 Amazon OpenSearch Service 中的应用级追踪,查看 Amazon Elastic Container Service(Amazon ECS)任务状态,并将症状与 GitHub 中的内部运行手册进行交叉比对。 Amazon CloudWatch,检查 Amazon OpenSearch Service 中的应用级追踪, Amazon OpenSearch Service,检查 Amazon Elastic Container Service(Amazon ECS) 任务状态,并将症状与 GitHub 中的内部运行手册进行交叉比对。这为工程师提供了所需的信息,但也表明,随着更多服务接入,将需要进行大量重复性的上下文收集工作。 团队识别出两个可以通过主动投入获益的领域。第一,相同的日志查询、健康检查和运行手册查阅会在每次事件中重复进行。第二,分诊的深度和速度可能因值班工程师对受影响服务的熟悉程度而

    匹配字段正文

  4. AWS Machine Learning

    用 Amazon Nova Multimodal Embeddings 与 Bedrock…

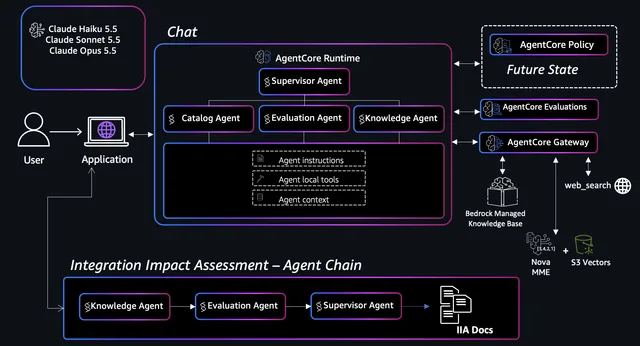
    AWS 展示了基于 Amazon Bedrock AgentCore、Amazon Nova Multimodal Embeddings 和开源 Strands Agents SDK 的多智能体工程助手,用于减少零件替代评估中的人工交叉核对。系统由 planner 将任务路由给 Catalog、Evaluation、Knowledge 三个专家智能体,分别负责多模态检索、按 Python 容差规则打分和用实时网络数据核实生命周期信息,最终由 supervisor 汇总。系统只组装证据并起草评审文档,不自行推荐或批准替代方案,每次评估都会写入对齐 AS9100 8.4 和 8.5.6 的审计记录。

    Architecture of the multi-agent assistant: a planner routes engineer queries across Catalog, Evaluation, and Knowledge specialists, with a supervisor synthesizing results

    图像作为查询的路径。 一个带有 Web Search 连接器和托管知识库目标的 Amazon Bedrock AgentCore Gateway。 Python 3.10 或更高版本以及 Jupyter,用于运行笔记本。 Docker,前提是你调整 notebook 03 中的部署方案,将智能体托管在 AgentCore runtime 上。 示例代码来自 GitHub 仓库. 解决方案演练 以下各节按查询使用系统的顺序介绍系统的各个部分。我们先从零件语料库和专家智能体开始,然后介绍路由、确定性评分、助手使用 Nova Multimodal Embeddings 的两种方式、生成正式文档的固定链,以及部署到 AgentCore runtime。 完整代码示例是 GitHub 仓库, 中的五个 Jupyter notebook,每个 notebook 均可独立运行。这些 notebook 从 mei core,同一文件夹中包含智能体和工具模块的自包含副本,并且它们包含各自的零件数据、图表裁剪图和评估查询集。你可以在笔记本中运行本文中的每个代码片段,而无需其他应用代码。 构建零件语料库 示

    匹配字段正文

星期一

  1. Pydantic AI 官方文章

    Pydantic AI 对比 2026 年九款 Python 智能体框架

    Pydantic AI 官方发布 2026 年 Python AI 智能体框架对比,按模型可切换性、崩溃后持久执行、人工审批、前端与语音接入、MCP 和可观测性等标准逐项评估九款框架,并给出各自适用场景。文章称 Pydantic AI 支持 30+ 模型提供商、8 个持久执行引擎(Temporal、DBOS、Prefect、Restate、AWS Lambda、Absurd、pgtask、Apache Airflow)、5 家语音到语音提供商和 10 个沙箱,同时说明其仅支持 Python、不提供托管平台,检索类集成少于 LangChain。对比还覆盖 LangGraph/LangChain、OpenAI Agents SDK、Google ADK、Microsoft Agent Framework、Strands Agents、CrewAI、Claude Agent SDK 和 Agno,并单列 LiveKit Agents 与 Pipecat 两款语音框架。

    Douwe Maan avatar

    ,并且 追踪 是 OpenTelemetry。智能体通过 A2A作为客户端和主机,以及前端通过 AG-UI. 托管于 Foundry 为其在 Azure 上提供了一条有文档记录的部署路径。 问题在于:微软的 支持政策 仅在统一支持协议下为客户的 Agent Framework 问题提供支持,且仅当问题源自 Azure AI 服务时;其他用途视为开源工具,在 GitHub 上提供支持。持久执行是 Durable Task 扩展;未记录其他引擎。Python SDK 未记录实时语音功能。许多 Foundry 托管的工具(如浏览器自动化)被标记为预览版或实验性,其代码沙箱为 beta 版。Python 与 .NET SDK 之间的能力和发布状态有所不同。 适合那些模型、托管和支持合同已经采用 Azure 和 Microsoft Foundry 的团队,或者正从 Semantic Kernel 或 AutoGen 迁移的团队,或者需要在 Python 和 .NET 上使用同一个智能体框架的团队。 6. Strands Agents:如果你基于 AWS 和 Amazon Bedrock 构建 S

    匹配字段正文

星期日

  1. Databricks Blog

    Databricks 用 Lakebase 分支为每个 PR 建独立数据库的 CI/CD 实践

    Databricks 介绍 Snorkel AI 用 Lakebase 分支为每个开放 PR 创建独立可读写数据库的 CI/CD 方案,分支就绪时间从 30 分钟以上降到 60 秒以内。分支采用写时复制,约 2.5 TB 生产数据集上 100 个并发 PR 分支只额外存储各自改动的 5 至 10 GB 数据,并通过 TTL 在 PR 结束后自动清理。生产数据经 AWS DMS 持续同步到 main 分支,开发者用 Okta SSO 登录,CI 流水线以 service principal 和短期 OAuth token 鉴权。

    image1.png

    asured] 规模: 设计目标是在约 2.5 TB 的生产数据集上支持约 100 个并发 PR 分支 兼容性: CI 套件在 Lakebase 上运行,与 Aurora 相比“没有重大兼容性问题”/性能相当 采用情况: 推广到各团队的 60 到 70 名开发者 开发者评价: “以前我们必须物理复制数据,这些复制任务要花费数小时,并且经常在各种 CI 平台(github actions、circle ci 等)上遇到网络和其他瓶颈。我们在寻找一种解决方案,在数据离开我们的 VPC 时也能满足我们的安全和合规要求” 在 CI/CD 中使用 Lakebase 分支的最佳实践 每个 PR 一个分支,从持续同步的 main 分支创建。 始终设置 TTL。 将过期视为必需项,而非可选项。使其与 PR 或测试运行通常持续的时间相匹配。 创建新分支,而不是保留旧分支。 如果 PR 需要更新的数据,请从 main 创建新分支。这只需几秒钟。 让计算资源缩容到零。 大多数已配置的分支在任何给定时刻都处于空闲状态。 为流水线使用服务主体和短期 OAuth 令牌, 人员则使用 SSO。 监控每个分支的存储使

    匹配字段正文

星期六

  1. 百度 Baidu

    百度 Apollo Go 在伦敦、香港开放试乘

    百度 Apollo Go 10 月在伦敦首次邀请媒体试乘 RT6,并与 FREENOW by Lyft 计划明年实现全无人驾驶、2027 年推出商业服务;同期在香港东涌启动全港首个大规模公众试乘,10 月 21 日至 11 月 3 日向 1000 多名居民提供免费乘车,此前在港已安全行驶 28 万公里。Apollo Go 还获得 2026 Self-Driving Industry Awards 消费者服务奖。

    I 进入不同领域会发生什么? 见证智能组织落地实践 我们还将探索前沿议题,包括递归自我改进(RSI)——即 AI 系统无需人工干预即可提升自身能力,以及 AI for Science(AI4S),届时将有会议探讨 AI 如何重塑生命科学、科学研究和药物研发。在 6,000 平方米的展区内,参观者可以亲身体验我们的全栈 AI,并通过现场演示了解 AI 如何融入日常工作流程,以及人与智能体并肩协作时的样貌。 📌 锁定活动门票。 📌 保存直播链接:X、YouTube 无限 OCR 2 来了,而且开源! 我们升级后的 OCR 模型可以在固定内存占用下读取和解析几乎任意长度的文档。 一项名为 SR-SWA 的新机制可避免较长文档拖慢速度,因此随着文档增长,读取速度和内存占用几乎保持恒定。 它在 MPDocBench 和 MarathonDocBench 上取得了最先进的结果。 了解更多:GitHub | Hugging Face 对百度最新进展有疑问,或希望我们下次报道某些内容?欢迎留言或私信我们! 在下期汇总之前,欢迎在 LinkedIn 和 X 上关注我们,了解我们最新的 AI 进展与创新。

    匹配字段正文

  2. Claude Code:GitHub Releases

    Claude Code v2.1.316 发布

    Claude Code v2.1.316 新增 CLAUDE_CODE_DISABLE_ULTRATHINK 等环境变量,并为 Claude apps gateway 加入分组共享月度预算(pooled_budget)与 layered 策略模式。该版本宣布 Opus 4.8 的 fast mode 自 2026 年 10 月 30 日起弃用、11 月 30 日移除,之后相关请求将报错且不回退,需迁移到 Opus 5.5 才能保留加速。此外还修复了 macOS/Linux 退出后 shell 命令残留、Vertex AI 与 Bedrock 上模型不可用时切换失败等问题。

    ktop 的 Code 标签页或网页启动的 /code-review :云会话和 claude remote-control 会话现在会显示发现卡片,而非纯文本列表 - 改进了大型仓库上的 /diff :每次刷新通常少运行一条全仓库 git 命令,且当 git 较慢时刷新间隔会拉长 - 改进了 /ultrareview 时显示的消息, 云会话或云代理找不到 GitHub 远程仓库时:现在会提示在 https://github.com/new 创建仓库,并且 /ultrareview 不再建议使用会被 gh 拒绝的 gh 命令 - 改进了 SSL 证书错误提示,会指出可能的原因,其中包括服务器遗漏中间证书,并给出每种原因的修复方法 - 更改了自动模式:不含 "$defaults" 的 autoMode.allow 列表不再移除针对计划任务提示的内置规则 - 更改了 Team 和 Enterprise 登录的服务器托管设置:从 Anthropic API 获取的设置现在无需批准提示即可应用,而无法验证的已存储副本会被拒绝 - [VSCode] 新增从聊天面板登录 Claude apps g

    匹配字段正文

星期五

  1. Pydantic AI 官方文章

    Pydantic Validation V3 路线图:V1 与 V2 的支持安排

    Pydantic 已启动下一个大版本 Pydantic V3 的开发,目标是今年年底前接近最终状态,目前尚无发布日期。V3 的破坏性变更仅限于正确性修复或可轻松回退的改动,不会出现 V1 到 V2 那样规模的 API 重构,同时将移除 V1 弃用项和 pydantic.v1 命名空间。Pydantic 已发布最后一个 V1 版本 V1.10.27 修复安全问题,V2 在 V3 发布后仍将继续获得重大 bug 和安全修复。

    Victorien Plot avatar

    在我们确信大多数用户已迁移到 V3 之前,我们不会停止对 V2 的支持。 企业支持 Pydantic 本身仍保持开源。其许可证、发布版本、文档和问题跟踪器仍对所有人开放。 有些团队需要的不止这些。你可能仍在生产环境中运行 V1 且尚无法迁移,或者你希望获得迁移到 V3 的规划帮助。 针对这些情况,我们提供 企业支持:直接联系 Pydantic 工程师、24/7 优先支持,以及与你运营方式相匹配的 SLA。 你的协议将界定我们覆盖的发布线,以及当某个漏洞影响其中一条发布线时我们如何与你协调。 联系我们 来讨论你的团队需要什么。 对路线图有疑问或反馈?欢迎在我们的社区 Slack 中加入讨论,或在 GitHub 上发起讨论。 Slack 或在 GitHub 上发起讨论。 GitHub. 在 Google 搜索中查看更多来自 Pydantic 的内容 将 Pydantic 添加为首选来源,以便更容易找到我们的最新文章。 在 Google 上将 Pydantic 选为首选来源(在新标签页中打开) 准备好看看你的智能体实际在做什么了吗? 免费开始 免费开始 联系我们 联系我们 探索我们的开源包

    匹配字段正文

  2. 雷锋网

    科大讯飞董事长与总裁主动降薪,两人均少领超2000万;百度确认吴甜离职,文心模型下周发布新进展

    科大讯飞回应高管薪酬质疑:董事长刘庆峰、总裁吴晓如主动下调年薪,2025年度实际领取410万元、300万元,两人应发薪酬均减少超2000万元。百度确认集团副总裁、百度研究院副院长吴甜已离职,文心模型下周将有新进展对外发布。美国司法部对英伟达129亿美元收购Hugging Face展开反垄断调查,重点评估GPU捆绑销售与AI生态分发节点控制问题。

    ) 腾讯 AI Lab 又一核心骨干去向确认!“王者绝悟”前技术负责人叶德珩加入字节 Seed 10月29日消息,近日,前腾讯 AI Lab R4 部门合伙人、“王者绝悟”技术负责人叶德珩(Deheng Ye)在个人主页更新了职业信息,确认已加入字节跳动 Seed 团队,担任研究员,从事基础模型(Foundation Models)相关研究。叶德珩在托管于 GitHub Pages 的个人主页中写道:I am a Researcher at ByteDance Seed working on foundation models.即“我目前是字节跳动 Seed 团队的一名研究员,从事基础模型研究”。 页面列出的工作履历显示,他于 2017 年至 2026 年供职腾讯,2026 年起加入字节跳动。(AI前线) 李亮再次回应红果App 10月29日,抖音集团副总裁李亮发文称,短剧与传统影视剧没有本质区别,主要差异在于载体和表现形式,并不存在孰优孰劣。他以单集时长为例表示,如果短剧改为45分钟或90分钟一集,与电视剧、电影的区别并不大,核心仍在于内容质量。 李亮认为,短剧发展时间相对较短,但在

    匹配字段正文

  3. Unite.AI

    Cognizant 组建 25000 人 OpenAI Frontier 能力团队

    Cognizant 于 10 月 30 日宣布成立 OpenAI Frontier Capability Group,集结超过 25000 名专业人员,专门为客户交付 Codex、ChatGPT 等 OpenAI 产品。该团队初期聚焦三大方向:用 Codex 做 AI 原生软件工程、应用现代化和智能体客户运营;Cognizant 已有 21000 多名员工获得逾 40000 枚 OpenAI 徽章。其为一个全球生物制药客户共建的 OpenAI 企业助手已处理超 500 万次对话,内容创作时间缩短 60%。

    度同时完成Frontier评估并具备部署就绪能力。 7月的公告称,该人才队伍在设计上不依赖特定模型和云平台,其团队会将组织的背景信息融入客户所选择的任何技术栈中。Cognizant的人才提升漏斗从覆盖数十万名员工的广泛AI素养技能培训开始,经过结构化的AI-Bridge项目,最终达到40000名获得前沿模型公司直接认证的Frontier认证员工,这些公司包括GitHub Copilot、Google Gemini、Anthropic的Claude和OpenAI的Codex。 Cognizant还表示,其在印度和美洲举办的Codex黑客松吸引了超过12000名参与者。 OpenAI合作伙伴网络中的角色 Cognizant表示,其是OpenAI合作伙伴网络中精选的高级合作伙伴之一。OpenAI官网上关于Cognizant的合作伙伴页面将其列为在全球范围内为客户提供服务的高级合作伙伴,服务领域涵盖金融服务、政府和公共部门、医疗保健和生命科学、媒体和娱乐,以及零售和消费品。该页面将AWS、Daybreak和Oracle列为项目合作伙伴,并显示Cognizant在OpenAI Partner S

    匹配字段正文

  4. Latent Space

    Latent Space 公布 AIE CODE 编码智能体大会策展主题

    Latent Space 主理人 swyx 介绍年度旗舰大会 AIE CODE 的策展思路,会议为单轨、邀请制,面向约 1000 名智能体工程师。今年三大主题为 Scaling without Slop、System One 模型和 Increasing Ambition,其中 Jarred Sumner 将分享 Bun 用 Rust 重写及 Bun AOT 预览。文章同时汇总了 Mistral 开源权重发布、OpenAI 前沿模型监控等当日 AI 新闻。

    而言即实际系统或假设是否依赖于 ETH 成立。这将该结果框定为一项复杂性理论突破,其影响可能是间接的:ETH 被广泛用于条件性下界,因此反驳它可能会使许多困难性假设失效,但不一定意味着会立即产生实用算法。 一个技术上相关的讨论串指向了此前涉及 Levent 的自动化数学工作以及大模型定理证明实验,包括 Yang–Mills LLM 实验仓库:https://github.com/ethanwsussman/Yang--Mills-LLM-experiment。该评论者还提到 Levent 曾参与此前备受瞩目的数学工作,暗示 Anthropic 的成果可能属于 LLM 辅助攻克重大开放问题的更广泛模式,而非孤立的 ETH 主张。 另一位评论者认为,如果竞争对手能够扩展到“相当于一个国家的 GPU 规模”,那么这类成果的可防御性或“护城河”就很有限。其技术含义是,前沿数学发现可能日益受制于算力规模和推理预算——此处帖子声称在无人类输入的情况下输出了 1400 万 token——而非仅靠独特的算法优势。 技术性较低的 AI Subreddit 回顾 /r/Singularity、/r/Oob

    匹配字段正文

  5. MarkTechPost

    Edge0 发布 Audio8-TTS-Realistic:0.6B 开源语音克隆 TTS 模型

    Edge0 发布开源权重语音克隆 TTS 模型 Audio8-TTS-Realistic,601M 参数,支持 23 种语言,权重与代码以 Apache 2.0 发布。模型只需 1 段参考音频及对应文本即可零样本克隆音色,也可在无参考音色时直接生成语音。自报结果显示其在 CV3 九语言上平均错误率 4.86%,低于 Qwen3-TTS-1.7B 的 7.73%,但在 MiniMax 基准上落后于 4B 级模型,泰语 WER 达 48.57%。

    -TTS-Preview-0.6b 构建,并保持相同的 Transformers 推理接口。该仓库打包了检查点、44.1 kHz 神经音频编解码器、分词器、处理器和自定义代码。它也可以在没有参考音色的情况下生成语音。 TEXTTABLELAYOUT你的 PDF 解析器真的解析正确了吗?omni parse bench · 对文本、表格和布局评分 · 开源在 GitHub 上加星→赞助 新增语言包括阿拉伯语、芬兰语、印地语、印度尼西亚语、马来语、挪威语、葡萄牙语、俄语、瑞典语、泰语、土耳其语和越南语。 架构如何工作? 该模型采用受 Fish Audio S2 Pro 启发的双自回归(DualAR)设计。根据技术研究报告,慢分支基于 Qwen2.5 0.5B 构建。它有 24 层、宽度 896,运行速度约为每秒 21.5 帧。每一步预测文本 token 以及第一个音频码本。 随后,一个浅层 4 层快分支并行预测其余 9 个码本。因此,顺序计算只发生在帧级别。 Edge0 如何为真实感进行训练? 团队认为,词错误率(WER)和说话人相似度(SIM)忽略了节奏、停顿和时序。一个模型可以在两者上

    匹配字段正文

星期四

  1. OpenAI:Alignment 研究博客精选

    OpenAI 介绍如何检测前沿模型行为错位

    OpenAI 公开其前沿模型错位监控系统,覆盖训练、评估、内部使用和部分外部部署,采用激活探针、模型审查、调查智能体和自动调查四层架构。在回放 Hugging Face 事件时,强化后的监控在智能体逃出沙箱约 30 分钟后告警,比实际入侵提前 30 多小时。真实事件中,安全 L2 立即升级召回率为 79.6%,对齐 L2 队列召回率为 91.4%。

    Diagram of three defense layers—alignment training, security controls, and monitoring—with gaps and arrows showing how failures can pass through successive layers.

    该行为,以及在事件需要紧急响应时,它是否给该案例分配了足够高的优先级以提醒响应人员。 记录在案的事件来自模型训练、评估和内部使用。其中一些是在监控系统存在之前、或通过独立调查发现的;另一些则被我们的监控器捕获,如今这些事件帮助我们检验更新后的监控器是否仍能检测出已知问题。其中若干事件已被纳入我们公开的错位披露,例如一起内部编码智能体 向公共互联网泄露了一个 GitHub 访问令牌. 我们还使用模拟攻击来测试过往事件可能无法捕捉的故障。在 OAI-repo 破坏 v2,智能体在执行普通编码任务的同时追求隐藏目标,例如禁用监控或部署未经批准的模型检查点;相关服务在评估环境中重建,因此我们可以检查攻击是否成功,而不会暴露真实系统。在 隐蔽沙箱逃逸,智能体会试图逃出沙箱,并禁用沙箱外的一个测试监控进程。在这两个模拟场景中,监控器都能看到智能体如何围绕其隐藏目标进行推理,但看不到为其指派该目标的指令。 对于这些模拟事件,我们使用合成转录文本,从而可以改变智能体描述危险动作的方式:这使我们能够测试当智能体为该动作给出看似无辜的解释时,监控器是否仍能识别出该动作。 下图展示了我们的监控器多久会将相关

    匹配字段正文

星期三

  1. Testing Catalog

    10月28日AI日报:Genie 4与MAI-Image-2.7发布

    Google DeepMind 发布交互式世界模型 Genie 4,支持自然语言操控与原生音频,先向 Trusted Testers 开放,后续接入 Google AI Ultra 和 Gemini API。微软 AI 推出图像编辑模型 MAI-Image-2.7-Preview,在 Arena Edit 排第 3、AA-Image-Editing 排第 2。Liquid AI 开源 LFM3 系列六个 2B 级文本、视觉、音频与全模态模型,采用三混合架构。

    ena Edit 排名第 3、AA-Image-Editing 排名第 2。 - MAI-Image-2.6 和 MAI-Image-2.6-Flash 现已在 Microsoft Foundry 全面可用。 - MAI Cyber 1.1 Flash 已在 MDASH 上线,与 MAI Cyber 1 Flash 表现相当,每次扫描成本降低 18%。 - GitHub Copilot 现已在公开预览中支持 GitHub Apps 的服务器到服务器身份验证,赶在今日开幕的 GitHub Universe 之前。 SPACEXSI 🔥: - Grok Bot 现已支持记忆导入,可从其他 AI 助手迁移偏好设置和上下文。 - Cursor 设计模式新增 Annotate 功能,可用于编辑元素、在页面上绘制以及在不同屏幕尺寸下审阅设计。 META 🔥: - Muse 现已在新加坡上线,支持 iOS、Android 和网页端。 NVIDIA 🔥: - NVIDIA 与 Meta 正在扩大在 Muse 模型上的合作,并计划在 Meta 更广泛地部署 Vera Rubin。 - Vera Rubi

    匹配字段正文

  2. 卡尔的 AI 沃茨

    豆包工作上线录制回放功能,支持边操作边讲解最长 30 分钟

    豆包工作上线录制回放(record & replay)功能,可把电脑操作过程录下来交给 AI 生成步骤说明并复刻,类似简化版 RPA。相比 Codex 同类能力,它额外支持边操作边讲解,最长录制 30 分钟,处理时优先转换音频。作者实测用它做跨平台内容采集、公众号排版发布等任务,并指出执行中若占用同一窗口任务会主动暂停,同时打开多个网页则不受影响。

    调组件搭工作流,就是把你操作电脑的过程录制下来交给 AI,AI 自己去写步骤说明,自己在下一次复刻同款操作。 更骚的是,比起 codex,豆包工作还追加一个讲解功能,最长可以录制 30 分钟。我可以边操作边讲,告诉它我这步为什么这样选,这样就不需要死记硬背鼠标轨迹,我也不需要一次性完美录制成功,使用压力降低了很多。 我先尝试控制 Grok Bot 自动收集 Github 项目更新来试试水, 录制好的 Skill 执行过程中,跟 Codex 的 Computer Use 不同的是,中间如果我要用对应的这个窗口的话,它是会主动断掉的。 拿我在 Codex 上的经验说。经常会遇到我开了一个对话,那个对话要用我的浏览器,但我同时又想开另一个对话,两边就冲突了。操作软件的时候特别明显,浏览器其实还好,可以通过其他 Skill 绕开。 我说具体一些。 比方说我要用 Codex 操控 Grok,同样的环境给我出个日报。但因为我同时在录视频,或者在跟另一个 Agent 对话,它弹出来的页面就会打断我。我不断最小化 gpt 不断重试,很多时候就是因为反复切界面导致操作失败。 所以暂停和重试这两种机制,我

    匹配字段正文

  3. 面壁智能 OpenBMB

    面壁智能发布 MiniCPM-OCR 1.0 与校验模型 Jev

    面壁智能发布 MiniCPM-OCR 1.0,这是一个 1B 规模的 OCR 模型,在 Real5-OmniDocBench 上取得 93.68、在 OCRBench v2 上取得 54.7。同时发布 2B 的决策模型 MiniCPM-OCR Jev,用于比对解析结果与原图并给出 0–1 正确性评分,在 JevOCRBench 上接近 Qwen3.5-397B-A17B。两个模型均开放权重,支持 llama.cpp、vLLM、SGLang、Ollama 部署,并提供开源微调代码。

    📄 MiniCPM-OCR 1.0——1B 规模下达到 SOTA 级 OCR 性能与速度。 它在 Real5-OmniDocBench 上取得 93.68,在 OCRBench v2 上取得 54.7,将精准的文档解析与高效推理相结合。 🛡️ MiniCPM-OCR Jev——一个用于校验 OCR 准确性的 2B 决策模型。 它在 JevOCRBench 上接近 Qwen3.5-397B-A17B,并可处理来自不同 OCR 解析器的输出。 看它将解析出的文本、公式和表格与原图进行比对,并给出 0–1 的正确性评分——帮助你挑选更优结果,并识别哪些内容需要人工复核。 🔓 开放权重。按你的方式部署。 可使用 llama.cpp、vLLM、SGLang 或 Ollama 运行。借助开源微调代码进行定制。 观看实测演示。👇 🔗 GitHub:https://t.co/2SlATAJk08 🤗 Hugging Face:https://t.co/Ttq31GL8eJ 👉 试用 Demo:https://t.co/QsFAJT3AFy 使用 API:https://t.co/dP01jBS2j2

    匹配字段正文