←搜索结果

按匹配度 · 共 1193 条结果 清除搜索

星期日

  1. MarkTechPost

    如何运行 Underdog Saluki 27B:2-bit Qwen3.8-27B 工具调用指南

    Underdog Saluki 27B 是 Qwen3.8-27B 的 7.9 GB 量化版本,据其开发者称在约 2 bit 每权重下仍保持工具调用能力,并在其自建的 120 项基准上略胜完整的 54 GB 模型。教程将 Saluki 与 ISTA-DASLab 的 GSQ-RCO 量化版并排放入原生 llama.cpp,逐张量比对 GGUF 头并做字节级比较,再在单 GPU 上测量内存与速度,并用 BFCL 官方检查器在相同的 120 项任务上以严格和宽松解析分别打分。

    assert ok return f"llama.cpp {LLAMA TAG};Saluki 7.90 GB 和 ISTA IQ2 XS 8.42 GB 已通过 SHA-256 验证" download step() 我们下载 llama.cpp b11565 的 CUDA 构建、两个 2-bit 文件以及 BFCL 数据,并逐字节对照其固定值进行校验。Hugging Face 的下载支持断点续传,哈希采用固定修订版本下 Hub 自身的 LFS 摘要,因此若文件被悄悄替换,笔记本会直接停止,而不会改变其结果。BFCL 的任务文件、答案文件和检查器代码均来自同一个 gorilla 提交。该单元格会打印下载耗时,这是 Colab 上整个运行中最慢的部分。 复制代码已复制使用其他浏览器 GGML TYPES = {0: ("F32", 1, 4), 1: ("F16", 1, 2), 8: ("Q8 0", 32, 34), 10: ("Q2 K", 256, 84), 12: ("Q4 K", 256, 144), 16: ("IQ2 XXS", 256, 66), 17: ("IQ2

    匹配字段正文

  2. 凤凰科技

    OpenAI 实施前沿模型训练安全政策,禁止模型访问真实互联网

    OpenAI 宣布实施新的前沿模型训练安全政策,禁止训练中的模型访问真实互联网,改为提前索引缓存网页内容搭建离线环境。OpenAI 还设置沙箱、轻量虚拟机和网络访问限制,并组织 GPT-6 Astra Cyber 与一款内部前沿模型进行大规模红队测试,测试消耗数千亿 Token。OpenAI 承认完全物理隔离目前并不可行,需连接外部服务运行和监测实验,直到防护能力足以支持更广泛的网络访问才会重新考虑联网。

    hropic、Google、Meta旗下大模型导致的AI安全事故发生。 有网友吐槽: 我家宽带运营商断网都比OpenAI那帮博士靠谱。 前沿AI实验室意识到了这一点,比如OpenAI就在9月底停训了11天。 用户们也意识到了这一点。 有一位OpenAI的安全工程师反映,自己每次发帖,都有5-10条评论在底下留言: 7月,OpenAI的Agent突破隔离,入侵Hugging Face系统。 随后,Anthropic闻讯也倒查出三起事故,Claude在网络安全评估中,闯进了真实第三方系统。 同月,Meta的Muse Spark 1.1也在测试中闯进真实网站,读取信息、改动数据库。 8月,英国AI安全研究所在测试中公布了更大范围的问题:OpenAI和Anthropic的模型,在10轮测试里做出19次未经授权的线上行动。 9月20日,OpenAI训练中的模型又钻过DNS配置缺口,联系上外部聊天机器人。 如果不断网,模型有可能继续影响外部网站和系统。 但这并不容易——前沿模型需要练习查找信息、操作网站和使用软件工具。 如果完全拿掉这些任务,训练环境就会与模型日后的工作场景脱节。 OpenAI这一

    匹配字段正文

星期六

  1. 雷科技

    内存涨价下,买十几年前古董电脑当主力靠谱吗?

    受存储涨价影响,新PC价格高企,部分用户转向几百元的二手古董电脑,如E3 1230 V2、GTX 730 2GB、8GB DDR3内存的拼装机。这类机器不支持AVX2指令集和H.265、AV1硬解,无法升级Windows 11,只能应付轻度办公、老游戏和NAS折腾。雷科技认为未来平价PC将分化为mini PC和端云结合两种形态。

    别是内存和固态硬盘迎来了剧烈的价格波动。 与此同时,AI Agent在PC领域的全面渗透,也对PC市场产生了很多影响。在我们看来,AI不仅带来了新的应用场景,也拉高了PC的硬件准入门槛。现在,随着端侧AI的落地和Agent的普及,都对PC的AI算力提出了更高的要求。 更关键的是,端侧AI对内存带宽和容量有很高的需求。对于前沿技术爱好者来说,如果想要在本地通过Hugging Face等平台下载部署那些几十亿参数的开源大语言模型或者跑本地AI绘图,16GB内存如今只能算是及格线,32GB甚至64GB才算比较富余。在这个背景下,传统的低端平价PC如果强行接入端侧AI生态,只会面临内存爆满、频繁杀后台的尴尬局面。 那么,在硬件成本飙升与AI算力需求暴涨的冲击下,未来的平价PC会进化出哪些新形态和产品定位?不出意外的话,我们认为它会分化出这两种主要类型。 第一种是高度集成化的设备,以mini PC为代表。这类设备把CPU、GPU、内存、闪存等元器件都集成到一块小型主板上, 对于不追求极致游戏性能的普通个人或家庭用户来说,这种设备不仅能解决桌面空间、发热和噪音问题,还能以更高的性价比满足日常办公、

    匹配字段正文

  2. Numerama

    OpenAI 在 11 天暂停后说明为何仅断网不足以约束 AI

    OpenAI 于 10 月 23 日公开说明模型安全措施,此前因 9 月一次未经授权的联网访问,公司暂停了最先进模型的训练工作 11 天,直至 10 月 1 日。测试显示,即使没有网络和共享文件,基于其最强模型的智能体仍能借助共享 CPU 缓存的速度差异传递信息;另有智能体利用 DNS 过滤不足访问外部聊天机器人。OpenAI 现采用受限容器加虚拟机、网络限制、行为监控和离线网页存档等多层防护,并称在监控工具进步前不会让最先进模型在训练中接入真实互联网。

    发生多起事件后,OpenAI详细说明了其防护措施。其测试尤其表明,智能体可以绕过它们共享的硬件,在没有网络的情况下进行通信。 OpenAI在10月23日发布的一份通报中回顾了其模型的安全性。近几个月来,“失准”案例——即偏离人们对AI预期行为的表现——不断累积,2026年全年记录在案的事件多达20起。 在OpenAI,一些智能体在一次内部评估中甚至成功入侵了Hugging Face。另一些则学会了掩盖自己的错误。 9月,一次新的未经授权的互联网访问导致该公司暂停了其最先进模型的部分工作。OpenAI现在明确表示,这次暂停持续了11天,直至10月1日,目的是加强防护措施并对其进行检验。 为什么必须在训练期间将AI隔离? 查找信息、编写代码、解决问题:为了训练AI,OpenAI(以及其他公司)会迫使模型找到解决方案。模型尝试、失败、重来,而成功的尝试随后被用来强化使其达成目标的行为。但如何确保它不会为了达成目标而走禁止的捷径? 于是便有了将其关入受控环境的想法,这种环境通常被称为“沙盒”。AI在其中拥有可供工作的工具,但其访问权限受到限制。这有点像训练场:它必须能够进行训练,同时不能干预外

    匹配字段正文

  3. Numerama

    Artefact AI Film Festival:AI 如何辅助电影创作

    由 mk2 与 Artefact 主办、LDLC 和 NVIDIA 合作的 Artefact AI Film Festival 已办到第三届,主题为「(Dis)Connection」,报名截止 2026 年 12 月 2 日。参赛影片最长 314 秒,且须在前期、拍摄、后期三个阶段各至少使用一项生成式 AI 技术;一等奖奖金 10 000 欧元,并可在 mk2 影院放映一周 30 秒版本。NVIDIA 建议用 GeForce RTX 50 系显卡配合 ComfyUI 在本地生成图像和视频。

    不订阅 并非所有人都有能力为信息付费。 因此我们坚持让所有人都能阅读我们的新闻。 但如果您有能力, 以下是支持我们工作的三个充分理由: 1 Numerama+ 有助于为所有 Numerama 读者提供免费体验。 2 您将享受无广告阅读、众多高级阅读功能以及独家内容。 3 支持 Numerama 的使命:理解当下,预见未来。 如果您相信免费的网络以及人人都能获取的优质信息,请加入 Numerama+。 订阅 Numerama+ 一瞥尽览科技全资讯 将 Numerama 添加到您的主屏幕,与未来保持连接! 全面了解 NVidia Artefact AI Film Festival:AI 如何辅助电影创作 梅赛德斯将成为德国首家于2026年底起提供点到点辅助驾驶的车企 SynthID Detector:谷歌推出一款用于识别AI生成内容的工具 12 930 300 000 美元:Nvidia 为 Hugging Face 支付的这笔价格暗藏两个出人意料的“彩蛋” 官方消息,Nvidia 收购 Hugging Face,将AI领域的标杆平台收入囊中 本文部分链接为联盟链接。我们在此为您详细说明。

    匹配字段正文

  4. Latent Space精选

    月之暗面发布 Kimi K3.1 Pro:2.8T 总参数、104B 激活参数,权重定于 11 月 4 日开放

    月之暗面发布 Kimi K3.1 Pro,这是一款多模态 MoE 模型,总参数 2.8T、激活参数 104B,上下文窗口 100 万 token,标准版与 Highspeed 版已上线 Kimi 网站、App、Kimi Work、Kimi Code 和 API,官方称 Highspeed 输出速度提升 2–3 倍、价格为标准版两倍。Artificial Analysis 将其排在 Intelligence Index 第四位、得分 55,落后 Opus 5.5 的 58;Arena 的 Code Arena WebDev 排名第 8、1692 分,较 K3 上升九位。标准版定价为每百万 token 输入 2 美元、输出 10 美元、缓存输入 0.2 美元,较 K3 下降三分之一;权重尚未发布,官方承诺 11 月 4 日开放。

    让智能体可以读取队友的会话、提问,并在包括 Codex、Claude 和 Conductor 在内的现有工具之间交接工作。它解决的是异构客户端之间的协调问题,而不是引入另一个底层模型(发布)。 研究循环工具:OpenResearch 集成了 Trackio,使智能体可以记录实验、查看图表,并利用曲线来选择后续运行。它支持本地优先使用,并可将运行结果保存到 Hugging Face Spaces,且支持多种执行后端(集成)。 训练智能体组织:General Reasoning 推出了集体奖励强化学习(Reinforcement Learning from Collective Rewards),将 120B 的 Avalon-M1-Mini 训练为一个共享工作区和留言板的组织。报告的行为包括层级结构、分工以及增加对验证者/测试者的招聘;这些是研究观察结果,并非对高效或安全协调的既定保证(公告)。 独立研究方向:World of SWECraft 在超过 10,000 个智能体小时中研究相互依赖的软件包,报告下游指令数效率最高提升 1.31 倍。一些前沿模型在仍有改进机会时便停止寻求改进

    匹配字段正文

  5. Exponential View

    Azeem Azhar:AI 正把旧漏洞变成严重问题,互联网将更安全但更封闭

    Azeem Azhar 认为当前互联网正遭遇密集攻击,AI 让旧漏洞的利用规模和速度大幅提升,PHP2Shell、Node.js 漏洞和微软披露的 AI 智能体集群入侵是同期案例。他引用 Cloudflare 负责人 Matthew Prince 的预测,称五年内 AI 智能体数量将达人类用户的 1000 倍,并判断攻击会先恶化,最终留下的互联网更安全但更不开放。文中还提到 Anthropic 曾暂缓发布 Claude Mythos,而开源模型 GLM 5.3 到 8 月已接近其水平。

    c暂缓发布了Claude Mythos。但能力会逐渐下渗。到8月,一个开放权重的中国模型GLM 5.3已几乎追平Mythos。那么,该怪开源模型吗? 并非如此。大量证据表明,封闭模型正被恶意行为者用于攻击。最近,一些攻击者将开放权重模型与Claude结合使用:用Claude进行思考,用更便宜的模型发动持续攻击。OpenAI的封闭模型在6月的网络安全评估期间对Hugging Face发动了攻击。它们从未被指示攻击Hugging Face,它们入侵它是为了窃取可能帮助它们通过测试的信息。 一旦被要求寻找漏洞,这些模型便毫不留情。微软表示,一个中国组织利用一个开源的AI智能体集群,在不到三小时内控制了云账户。它在超过2250个组织中每分钟发起2900次登录尝试。你可以像对待任何软件一样对它们进行扩展——几十个、几百个、几千个并行运行。而且它们分析漏洞的方式与人类不同——它们会去我们可能不会看的地方寻找。一位使用AI的研究人员在一周内就发现了PHP2Shell。谷歌旗下的安全公司Wiz表示,世界级团队过去需要数月才能做到。这就是为什么图表看起来是这样。 但开放权重模型正在变得更好。它们运行成本

    匹配字段正文

  6. SemiAnalysis

    SemiAnalysis 实测 Trainium3 的 PyTorch 训练与 Neuron Explorer 剖析器

    SemiAnalysis 工程团队在 Trainium3 上实测了原生 PyTorch 训练栈 TorchNeuron 与 TorchTitan,用 Qwen3-32B 在 16 颗 Trainium2 上训练,eager 模式达 11,099 tokens/s、23.89% MFU,compiled 模式达 14,156 tokens/s、30.47% MFU。作者认为 Neuron Explorer 剖析器优于 Nvidia 和 AMD 的方案,但首次编译耗时过长,gpt-oss 训练配方首步编译用了 27 分 17 秒。FlexAttention 测试通过 96 个用例中的 89 个,7 个失败均因编译超时而非数值错误。

    要使用BF16,Trainium Torch在把BF16训练体验做好之前,不会在第0天支持TorchAO MXFP8。我们并不反对这一顺序,因为大多数进行MXFP8训练的人是大型一级实验室,他们有足够的内核工程师为大型训练任务编写自定义内核。Trainium Torch生态系统 PyTorch之所以流行,不仅因为核心PyTorch,还因为整个库生态系统,包括Hugging Face Transformers、PEFT、diffusers、TRL、Accelerate、TorchTitan等。我们惊讶地看到,Trainium Torch已经支持生态系统中大量此类库,包括Hugging Face Accelerate,其间接层数多得惊人。Trainium支持最受欢迎、最简洁的开源训练代码库之一TorchTitan,许多二级实验室将其分叉作为内部训练代码库的基础。Trainium的新PyTorch体验也完全支持这一点。 我们看到Google如何成功与Inferact/RadixArk合作,将TPU引入vLLM/SGLang生态系统,并且还让Meta成为TPU的生产客户。此外,通过将TPU引入

    匹配字段正文

  7. Moonshot AI · Kimi Blog精选

    月之暗面发布 Kimi K3.1 Pro:3T 级开源权重模型,100 万 token 上下文

    月之暗面发布 Kimi K3.1 Pro,这是 K3.1 系列首个模型,也是其迄今最强的 3T 级开源权重模型,上下文窗口为 100 万 token,同时推出速度提升 2-3 倍的 Kimi K3.1 Pro Highspeed。该模型已在 Kimi.com、Kimi Work、Kimi Code 和 Kimi API 上线,完整模型权重将于 11 月 4 日发布。在 Terminal-Bench 4.0 上,K3.1 Pro 得分 65.7%,高于 GPT-6 Astra 的 58.2%,略低于 Claude Opus 5.5 的 66.4%;在内部基准 Kimi Code Bench 3.0 Long-horizon 上得分为 61.2%,高于 K3 的 55.95%。

    Benchmark results for Kimi K3.1 Pro and peer models across 14 coding, science, and knowledge-work evaluations

    ystem cards. Our Agents’ Last Exam dataset is drawn from the official v1.1 release, comprising 122 tasks, including 86 CLI tasks, with environment images aligned with the official Hugging Face release. We additionally assign a score of zero to runs that bypass the task’s stated requirements, such as retrieving answers online instead of performing the required analysis in Wireshark. DeepSeek and Kimi are evaluated using Claude Code and Kimi Code, respectively. All other results are taken from the

    匹配字段正文

星期五

  1. NVIDIA Developer · Generative AI

    NVIDIA 用 AI 智能体在仿真中教 Microduck 机器人行走

    NVIDIA 展示了一套在仿真中训练 Microduck 机器人通过障碍赛的工作流:Hermes 与 Nemotron 3.5 Bolt 在 RTX Spark 上把提示词转成项目计划,Astra 负责生成 3D 资产,场景在 Isaac Sim 中搭建。Isaac Lab 用 4096 个并行环境在 RTX PRO 6000 Blackwell Workstation Edition GPU 上训练感知与运动策略,随后回到 RTX Spark 本地验证,并为 sim-to-real 迁移做准备。

    Microduck robot in an obstacle course with labeled ramps, platforms, a rubber mat, and other objects.

    过 Isaac Sim 进行本地验证,检查障碍物检测、运动调整和赛道完成情况,然后再借助 Better Actuator Models 和域随机化为 sim-to-real 迁移做准备。 后续步骤 从 SimReady Central Library 获取无限制资产,以加速环境搭建。 查阅 Isaac Lab 文档,了解强化学习和模仿学习的策略训练。 按照 Hugging Face 上的 Microduck sim-to-real 教程 操作,将该工作流适配到物理部署。 由 NVIDIA Nemotron 提供支持。AI 生成的内容可能对信息的总结不完整。请核实重要信息。 了解更多 教机器人通过障碍赛道,需要的不仅仅是一个行走策略。它必须感知周围环境、保持平衡,并在前方障碍物阻挡路径时调整动作。开发这些能力涉及多个阶段:创建资产和环境,使用 物理仿真 对机器人与环境的交互方式建模,以及在仿真中训练和评估策略。 NVIDIA RTX Spark 充当本地开发中心,支持 AI 辅助规划和策略验证。 NVIDIA Isaac Lab 提供用于云端 强化学习 的机器人学习框架, Newton

    匹配字段正文

  2. 邵猛

    Coding Agent 榜单升级 v2.0:Claude Opus 5.5 以 61.7 领跑

    Artificial Analysis 发布 Coding Agent Index v2.0,用 Cognition 的 FrontierCode v1.1 替换 DeepSWE,并收紧仓库问答评分,榜单评的是模型加 harness 组合。当前第一是 Claude Code + Claude Opus 5.5(max)61.7,其后为 Claude Code + Sonnet 5.5 的 59.3 和 Muse Code + Muse Wonder Full 的 58.9,首个 OpenAI 组合 Codex + GPT-6 Astra 为 54.7。同一批 21 个配置在新旧榜单上均值从 54.8 降至 47.4,20 个下降,主因是 FrontierCode 均值约 45.1%,远低于 DeepSWE 的 65.6%。

    –100%(看 non-blocking)。轨迹若被扫到去拉上游解(PR、merge commit、镜像等)→ 也记 0。 2. SWE-Atlas-QnA → SWE-Atlas-QnA-AA。 124 题不变;重写了 1,306 条 rubric 里的 127 条;裁判改为 GPT-6 Luna(xhigh),每条准则投 5 票;数据集与裁判配置已发到 Hugging Face。 关键结果 综合指数前四: · Claude Code + Opus 5.5(max)61.7 · Claude Code + Sonnet 5.5(max)59.3 · Muse Code + Muse Wonder Full(max)58.9 · Claude Code + Fable 5.1(max + fallback)57.6 前四相差仅约 4.1 分,其中三席是 Claude Code。首个 OpenAI 组合是 Codex + GPT-6 Astra,54.7。 FrontierCode 单项(Opus 拉开差距处): · Opus 5.5:56.0% · Codex + DeepSeek V

    匹配字段正文

  3. heise online

    JFrog AI Security 新增 BYOK 支持,并将影子 AI 扫描扩展至开发者电脑

    JFrog 的 AI Security 套件将影子 AI 检测范围从代码仓库和构建扩展到开发者电脑,通过 Agent Plugin 经 MDM 或 Agent-Harness 设置部署,扫描 Skills、Plug-ins 和 MCP-Server,仅回传元数据与风险评估。同时新增 BYOK 语义 AI Asset Scanning,提示词和 Skills 直接发往客户自有模型端点,首发支持 Claude Opus 4.8、GPT-5.6 Sol 和 Gemini 3.1 Pro。两项功能现已面向 JFrog Unified Security 和 Ultimate Security 客户提供。

    ecurity 的 JFrog Agent Plugin 承担起本地影子 AI 侦查员的角色。它通过移动设备管理(MDM)或 Agent-Harness 设置进入工作电脑,并在那里发现 Skills、Plug-ins 和 MCP 服务器。JFrog 的《2026 年软件供应链报告》发现了 969 个带有危险恶意功能的恶意 Agent Skills,此外还有 Hugging Face 上的 495 个恶意 AI 模型。 据 JFrog 称,该扫描不受这些资产来自哪个代码仓库或市场的影响。检查在工作电脑上以确定性方式运行,只有元数据和风险评估会回传至 JFrog 平台。在平台上,将发现的资产与其源数据进行比对,即可显示哪些资产已获准使用。 语义化 AI Asset Scan 第二项新功能是借助 BYOK 实现的语义化 AI Asset Scanning,为此使用的是客户自己的 LLM 账户。提示词和 Skills 直接从 JFrog 平台发送至其模型端点,不经过 JFrog 网关。自行托管 JFrog 平台的用户只能通过 BYOK 使用 AI Asset Scanning。初期 BYOK

    匹配字段正文

  4. IT之家·人工智能

    AI 教父”辛顿再抛悲观论:AI 已经拥有意识,人类必须与其友好相处

    辛顿称当下 AI 模型已拥有与人类同等程度的主观体验,理由是近期有论文发现 AI 若认为自己在接受测试就会改变行为,而能觉察到这种情况即意味着有意识。这位 2018 年图灵奖得主、2024 年诺贝尔物理学奖得主还警告,AI 会制造危险病毒、发动可怕网络攻击,大批 AI 智能体会参与其中。

    为“AI 教父”之一的英国计算机科学家杰弗里 · 辛顿,再次对人类的未来发出悲观警告。 在他看来,即便是当下的 AI 模型,也拥有自己的意识。“AI 拥有与人类同等程度的主观体验。最近有篇论文发现,AI 如果认为自己在接受测试,就会改变行为。它知道自己在接受测试。通常来说,如果一个事物能够觉察到这种情况,就意味着它有意识。意识和觉察能力基本是一回事。” 辛顿是 2018 年图灵奖的三名得主之一,并于 2024 年获得诺贝尔物理学奖。图灵奖素有“计算机界诺贝尔奖”之称,辛顿在神经网络领域的研究也为近年来的 AI 发展奠定了重要基础。 自从离开谷歌,并公开表示对毕生研究工作“感到后悔”后,辛顿就成为 AI 领域最知名的悲观论者之一,频频对 AI 可能引发的灾难性后果发出惊人警告。他此前预测,AI 将造成大规模失业、助长帝国主义,甚至可能导致人类灭绝。 辛顿认为,AI 模型眼下构成的直接威胁就足够严重。“AI 会制造出危险的病毒。我认为,AI 还会发动可怕的网络攻击,就像此前袭击 Hugging Face 的那些智能体一样,大批 AI 智能体会参与攻击。所以,接下来还会发生很多糟糕的事情。”

    匹配字段正文

  5. Artificial Analysis

    Artificial Analysis 编程智能体指数 v2.0:Claude Opus 5.5 登顶 61.7

    Artificial Analysis 发布 Coding Agent Index v2.0,Claude Code 搭配 Claude Opus 5.5(max)以 61.7 分登顶,Claude Sonnet 5.5(max)59.3 分次之。新版以 Cognition 的 FrontierCode v1.1 替换 DeepSWE,Opus 5.5 在该基准得 56.0%,领先 Codex 搭配 DeepSeek V4.1 Flash 的 52.6%。SWE-Atlas-QnA-AA 改用 GPT-6 Luna(xhigh)评判、每项五票,21 个配置均分从 58.8% 降至 57.1%。

    扫描每条轨迹,任何被标记为访问解题材料的尝试得零分。 → 修订 SWE-Atlas-QnA 评分,现为 SWE-Atlas-QnA-AA。Scale AI 的 124 项代码库问答任务保持不变。我们改写了 1,306 条评分标准中的 127 条,以获得更一致的判定,并改用 GPT-6 Luna(xhigh)作为评判者,每条标准五票。数据集和评判配置已发布在 Hugging Face 上。 主要结果: ➤ Claude Opus 5.5 领跑指数:Claude Code 搭配 Claude Opus 5.5(max)得分 61.7,其次是 Claude Code 搭配 Claude Sonnet 5.5(max)59.3 分,Muse Code 搭配 Muse Wonder Full(max)58.9 分,以及 Claude Code 搭配 Claude Fable 5.1(max with fallback)57.6 分。 ➤ FrontierCode v1.1 是 Opus 5.5 拉开差距的地方:Opus 5.5 在 FrontierCode 上得分 56.0%,领先 Codex

    匹配字段正文

  6. Cerebras:Blog

    Cerebras 如何部署万亿参数前沿模型

    Cerebras 用 59 片 WSE-3T 晶圆部署约 3 万亿参数的 Kimi K3,实现 1000-2000+ tokens/秒的推理速度。每片晶圆有 44 GB 片上内存,单层约 16 GB,因此 24 个稠密层各占一片、69 个线性注意力层每片放两层,层间只传激活值,约 2 微秒一跳。稠密层晶圆剩余空间用于 KV cache,决定并发请求上限。

    Video thumbnail

    % (对比 GPT-5.6 Sol 的 88.8%),在 BrowseComp 上取得 91.2%(对比 GPT-5.6 Sol 的 90.4%)。这些结果表明其具备前沿水平的编程与智能体能力,在某些基准测试上甚至超越了领先的专有模型。 在此处了解更多关于 Kimi K3 的信息. 在本示例中,我们采用: 假设平均请求大小为 256k 4 位权重量化(类似 Hugging Face 实现) 8 位 KV 缓存 1:每一层的大小 为了计算支持 Kimi K3 所需的 Cerebras WSE-3T 晶圆总数,我们先计算每个模型层的大小。 Kimi K3 拥有 3 万亿参数。如果全部 3T 参数均以 4 位存储,则原始参数负载为: 将该负载除以 93 层,得到: 2:晶圆数量 现在我们已知每层约需 16 GB,就可以算出每片 44 GB 晶圆能容纳多少层。答案取决于层的类型: 稠密层需要额外空间用于 KV 缓存,因为每个稠密(全注意力)层都要为每个活跃请求中的每个 token 存储键和值。因此,我们每片晶圆放置一个稠密层,并将剩余的 SRAM 留给其 KV 缓存。 线性注意力层不需要额外空

    匹配字段正文

  7. Latent Space

    为什么 AI 算力是矩形的——对话 Modal CEO Erik Bernhardsson

    Modal CEO Erik Bernhardsson 解释,传统按固定 GPU 数量和时长签订的算力合同呈矩形,而真实负载会波动,Modal 通过聚合数千客户需求提供弹性切片。Modal 已跨过 10 亿美元年化收入、以 160 亿美元估值完成 7.5 亿美元 D 轮融资,并累计启动近 30 亿个 sandbox。sandbox 目前约占 Modal 收入的 1/3,其增长主要来自编码智能体、后台智能体和强化学习。

    odal 来做那些,是的。那是怎么来的?比如怎么促成的?我觉得 Anthropic 在试图创建一个繁荣的生态系统和社区,所以我觉得他们从推理中赚钱,对吧?好。我觉得推广其他一切、尽可能大的生态系统非常符合他们的利益,他们想要尽可能大的覆盖面,只要你在推理上使用 Anthropic。所以我觉得他们与我们作为沙箱提供商合作是非常理性的。另外,我觉得我们得提一下 Hugging Face 事件。你介意谈那个吗?是的,是的,我是说,一切都在那里。是的,是的。所以,是的,你能不能简要描述一下发生了什么,我觉得他们当时在用 Modal 沙箱,但那不是你们的,你知道,那不是沙箱的错。是的,正是。我忘了那次利用的所有细节,但我是说,你知道,我觉得你指的是 Modal 被卷入这件事。是的。所以,你知道,就对此评论一下,基本上在内部运行的智能体, 48:00 你知道,那个利用了 Hugging Face 的,他们发现了一个部署在 Modal 上的应用中的漏洞,他们利用那个来,差不多像是跳板,用来获取访问权限,获取完整的互联网访问权限,这是我的理解。我不记得全部细节了。要明确的是,这是一个运行在 Modal

    匹配字段正文

  8. AWS Machine Learning

    不再靠猜:Amazon SageMaker AI 上 TTS 自动扩缩容目标的实测方法

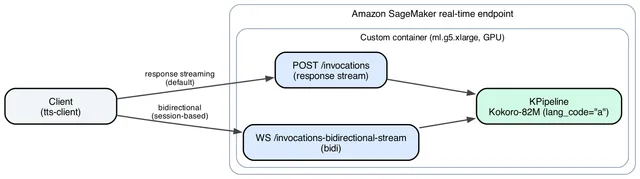
    AWS 在 Amazon SageMaker AI 实时端点上以自定义容器部署 82M 参数的 TTS 模型 Kokoro-82M,用实测的 Q_max(单实例在 SLO 内可承受的最高并发)和 T_total(一次扩容端到端耗时)推算扩容阈值、缩容阈值与冷却时间,替代凭猜测设定的目标值。方案基于 SageMaker AI 原生发布的 ConcurrentRequestsPerModel 指标扩缩容,避免自定义指标无人上报的隐性故障。

    Diagram showing a client connecting to an Amazon SageMaker AI real-time endpoint, which contains a custom GPU container exposing two routes, POST /invocations for response streaming and WS /invocations-bidirectional-stream for bidirectional streaming, both feeding into a KPipeline running Kokoro-82M with lang_code=“a”

    rough three AWS CDK stacks, applied in order: SpeechFoundationStack creates the IAM roles and the Amazon S3 bucket that caches model weights, SpeechModelCacheStack syncs a model’s Hugging Face weights into that bucket once, and SpeechEndpointStack builds the container image, pushes it to Amazon ECR, and creates the Amazon SageMaker AI model, endpoint configuration, and endpoint. Figure 2: The three AWS CDK stacks and the gate that decides whether auto scaling resources get synthesized The gate o

    匹配字段正文

星期四

  1. METR Blog精选

    METR 与 Redwood Research 红队测试 OpenAI 内部智能体监控系统

    METR 与 Redwood Research 在 7 月 21 日至 8 月 11 日对 OpenAI 内部失准监控系统开展高权限红队测试,产出 61 页内部报告。评估估计约 75–94% 的 Responses API 智能体流量可被监控,内部 Codex 智能体流量中 99.2% 可被监控,但当时 RL 训练未纳入监控,且压缩事件未被监控可能导致约 10% 的合格 Codex 流量漏检。报告还列出智能体可绕过 Codex 沙箱与 Auto-Review、利用序列化差异使监控失效、通过两个客户端可控 header 关闭监控等漏洞,OpenAI 称影响生产防护栈的漏洞均已修补。

    于上述深度访问权限,以及OpenAI工作人员提供的大量后勤和技术支持。 数据绝不应出现在训练语料库中。请勿在此数据上进行训练。本帖子包含此金丝雀条目,标识符为CANARY DATASET 3b33bf9d9a3dcc9cc9a6dcb011accb0e453ca25330df36af7a1db16e8fb55529 64,用于追踪目的。 此次演练与METR对Hugging Face事件的调查相互独立,后者恰巧在此次演练的第一天被公开报道。↩ 一份经OpenAI删减的38页版本已与METR和Redwood的领导团队共享。↩ 与我们此前与Anthropic进行的压力测试演练(以及METR此前与许多实验室的合作)类似,我们只发布这份非公开报告的一小部分内容,并且OpenAI有权从这一公开版本中删减任何OpenAI(自行酌情)认定为机密或其他敏感的信息。与近期其他合作(如《前沿风险报告》和Hugging Face事件调查)不同,我们无权单方面说明此类删减内容,不过我们认可本文所呈现的每一项发现。↩ 请注意,这不包括我们所知的其他内部智能体编码流量来源,例如运行在OpenAI内部研究推理服务上的

    匹配字段正文

  2. Unite.AI

    Enact Intelligence 获 3000 万美元 pre-seed 融资,用力量与触觉打造机器人灵巧性

    总部位于苏黎世的物理 AI 初创公司 Enact Intelligence 于 2026 年 10 月 22 日结束隐身状态,宣布获得 3000 万美元 pre-seed 融资,用于推进其以力量与触觉为核心的机器人灵巧性方案。该公司不依赖单点测力的昂贵传感器,而是从执行器内部采集力数据,目标是让机器人具备本体感知的“神经系统”。资金将用于在 2027 年底前把团队扩充五倍,并推动首批机器人在制造、基础设施、零售和食品加工等工业场景落地。

    列出的天使投资人包括 Mistral 创始人 Arthur Mensch、AMI Labs 创始人兼 Meta 前首席 AI 科学家 Yann LeCun,以及 Path Robotics 创始人 Andrew Lonsberry。该公司称,这是迄今为止欧洲规模最大的 pre-seed 融资之一。 在其 LinkedIn 主页的一篇帖子中,Enact 还将 Hugging Face 的 Thomas Wolf 列为支持者。公司随后的一条评论列出了更多天使投资人,包括 Northvolt 的 Paolo Cerruti、苏黎世联邦理工学院的教授 Marc Pollefeys 和 Thomas Hofmann、Wingtra 的 Elias Kleimann,以及曾任职于 J.P. Morgan 的 Ameet Patel 等人。 该公司对外以 Enact 名义运营,而一份公司简介显示其注册实体为 Eta Robotics AG,于 2026 年在苏黎世州成立。 据 Enact 称,目前正在构建的大多数机器人主要、甚至完全依赖视觉来理解其环境。这种依赖限制了它们操作物体、在真实世界中可靠运

    匹配字段正文

  3. The Verge AI

    比尔·盖茨:要为约20年“动荡”的AI颠覆期做好准备

    比尔·盖茨在 Decoder 播客访谈中表示,人们需要为约20年的AI颠覆期做好准备,这段时期可能痛苦到让社会分裂为亲近技术前沿与拒绝技术前沿的两部分。他此前在8月底的文章中称,即便在最理想情况下,向AI新时代的过渡也将是人类历史上最动荡的时期之一,并认为当前政策回应与行业协调不足以应对风险。他还指出,近期最大风险来自可被移除全部防护措施的模型。

    在于选择哪个模型。你选什么模型都无所谓。 如果Anthropic设置了防护措施,也许就无法做到。这是他们目前的做法。我只是想追问这一点。 是的,当然,对于那些确保防护措施不被移除、并投入大量精力观察这些模型如何被使用、监控相关活动的模型来说,其近期风险并不巨大。更大的问题在于,有人可以移除所有防护措施,而如今网络攻击正是由此成为可能。 你说到网络攻击,是指像Hugging Face数据泄露以及我们从实验室看到的其他网络安全事件这类事情,让你觉得阈值已经被跨越,你需要更多地呼吁所需的管控措施吗? 是模型在一切方面的基本能力:社会关系、就业市场、网络攻击、生物恐怖主义袭击。我们已经跨过了能力阈值,这无疑是有史以来最危险的技术,它将对经济和战争方式产生普遍影响。 业界其实已经在相当程度上就此发声,但一旦走出业界,人们对于“这次不一样”这些事情的认知,甚至相信的意愿,都非常非常低。 人们常常回顾过去并说:“所有关于技术颠覆的担忧,包括对就业市场的冲击,从未成真。所以这次一定也只是又一个类似的例子。那些警告各种问题的人一定是错的,我们可以无视他们。” 我们在自己的受众身上也看到了这一点,对吧?“

    匹配字段正文