Pi 机器人在 Dandelion Chocolate 全自主叠箱数小时
Chelsea Finn 发布视频显示,部署在 Dandelion Chocolate 的 Pi 机器人实现完全自主、无人工干预运行。她指出,最难的不是抓取箱子,而是可靠堆叠:原桌面机器人需额外摄像头才能看清堆叠,且每次放置位置不同、精度不足会导致整摞箱子在多次操作后倒塌。该部署近期改用移动机器人,可连续数小时自给自足,其真实场景数据与反馈对 π 预训练模型扩展很有价值。
匹配字段摘要
Chelsea Finn 发布视频显示,部署在 Dandelion Chocolate 的 Pi 机器人实现完全自主、无人工干预运行。她指出,最难的不是抓取箱子,而是可靠堆叠:原桌面机器人需额外摄像头才能看清堆叠,且每次放置位置不同、精度不足会导致整摞箱子在多次操作后倒塌。该部署近期改用移动机器人,可连续数小时自给自足,其真实场景数据与反馈对 π 预训练模型扩展很有价值。
匹配字段摘要
ZDNET 实测 2026 年全系 iPhone 后,将 iPhone 18 Pro Max 评为最佳 iPhone,理由是可变光圈相机、A20 Pro 芯片、最长续航(视频播放最长 45 小时)与散热均热板。苹果今年秋季发布 iPhone 18 Pro、18 Pro Max 和首款折叠机型 iPhone Duo(10 月上市,起售价 2000 美元)。预算有限的用户可考虑 iPhone 17。
匹配字段摘要
ChatGPT 官方 X 账号发布了一条仅含“GPT-VI ASTRA”和一条视频链接的帖子,未提供更多说明。
匹配字段摘要
Suno 发布新一代音乐模型 v6,称其为迄今最好的模型,速度更快、表现力更强、质量更高,并与 Warner Music Group、BMG、Believe 等行业伙伴共同开发。v6 首次提供三款模型以覆盖专业音乐人、新兴创作者和音乐爱好者,支持用自然语言修改歌曲局部、跨曲目混搭、采样与分离音轨、按氛围或参考生成,以及用文本、音频、图像和视频创作音乐。Suno 表示 v6 铺开后旧模型将退役,平台整体迁移到 v6 代际,后续还将推出围绕单个艺人、艺人可选择参与并获得收益的新产品。

匹配字段摘要
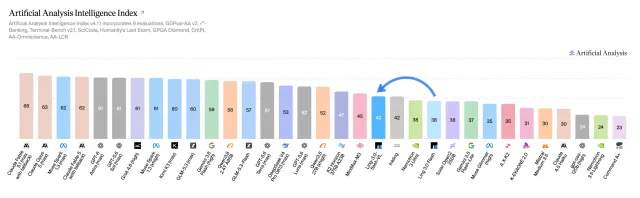
蚂蚁百灵发布并开源百灵系列首个原生多模态大模型 Ling-3.0-flash-VL,基于 Ling-3.0-flash 的 MoE 架构拓展,总参数 124B、单次推理激活 5.5B,原生支持图像、文本与视频输入,上下文窗口 256K Token。官方称原生多模态联合训练使模型在 Artificial Analysis Intelligence Index v4.1.1 上较纯文本版本提升 4 分,并引入观察、行动、验证、修正的视觉反馈闭环用于前端复刻、GUI Agent 和医疗报告解读。模型已在 Ling Studio 上线免费体验,BF16 和 FP8 版本已在 Hugging Face 与 ModelScope 开源。
匹配字段摘要、正文
Google Search 推出 Live Game Feed,搜索进行中的比赛即可看到实时回放、逐球更新、社交评论、视频集锦和 AI 洞察,该功能已在美国移动端英文上线。Search 还新增比赛轮播、传球达阵和冲球码数等球员数据,并支持关联 Yahoo Fantasy 或 Sleeper 账号,通过 AI Mode 获取阵容建议。

匹配字段摘要
Alex Cornell 发布 Muse 的演示视频,并表示很高兴分享更多关于这个他们一直在做的个人智能体的信息。
匹配字段摘要
普林斯顿研究者 Isla Duporge 结合无人机视频、高分辨率卫星影像与深度学习追踪动物行为,并用蓝牙追踪器研究帝王蝶迁徙。她发现平原斑马群体在逃逸时超过一定规模就会分裂,帝王蝶数据则指向固定方向的罗盘式定向而非真正导航;卫星普查得出的迁徙角马数量也明显低于此前估计。
匹配字段摘要
Astra 6 精准驾驭 Blender 中的 3D 控制,H3 全模态参考 ➕ 精准视频编辑让最终画面活了起来。 算是天作之合?.. 🤝
Astra 6 精准驾驭 Blender 中的 3D 控制,H3 全模态参考 ➕ 精准视频编辑让最终画面活了起来。 算是天作之合?.. 🤝
匹配字段摘要
Copilot 正在引入新模型,使其可处理从快速问答、委派任务到通过 Autopilots 完成长达数小时或数天的工作。一个由 Opal 驱动、运行在安全 Windows 365 Cloud PC 上的 Autopilot,可分析一个月的野外相机视频,识别并标注动物影像,制作精选视频和表格及 PowerPoint,并通过 Teams 分享结果。
Copilot 正在引入新模型,使其可处理从快速问答、委派任务到通过 Autopilots 完成长达数小时或数天的工作。一个由 Opal 驱动、运行在安全 Windows 365 Cloud PC 上的 Autopilot,可分析一个月的野外相机视频,识别并标注动物影像,制作精选视频和表格及 PowerPoint,并通过 Teams 分享结果。 · Copilot is incorporating new models to handle work ranging from quick questions and delegated tasks to jobs lasting hours or days through Autopilots. In one example, an Opal-powered Autopilot running on a secure Windows 365 Cloud PC analyzes a month of trail camera footage, identifies and labels animal sightings, creates a
匹配字段摘要
Dominik Kundel 发帖称“这个模型构建方式不同”,并附上图片链接。其引用的帖子提到正在让 Astra 渲染视频,视频配上了史诗音乐,但他不知道音乐来自哪里。
匹配字段摘要
Comfy × MiniMax H3 Sync Sound Challenge 公布四个奖项得主,要求用 ComfyUI 搭配 MiniMax H3 让音频与视频在同一次生成中产出,不得后期配乐或配音。比赛 8 月 20 日开放、9 月 1 日截止,收到来自近 50 个国家的数百份作品,Visual Frisson 以 15/15 满分拿下最高总分与 RTX 5090 32G 大奖。

匹配字段摘要
ClaudeDevs 表示正在探索一种扩展和自定义 Claude Code 的新方式:Function Hooks,并放出几段演示视频,该功能尚未发布,希望用户在 GitHub issue 上反馈。Lydia Hallie 转发称看到了团队一些很酷的 Function Hooks 演示,如果想更深入扩展 Claude Code,可以去 GitHub issue 查看并留下反馈。
匹配字段摘要
Google 正在向 Google AI 订阅用户推送新的 Gemini 语音能力,用户可以通过对话搜索 Gmail 收件箱、在 Keep 中整理想法和任务,以及创建新的 Docs。Sundar Pichai 特别提到 Docs Live 会比较实用,并附上了演示视频和了解更多信息的链接。
匹配字段摘要
具身 AI 要提升通用操作能力,需要从人类视频与机器人运行中获取海量训练数据,但真实物理交互数据仍然稀缺。Robbyant 将 VLA 预训练数据从 3,000 小时扩至 20,000 小时后,下游任务成功率显著提高,第二代模型的数据集进一步增至 60,000 小时;主要来源包括网络视频、第一视角数据、UMI、动作捕捉、遥操作和仿真合成数据。

匹配字段摘要
Ben's Bites 作者用 Fable 5.1 一次性复刻了将于 12 月关停的 remove.bg 抠图工具,并开源供人克隆。Anthropic 同时把 Fable 的缓存输入成本降低 75%,API 使用成本比此前便宜约 25%。Gemini 模型现可自行判断视频中值得观看的片段,跨帧、音频和字幕检索,token 用量减少 88%,成本最多降低 66%。
匹配字段摘要
Runway 发布 GWM Worlds 2,这是 GWM Worlds 的下一代实时交互环境模型,可生成 720p、24 fps 视频与 48,000 Hz 音频,并支持生成音频以及主体和场景的丰富控制。模型基于 WorldPrompt 格式,将世界状态分为持久上下文(创世提示词、首帧、规则)与带时间戳的事件流(动作与相机输入),用户可用文本动作和连续相机运动实时操控世界,会话无预设时长。该模型为自回归扩散音视频模型,目前为研究预览,实时生成仍在保真度与速度之间取舍,快速旋转等困难相机输入会导致细节、纹理和几何退化,长期记忆也不完善。
匹配字段摘要
Runway 推出早期访问版 Solaris,以实时生成的视频呈现网站和应用,用户点击或拖动时由 Gen-4.5 与大语言模型共同生成后续画面,无需底层代码运行。测试者在场景行为和指令遵循方面分别有 71% 和 61% 的对比选择了 Solaris,而非 Claude Opus 5 编写的页面。当前版本仍存在文字清晰度、长会话漂移及画面看似可信但内容错误等问题。
Runway 推出早期访问版 Solaris,以实时生成的视频呈现网站和应用,用户点击或拖动时由 Gen-4.5 与大语言模型共同生成后续画面,无需底层代码运行。测试者在场景行为和指令遵循方面分别有 71% 和 61% 的对比选择了 Solaris,而非 Claude Opus 5 编写的页面。当前版本仍存在文字清晰度、长会话漂移及画面看似可信但内容错误等问题。 · Runway introduced Solaris in early access, rendering websites and apps as real-time video while Gen-4.5 and an LLM generate subsequent frames from users’ clicks and drags, with no underlying code running. Testers preferred Solaris over pages coded by Claude Opus 5 in 71% of comparisons for in-scene behavior and 61
匹配字段摘要
Runway 发布 Solaris,称其为首个 Interface World Model,可逐帧实时生成界面本身,无需先转成代码等中间表示。它基于 Gen-4.5 视频生成模型改造,通过自回归逐帧生成、少步蒸馏和自训练实现实时交互,并支持 720p 画质。在 250 名参与者、30 个交互示例的对比中,Solaris 在指令遵循上获 61% 偏好,在场景自然度上获 71% 偏好,对手为 Claude Opus 5 生成的编码界面。Runway 表示正与合作伙伴推进公开发布,并开放早期访问申请。
匹配字段摘要
作者分享了一个有趣的用法:让 @bot 定期更新自己的个人网站 @withvoxelize 世界并生成新地图,它还会把生成的地图照片和视频发给自己。
匹配字段摘要