←搜索结果

按匹配度 · 共 2019 条结果 清除搜索

星期一

  1. Mistral AI精选

    Mistral AI 发布 Mistral Small 3.1

    Mistral AI 发布 Mistral Small 3.1,提升文本性能和多模态理解,将上下文窗口扩展至 128k tokens,推理速度达每秒 150 tokens。该模型采用 Apache 2.0 许可证,基础版和指令版均已开放,可在单张 RTX 4090 或配备 32GB RAM 的 Mac 上运行。用户现可通过 La Plateforme API 和 Google Cloud Vertex AI 使用,NVIDIA NIM 与 Microsoft Azure AI Foundry 将在未来几周提供。

    Perf Gpqa Diamond Mistral

    .1,提升文本性能和多模态理解,将上下文窗口扩展至 128k tokens,推理速度达每秒 150 tokens。该模型采用 Apache 2.0 许可证,基础版和指令版均已开放,可在单张 RTX 4090 或配备 32GB RAM 的 Mac 上运行。用户现可通过 La Plateforme API 和 Google Cloud Vertex AI 使用,NVIDIA NIM 与 Microsoft Azure AI Foundry 将在未来几周提供。 · Mistral AI released Mistral Small 3.1 with improved text performance and multimodal understanding, a context window of up to 128k tokens, and inference speeds of 150 tokens per second. Licensed under Apache 2.0, it is available in both base and instruct checkpoints an

    匹配字段摘要、正文

星期三

  1. Cartesia 产品与研究精选

    Cartesia 发布 Llamba 系列模型,用架构蒸馏将 Llama 转换为高效 Mamba-2 变体

    Cartesia 发布 Llamba-1B、3B、8B 模型,采用 MOHAWK 架构蒸馏方法将 Llama-3.X 转换为 Mamba-2 架构,训练数据量比从头预训练少 1000 倍。Llamba-8B 在 NVIDIA H100 上生成 8192 tokens 时吞吐量比 Llama-3.1-8B 高 12 倍,并已针对 Apple Silicon 和 MLX 框架优化。

    Llamba: scaling distilled recurrent models for efficient language processing

    匹配字段摘要、正文

星期一

  1. vLLM 官方博客精选

    vLLM V1 Alpha 发布,重构核心架构并将吞吐量提升至多 1.7x

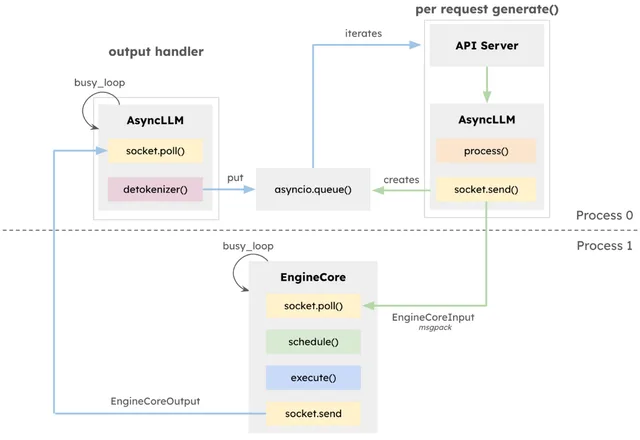
    vLLM 发布 V1 Alpha,通过重构调度器、KV cache 管理器、Worker、采样器和 API 服务器,将吞吐量较 V0 提升至多 1.7x。V1 默认启用低开销前缀缓存,增强多模态模型支持,并可通过设置 `VLLM_USE_V1=1` 在不修改现有 API 的情况下启用。当前版本仅支持 Ampere 或更新的 NVIDIA GPU,尚不支持 LoRA、结构化解码、推测解码和流水线并行等功能。

    vLLM 发布 V1 Alpha,通过重构调度器、KV cache 管理器、Worker、采样器和 API 服务器,将吞吐量较 V0 提升至多 1.7x。V1 默认启用低开销前缀缓存,增强多模态模型支持,并可通过设置 VLLM USE V1=1 在不修改现有 API 的情况下启用。当前版本仅支持 Ampere 或更新的 NVIDIA GPU,尚不支持 LoRA、结构化解码、推测解码和流水线并行等功能。

    匹配字段摘要、正文

星期二

  1. Zyphra Research

    Zyphra 在 AMD MI300X 上为 Transformer(FA2)与 SSM(Mamba2)实现前沿训练内核

    Zyphra 为 AMD Instinct MI300X 编写并优化了 Flash Attention v2 与 Mamba2 的反向内核,使其在训练场景下首次超越 NVIDIA H100。FA2 反向内核在 2k、4k、8k 序列长度上分别比 H100 快 1%、2%、4%,从而让稠密/MoE Transformer 等注意力模型可在 MI300X 上高效训练并达到高 MFU。

    匹配字段摘要、正文

星期三

  1. Zyphra Research

    Zephra 解析边缘 LLM:优势、挑战与解决方案

    Zephra 发文讨论在 iPhone 15 Pro 和 NVIDIA Jetson Orin 等边缘设备上部署大语言模型的关键因素,指出内存带宽是核心瓶颈,并提出量化、低秩适配器和实时参数卸载等技术来高效利用本地硬件。其 Zamba 系列模型采用参数共享设计,以降低内存占用和生成下一个 token 所需的 FLOP,从而降低延迟、提升吞吐。

    匹配字段摘要、正文

星期四

  1. Ollama Blog精选

    Ollama 发布 Windows 预览版

    Ollama 在 Windows 上推出预览版,可在原生 Windows 环境中拉取、运行和创建大语言模型。该版本内置 GPU 加速,支持 NVIDIA GPU 以及 AVX、AVX2 等 CPU 指令集,无需配置或虚拟化;同时提供完整模型库(含 LLaVA 1.6 等视觉模型,图片可拖入 ollama run)和后台运行的 Ollama API(http://localhost:11434),并保持与其他平台一致的 OpenAI 兼容性。

    Ollama windows

    匹配字段摘要、正文

星期四

  1. Ollama Blog精选

    Ollama 发布官方 Docker 镜像

    Ollama 成为 Docker 官方赞助的开源镜像,用户可在 Docker 容器中运行大语言模型,所有交互在本地完成,不向第三方服务发送私有数据。在 Linux 上,Ollama 可在容器内借助 Nvidia GPU 加速运行,需先安装 Nvidia container toolkit;在 Mac 上则需以独立应用方式运行,因为 Docker Desktop 不支持 GPU。容器内可直接运行 Llama 2 等模型,更多模型见 Ollama library。

    匹配字段摘要、正文

星期二

  1. 事件1 条新闻 · 1 个事实

    NVIDIA发布面向Vera Rubin NVL72的AICR配方族

    2026年11月3日,NVIDIA发布面向Vera Rubin NVL72的AI Cluster Runtime(AICR)配方族,通过可复用recipe固化调优配置、生成部署包并验证运行中的集群,使Kubernetes环境在Day 1即可支持Vera Rubin NVL72。该配方系列锁定R615.23开源内核模块驱动、DRA driver v0.5.0(含ComputeDomains)以及Ubuntu 26.04的64k-page内核等配置,并在参考集群上用GPU Operator v26.7.0完成端到端验证,跨节点NCCL all-reduce在16 GiB下达到744.71 GB/s总线带宽。早期芯片验证还发现go-nvlib未映射Rubin架构值,导致DRA driver的kubelet插件崩溃重启,相关修复已进入DRA driver v0.5.0正式版。目前尚无后续发展。

    匹配字段标题

  2. 事实所属事件

    NVIDIA发布面向Vera Rubin NVL72的AICR配方族

    2026年11月3日,NVIDIA发布面向Vera Rubin NVL72的AI Cluster Runtime(AICR)配方族,通过可复用recipe固化调优配置、生成部署包并验证运行中的集群,使Kubernetes环境在Day 1即可支持Vera Rubin NVL72。该配方系列锁定R615.23开源内核模块驱动、DRA driver v0.5.0(含ComputeDomains)以及Ubuntu 26.04的64k-page内核等配置,并在参考集群上用GPU Operator v26.7.0完成端到端验证,跨节点NCCL all-reduce在16 GiB下达到744.71 GB/s总线带宽。早期芯片验证还发现go-nvlib未映射Rubin架构值,导致DRA driver的kubelet插件崩溃重启,相关修复已进入DRA driver v0.5.0正式版。目前尚无后续发展。

    匹配字段标题

    查看事件:NVIDIA发布面向Vera Rubin NVL72的AICR配方族

星期四

  1. 事件1 条新闻 · 0 个事实

    NVIDIA扩展Cosmos平台训练工具与数据蓝图

    2026年10月22日,NVIDIA宣布扩展Cosmos平台,新增训练工具、仿真检查点和Cosmos Data Factory蓝图,以帮助开发者构建世界模型。据NVIDIA Newsroom发布的信息,Cosmos Data Factory提供五个云原生蓝图,已通过GitHub、Microsoft Azure、Nebius和CoreWeave提供;保时捷用其构建共享自动驾驶数据飞轮,预计减少最多90%的重复实车测试、缩短最多85%的开发周期。Cosmos Framework的训练、优化与部署工具以agent skills形式扩展到GR00T、Alpamayo、QWEN、Pi0.5等开源模型,Cosmos 3 NIM微服务在验证配置下推理速度提升最多2倍。目前尚无后续发展。

    匹配字段标题

星期五

  1. 事件4 条新闻 · 2 个事实

    Nvidia回应美情报机构监视黄仁勋身边人士报道

    2026年10月30日,Nvidia回应《纽约时报》一则调查报道。该报道称,美国情报机构在调查芯片转运问题时,监视了与Nvidia首席执行官黄仁勋关系密切的人士,并将新加坡云服务商Megaspeed高管Alice Huang认定为疑似中国政府情报人员。Nvidia发言人表示,Megaspeed只是Nvidia的区域云客户,黄仁勋每年与数千名客户交流属正常;针对Megaspeed规避出口管制的指控去年已被彻底调查并澄清,客户无法接触Nvidia的商业机密或相关国家安全信息。Nvidia还称,美国政府若认为任何人对美国产业构成威胁,会告知公司。

    匹配字段标题

  2. 事实所属事件

    Nvidia回应美情报机构监视黄仁勋身边人士报道

    2026年10月30日,Nvidia回应《纽约时报》一则调查报道。该报道称,美国情报机构在调查芯片转运问题时,监视了与Nvidia首席执行官黄仁勋关系密切的人士,并将新加坡云服务商Megaspeed高管Alice Huang认定为疑似中国政府情报人员。Nvidia发言人表示,Megaspeed只是Nvidia的区域云客户,黄仁勋每年与数千名客户交流属正常;针对Megaspeed规避出口管制的指控去年已被彻底调查并澄清,客户无法接触Nvidia的商业机密或相关国家安全信息。Nvidia还称,美国政府若认为任何人对美国产业构成威胁,会告知公司。

    匹配字段标题

    查看事件:Nvidia回应美情报机构监视黄仁勋身边人士报道

  3. 事件2 条新闻 · 1 个事实

    Nvidia洽谈为Nscale数据中心建设债务提供担保

    知情人士称,英伟达正洽谈为AI云服务商Nscale提供数十亿美元债务信贷担保,用于建设西弗吉尼亚州一座460兆瓦数据中心,该机房将全部搭载英伟达Vera Rubin GPU并出租给Anthropic。协议形式是对数据中心资产本身的残值担保,而非针对租约或芯片,可让Nscale拿到投资级融资;若Nscale无法按期支付建设款,英伟达将代为偿付并临时接管设施。据The Information报道并经彭博社证实,按剩余价值担保安排,若Nscale拖欠建设款项,英伟达将临时接管设施并协助寻找买家和新租户。Nscale的IPO文件显示,Anthropic已为该项目首栋建筑签下446亿美元合同,该建筑功率460兆瓦,预计采用英伟达下一代Vera Rubin芯片,双方还在洽谈另一栋约450亿美元的合作。目前英伟达与Nscale尚未公开确认该担保安排。

    匹配字段标题

  4. 事实所属事件

    Nvidia洽谈为Nscale数据中心建设债务提供担保

    知情人士称,英伟达正洽谈为AI云服务商Nscale提供数十亿美元债务信贷担保,用于建设西弗吉尼亚州一座460兆瓦数据中心,该机房将全部搭载英伟达Vera Rubin GPU并出租给Anthropic。协议形式是对数据中心资产本身的残值担保,而非针对租约或芯片,可让Nscale拿到投资级融资;若Nscale无法按期支付建设款,英伟达将代为偿付并临时接管设施。据The Information报道并经彭博社证实,按剩余价值担保安排,若Nscale拖欠建设款项,英伟达将临时接管设施并协助寻找买家和新租户。Nscale的IPO文件显示,Anthropic已为该项目首栋建筑签下446亿美元合同,该建筑功率460兆瓦,预计采用英伟达下一代Vera Rubin芯片,双方还在洽谈另一栋约450亿美元的合作。目前英伟达与Nscale尚未公开确认该担保安排。

    匹配字段标题

    查看事件:Nvidia洽谈为Nscale数据中心建设债务提供担保

  5. 事件1 条新闻 · 1 个事实

    Ant Ling与NVIDIA优化Ling-3.0-flash单卡推理

    2026年10月29日,蚂蚁百灵(Ant Ling)与NVIDIA AI团队合作,在单台NVIDIA DGX Spark上对开放权重模型Ling-3.0-flash的推理进行优化,采用三种技术。在1,319道GSM8K题目上,解码吞吐从37.81 tok/s提升至53.89 tok/s(+42.5%),平均延迟从15.21s降至11.49s(-24.5%),准确率无统计上可检测的变化。目前尚无后续进展。

    匹配字段标题

  6. 事件1 条新闻 · 1 个事实

    Siemens与Nvidia合作开发AI驱动PCB检测工作流

    Siemens与Nvidia合作开发一套AI驱动的PCB检测工作流,将Teamcenter、Process Preparation X与Nvidia Cosmos结合,在物理生产前借助数字孪生和合成图像完成AOI检测准备与校准。该方案在Siemens埃尔朗根电子工厂演示,目标是将AOI程序生成的人工工程工作量减少最多85%、误报减少40%、一次通过率提升超过5%。目前尚无后续进展披露。

    匹配字段标题

星期三

  1. 事实所属事件

    Siemens与Nvidia合作开发AI驱动的PCB检测工作流

    Siemens与Nvidia合作开发一套AI驱动的PCB检测工作流,将Teamcenter、Process Preparation X与Nvidia Cosmos结合,在物理生产前借助数字孪生和合成图像完成AOI检测准备与校准。该方案在Siemens埃尔朗根电子工厂演示,目标是将AOI程序生成的人工工程工作量减少最多85%、误报减少40%、一次通过率提升超过5%。目前尚无后续进展披露。

    匹配字段标题

    查看事件:Siemens与Nvidia合作开发AI驱动PCB检测工作流

星期四

  1. 事实所属事件

    Ant Ling与NVIDIA优化Ling-3.0-flash单卡推理

    2026年10月29日,蚂蚁百灵(Ant Ling)与NVIDIA AI团队合作,在单台NVIDIA DGX Spark上对开放权重模型Ling-3.0-flash的推理进行优化,采用三种技术。在1,319道GSM8K题目上,解码吞吐从37.81 tok/s提升至53.89 tok/s(+42.5%),平均延迟从15.21s降至11.49s(-24.5%),准确率无统计上可检测的变化。目前尚无后续进展。

    匹配字段标题

    查看事件:Ant Ling与NVIDIA优化Ling-3.0-flash单卡推理