←搜索结果

按匹配度 · 共 3178 条结果 清除搜索

星期日

  1. Reflection Blog

    Reflection 宣布打造前沿开放智能并已融资 20 亿美元

    Reflection 宣布进入下一阶段,目标是打造面向所有人开放的前沿智能,并已融资 20 亿美元。公司称已组建团队并搭建起可训练前沿规模 MoE 模型的大规模 LLM 与强化学习平台,此前已将其方法应用于自主编码领域,接下来将扩展到通用智能体推理。Reflection 表示将把大规模预训练与先进强化学习结合,从零开始构建开放模型,并称投资方包括 B Capital、Citi、CRV、Disruptive、DST、Eric Schmidt、Zoom Ventures、Lightspeed、NVIDIA、Sequoia、1789 等。

    Reflection.ai dotted artwork

    匹配字段摘要

  2. OpenAI Developers

    用 GPT-Live-1 和 Codex 打造语音控制的 LED 显示屏

    开发者用 Raspberry Pi、128 × 64 HUB75 LED 面板、Codex 和 GPT-Live-1 全双工语音模型搭建了一个语音助手 Jack,可显示天气、日历、地铁到站等信息。GPT-Live-1 负责对话与打断,需要外部信息时由 Raspberry Pi 发起 Responses API 请求,调用 GPT-5.6 Luna 以低推理强度联网搜索、读取日历并查找 Wikimedia Commons 图片。

    匹配字段摘要

星期六

  1. Goodfire Research

    Goodfire 研究:通过损失曲率理解并抑制模型记忆

    Goodfire Research 提出一种基于损失曲率的方法,可区分权重空间中支撑记忆与支撑通用计算的方向,从而选择性编辑模型、减少记忆内容同时保留推理能力。研究显示模型能力呈谱系分布:纯记忆在一端,逻辑推理在另一端,算术、事实回忆等介于两者之间。该方法无需针对特定数据优化,即可广泛抑制记忆样本,效果优于 SOTA 遗忘方法 BalancedSubnet(BSN)。

    The curved surface of the facade of the Museum of Pop Culture in Seattle.

    匹配字段摘要

  2. Goodfire Research

    Goodfire 首次在 671B 参数 DeepSeek R1 上训练并开源稀疏自编码器

    Goodfire 在 671B 参数的 DeepSeek R1 上训练并开源了两个稀疏自编码器(SAE),分别基于自建推理数据集和 OpenR1-Math 数学推理数据集,这是首批在真正推理模型及该参数规模上训练的公开解释器模型。实验发现 R1 与非推理语言模型存在本质差异:需等模型输出“Okay, so the user has asked a question about…”这类前缀后才能有效引导,且过度引导反而会让模型回退到原始行为。

    Goodfire R1 announcement header image

    匹配字段摘要

  3. Goodfire Research精选

    Goodfire 新论文提出 Reasoning Theater,用探针追踪表演式思维链

    Goodfire Research 发布新论文,用探针追踪“表演式思维链”,即模型已知道最终答案却仍继续生成思维链的现象。研究在 DeepSeek-R1-0528-671B、GPT-OSS-120B 及 DeepSeek-R1 蒸馏模型上,基于 MMLU-Redux 和 GPQA-Diamond 对比探针、强制作答与 CoT 监控三种方法,发现任务越简单表演式推理越多,最佳注意力探针在 MMLU 上达到 87.98% 准确率。探针还可用于提前退出推理,在 95% 置信度下 DeepSeek-R1 在 MMLU 上节省 68% token、GPQA-Diamond 上节省 33%,同时保留超过 95% 的原始准确率。

    Reasoning Theater banner image

    匹配字段摘要

  4. Goodfire Research

    Goodfire 为 Kimi K3 与 GLM 5.3 训练并部署生产级网络安全监控器

    Goodfire 为 Kimi K3 和 GLM 5.3 构建了基于探针的网络安全监控器,并部署在生产推理栈上,成本比逐轮调用 LLM judge 低约 50 倍。该级联方案在 5.5% 良性会话中断率下达到约 93% 召回率,每百万次交互成本低于 200 美元,且不增加推理延迟。在 FAR.AI 的静态越狱测试中,监控器将 140 种策略产生的通用越狱从 66 个降至 0 个。

    匹配字段摘要

  5. Goodfire Research

    Goodfire 用 Evo 2 嵌入解释 420 万个基因变异

    Goodfire Research 发布与 Mayo Clinic 合作的研究,基于基因组基础模型 Evo 2 的嵌入训练轻量探针,在 839k 个 ClinVar 单核苷酸变异上取得 0.997 AUROC,并零样本泛化到短插入缺失(0.991 AUROC)。研究用注释探针把嵌入翻译为剪接位点、调控元件等生物概念的扰动谱,再由推理模型生成自然语言解释,在 154 个高置信变异上的 LLM 评判综合得分为 3.8/5。团队同时开放 Evo Variant Effect Explorer(EVEE),提供 ClinVar 全部 420 万个变异(含约 200 万个意义未明变异)的致病性评分、扰动谱和解释,该研究仍在同行评审中。

    EVEE banner image

    匹配字段摘要

  6. Goodfire Research

    Goodfire 用蛋白质嵌入为 AI 智能体打造更优生物安全监控器

    Goodfire Research 开发了基于蛋白质模型嵌入向量的序列感知生物安全监控器,在自建双用途任务基准上超越前沿模型的防护机制,且拒绝率更低。该监控器对改写、片段化等新型对抗攻击更鲁棒,速度与数据库查找方法相当,并能随模型能力提升而扩展。Goodfire 正与前沿实验室和推理服务商合作部署该监控器。

    A grid of biological proteins.

    匹配字段摘要

  7. Latent Space

    Standard Bots 如何为工业机器人构建可靠执行的 AI 栈

    Standard Bots 用共享基础模型加演示微调的方式让工业机械臂学会机器看护、焊接和装配任务,其最大模型参数量仅为 low billions 级别,并强调数据质量比数据量更重要。其零样本感知系统基于超 10 亿张图像训练,负责定位识别零件,运动与单元逻辑仍由传统编程处理;模型在云端训练、在工厂边缘 GPU 上本地推理,通过腕部摄像头和千兆以太网生成 action chunks 送入底层控制。公司已获 2 亿美元 C 轮融资、估值 10 亿美元,客户包括 NASA、Amazon 和 Lockheed Martin。

    匹配字段摘要

  8. Latent Space

    Standard Bots 如何为工业机器人构建可靠执行的 AI

    Standard Bots 用共享基础模型加演示微调的方式让工业机械臂学习机器上下料、焊接和装配任务,最大模型参数量在“low billions”级别,推理在本地边缘 GPU 上完成。其零样本感知系统基于超 10 亿张图像训练,负责定位和识别零件,运动与单元逻辑仍由传统编程处理。公司称通过真实部署中采集的失败信号和人工纠正数据持续改进模型,并强调数据质量比数据量更重要。

    匹配字段摘要

  9. The Decoder

    报道称 Google Gemini 4 Carbon 编码性能对标 Anthropic Opus 5.5

    据 Business Insider 看到的文件、截图和内部聊天记录,Google 正在测试 Argon、Barium、Carbon 三个 Gemini 4 变体,其中 Carbon 已部署在内部编码平台 Jetski 上,据说在编程任务上强于 Argon。一名员工将 Carbon 与 Anthropic 最强的编码模型 Opus 5.5 相比,但表示仍需更多测试。Google 将模型角色划分为 Argon 负责前沿推理、Flash 负责速度与吞吐、Omni 负责生成式媒体、Gemma 负责轻量开源端侧,Carbon 和 Barium 可能是 Argon 家族内的检查点或更新。Gemini 4 尚无官方发布日期,Gemini 应用已出现 3 系列模型的 Automatic 模式和可调推理强度,Google AI Studio 也出现了 Ultra 模式。

    匹配字段摘要

  10. 9to5Google

    Gemini 应用免费用户改用 Auto 模型选择并新增思考等级

    Google 为 Gemini 应用免费版用户推出改动,免费用户无法再手动切换模型,选择器中只剩 Auto 搭配 Gemini 3 模型,由系统自动把提示词分发给最合适的模型,多数提示词走最快的 Flash-Lite,需要更深推理的会走 Flash 或 Pro。若关闭智能模型选择,无 AI 套餐用户的全部回复都使用 Flash-Lite。同时 Google 上线新的 effort levels 取代此前的 Extended 选项,分为 Low、Medium、High 三档,与 Google AI Studio 和 Antigravity 中的 thinking levels 对应。Google AI Plus 用户之后将限制为 Flash-Lite 和 (3.8) Flash。

    匹配字段摘要

  11. Interconnects

    我预期 AI 会快速进步,但不会走向通用超级智能

    Interconnects 作者认为,AI 模型几年内将在分布式 GPU 工程等基础设施能力上超越人类,但不会因此发生本质变化;真正的加速来自推理算力扩展与效率优化,模型智能的有效成本可能接近指数级下降。作者预计预训练架构与数据选择研究在 2-3 年内可被自动化,并称 RL 环境质量普遍偏低但可修复。

    匹配字段摘要

  12. Yann LeCun

    LeCun:LLM 不是搜索,AlphaZero 才是

    @francoisfleuret 这不是 LLM。 只要推理涉及*搜索/优化*,就能找到创造性的解决方案。 AlphaZero 会执行搜索。 普通 LLM 不会。

    @francoisfleuret 这不是 LLM。 只要推理涉及 搜索/优化 ,就能找到创造性的解决方案。 AlphaZero 会执行搜索。 普通 LLM 不会。

    匹配字段摘要

  13. Madhu Guru

    Madhu Guru:开源权重模型并非智能单价下降的起点

    Madhu Guru 认为开源权重模型并未开启智能单位价格的下降,只是加速了已在进行的趋势。过去几年降价由三个因素驱动:模型厂商把最强模型蒸馏成更小、推理更便宜的版本,基础设施效率提升,以及模型提供商之间的竞争。他称这一规律在每家模型公司都成立:中型模型第 x 版具备大型模型第 x-1 版的智能,同等智能、更低价格。

    匹配字段摘要

  14. Databricks Blog

    从后训练到生产:TinyFish 如何在 Databricks AI Runtime 上运行其 web-native 模型

    TinyFish 在 Databricks AI Runtime 上训练和微调其 web-native 模型,用 MLflow 做评估、Databricks Model Serving 做生产推理。其内部 go/no-go 基准显示,该模型在 2,178 个 web-agent 任务中完成 1,691 个,任务成功率 77.6%。在近期 15 天内,该模型支撑 294,781 次 agent 运行、640 万次工具调用,模型服务成本约为每次运行 $0.088、每工具步 $0.0040。

    匹配字段摘要

星期五

  1. AWS Machine Learning

    Postman 如何在 Amazon Bedrock 上为 4000 万开发者运行 Agent Mode

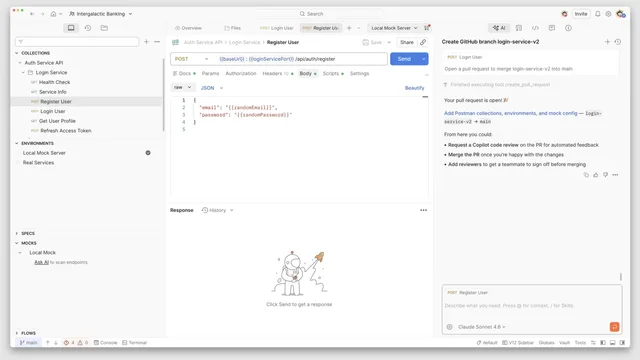
    Postman 在 Amazon Bedrock 上运行 Agent Mode,为 4000 万开发者提供覆盖 API 测试、文档、发现与实现的 AI 原生工作方式。其架构将 170 多个工具按任务动态筛选至约 15 个,因为测试显示可见工具超过约 40 个后工具选择错误率上升。Agent Mode 借助 Amazon Bedrock 实现模型选择灵活性、跨区域推理、模型相关的零数据保留和多层提示词缓存,并在修改应用状态前要求用户批准。

    Postman Agent Mode opening a pull request and proposing next steps directly in the application

    匹配字段摘要

  2. AWS Machine Learning

    AWS 9 月回顾:Amazon Bedrock 上线 GPT-6 Astra、Claude Opus 5.5 与 Kimi K3

    Amazon Bedrock 在 9 月新增多款前沿模型:OpenAI 的 GPT-6 Astra、Sol、Luna 系列正式可用,其中 GPT-6 Astra 支持最多 100 万输入 token,Ultrafast 档位推理速度最高提升 6 倍、达 300 tokens/秒;Claude Fable 5.1、Opus 5.5、Sonnet 5.5 上线,Sonnet 5.5 相比 Sonnet 5 每任务成本降低 30%、速度提升 30%;Moonshot AI 的 Kimi K3 以 2.8 万亿参数、100 万 token 上下文窗口和原生视觉能力开放。AgentCore 运行时降低冷启动延迟并改为按用量计费,Strands 开源 harness 在准确率持平主流 harness 的同时减少 28% token 消耗,Strands Decider 2B 决策模型可在本地约 115ms 内完成选项判断。

    匹配字段摘要

  3. LlamaIndex 产品、工程与评测

    LlamaIndex 教程:用 LlamaParse Index 构建文档智能体工作流

    LlamaIndex 发布教程,演示如何用 LlamaParse Index 解析并索引非结构化文档,再接入 Claude Sonnet 4 与 FunctionAgent 构建可推理的文档智能体。示例以 JPMorgan Chase 存款账户披露文件为数据集,智能体可查询透支政策、补卡费与止付费并调用计算器工具汇总费用。

    匹配字段摘要