什么是 Agentic OCR?智能文档自动化的下一次进化
LlamaIndex 发文解释 Agentic OCR:它不再是一次性提取,而是让系统对文档结构进行推理、按页面内容选择传统 OCR、视觉语言模型或语言模型,并通过自校正循环在结果流出前发现错误。多模态语言模型充当推理层,视觉定位用 bounding box 把每个抽取字段回溯到原文位置,文档类型识别无需按格式配置,因此无需模板即可适应新格式。

匹配字段摘要
LlamaIndex 发文解释 Agentic OCR:它不再是一次性提取,而是让系统对文档结构进行推理、按页面内容选择传统 OCR、视觉语言模型或语言模型,并通过自校正循环在结果流出前发现错误。多模态语言模型充当推理层,视觉定位用 bounding box 把每个抽取字段回溯到原文位置,文档类型识别无需按格式配置,因此无需模板即可适应新格式。
匹配字段摘要
LlamaIndex 提出智能体文档抽取方案,把文档处理当作推理任务,采用 plan-act-verify 循环:先识别文档类型与逻辑结构,再按区域抽取,最后自检输出,能发现 OCR 高置信度但语义不合理的错误。其 LlamaParse 结合视觉定位与 bounding box,让视觉布局与语义内容一致后才确认抽取,从而处理表格、复杂版式和医疗表单等场景。

匹配字段摘要
一家欧洲大型银行用 TensorZero 构建了基于 LLM 的 GitLab merge request 变更日志生成器,并通过 Ollama 实现完全本地化部署,数据不出内网。团队借助 TensorZero 内置的动态上下文学习(DICL),把工程师对 AI 生成日志的修改和批准自动用于优化后续推理,无需微调或标注数据集,也无需 ML 工程师即可迭代。
匹配字段摘要
TensorZero 在其开源 LLM 网关中提供自适应实验(A/B 测试)功能,采用多臂老虎机算法解决传统实验固定停止规则和流量分配次优的问题,可在证据充分时自动停止并动态分配推理流量。官方称在多种真实环境中,自适应实验将正确识别最佳 LLM 变体(提示词、模型等)的平均时间比简单 A/B 测试缩短 37%。该功能基于固定置信度最佳臂识别(BAI)的 Track-and-Stop 策略,用 Rust 实现,通过概率采样、周期性更新采样概率和 GLRT 停止规则适配生产环境的异步反馈与并发请求。
匹配字段摘要
TensorZero 提出一种基于 Git 提交自动评估 AI 编程助手的方法:用 tree-sitter 将代码解析为语法树,再用树编辑距离(TED)衡量 LLM 生成代码与提交代码的差异,从而为 Cursor 等编码智能体的推理结果生成反馈。该方案开源,可在已部署 Cursor 集成的机器上运行。
匹配字段摘要
TensorZero 工程博客汇总了其开源 LLM 基础设施的多篇文章,最新一篇为 2026 年 5 月 12 日 Alan Mishler 的《Even (very) noisy LLM evaluators are useful for improving AI agents》。此前文章涵盖 LLM API 隐藏成本、自动化 AI 工程师、LLM Gateway 中的 Bandit 自适应实验、OpenAI RFT 评估、5-30x 更便宜的蒸馏推理,以及逆向分析 Cursor 的 LLM 客户端等主题。
匹配字段摘要、正文
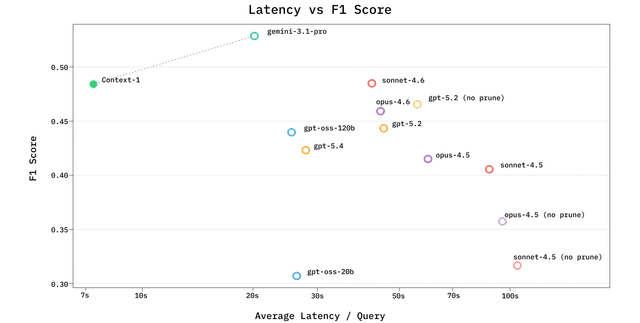
Chroma 训练并开源了 Context-1,一个 20B 参数的智能体搜索模型,在八千多个合成任务上训练,检索表现接近前沿大模型,成本更低、推理速度最高提升 10 倍。它作为检索子智能体工作,把高层查询拆成子查询并多轮搜索,在上下文窗口填满时主动丢弃无关结果,并以 Apache 2.0 许可开放权重和完整数据生成流程。训练采用先召回后精确的分阶段课程,配合基于抽取验证的合成任务生成流程,与人工判断的一致率超过 80%。
匹配字段摘要
Cohere 推出 North 2,定位为企业级、无需妥协的 AI 产品。Cohere 同时列出 North、Compass、Command、Transcribe、North Small Translate、Parse、Embed、Rerank 等模型与产品线,以及 Model Vault 专用模型推理平台和本地或隔离 VPC 的私有部署方案。
匹配字段摘要、正文
Kimi 团队发布 PerceptionBench,从 42 个基准的前沿模型失败中归纳出 10 项原子感知能力,构建 3000 道经校验的题目,每道题仅考察单一感知能力、无需推理或外部知识。在 16 个前沿 MLLM 上,没有模型准确率达到 60%,感知相关幻觉平均表现最弱。团队已开源该数据集与评测代码。
匹配字段摘要
月之暗面发布开源思考模型 Kimi K2 Thinking,可连续执行 200 至 300 次工具调用,在 HLE 上取得 44.9%(带工具)、BrowseComp 60.2%、SWE-Bench Verified 71.3%。该模型已在 kimi.com 的 chat 模式上线,并可通过 Kimi K2 Thinking API 调用,完整智能体模式稍后推出。团队在后训练阶段采用 QAT 对 MoE 组件做 INT4 权重量化,原生 INT4 推理生成速度约提升 2 倍,所有基准成绩均在 INT4 精度下报告。
匹配字段摘要
月之暗面开源最新模型 Kimi K2.6,具备编码、长程执行和 Agent Swarm 能力,已上线 Kimi.com、Kimi App、API 和 Kimi Code。官方称其在长程编码任务上较 K2.5 明显提升,例如在 Mac 上用 Zig 实现并优化 Qwen3.5-0.8B 推理,经 4000+ 次工具调用、超 12 小时连续执行和 14 轮迭代,吞吐从约 15 tokens/sec 提升到约 193 tokens/sec。Agent Swarm 架构从 K2.5 的 100 个子智能体和 1500 步扩展到 300 个子智能体、4000 步并发执行,并新增 Claw Groups 研究预览。
匹配字段摘要
Kimi 发布 Agent Swarm,让 K2.5 在推理时自行组建带分工的智能体组织,最多并行部署 100 个子智能体、执行超过 1500 次工具调用,比顺序执行快 4.5 倍。官方称其针对单智能体顺序执行在长任务上的上下文与时间瓶颈,适用于大规模检索、批量文档处理、多视角分析等可并行场景。该功能目前为早期研究预览,后续将加入子智能体直接通信与并行宽度动态控制。
匹配字段摘要
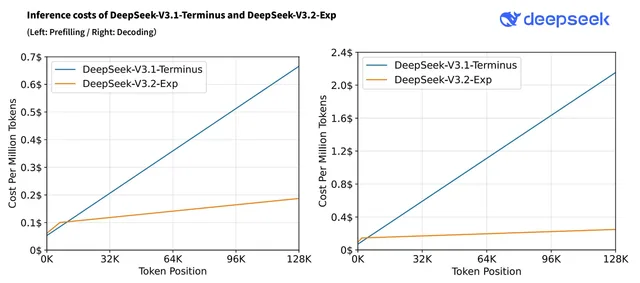
DeepSeek 发布实验模型 DeepSeek-V3.2-Exp,基于 V3.1-Terminus 构建,首次引入 DeepSeek Sparse Attention(DSA),用于提升长上下文训练与推理效率并降低算力成本。官方称基准测试显示 V3.2-Exp 与 V3.1-Terminus 表现相当,同时 DeepSeek API 价格立即下调 50% 以上。V3.1-Terminus 将通过临时 API 保留至 2025 年 10 月 15 日 15:59(UTC)供对比测试,关键 GPU kernel 以 TileLang 和 CUDA 开源。
匹配字段摘要
中国信通院产业与规划研究所发布《面向词元(Token)服务的智算基础设施发展研究报告(2026年)》,指出推理算力首次超越训练算力成为需求主体,Token 取代 FLOPS、GPU 卡数成为衡量 AI 产业价值的新标尺。报告围绕态势特征、政策导向、区域布局、技术突破、产业生态 5 个环节,梳理智算基础设施从“算力工厂”向“Token 工厂”的范式重构,技术重心转向“每瓦 Token 产出最大化”。
匹配字段摘要、正文
Conway Research 的端侧助手 Underdog 以 Apache 2.0 发布 Saluki 27B,这是 Qwen3.8-27B 的 2-bit 混合精度 GGUF,体积 7.89 GB,而 BF16 原模型需 54 GB,可在原生 llama.cpp 上运行并支持完整 GPU 卸载。在相同测试环境下,Saluki 在 Underdog Bench 的 120 项 BFCL v4 任务上得 88 分,原模型 84 分;并行工具调用 42 对 35;SWE-bench Verified 修复 30 个问题,原模型 33 个。代价是数学与多步推理下降 12 到 18 分,AIME 2025 为 79.2 对 96.7。
匹配字段摘要
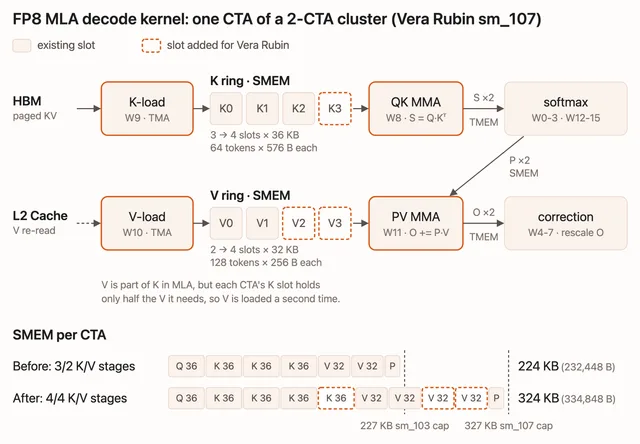
LMSYS 团队提前拿到两个 NVIDIA Vera Rubin 节点(8 块 GPU),把 SGLang 推理和 Miles 强化学习训练搬上该平台。推理侧针对 Kimi K3 NVFP4 调整了 attention、MoE/通信和 KDA 内核,例如更深的 MLA 流水线在 batch 16、128k 上下文下快 16%,融合 MoE 尾部每步减少 276 次内核启动、端到端提升 5.9%。训练侧 Miles 用 SGLang 做 rollout、Megatron 做训练,在单托盘 4 块 GPU 上开箱跑通 Qwen3-30B-A3B 的 GSM8K 训练,奖励从约 45% 升到 95%,并在 Vera CPU 上以 64 个沙箱运行 SWE-bench Verified 的智能体 RL。
匹配字段摘要
10月6日,OpenAI一次性开源了722篇数学成果,这些成果来自一个尚未发布的内部模型,涉及大量悬而未决的数学难题,平均每项成果仅消耗约3小时推理算力。文章指出,OpenAI承认其中部分证明未经严格检验,而AI产出答案的速度正在超过人类理解和验证答案的速度。作者认为,该放缓的不是技术进步,而是缺乏约束的裸奔,应把独立第三方安全评估、可核查的协调机制和发布者验证追责义务装进制度中。
匹配字段摘要、正文
正行创新在第22届亚太零售商大会(APRCE 2026)上发布面向零售开放场景的 Physical AI 解决方案,由补货、巡检、搬运机器人本体与统一机器人管理平台 M1 组成,支持“零改造”快速部署。方案依托自研轻量级世界动作模型 SLM-0.5,在 LIBERO 基准测试中实现 98.6% 平均任务成功率,推理速度较主流方案提升 24 倍;基于 RLinf 的强化学习后训练体系 STEAM 在指定商品上货任务中成功率达 95%。
匹配字段摘要、正文
Tessl 博客提出,把技能铺到各处不是到处散落 markdown 文件,而是要把上下文打包一次、做评测、保持同步并分发给人和其他 Agent。作者称自己已能在 Claude Code、Devin、GitHub Copilot CLI 等 harness 之间携带上下文,瓶颈因此从模型能力转向上下文工程,并主张先用中等推理模型、只在复杂规划或超长上下文时升级到更高端模型。

匹配字段摘要
NVIDIA KGMON 团队在 KDD Cup 2026 Data Agents 竞赛中获得第二名,方案核心是在固定的小模型外构建更小、更清晰、更易验证的 harness。团队把 CSV 和 JSON 统一转成 SQLite 表,只暴露 schema() 和 sql(query) 等少量工具,并在主推理循环前加入 schema 预检步骤,减少路由错误并保留模型的推理能力。文档检查与结构化分析分离,prose_helper 用零温度、关闭推理的独立 LLM 调用抽取答案或表格,避免原始文本占用主上下文;执行轨迹记录提示词、工具调用和中间结果,供专门的 inspector agent 归类失败原因。
NVIDIA KGMON 团队在 KDD Cup 2026 Data Agents 竞赛中获得第二名,方案核心是在固定的小模型外构建更小、更清晰、更易验证的 harness。团队把 CSV 和 JSON 统一转成 SQLite 表,只暴露 schema() 和 sql(query) 等少量工具,并在主推理循环前加入 schema 预检步骤,减少路由错误并保留模型的推理能力。文档检查与结构化分析分离,prose helper 用零温度、关闭推理的独立 LLM 调用抽取答案或表格,避免原始文本占用主上下文;执行轨迹记录提示词、工具调用和中间结果,供专门的 inspector agent 归类失败原因。
匹配字段摘要