←搜索结果

按匹配度 · 共 1346 条结果 清除搜索

星期五

  1. 蚂蚁 inclusionAI:GitHub 新仓库

    蚂蚁 inclusionAI 开源 TorchTurbo:面向 SuperNode 的后训练引擎

    蚂蚁 inclusionAI 在 GitHub 开源 TorchTurbo,一个 SuperNode 原生的后训练引擎,用于快速适配和训练 LLM 与 VLM。它基于 PyTorch FSDP2 和 Hugging Face Transformers,结合 FSDP、专家并行(EP)与 Ulysses 序列并行(SP),支持 MoE、多模态和稀疏注意力架构。目前仅支持训练,已提供 fsdp2 后端及 LlamaFactory、ms-swift 适配器,不支持评估、预测与生成。

    TorchTurbo training architecture

    MTP / MoE loss --tt enable mtp / --tt mtp loss scaling factor / --tt mtp log loss / --tt moe aux loss coeff / --tt moe z loss coeff / --tt enable chunk loss / --tt loss chunk size DeepSeek-V4 DSpark (needs MTP and a DSpark checkpoint) --tt enable dspark / --tt dspark loss scaling factor / --tt dspark num anchors / --tt dspark loss decay gamma / --tt dspark ce loss alpha / --tt dspark l1 loss alpha / --tt dspark confidence loss alpha VLM freezing --tt freeze vision tower / --tt freeze multi modal

    匹配字段正文

  2. NAVER / CLOVA 研究

    CLOVA 解读 Peri-LN:如何防止 Transformer 训练发散

    NAVER Cloud 在 ICML 2025 发表 Peri-LN 论文,重新审视 Transformer 中的归一化层位置。Peri-LN 在 Pre-LN 基础上为每个子模块输出也加归一化,已被 Gemma2、Gemma3、Olmo2 采用。研究指出 Pre-LN 在训练中方差会指数增长并出现 massive activations,而 Peri-LN 能维持均衡,避免训练发散。

    ization to hidden states after computation, helping maintain model stability. Pre-LN represents the approach adopted by modern open-source LLMs including Llama, Qwen, Mistral, and DeepSeek. This strategy normalizes hidden states before each sub-layer computation, resulting in more stable training dynamics. The emergence of Peri-LN Past studies revealed that normalization layer placement significantly affects Transformer reliability and performance, leading to extensive research on Pre-LN and Pos

    匹配字段正文

星期四

  1. The Rundown AI

    亚马逊百万机器人实验:Vulcan 触觉机械臂与 DeepFleet 调度系统

    亚马逊在仓库部署 100 万台以上机器人,并为其加入 DeepFleet AI 调度与可处理 75% 货品类型的触觉机械臂 Vulcan,DeepFleet 称可减少 10% 机器人移动时间。一项研究显示仓储机器人使严重工伤减少 40%、轻微工伤增加 77%,亚马逊称 2019 至 2025 年全球事故率下降 43%。纽约时报查阅的内部文件预计,到 2033 年自动化可能减少 60 万个以上美国招聘岗位。

    io with its general-purpose robots and underlying AI models. Austin-based ICON raised $200M to scale its robotic 3D-printing construction systems and expand into new U.S. markets. DeepSeek has reportedly agreed to lead a seed investment of tens of millions of dollars in Winverse AI, a robotics AI startup founded by a former Tencent scientist. NHTSA is reviewing a petition alleging that Tesla’s Model Y and Cybercab robotaxis exceed speed limits in active school zones while using automated driving

    匹配字段正文

  2. heise online

    OpenWiki 实测:为编码智能体构建仓库记忆

    heise online 实测 LangChain 的 CLI 工具 OpenWiki,它分析代码库并生成带链接的本地 Markdown 知识库,再依据 Git 历史中的新 diff 和提交进行更新,并通过智能体提示与 MCP 工具让内容可被检索。文章指出,AGENTS.md 或 CLAUDE.md 适合放安装命令、测试、风格规范和安全边界等简短规则,在 monorepo 中还可嵌套子目录文件,但难以充当大型快速变化仓库的完整知识模型。

    不会自动形成可靠的系统模型,而只是整体系统的零散拼图。也许只有某个特定服务才允许写入预订,或者一个看似多余的适配器将两个发布周期彼此解耦。这些关联分散在代码、测试、配置、提交历史和开发团队成员的头脑中。 OpenWiki 实测:编码智能体的记忆 指南:用来自互联网的最新事实充实本地 AI 模型 链式操作如何演变为风险:AI 智能体中的传话游戏 开放权重模型 DeepSeek-V4.1-Flash 里有什么 简要说明:N-gram 如何工作 AI 炒作:为何数据中心的超大规模扩建正受到批判性审视 失控的 AI 智能体:为何 OpenAI 等公司在美国不承担法律责任 关于 GPT-6.1 Astra 的评论:失控 AI 的障眼法 人工智能如何影响 DevOps 转型 AGENTS.md 或 CLAUDE.md 文件很适合用于简短的工作规则,例如安装命令、测试、风格规范和安全边界。AGENTS.md 可理解为一种面向智能体的 Readme,在 monorepo 中甚至允许使用具有局部作用范围的嵌套文件——即子目录中的额外 AGENTS.md 文件,例如 packages/api/AGENTS

    匹配字段正文

  3. Unite.AI

    OpenAI 计算战略与 GPT-Infra 副总裁 Sachin Katti 宣布离职

    OpenAI 计算战略与 GPT-Infra 副总裁 Sachin Katti 于 10 月 14 日宣布离职,最后工作日为 11 月 15 日,之后将以顾问身份继续支持 OpenAI。他称过去一年帮助推进了“史上最大规模的 AI 计算基础设施扩建之一”,拿下两位数吉瓦新增算力,涉及 Ohio、Portsmouth、Georgia 和 Trainium 等项目,合作方包括 NVIDIA、Broadcom、AMD、Oracle、Microsoft、Google、AWS、Cerebras 和 CoreWeave。

    delivered 1.5 to 1.9 times more AI work per watt at peak throughput and 1.7 to 3.6 times lower end-to-end latency than comparison systems across three public models: GPT-OSS 120B, DeepSeek R1 and Kimi K2.5 1T. OpenAI said it tested Jalapeño on InferenceX, a public benchmark from SemiAnalysis, and that the chip is rated at 700 watts while its measured sustained power remained at or below 550 watts on the workloads tested. A month before his departure announcement, Katti wrote that OpenAI’s comput

    匹配字段正文

星期三

  1. 智东西

    APUS 开源 Reflex Agent,用决策模型接管 Agent 调度

    APUS 开源 Reflex Agent,采用自研 Reflex 决策模型完成 Harness 中的决策环节,围绕无限记忆、无损记忆、无损输入构建无限上下文方案,面向可长期持续处理任务的 Personal Agent。该项目以 MIT 协议开源,提供桌面端、Web 和 SDK;Reflex 基于 Qwen3.5 的 4.5B 参数模型微调,测试场景下页面响应速度相比同类 Agent 提升 2-3 倍。

    月,APUS转向科创板再度冲击IPO,然而最终依旧终止了。 目前,APUS已经形成基座大模型+AI应用产品框架。 2023年,APUS发布了自研的千亿级多模态大模型“APUS大模型(AiLMe)”,此后,其于2024年4月联合开源了千亿参数MoE架构模型APUS-xDAN-4.0。 在大模型的基础上,APUS构建起了产品体系: 通用与语言模型包括天燕大模型和DeepSeek APUS加强版;垂直行业大模型包括奇黄大模型(医疗问诊)与智草大模型(中医诊断)等,覆盖教育、农业、网信、政务、传媒、金融、电商等领域。 基于大模型能力,APUS还推出了一系列直接面向用户的AI应用。C端手机应用包括APUS Launcher、APUS Booster、APUS Security、APUS Browser、APUS KATOO、APUS CutCut等;B端行业智能体有天燕商业智能体、智草中医智能体、智能诊疗平台等。 结语:为智能体长任务提供新解法 当下AI Agent赛道热度高涨,但长任务失忆、工具调用延迟仍是阻碍实用化的核心难题。 APUS此次开源Reflex Agent,跳出 “大模型包揽全部

    匹配字段正文

  2. Tomasz Tunguz 博客

    前沿模型智能接近,单位任务成本相差 3.8 倍

    五款前沿模型的智能水平相差不到 5 分,但单位任务成本相差 3.8 倍。Google 的 Argon 以每任务 1.99 美元处于最低位,比最贵的 Fable 5.1 低 74%,比 Opus 5.5 低 67%、比 Muse Wonder 低 56%、比 Astra 低 39%。作者认为这与 Google 自研 TPU 十余年的积累有关,并援引 Microsoft Maia 300 与 OpenAI 推理芯片 Jalapeño 的公开数据,判断随着每瓦智能每六个月翻倍,token 价格会继续下行,前沿模型利润率仍可维持在 40% 至 70%。

    y-leading speed and efficiency in AI inference”, August 25, 2026, reporting results measured on SemiAnalysis’s InferenceX suite with OpenAI engineers present, across GPT-OSS 120B, DeepSeek R1 670B & Kimi K2.5 1T. OpenAI normalized to published package power & reports Jalapeño’s sustained draw at or below 550W against a 700W rating. Three caveats apply : the comparison is against Blackwell-generation GB200/GB300 rather than the newer Vera Rubin platform, which also uses HBM4 & began shipping to c

    匹配字段正文

  3. 36氪 · AI

    AI视频价格从元降到分,可灵、Vidu、Seedance 卷向性价比

    36氪转载光锥智能文章指出,AI视频旗舰模型入门价正从元级降到分级:生数 Vidu Q4 Preview 首发优惠 0.09 元/秒起,可灵 Kling 4.0 与轻量版 Flash 开启内测但 API 定价未公布,字节 Seedance 2.5 同规格定价则较上一代上浮。文章认为价格战的前提是交付质量提升,Seedance 2.0 一次生成成功率最高约 90%,而此前行业平均约 20%,一致性瓶颈松动后竞争转向性价比与差异化能力。

    视频模型的DeepSeek时刻,本质不是低价,而是物美价廉。 9月28日,快手可灵AI的Kling 4.0开启内测,把单次原生视频时长拉到了30秒,画质干到4K,同时首个“轻量版”模型Kling 4.0 Flash上线,主打出视频速度快,价格也要往下走,不过目前其API定价尚未公布。 10月8日,生数科技Vidu Q4 Preview发布,支持15张参考图、3段参考音频、同样4K直出,同时延续了以往“又好又快”的优势——他们把首发价格打到了最低0.09元每秒。 如今,内容端的需求爆发吸引了大量厂商入场,同时也倒逼行业开始卷“标准”:人物情绪够不够细腻、叙事能不能抓住人、整体质感能不能撑住成片。 原来动辄需要一个动画团队手搓几个月的视频,交给AI,它能把脚本故事完美地讲出来:一张张飞舞的日历垒起高楼,再缓缓向着主人公的方向倒塌......时间的紧迫感扑面而来。看完不由得“震惊瘫坐”了。 从7月MiniMax H3打出“地板价”开始,价格普惠的浪潮一浪高过一浪。越来越多的创作者终于有底气大量尝试用AI视频的形式完成表达。于是,从可灵到生数,成本优化成了最新一轮模型角力的关键项。 但在工业应

    匹配字段正文

  4. 钛媒体 · AGI

    大厂醒悟了,卷模型不如卖芯片

    IDC数据显示,2026年上半年中国数据中心AI加速器出货200.8万颗,非GPU加速器出货101.6万颗,规模首次超过GPU,英伟达份额34%仍居第一,但与华为昇腾的差距只剩6个百分点。文章梳理出大厂芯片变现的两条路径,一是华为昇腾超节点、阿里真武V900等硬件方案,二是百度昆仑芯分拆上市、阿里平头哥独立上市等资产化操作。产能成为新瓶颈,国内算力需求达供给10倍以上,部分产品交付排期延到一年以后。

    会。同一类任务反复运行,芯片就可以围绕特定模型和场景优化,把每次调用的成本降下来。有机构预估,在适配的推理场景下,定制化芯片的能效比可达到通用GPU的1.5至3倍,单位算力成本降低35%以上。 眼看推理芯片成了一门好生意,想进场的大厂越来越多。腾讯7月推出紫霄2.0,主要供自家业务使用,计划年底推进十万卡部署;据报道,字节的芯片研发团队已超过千人;连模型公司DeepSeek,都被曝出在自研推理芯片。 不过,想把芯片卖给外人,先得在自己家里跑通。 国内大厂现在也已经跑通了。百度集团执行副总裁、百度智能云事业群总裁沈抖介绍,昆仑芯P800“已在百度内部得到全面验证”,承担了百度绝大部分推理任务之后,才推向外部行业。中国移动的十亿级推理型集采中,昆仑芯三个标包分别拿下70%、70%和100%的份额。 02 生成式AI热潮之前,亚马逊就为AWS布局自研芯片,原本是给云服务降本。到了AI时代,更便宜的训练和推理算力,成了它吸引外部客户的卖点,Anthropic和OpenAI先后承诺使用Trainium。今年二季度,包含Trainium和通用计算芯片Graviton的芯片业务,年化收入运行率超过2

    匹配字段正文

  5. 虎嗅

    全球寻找下一个乌兰察布:AI算力选址的全球候选地与短板

    乌兰察布凭借约0.32-0.36元/度的到户电价、最低可达1.1的PUE和直通北京4.2毫秒以内的时延,成为亚太最大AI算力集群之一,截至今年6月数据中心容量承诺约12.5GW。文章分析西班牙阿拉贡、马来西亚柔佛、日本千叶、中亚和阿联酋等候选地,指出它们在电力制度弹性、能源结构、人才或地缘风险上各有短板。中国算力出海已锁定柔佛和中亚等落点,字节跳动、阿里云、腾讯云及华为等企业已有布局或合作。

    古可能是全球“本地电力供过于求”最显著的行政区域。截至2025年底,内蒙古风电装机超100GW,全国第一;同时还有约130GW的化石燃料发电容量。如此庞大的电力产能,本地工业负荷根本消化不掉。 内蒙不缺电,而数据中心本质上是一个“电力消纳工具”,理解了这一点,才能理解为什么乌兰察布的扩张速度远超市场预期。从华为、阿里、字节跳动、快手等互联网巨头,到备受瞩目的DeepSeek、Z.ai等AI新贵,纷纷在这片草原上圈地盖楼。 图源:高德地图 然而,算力饥渴是全球性的。随着大模型训练与推理需求呈指数级爆发,全球范围内的云巨头、科技新贵与主权基金也在极力寻找下一个“乌兰察布”。 那么,全球还有哪些地方,具备类似的组合条件? 西班牙阿拉贡:欧洲版的最强候选之一,但缺一张牌 在欧洲这片向来以高电价、严环保和漫长行政审批著称的土地上,西班牙东北部广袤而人口稀少的阿拉贡(Aragon)地区,正像极当年的乌兰察布一样,试图上演一场欧洲版的“算力逆袭”。 长期以来,欧洲在AI基础设施建设上远落后于中美。为了打破这一僵局,阿拉贡地方政府选择直接为科技巨头“开绿灯”。他们推出了名为“PIGA”(阿拉贡公共利益

    匹配字段正文

  6. heise online

    KI-Harness 解析:LLM 背后看不见的脚手架

    heise online 发文解析 LLM 的 Harness 概念:它指让大语言模型真正投入使用的整套指令、配置与辅助程序,负责提供上下文、强制安全保证、评估任务是否完成,并让模型与其他程序交互。文章指出 Harness 一词用法极广,目前没有公认定义,通常只能反向界定为“不是 LLM 本身”。

    提供上下文,应当强制实施必要的安全保障,评估任务是否被成功处理,并允许 LLM 与其他程序交互。所有这些加在一起就是 Harness——至少如果宽泛地理解这个词的话。 这就是我们 heise-Plus 文章《AI Harness 解析:LLM 背后看不见的脚手架》的试读部分。通过 heise-Plus 订阅,您可以阅读整篇文章。 无论少开还是多开、小电池还是大电池:ID. Polo 相比 Raval、Polo 和 Ibiza 是否划算、何时划算,我们的成本对比将为您揭晓。 我们用横切锯、封边机和多功能工具搭建一个工作台。 由于身份已成为 IT 的新安全边界,因此必须对其格外加以保护。策略是其中最重要的防护工具。 Onleihe 3 将本地图书馆的数字媒体带到 iPhone 和 iPad 上。我们详细查看了这款应用。 凭借 DeepSeek-V4.1-Flash,这家中国供应商向 OpenAI 和 Anthropic 施加价格压力。该模型规模有所增长,并采用了全面更新的架构。 借助 DNS-01 挑战,自托管服务可以使用 Let's Encrypt 证书加以保护,而无需从互联网上可访问。

    匹配字段正文

  7. 钛媒体 · AGI

    周鸿祎谈AI:尽头不是能源,是安全

    360集团创始人周鸿祎在钛媒体《DeepPractice深度实践》访谈中判断,AI失控是确定性事件,AI的尽头不是能源而是安全治理。360自研AI攻防系统“图龙锋”上线三个月自动挖出上万个漏洞,包括Windows、Office潜伏七八年的老漏洞,以及Codex、Claude Code、OpenClaw等主流Agent平台的漏洞;配套自动化防御体系“仪天阵”以模型对抗模型。周鸿祎主张以模治模、用AI对抗AI,并认为中国在开源生态上“绝对必胜”。

    更好的方法,类似蒸馏,成本很低、效果很好。于是拿一个几百亿参数的小基座模型,比如千问的27B或者35B,把企业内部私有知识训进去,训出一个专业模型。它不需要啥都懂,懂我的业务就行,算力开销小、速度快,专业工作的得分比通用大模型还好,那大家为什么不用?所以黄仁勋也出来力挺开源模型。每年花上千万美金买OpenAI的Token,还是花几百万美金买点算力、装上中国的DeepSeek,相当于给员工实现了Token Free。 主权模型4.0,我认为明年就会到。不见得对所有人,但很多人可能会在自己家里弄一个大模型,我怀疑湘明你已经弄了。 刘湘明: 我家里现在装了个8B的模型,但太小,啥也干不了。 周鸿祎: 对,啥也干不了。现在把DeepSeek V4跑满血版,可能还要花几十万买硬件。但我预言2027年、2028年,1万块钱左右的硬件就能装一个今天的DeepSeek V4这样的模型,很多人在家里就配一个。因为在家里,你的个人隐私数据、摄像头数据都接在上面,不希望它们被传到云端去训练;实在干不了的少数活,把信息脱敏之后再发给云端。所以未来全世界的算力不会都消耗在几家云厂商身上,会有很多分布式的算力。

    匹配字段正文

  8. 钛媒体 · AGI

    所有App都在塞AI,但用户已经烦了

    QuestMobile 数据显示,2025 全年内嵌 AI 应用插件的月人均使用频次同比增速是独立 AI App 的 2.8 倍,月人均使用时长增速是 3.3 倍,但越来越多用户开始反感 App 强行塞入 AI。产品经理认为企业做 AI 更多出于对掉队的恐惧,接入门槛和成本已大幅下降,问题在于如何做、做多深以及什么时候做。

    加入了AI导购。 ● 图源:App截图 在海外,各个软件大规模接入AI的行为,被一些人称为“AI washing”(洗AI)——为了跟上趋势,给产品贴上AI标签。当AI无处不在,用户开始产生抵触情绪,这种现象被称为“AI fatigue”(人工智能疲劳)。 过去,拒绝AI是一件很容易的事情,可以不下载、不注册、不使用;如今,当我们谈论AI,谈论的不仅是豆包、DeepSeek、ChatGPT这类大语言模型,也不仅是AI陪伴、AI翻译这样的独立应用,而是早已成为我们生活一部分的事物。 有人不喜欢App里的AI,其实是不喜欢失去自主关闭它的权利。“我要用AI,会自己寻找AI工具。”为此,有人在更新前,养成了先看下一个版本是否插入了AI的习惯,有人直接卸载App,重装了没有AI功能的旧版本。 许多用户并不排斥AI,他们真正反感的是一个没有提供足够价值的AI。Seany认为,如果AI带来的新体验无法超越用户原来的使用方式,甚至增加了学习成本,那用户自然会觉得它鸡肋。“它没有让用户觉得‘没有它不行’,反而让用户觉得‘原来的方式挺好的’。” 但Seany也承认,这是AI应用早期必然经历的阶段。“你不

    匹配字段正文

  9. OpenRouter:Announcements

    OpenRouter 推出 Private Endpoints,把自有模型部署接入统一 API

    OpenRouter 上线 Private Endpoints,让企业把微调模型、专属部署或预留容量注册为私有端点,继续用现有 API、model slug 和路由偏好调用,公共提供商可作溢出备份。该功能是 Enterprise 套餐附加项,端点仅组织内可见,不进入公开模型列表、排名与基准;默认每组织最多 10 个,需通过 BYOK 密钥验证后激活,并可用 Management API 或 Terraform provider 管理全生命周期。

    Private Endpoints: Bring Your Fine-Tuned Models and Capacity to OpenRouter

    organizations you approve can see it, and it never shows up in public model lists, rankings, search, charts or benchmarks. If your organization has a dedicated Azure deployment of DeepSeek V4 Pro for example, you can register it as a private endpoint for deepseek/deepseek-v4-pro and your apps keep calling that slug. For your organization it moves to the front of the provider list by default, and Model Fallbacks, Provider Selection and the rest of routing work as they do for any provider. OpenRou

    匹配字段正文

星期二

  1. Modal 官方工程博客

    Modal 研究混合精度、混合加速器采样器上的强化学习

    Modal 工程博客提出用离策略修正让 RL 采样器与训练器解耦,从而在混合精度、混合加速器上稳定训练。实验用 Miles 框架、SGLang 采样器和 Megatron-LM 训练器,在 B200 上以 BF16 训练 Qwen3.6-35B-A3B 做智能体编码任务,采样器分布在 B200、B300、H100、H200、A100 和 RTX PRO 6000 六类加速器上,分别使用 NVFP4、FP8 和 BF16 权重。加入掩码重要性采样、分数居中和 top-p 掩码回放后,混合采样器在 SWE-bench Pro V2 上与同构采样器持平,HARD-51 上 pass@4 稳定在约 65–75%,且多数训练阶段每次更新的采样成本低约 15%。

    er’s current weights. Bitwise-identical sampling and training has been demonstrated. Open RL frameworks make the two identical for small models and nearly identical for GLM-5, and DeepSeek-V4 built batch-invariant, deterministic kernels to make its training and inference bitwise reproducible. Matching every source, though, has a cost: Most of these sources change only token probabilities, which correction accounts for. Multi-turn context and top-p / top-k sampling break the shared context and sh

    匹配字段正文

  2. 腾讯混元 Research

    腾讯混元提出 GradLoc 与 LayerClip:定位 RLVR 训练崩溃的异常词元

    腾讯混元提出梯度异常定位器 GradLoc,基于分布式二分搜索将 RLVR 训练中的梯度突刺定位到单个异常词元,复杂度为 O(log N)。GradLoc 还识别出一类新崩溃模式——层间梯度异质性:异常词元的重要性采样比率处于合理区间,但某些层的梯度范数极端大。为此团队提出分层梯度裁剪 LayerClip,基于各层历史统计量分别施加动态约束,显著提升 RLVR 训练稳定性。

    lip),基于各层的历史统计量分别对其梯度施加动态约束,从而显著提升 RLVR 训练的稳定性。 (详见 §Type B 解决方案: 分层梯度裁剪) 梯度突刺导致的RLVR 训练崩溃 训练易崩溃是大语言模型的可验证奖励强化学习(Reinforcement Learning with Verifiable Rewards,RLVR )[^OpenAI o1][^DeepSeek-R1] 的重要挑战,这种训练崩溃常表现为模型性能指标在训练中的突然下降,伴随着频繁的 梯度突刺 (gradient spikes)。现代大模型训练框架[^verl][^areal][^slime]为支持基于长思维链推理的高效 RLVR 训练,引入了KV-cache 量化[^KVQuant]、自定义 kernel 融合[^vLLM]、异步数据生成[^Kimi k1.5] 等加速手段,进一步放大了这种不稳定性。这些加速策略会引入来自数值精度损失、数据陈旧等来源的近似误差,导致工业生产中的 RLVR 训练逐渐演化成为一个复杂系统,使得 RLVR 难以在长期训练中保持稳定,且使对 RLVR 训练动态的分析变得困难。 本质上

    匹配字段正文

  3. 腾讯混元 Research

    腾讯混元发布 Hy-MT2 多语言翻译模型族

    腾讯混元发布 Hy-MT2 多语言翻译模型族,包含 Hy-MT2-1.8B、Hy-MT2-7B 和 Hy-MT2-30B-A3B,支持 33 种语言互译并遵循多语言翻译指令。在 FLORES-200 的 XX⇔XX 设置下,三款模型分别达到 79.77、86.89 和 87.47,相当于 Gemini 3.1 Pro 思考模式的 89.9%、97.9% 和 98.6%。模型提供 1.25-bit、2-bit、4-bit、8-bit 和 FP16 多种精度,其中 1.25-bit 版本基于自研 AngelSlim 技术,仅需约 440MB 存储,在苹果 A15 上推理速度相比 Hy-MT1.5 的 4-bit 版本提升 1.5 倍。

    ghtarrow$XX 设置下,Hy-MT2-1.8B、Hy-MT2-7B 和 Hy-MT2-30B-A3B 分别达到了 79.77、86.89 和 87.47,分别相当于 Gemini 3.1 Pro$^{\mathrm{T}}$ 的 89.9%、97.9% 和 98.6%。特别是在该设置下,Hy-MT2-7B 和 Hy-MT2-30B-A3B 表现优于 DeepSeek-V4-Pro、Kimi K2.6、Qwen3.5-397B-A17B 和 Gemma4-26B-A4B 等强劲的基线模型。与 Hy-MT1.5-7B 相比,Hy-MT2-7B 将 XCOMET-XXL 评分从 80.98 提升至 86.89,展示出在整体多语言翻译性能上的明显优势。 在 WMT25 上,Hy-MT2-7B 和 Hy-MT2-30B-A3B 同样表现强劲。Hy-MT2-7B 取得了 63.86/71.21/82.24 的成绩,而 Hy-MT2-30B-A3B 达到了 62.89/71.08/84.34。相比于评分为 61.59/68.85/75.91 的 Hy-MT1.5-7B,Hy-MT2-7B 在

    匹配字段正文

  4. 腾讯混元 Research

    当大模型强化学习走向规模化,Batch Size Scaling 有什么不一样?

    腾讯混元研究团队从第一性原理重新审视 LLM 强化学习的 batch size 规模化规律,提出以 time-to-target 为标准的分析框架:只有吞吐增益 r_q 超过样本代价 r_N 时,更大的 batch 才能缩短训练时间。实验在 GRPO 上使用 Qwen3-30B-A3B-Instruct-2507 与 DAPO-MATH-17K 子集,按平方根规则重调学习率后,prompt batch size 从 P=64 扩大到 P=1024 仍保持学习曲线近似对齐,P=2048 和 P=4096 时开始偏离。

    调整学习率后,B、2B 和 4B 在累计样本维度上保持近似相同的学习进度;其中更大的 Batch 因吞吐更高而更快“登顶”。但扩大到 16B 后,样本效率损失超过吞吐收益,登顶反而比 B 更慢。图例给出了归一化 time-to-target。 引言 预训练为大语言模型建立了新的能力基线;强化学习则通过在新环境和新任务中的探索与反馈,决定模型还能继续进步多远。DeepSeek-R1 展示了大规模强化学习如何仅使用少量标注数据发展出强大的推理能力。[^r1] 随着 Grok 4 的发布,xAI 进一步扩大了计算规模:据其介绍,Grok 4 使用拥有 200,000 张 GPU 的 Colossus 集群,以预训练规模运行强化学习,所使用的计算量超过此前 RL 工作的一个数量级。[^grok] 随着强化学习在模型开发中的占比不断提升,其 效率 也会对训练预算产生越来越大的影响。 考虑一个示例预算:假设 10,000 张 GPU 连续运行 30 天,每张 GPU 每小时的成本为 3 美元,那么总成本将达到 2,160 万美元 。如果在达到相同模型质量的情况下,训练时间缩短 10%,那么按照这一

    匹配字段正文

  5. InternLM 原创项目

    InternLM 开源 AdaptiveGEMM:支持不同 Group M 长度的 FP8 GEMM

    InternLM 发布 AdaptiveGEMM,在 DeepGEMM 基础上支持不同长度的 group M,并新增 Group K GEMM 支持,每组 k 需补齐到 128x。该项目要求 Hopper 架构 GPU(sm_90a)、Python 3.8+、CUDA 12.3+(推荐 12.8+)、PyTorch 2.1+ 和 CUTLASS 3.6+。

    ty of the original DeepGEMM. NOTE: k in each group should be padded to 128x Quick start Requirements Hopper architecture GPUs, sm 90a must be supported; Python 3.8 or above; CUDA 12.3 or above But we highly recommend 12.8 or above for the best performance; PyTorch 2.1 or above; CUTLASS 3.6 or above (could be cloned by Git submodule) If you find our work useful, please cite: Original deepgemm To get detailed information of original deepgeem, please refer to https://github.com/deepseek-ai/DeepGEMM

    匹配字段正文

  6. 小米 MiMo 官网发布与博客

    小米详解 MiMo-V2.5 推理系统优化实践

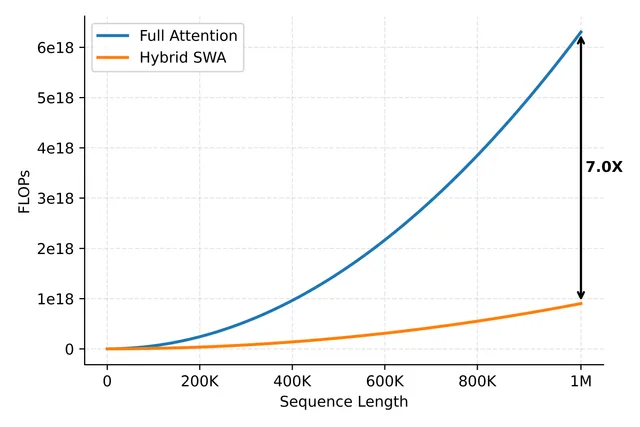
    小米 MiMo 团队发布 MiMo-V2.5 系列推理系统的端到端工程实践,覆盖 KVCache 管理、分层缓存、SWA 感知前缀缓存树、调度策略、Prefill/Decode 执行流水线与多模态优化。MiMo-V2.5-Pro 共 70 层,其中 10 层 Full Attention、60 层 SWA,滑动窗口为 128,Hybrid SWA 使计算量与 KVCache 存储降至 Full Attention 的约 1/7。团队称上线以来服务端 KV Cache 命中率平均 93%,重度用户可达 95% 以上,并将部分优化以 PR 形式回馈 SGLang 社区。

    Attention FLOPs vs sequence length: Full Attention vs Hybrid SWA, roughly a 7.0× compute reduction

    varies greatly across different model architectures, and access patterns also differ. As shown below, MiMo-V2.5-Pro and MiMo-V2.5 rank second in KVCache efficiency, trailing only DeepSeek-V4-Pro and DeepSeek-V4-Flash. It is worth noting that actual cost differences do not strictly correspond to KVCache size ratios, as there are fixed compute and memory access costs independent of sequence length. However, in long-context scenarios, the overall trend holds: the gains are marginal for short seque

    匹配字段正文