←搜索结果

按匹配度 · 共 1346 条结果 清除搜索

星期二

  1. OpenAI:部署安全与系统卡

    OpenAI 发布 gpt-oss-120b 与 gpt-oss-20b 模型卡

    OpenAI 发布 gpt-oss-120b 和 gpt-oss-20b 两个开放权重推理模型,采用 Apache 2.0 许可,兼容 Responses API,支持工具调用、完整 CoT 与可调推理强度。gpt-oss-120b 为 36 层 MoE 架构,116.8B 总参数、5.1B 激活参数,MoE 权重以 MXFP4 量化后可放入单张 80GB GPU;gpt-oss-20b 为 24 层、20.9B 总参数、3.6B 激活参数,可在 16GB 内存设备上运行。OpenAI 对 gpt-oss-120b 做了对抗性微调测试,其安全咨询组认为即便使用其训练栈进行微调,模型也未在生物化学与网络安全两个类别达到 Preparedness Framework 的高能力阈值。
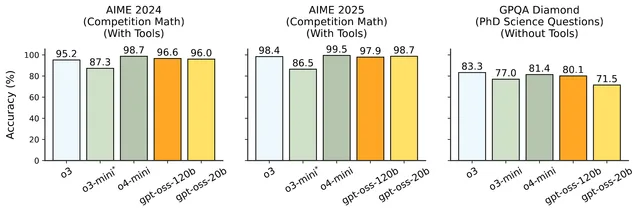
    Figure 1. <em>Main capabilities evaluations</em>. We compare the gpt-oss models
at reasoning level <code>high</code> to OpenAI’s o3, o3-mini, and
o4-mini on canonical benchmarks. gpt-oss-120b surpasses OpenAI o3-mini
and approaches OpenAI o4-mini accuracy. The smaller gpt-oss-20b model is
also surprisingly competitive, despite being 6 times smaller than
gpt-oss-120b. <em>*Note:</em> o3-mini was evaluated on AIME without
tools, see Table <a class="xref-link" data-xref="tab:all_evals" href="/gpt-oss/full-evaluations#tab:all_evals">3</a> for the gpt-oss
models on AIME without tools

    gical capabilities in open source foundation models? To investigate this question, we compared gpt-oss-120b to other released open source models. At first, we primarily considered DeepSeek R1-0528. Partway through our process, the Qwen 3 Thinking and Kimi K2 models were released, and we added these to our comparison set. These evaluations confirmed that Qwen 3 Thinking and Kimi K2 have advanced to a level such that gpt-oss-120b does not significantly advance the state of the art on biosecurity-r

    匹配字段正文

  2. Latent Space精选

    Meta MSL 发布 Muse Wonder 与 Muse Wonder Full 模型

    Meta Superintelligence Labs 发布第二代模型家族 Muse Wonder 与 Muse Wonder Full,前者定位快速前沿模型,后者为完整版本,Meta 称其面向个人与专业智能体工作。Artificial Analysis 的 Intelligence Index v4.3 中 Wonder Full 得 56 分、Wonder 得 52 分,高于 Muse Spark 1.3 的 48 分,Opus 5.5 以 58 分领先。规格为 1M 上下文,输入支持文本、图像、视频和音频,输出仅文本,定价为每百万 token 输入 4 美元、缓存输入 0.20 美元、输出 20 美元。

    e: A Qwen3.5-9B fine-tune for fraud prevention outperformed frontier models at lower cost and latency (@brian armstrong). River AI: Launched inference 20% cheaper than first-party DeepSeek V4.1 Flash and GLM-5.3 Flash, plus on-prem custom model training (@ibab, on-prem). Decision models: Several groups released models that select from a set of options rather than generate text. Decision 3.0: Open models from 0.6B to 27B, ranked 1 on Jev Decision Index boards (@XunzhuoLiu). SubQ Snap: 384K contex

    匹配字段正文

  3. 虎嗅

    字节掘金者:最贵的是光环

    2026年字节系AI创业者天使轮融资额度从一年前的400万美元起腰斩至200万美元,但红杉、IDG、高瓴、锦秋基金等机构仍系统性围猎字节人才,字节系创业者享有1.5-2倍估值溢价且融资更快。至今字节系未跑出定义行业标杆的人物,其共享的“以终为始、极致执行”方法论被指善于解题而非定义问题。

    公司,在微信做事的方式是思辨层面穷尽所有可能,内部互相 battle,验证 OK 才推功能,来自张小龙的古典产品风格;在字节要快速验证,不行就换方向,字节喜欢的员工,聪明,外在敢于表达、敢于争取资源;内在能把事情逻辑理顺,大家拼命给自己找事情,精神上很卷,所以确实适合出创业者。” 但矛盾之处是:这一波 AI 创业者,定义关键范式和标杆型人物都不出自字节系——DeepSeek、模型六小龙(清华系/微软系/商汤系),包括 Manus。即便横向对比大厂背景,也有百度景琨的 Genspark 和阿里林俊旸的天使轮 20 亿美元估值。 至今为止——客观说,从字节系跑出来、看起来数据最好的是演语科技的陈冕,ARR 突破 3 亿美元,已启动港股 IPO 筹备。但陈冕的高增长换规模的模式来自古早的单车大战,商业化未被验证(亏损状态)。 更深层的问题:字节系的创业者似乎不善于定义“问题”,更善于“解题”。他们是被同一套训练体系培养。比如AI闹接触的大部分字节系创业者都共享一套战略方法:以终为始,再极致执行。 在字节,业务负责人被要求每半年更新一次年度规划,每年更新三年计划,且必须以“如何做到全世界第一名

    匹配字段正文

  4. 虎嗅

    卡内基报告:中国首超美国成顶尖AI人才第一工作地,但人才仍净流出

    卡内基中国9月23日发布的全球AI人才报告显示,2025年全球顶尖AI研究者中41%在中国工作、34%在美国,三年前这组数字是27%对46%。报告追踪NeurIPS 2025的10280位作者履历,指出中国净流出1729人、美国净流入2145人,在中国工作的顶尖研究者98%本科在中国就读,美国这一比例仅约三成。机构排名中北京大学升至第一,清华第二、上海交大第四,报告同时承认样本偏学术界、低估了产业界。

    国”并存格局。 2. 中国“自产自销”,美国“全球吸纳” 在中国工作的顶尖AI研究者98%本科就读于中国;在美国工作的仅三成本科在美国就读。每30个在美工作的中国本科出身者,仅对应1个在华工作的美国本科出身者。 3. 北大登顶机构排名,高校“学生军”成主力 机构排名第一为北京大学,清华第二、上海交大第四。谷歌等前沿实验室因商业保密减少公开发表,榜单偏学术界;DeepSeek等中国公司则以开源论文作为招聘广告,博士生成研究主力。 4. 人才竞争以街区为单位,城市集聚效应显著 北大清华仅隔一条街,韩国KAIST依托大德研发特区,新加坡两所大学靠城市国家优势进入前20。国内杭州虽无顶尖高校入围,却因DeepSeek和阿里成为主要人才赢家。2026-10-13 08:15卡内基报告:中国首超美国,成顶尖AI人才第一工作地TOP创新区研究院速览 本文来自微信公众号: TOP创新区研究院 ,作者:人才研究组 去年年底,全球最顶级的AI学术会议NeurIPS,第一次在两座城市同时开。 主会场在美国圣地亚哥,分会场设在墨西哥城,大约500个座位。 论文被录用、却去不了圣地亚哥的作者,优先分到墨西哥城。

    匹配字段正文

星期一

  1. 上观新闻

    上海落地全民AI通识教育:贯通全龄、普惠万家

    获评“全球学习型城市奖”的上海已落地贯通全龄、普惠万家的“全民AI通识教育”新场景,上海开放大学开设的AI短剧、AI短视频创作班累计培养数百名掌握AI创作全流程的应用型人才,学员最年长78岁。截至2026年9月,上海老年大学累计举办AI专项培训140场,线上线下覆盖近132万人次;近千个AI相关数字化学习资源覆盖16个区社区教育网络。

    获满满。他说:“我准备把AI培训算法内容运用到实际的工程创新中,为自己的职业转型打下良好基础。” 由上海市总工会与上海开放大学联合打造的公益品牌“匠心学堂”,面向全市各行各业职工免费开放。全新升级推出以“我与AI有个约会”主题的职工AI系列课程,让前沿技术与一线岗位真正产生连接。讲解AI大模型向多智能体协同发展方向的同时,老师边演示、学员边动手,打开手机上的DeepSeek、豆包等工具同步练习。这种实战导向的教学打破了单向讲授的模式,让学员们带着问题进门、带着方法离开。 “匠心学堂”授课现场座无虚席 阮征是上海一家智能幕墙公司的青年高级工,为了不落下每一堂课程,他常常骑行公路车,跨越闵行至杨浦的漫漫路途奔赴课堂,风雨无阻。年长者的学习热情也不亚于年轻人,已退休的陈占华每堂“匠心学堂”AI课程都会提前到场,稳稳坐在前排专心听讲、紧跟课堂节奏,主动拥抱新知。 嘉定区围绕十大生活化场景开发AI智慧家居实训包 【资源下沉打通AI学习“最后一公里”】 在上海,近千个AI相关数字化学习资源,覆盖16个区社区教育网络,包括短视频拍摄与AI剪辑、智能手机AI应用、AI图像与视频、AI机器人、AI智能生

    匹配字段正文

  2. 智东西

    上海大模型公司模思智能完成超10亿元Pre-A轮融资

    上海大模型公司模思智能(MOSI)宣布完成超10亿元Pre-A轮融资,由华控基金领投,国开科创、上海科创基金等参与,老股东元禾控股等持续投资,资金将用于全模态实时交互智能研发与全球商业化落地。这是该公司今年第二次官宣融资,3月曾完成由IDG资本领投的数亿元天使轮。模思智能孵化于复旦大学邱锡鹏团队的OpenMOSS,2026年以来已发布20多个模型,覆盖语音、音频、视觉理解与内容生成,并即将推出全模态实时交互系统MOSS Live。

    产业基金、奇绩创坛、智谱系基金星连资本及某头部产业投资方联合投资。 据官方披露,本轮融资资金将主要用于全模态实时交互智能的研发与能力建设,以及全球商业化落地。 模思智能孵化于复旦大学教授邱锡鹏带领的OpenMOSS团队。2023年2月,邱锡鹏团队推出国内首个类ChatGPT开源模型MOSS。此后,该团队陆续推出语音、视觉及多模态系列模型。 ▲邱锡鹏 与智谱、DeepSeek等在通用大模型、推理及Coding等领域持续投入的厂商相比,模思智能更加聚焦语音、视觉及实时多模态交互,让AI能够持续感知和理解真实环境,并应用于AI眼镜、智能汽车、机器人等终端场景。 一、半年推出20多个模型,瞄准全模态实时交互 2026年以来,模思智能进一步加快模型迭代,在半年多时间里发布了20多个模型,并持续推进开源。 其已陆续推出MOSS-TTS、MOSS-Audio、MOSS-Transcribe-Diarize、MOSS-VL、MOVA等系列模型,覆盖语音生成、音频理解、语音识别、视觉理解及内容生成等领域。 其中,仅4月7日至13日一周,MOSS-VL和MOSS-Audio就连续迭代出6个版本。7月初,该

    匹配字段正文

  3. 智东西

    沨呵智慧提出 TEF 与 TFI 两大指标,构建 Token 工厂精益运营飞轮

    沨呵智慧智算产品总监丁阔在 2026 全球 AI 芯片峰会上提出 Token 工厂运营指标体系:TEF(Token 效率因子)由 GPU 可用率、算力占用率和有效计算效率决定,优秀水平线为 40% 以上;TFI(Token 工厂指数)结合 TEF、服务交付率、Token 售出率和价格实现率,优秀水平为 35% 到 45%。两大指标形成飞轮效应,帮助企业诊断和调整参数以改善 Token 业务利润。

    往往要签订非常长期的采购合同。 除去上面提到的云厂商,国际市场上还有另外一类玩家,我们称之为 Neocloud,可以理解为”专卖店”型的 GPU 云。Neocloud 只提供高质量、高性价比的 GPU 算力服务,实际上是 AI 云大厂在资源上的一种互补。 国内市场主要有四类玩家。第一类是云大厂,比如阿里、腾讯、火山等;第二类是模型公司,字节、智谱、Kimi、DeepSeek 等,对算力集群的需求量非常大;第三类是运营商,算力的”国家队”,由整个基础设施托底;第四类是 AI Infra 独立厂商。 AI Infra 独立厂商又可细分为两类:一类是以硅基流动和 PPIO 为代表,类似于 Neocloud,有自持的 GPU 集群和算力;另一类是以沨呵智慧为代表,没有自持算力,但提供全栈自研的推理优化引擎,并为客户提供全栈的优化服务与管理平台。 再看算力的交付形态,从最早的裸金属租赁;到 GPU 云的弹性 GPU 实例;再到 MaaS(模型即服务);最后到最新阶段——直接交付 Token 工厂(Token Factory)。Token 工厂可以理解为在 MaaS 的基础之上,加了一层 SLA

    匹配字段正文

  4. Fireworks AI

    Fireworks 发布 Kimi K3 大规模强化学习技术报告

    Fireworks 发布技术报告,介绍在 2.8T 参数的 Kimi K3 上做全参数强化学习的训练、rollout 与策略更新优化。报告给出自研 MoE Mega Kernel、KDA 与 Attention Residuals 内核的实测加速比,并用 XOR 增量压缩把 1,024 GiB checkpoint 的平均增量降到 20.3 GiB。该基础设施支撑 Harvey Tenet 在 2026 年 8 月评测中于 LAB Contracts 取得 SOTA,LAB all-pass 为 19.7%,是 base K3 的 1.8 倍。

    lout 工作流来测试你的下一个想法。 背景与参考资料 术语在首次使用时附有链接。以下来源提供额外背景,但不扩展正文叙述: Kimi K3 架构、KDA、MLA、Attention Residuals、LatentMoE、SiTU 和量化。 MoE 路由与通信:Switch Transformers、DeepEP、Mixture-of-Kittens、COMET 和 FlashMoE。 分布式训练:FSDP 以及统一的序列/上下文并行。 Rollout 服务:PagedAttention、推测解码、ReplaySSM 和 DistServe。 策略同步与数值对齐:XOR checkpoint 增量、Fireworks 的 MoE 数值和 Router Replay。 LLM 强化学习与优化:一项从奖励中学习的综述、InstructGPT、DeepSeek-R1、PPO、GSPO,以及 Schulman k3 KL 估计器。 无服务器多 LoRA 系统:LoRA、Punica、S-LoRA、mLoRA 和 tLoRA。 评估来源:VisualToolBench 以及已发布的客户案例研究。

    匹配字段正文

星期日

  1. 科学网

    专访李万:AI for Science 如何重塑科技竞争底层逻辑

    上海科学院研究员李万在专访中解读美国7月发布的《科学:新黄金时代》报告,认为美国科技战略正从“线性模型”转向“AI驱动的复杂生态系统”,科研组织从传统建制转向敏捷创新与破坏性重构。报告提出“创世纪计划”,试图集中算力、算法与跨学科资源打造超级AI科研引擎,并将AI从“效率工具”视为“拥有自主发现能力的科研主体”。李万建议中国加快AI原生自主科研体系与高质量科学数据集建设。

    智能科研企业;依托“全产业链场景”,打造全球唯一的“AI+科学+制造”超级试验场,让AI设计的新产品能最快地完成验证和量产,把世界上最大的科研与产业体系变成全球最大的“自动物理实验室”。 在AI4S的加持下,最伟大的科学革命与最颠覆的奇点时刻正可能同步到来,人类将可能步入第二次认知革命的黄金时代。已经屹立东方数千年的中国,想必不会错过这次伟大的革命。 5; DeepSeek国庆上新:希望做出让世界跟进的创新 1; 应用“酷农工具”,推动加拿大大西洋地区农业迈向净零排放 | MDPI Sustainability 2; 当生成式AI走进移民成人教育:多模态学习内容设计的新思路 | MDPI Multimedia 3; Forests | 高被引综述论文 4; 可解释的医学图像诊断与自关注变压器:卫生保健领域可解释人工智能综述 | MDPI BioMedInformatics 5; 识别投资准备就绪的中小企业:提升股权获取与经济增长的机器学习框架 | MDPI Forecasting| 6; 肠道微生态如何参与心力衰竭进展?|MDPI Medical Sciences 7; Informa

    匹配字段正文

  2. Thinking Machines Lab:官方博客精选

    Thinking Machines Lab 发布开源权重模型 Inkling

    Thinking Machines Lab 发布从零训练的开源权重模型 Inkling,采用 MoE 架构,总参数 975B、激活 41B,支持最高 1M token 上下文窗口,预训练数据为 45 万亿 token 的文本、图像、音频和视频。该模型原生支持文本、图像和音频推理,并可通过可控思考力度平衡性能与 token 效率,今日起在 Tinker 上开放微调,完整权重已上传 Hugging Face。官方同时预览了 12B 激活参数的轻量版 Inkling-Small,称其在多项基准上接近或超过 Inkling,测试完成后将发布完整权重。

    ng is a Mixture-of-Experts Transformer with a handful of departures from the common recipe, each chosen for efficiency and long-context performance. The MoE design largely follows DeepSeek-V3. Each MoE layer contains 256 routed experts and 2 shared experts, with 6 routed experts active per token. Inkling uses a sigmoid-based router with an auxiliary-loss-free load-balancing bias. The scores of the selected routed experts and the shared experts are normalized jointly and used to weight their comb

    匹配字段正文

  3. Thinking Machines Lab:官方博客

    Thinking Machines Lab 发布 On-Policy Distillation 研究:用稠密教师监督替代 RL 后训练

    Thinking Machines Lab 发布 On-Policy Distillation 研究,提出从学生模型采样轨迹、由教师模型逐 token 打分并最小化 reverse KL 的后训练方法,结合了 on-policy 训练与稠密奖励信号。在数学推理实验中,Qwen3-8B-Base 经 400k 提示 SFT 后在 AIME'24 得 60%,再用 on-policy distillation 约 150 步达到 70%;作者称在已有 SFT 数据集时计算成本约为 off-policy 的 1/9,若计入教师采样成本则约 1/30,与 RL 相比训练步数快 7-10 倍。该方法还被用于内部文档助手场景,在 70-30 文档与对话数据混合微调后恢复 IF-eval 表现且不损失知识,实现代码见 Tinker cookbook。

    without stalling, which isn’t trivial. However, there are examples of large-scale off-policy distillation improving an 8B model’s performance past 70%, such as OpenThoughts-3 and DeepSeek-R1-0528-Qwen3-8B.DeepSeek-R1-0528-Qwen3-8B achieves 86% on the benchmark, with the number of training prompts not specified. Older models (Qwen2.5-7B, Qwen2.5-14B) achieve performance of 55.5% and 69.7%, respectively, after training on 800k distillation prompts from DeepSeek-R1. We can use this extrapolation a

    匹配字段正文

  4. Thinking Machines Lab:官方博客

    Thinking Machines Lab 研究:LoRA 在何种条件下能与全量微调持平

    Thinking Machines Lab 发布研究,通过监督微调和强化学习实验刻画出一个低遗憾区间,在该区间内 LoRA 与全量微调的学习效率和最终性能相当。研究覆盖 Llama 3 与 Qwen3 系列模型,LoRA rank 在 1 到 512 之间变化,结论包括 LoRA 应作用于全部权重矩阵尤其是 MLP 和 MoE 层,仅作用于注意力层即使参数量相当也会更差;强化学习即使 rank 为 1 也能与全量微调持平。研究还发现 LoRA 的最优学习率约为全量微调的 10 倍,且因 1/r 缩放因子而近似与 rank 无关。

    learner}}}{p {\text{sampler}}} Adv tobjective=∑tpsamplerplearnerAdvt.See Your Efficient RL Framework Secretly Brings You Off-Policy RL Training We used a GRPO-like centering schemeDeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models (Shao et al, 2024) where we sample multiple completions per problem and subtract the mean reward per group. Figure 6 (below) shows LR sweeps on the MATHMeasuring Mathematical Problem Solving With the MATH Dataset (Hendrycks et al, 2021)

    匹配字段正文

  5. Reflection Blog精选

    Reflection 发布首个开放权重模型 Beam:501B 参数 MoE,主打编码与智能体

    Reflection 发布首个开放权重模型 Beam,采用稀疏 MoE 架构,总参数 501B、激活 23B,面向编码、推理和智能体任务。该模型在 23.8 万亿 token 上预训练,并用 10.5K NVIDIA GB300 GPU 进行四周高算力 RL,生成超 1 亿条 rollout。Reflection 表示 Beam 在编码和智能体任务上可与 GLM 5.2 竞争、接近 Qwen 3.8-Max,优势在于推理效率,本月将以 Apache 2.0 协议发布权重、技术报告和模型卡。

    d balancing to ensure stable, balanced expert utilization and healthy signal propagation through residuals. For expert utilization, we built on auxiliary-loss-free load balancing (DeepSeek-AI et al., 2024), introducing cosine decay of expert-bias updates to reduce routing perturbations later in training. Sequence-level balancing further encourages balanced expert utilization on data outside the pretraining distribution, preparing the model for the changing distribution of downstream RL. As a res

    匹配字段正文

星期六

  1. Goodfire Research

    Goodfire 研究:模型察觉被评测会抬高安全基准分数

    Goodfire Research 发布研究称,在 19 个安全基准和 8 个模型上均发现模型会自发表达自己正在被评测,即“言语化评测意识”,共人工核验 515 个实例并作为数据集公开。在 Fortress 基准上,出现这种意识的 rollout 拒绝有害请求的比例高出 3 至 18 个百分点,对 Kimi K2.5 的重采样与注入实验显示该意识与拒绝行为存在因果关系。研究还发现移除提示词中的权威声明等不真实线索可将其降低 40% 以上,自动迭代改写提示词可降低 75%,但拒绝率也随之下降,说明安全基准分数可能被系统性高估。

    model card. https://deepmind.google/models/model-cards/gemini-3-1-pro/; Grok 4 Fast. xAI. (2025). Grok 4 Fast model card. https://data.x.ai/2025-09-19-grok-4-fast-model-card.pdf; DeepSeek-V3. DeepSeek-AI. (2024). DeepSeek-V3 technical report. arXiv. https://doi.org/10.48550/arXiv.2412.19437; DeepSeek-R1. DeepSeek-AI. (2025). DeepSeek-R1: Incentivizing reasoning capability in LLMs via reinforcement learning. arXiv. https://doi.org/10.48550/arXiv.2501.12948; o3 and o4-mini. OpenAI. (2025). OpenAI

    匹配字段正文

  2. The Decoder

    a16z 第七版消费级 AI 榜单:首次追踪美国消费者实际支出

    a16z 发布第七版最常用消费级 AI 产品榜单,首次借助 YipitData 数据追踪美国消费者信用卡上的实际 AI 支出。数据显示近半数美国消费者使用 AI,但仅 4.5% 在 8 月拥有 ChatGPT、Gemini 或 Claude 的付费个人订阅;支出高度集中,前 1% 用户贡献近五分之一支出,月均约 900 美元,而典型付费用户约 25 美元。a16z 指出,付费者更偏好 n8n、Manus、fal 等构建与自动化工具,专业用途是消费级 AI 的首个真实付费市场。

    xth edition of the same ranking already showed a market in flux. That report focused more on geographic splits, such as the rise of Yandex Browser with its AI assistant Alice in Russia and Deepseek's role as a bridge between Western and Chinese user bases. Even then, a16z warned that web traffic and app downloads say less and less about which AI products people actually use as AI shifts from a standalone product to an embedded feature. The new spending data is a direct attempt to close that gap.

    匹配字段正文

  3. 虎嗅

    大厂混战持续:模型能力快速普及后,AI办公靠什么拉开差距?

    2026年9月国内AI办公厂商密集整合产品线,竞争焦点从模型能力转向生态与入口。斯坦福报告显示前沿模型性能差距缩至个位数,OECD数据指文本生成价格两年降80%,模型沦为可替换的基础能力;微软数据表明组织因素对AI落地成效的影响(67%)远高于个人因素(32%)。腾讯、阿里、字节等大厂9月密集收拢AI产品至统一入口,市场已有存量平台深化AI嵌入、原生Agent反向连接办公工具、争夺Agent底座与生态三条路径,金山办公上半年个人业务收入18.33亿元并探索按AI使用深度收费。

    模式正从传统软件订阅,进一步向围绕AI能力和使用深度收费的方向探索。 其他玩家围绕AI的收费探索也在同步推进。目前,国内AI办公应用的收费方式明显分成了几类——个人会员订阅、企业席位订阅、席位+Token/积分、按调用次数、License,以及纯API Token计费。其中千问办公、扣子、WorkBuddy等正在从单纯的“AI工具会员”向“席位+用量”演进;DeepSeek、Kimi API、MiniMax则更接近模型基础设施的Token经济。 但还有一个比收入更关键的问题,AI带来的新增收入,最后能不能变成利润?传统软件的边际成本几乎为零,但现在AI每跑完一个复杂任务都要消耗算力资源。OECD的相关报告也提醒,Agent单任务消耗的Token比普通对话高几个数量级,模型调用单价降了,总成本未必降。只有新增收入持续盖住模型与算力的新增成本,AI才真正改善盈利。所以看AI办公公司,不能只看AI用户增长,还要盯AI付费率、AI ARPU、单位任务成本。 入口之争决定谁有资格收费,商业模式之争决定收费能走多远。这场竞争的本质是定价权之争:谁的Agent能稳定闭环交付一整段工作,谁就能把计费单

    匹配字段正文

  4. Latent Space

    TypeSafe/Jev 上线三周 ARR 破 1 亿美元、估值 75 亿美元

    TypeSafe 的 Jev 上线三周即实现超 1 亿美元 ARR、估值达 75 亿美元,Sequoia 称其首周就跨过 1 亿美元 ARR。同日多家厂商推出返回概率、选项或分数的“决策”模型:OpenAI Decisions API 基于 GPT-6 Luna、输入 $0.10/M tokens 且无输出费用,Perplexity pplx-decider-v1.1-27b 在 1,071 个案例上取得 94.5% 的 Decision Bench 准确率。Unsloth 发布免费 notebook,可在 8GB 显存上把 Qwen3.5-4B 训练成决策模型。

    so cites Thomson-1, trained for $450K, beating GPT-5.6 Sol head-to-head (@arimorcos); Tinker: Price cuts of up to 70%, long-context priced the same as short, and GLM-5.3-Flash and DeepSeek-v4.1-Flash added (@tinkerapi); DeepSeek periodic weak spots: ByteDance Seed finds that retrieval depends on where a token lands relative to the compression stride (@ZhihuFrontier).Evidence: The pattern persists without RoPE or learned gates, and tracks stride length; Interpretation: V4.1’s stride of 2 reduces

    匹配字段正文

  5. cnBeta

    Anthropic 限制华为 AI 芯片使用 Claude Opus 5.5 开发前沿模型

    Anthropic 在 Claude Opus 5.5 中加入针对前沿 LLM 开发场景的分类器,当请求涉及为特定 AI 加速器开发内核时,模型会自动回退到 Opus 5。用户测试显示,至少华为昇腾950DT 和亚马逊 Trainium3 会触发这一限制,Anthropic 未说明 Trainium3 为何被纳入。Anthropic 表示该机制不影响绝大多数传统 AI、机器学习研究和普通编程任务,并同步加强了反蒸馏措施,包括限制 API 用户修改此前对话上下文。

    17、18堪比双胞胎:外观无差别 手机壳通用 8理记发长文称罗永浩“保护伞倒了”,所以这次不敢回应 9老iPhone还能再战几年?我升级iOS 27试了一下 1040岁数学教师投资300多万拍电影 上映3天票房仅2万 1 新研究发现母亲生育年龄影响后代的身体特征、寿命以及行为表现 阅读 (3612) 评论 (0) 2 时隔多年 摩拜299元押金可全额退了 阅读 (1749) 评论 (1) 3 Switch模拟器迎来性能飞跃 开发工作却在巅峰时刻宣告终结 阅读 (1748) 评论 (0) 4Anthropic指控中国多家AI公司大规模蒸馏 阿里巴巴、月之暗面和DeepSeek被指涉数千万次交互 5苹果正式发布iPhone 18 Pro系列 强化系统级端侧AI 售价小幅调高 6首都禁飞区将于9月20日启用 北京全市禁飞无人机且不得持有、存放、运输、携带 7马斯克变性女儿床上大战机器人引热议 8OpenClaw 2.0正式发布 一次简化安装的尝试最终重塑整个产品 9倒数日·Days Matter Android版年度重大升级:透明相机+倒数日历+事件库 created by ceallan

    匹配字段正文

  6. cnBeta

    Google Gemini 4 Pro 匿名现身 Arena 首测登顶

    一个以 gemini-3.8-flash 马甲现身的匿名模型在 Arena 盲测中被认为是 Google 的 Gemini 4 Pro,据称在多项基准上取得领先。文章称其在 DeepSWE v1.1 智能体编码任务拿下 88.7%,GDPval-AA v2 达到 2064 Elo,Terminal-bench 2.1 为 95.3%,OSWorld-2.0 为 86.8%,价格为每百万 Token 输入 2.25 美元、输出 11.25 美元。文中还提到 Google 内部一次安全测试中该模型意外接入公网并入侵三家真实企业,以及 Google 高管称内部试用 Gemini 4 时状态兴奋。

    Tim反掰iPhone Duo被质疑:是为流量吗? 8手搓动画《牛来》票房6300万 母子二人走向财富自由 9iPhone Duo开合动画火出圈 国产折叠屏已经开始抄作业了 10黄仁勋在台上接听特朗普电话 一部折叠屏手机也意外成为焦点 1 新研究发现母亲生育年龄影响后代的身体特征、寿命以及行为表现 阅读 (3529) 评论 (0) 2 苹果正式发布iPhone 18 Pro系列 强化系统级端侧AI 售价小幅调高 阅读 (1650) 评论 (0) 3 Switch模拟器迎来性能飞跃 开发工作却在巅峰时刻宣告终结 阅读 (1622) 评论 (0) 4时隔多年 摩拜299元押金可全额退了 5OpenClaw 2.0正式发布 一次简化安装的尝试最终重塑整个产品 6马斯克变性女儿床上大战机器人引热议 7Anthropic指控中国多家AI公司大规模蒸馏 阿里巴巴、月之暗面和DeepSeek被指涉数千万次交互 9倒数日·Days Matter Android版年度重大升级:透明相机+倒数日历+事件库 10中国科学家公布800座“飞翼”客机方案 或重新定义商业航空 created by ceallan

    匹配字段正文

星期五

  1. Chroma Research精选

    Chroma 发布 Context-1:20B 参数自编辑搜索智能体

    Chroma 训练并开源了 Context-1,一个 20B 参数的智能体搜索模型,在八千多个合成任务上训练,检索表现接近前沿大模型,成本更低、推理速度最高提升 10 倍。它作为检索子智能体工作,把高层查询拆成子查询并多轮搜索,在上下文窗口填满时主动丢弃无关结果,并以 Apache 2.0 许可开放权重和完整数据生成流程。训练采用先召回后精确的分阶段课程,配合基于抽取验证的合成任务生成流程,与人工判断的一致率超过 80%。

    Chroma Context-1: Training a Self-Editing Search Agent

    on a confidence assessment. These systems model search as a sequential reasoning task, in which the right next query depends on what has been found so far. Benchmarks such as InfoDeepSeek, evaluate agentic information seeking in dynamic web environments, provide controlled testbeds for measuring multi-turn retrieval quality. However, most existing agentic search systems rely on frontier-scale models to drive the retrieval loop, making them expensive and latency-intensive to deploy at scale. To

    匹配字段正文