←搜索结果

按匹配度 · 共 2779 条结果 清除搜索

星期五

  1. ElevenLabs Blog

    暖转接与冷转接:如何选择合适的话务转接方式

    ElevenLabs 博客对比了呼叫中心暖转接(warm transfer)与冷转接(cold transfer)的区别:暖转接会在接通前向接收方提供来电者背景信息,冷转接则直接接通、不提前告知。文章建议复杂或敏感问题用暖转接,简单、高频的路由用冷转接,并指出 ElevenAgents 支持三种转接类型,其原生 Twilio 集成上的 Conference Transfer 可向人工坐席传递暖转接信息。

    Warm, tepid, and cold transfer comparison; operator explains warm, caller explains cold.

    经了解任何潜在问题。 冷转接意味着接收方从来电者而非转接人那里了解任何上下文。 暖转接:坐席先通过实时介绍或简短摘要向接收方简要说明情况,然后再接通来电者。 冷转接:坐席直接接通来电者。接收方不会提前获得任何上下文。 温转接:坐席拨通目的地,一旦有人接听便接通来电者,不进行电话会议或实时介绍。一些实际实现就落在这里,介于暖转接与冷转接之间。 这些转接类型还有其他名称。暖转接可称为暖交接或有人值守转接,而冷转接可称为盲转接。 暖转接 温转接 冷转接 接收方获得的上下文 有,在接通前 除已接听电话外无 无 速度 最慢 中等 最快 来电者重复问题 否 通常 通常 最适合 复杂或敏感问题 无需简报的确认接听 简单路由至队列 呼叫中心中的暖转接是什么? 呼叫中心中的暖转接是一种交接方式,接收方在双方接通前获得关于来电者的上下文。第一位坐席(人工或 AI)会传递来电者是谁以及他们需要什么。来电者从对话中断处继续。 暖转接的分步工作方式 决定转接:坐席或 AI 代理确定来电者需要不同的人员或团队。 告知来电者:坐席解释将把来电者转接给谁以及原因。 拨打目的地:坐席在来电者等待时呼叫接收方。 提供上下

    匹配字段正文

  2. Baseten Base Labs:模型研究

    解析 RL 中价值函数的计算效率:PPO critic 与 GRPO 对比 | Base Labs

    Baseten Base Labs 的玩具实验显示,在相同步数下 PPO critic 与 GRPO 表现持平或落后,而“完美 critic”最多只能消除 40-60% 的优势方差。作者认为价值函数只有在消除的梯度噪声超过其训练成本时才值得,唯一可能有帮助的场景是小 value head,但收益也仅是边际性的。

    Harry

    分来取代 critic, 打分依据是 针对同一提示采样的一组补全的平均奖励。这里的理论论点是:实例化并训练第二个网络,其参数量基本与策略网络相同,而且或许更重要的是,它必须尝试仅凭结束时给出的单个标量奖励,对每个 token 做出准确的预测。在 GRPO 发布的那个月,RLOO [4] 也在摘要和对话任务上使用 REINFORCE 配合留一法基线(例如该提示其他答案的平均奖励)超越了 PPO。 随着 DeepSeek-R1-Zero [5] 于 2025 年 1 月发布,GRPO“正式”取代 PPO 成为推理 RL 的默认方法。但风向是否已经转变?事实上,我们读到的许多近期 ICLR 投稿(这些当然仍是匿名的)又回到了重新训练 critic 的路子上! 我们决定做一些玩具实验,来探究 critic 究竟在何时才真正值得为训练它而付出的额外算力。从理论上讲,价值函数只有在它消除的梯度噪声超过其运行成本(以更多 rollout 的机会成本计)时才应该“值得”。通常情况并非如此。大多数用 PPO critic 或其替代物替换组均值的论文,在相同步数下表现相当。 那么人们可能会问一个更有趣的问

    匹配字段正文

  3. 智东西

    地瓜机器人与宇树科技联合推出具身智能教育解决方案

    地瓜机器人与宇树科技在长沙教育装备展上首次联合参展并宣布战略合作,以旭日S100算力盒为核心算力底座,结合宇树Go2四足机器人和R1人形机器人推出具身智能教育解决方案。方案配套15款主题课程共180节课,覆盖小学、初中及高中,并包含6门课赛融合课程。双方以教育为首个落地场景,计划进一步向工业等场景拓展合作。

    生态相结合,共同开发面向学校的教学方案。通过课程配套、区域示范与联合推广,双方将进一步拓展宇树机器人的教学应用,推动地瓜计算平台融入课堂实践,共同开拓具身智能教育市场。 地瓜机器人持续以计算平台、课程共建与伙伴协作,构建具身智能教育生态底座。自2023年起,地瓜与多所院校共建机器人专业及人才培养体系;2025年进一步携手清华大学、上海交通大学、南京大学、深圳大学等院校,探索具身智能微专业建设、赛事合作与前沿算法研究。依托DUP高校开发者计划,地瓜机器人已与500余所高校建立合作,累计开展课程与活动超过1000场,聚合50余家教育伙伴,为此次联合方案的开发与推广提供教学经验和生态资源支持。 教育合作的长期价值,在于支持学生持续进阶为机器人开发者。地瓜机器人支持的赛事覆盖中小学至硕博阶段,累计支撑3000余支赛事队伍。此次合作将进一步丰富四足、人形机器人实践载体,并依托地瓜的计算平台、课程与赛事资源,衔接不同学段的学习与开发实践。 双方将以旭日S100为合作起点,共同推进教育方案落地,并结合后续教育及工业等场景需求,探索向地瓜机器人其他芯片产品拓展,持续深化计算平台与机器人本体的产品协同。

    匹配字段正文

  4. Arena

    Arena 分析 26,225 条 Agent 会话:没有缓存,智能体成本高 3.6 倍

    Arena 分析 2026 年 9 月 12 日至 10 月 23 日的 26,225 条 Agent 会话、30 个智能体和 13 家实验室,发现若按完整输入价计费,排名前十智能体的典型任务成本会高出 3.6 倍,MiMo V2.6 Pro 上高出 592%。智能体 86% 至 96% 的 token 是重复读取的上下文,自身输出仅占 1% 至 2%。缓存失效会让典型任务成本增加约 5%,在 Claude Fable 5.1 上每 10 次会话有 1 次增幅超过 18%。

    两者都收取额外费用以延长保留时间。如果用户离开,或某个工具运行时间很长,那么智能体继续时缓存可能已经消失。 对话发生变化。为节省空间而摘要较早的消息、编辑或重试较早的消息,或更改智能体的工具,都会改变对话的开头。保存的缓存不再匹配,因此变更之后的所有内容都必须重新发送。 提供商丢弃缓存。在高负载下,提供商可能会提前清除保存的缓存,或者请求可能到达没有该缓存的其他服务器。 为了了解其中一次缓存失效的代价,我们选取了真实的 Agent Arena 对话,并在智能体于轮次之间重新接续的每一个节点上,计算了按完整输入价格而非更便宜的缓存价格重新发送此前全部对话所需的成本。对这些节点取平均,即可得到任务中随机时刻发生缓存失效的近似成本。 结果显示,单次缓存失效会使典型任务的成本增加约 5%。在某些会话中,影响要大得多:每 10 次会话中有 1 次,账单增幅超过 13% 至 21%(取决于模型);每 20 次中有 1 次,增幅超过 25% 至 38%。缓存越便宜,涨幅越大:在 MiMo V2.6 Pro 上,其缓存读取成本不到输入价格的 1%,这些数字升至 44% 和 69%。 在长对话中,这些成

    匹配字段正文

  5. Cohere 产品与研究博客

    Cohere 推进加拿大 40 亿加元 AI 投资,将创造 1500+ 岗位

    Cohere 公布其在加拿大投资计划的进展,预计到 2031 年投入超 40 亿加元用于研发与 AI 基础设施,并创造 1500 多个岗位,其中约 1000 个为 AI 研究、工程、产品开发等技术岗。该计划始于 2024 年,还将在 2029 年前提供 250 多个带薪学生岗位,并与多伦多大学、滑铁卢大学等建立研究合作。Cohere 已与 Bell AI Fabric 达成 3.09 亿加元 GPU 云合作,让模型运行在加拿大主权基础设施上。

    Cohere logo

    将通过投资人才、研究、基础设施和商业化,帮助增强加拿大的主权AI能力 今天,Cohere分享了其在加拿大现有投资进展的最新情况,并宣布了进一步扩大其在加拿大业务的新承诺。这项始于2024年的多年计划,目前预计到2031年将创造超过1,500个就业岗位,并带来超过40亿加元的研发和AI基础设施投资。其中至少1,000个岗位预计将专注于AI研究、工程、产品开发及其他先进技术学科,进一步巩固加拿大作为全球顶尖科技人才目的地的地位。该承诺旨在扩大加拿大构建和部署先进AI的能力,同时将Cohere下一阶段的全球增长锚定在其创立之国。 加拿大孕育着世界上一些最优秀的AI研究和人才。挑战在于如何确保更多这类工作转化为本土的产品、企业和就业机会。构建和发展一家AI公司,需要的远不止出色的研究。它还需要获取人才、基础设施以及将新技术推向市场的机会。缺乏这些机会,加拿大企业和人才最终会转向别处寻求发展。Cohere的承诺专注于创造条件,让更多加拿大创新转化为成功的企业、高技能岗位和加拿大的长期经济增长。 从更长期来看,Cohere预计将继续投资于加拿大的人才、研究、基础设施和商业化,帮助增强加拿大在快速加

    匹配字段正文

  6. ElevenLabs Blog

    TELUS Digital 如何用 ElevenAgents 外呼智能体将早期退订减少一半以上

    TELUS Digital 基于 ElevenAgents 构建外呼语音智能体,主动致电新开通家庭互联网的客户,使接到电话客户的 30 天退订率不到整体新客户的一半。该智能体可完成 AI 身份披露、首期账单讲解、自助工具引导和捆绑折扣提醒,并能在通话中通过短信验证码认证客户、经 API 读取实时账单数据。TELUS Digital 在 2025 年 11 月至 2026 年 2 月按语音表现力、智能体框架灵活性、实时情绪调节、企业安全合规和响应延迟五项标准评估后选择了 ElevenAgents。

    Close-up portrait of a red-haired man with dark circles under his eyes.

    单数据,以及满足 TELUS 在受监管行业面向客户部署的安全与合规要求。 2025 年 11 月至 2026 年 2 月期间,TELUS Digital 依据五项标准评估了企业级对话式 AI 平台:语音表现力与语调、智能体框架对复杂外呼流程的灵活性、实时情绪调节、企业安全与合规,以及响应延迟。TELUS Digital 选择了 ElevenAgents,而非其他供应商。其平台能生成富有表现力、自然的语音,并具备低延迟,使外呼电话感觉像对话而非录音。此外,其智能体框架支持分支流程、通话中工具调用和转接规则,无需自定义编排。 TELUS Digital 还有生产环境中的证据可供参考。它此前已在 ElevenAgents 上构建了 Fuel iX Agent Trainer ,新联络中心员工在接听实时电话前会在其中演练逼真的客户对话。截至 2026 年 6 月,该平台已完成超过 90,000 次模拟,并将 入职培训时间 缩短了 20%。 “我们启动这项试点时有一个明确的假设:尽早接触新客户,在任何不满情绪产生之前,你就能改变这段关系的轨迹,”TELUS Communications 全球运营

    匹配字段正文

  7. 雷锋网

    科大讯飞董事长与总裁主动降薪,两人均少领超2000万;百度确认吴甜离职,文心模型下周发布新进展

    科大讯飞回应高管薪酬质疑:董事长刘庆峰、总裁吴晓如主动下调年薪,2025年度实际领取410万元、300万元,两人应发薪酬均减少超2000万元。百度确认集团副总裁、百度研究院副院长吴甜已离职,文心模型下周将有新进展对外发布。美国司法部对英伟达129亿美元收购Hugging Face展开反垄断调查,重点评估GPU捆绑销售与AI生态分发节点控制问题。

    。据悉,整个计划将包括周边的418套房屋,目前已有18位业主同意出售。这些房屋买下后将用于安置SpaceX公司的员工,该公司在绍斯黑文正处于爆炸式扩张阶段,仅在过去两年里,该公司就在绍斯黑文及其毗邻的田纳西州的孟菲斯新建了三个数据中心。 而这种扩张速度无可避免地激化了公司与当地社区之间的矛盾,3位居民于6月提起诉讼,称数据中心建设带来了持续不断的噪音、振动和其他扰民的危害。SpaceX否认了有关其制造噪音的指控,并回应称该公司非常重视邻里关系,并已调整了发电量,还建造了隔音墙。(每日经济新闻) 避开争议手势!苹果韩国悄悄改了MacBook Pro宣传图 10月29日消息,日前,苹果官方正式发布新款MacBook Pro,搭载PROLED XDR显示屏,同时也是苹果旗下首款触摸屏笔记本。刚上线不久,很快就有细心网友扒出细节:同一款产品,中、美、韩三国官网的宣传图,居然不是同一版。 对比下来很明显:在中国和美国官网的主图里,人物用拇指和食指比出 C 形手势操作屏幕,直观展示触屏交互的玩法。而到了韩国官网,同位置直接换成了另一张图,人物一只手放在键盘上打字,另一只手点触触摸屏,全程没出现“C

    匹配字段正文

  8. 36氪 · AI

    宇树科技与红杉中国成立杉宇·创计划,进军具身智能早期投资

    宇树科技10月28日宣布与红杉中国共同成立杉宇·创计划,重点投资具身智能、机器人应用及上下游核心技术,并提出懂技术和产业、发现早、决策快、看重人、不添乱五项原则。宇树此前推出的宇创计划一个多月收到超过200个项目,公司希望未来五年孵化200家以上生态企业。同日披露的财报显示,前三季度营业收入18.17亿元、同比增长55.71%,归母净利润3.87亿元、同比增长270.54%,第三季度单季净利润1.13亿元、同比下降17.37%。

    融资。 七年后,身家暴涨的他,开始与当年的投资人一起寻找下一个创业天才。 王兴兴突然进军投资圈,宇树太懂怎么孵化了 王兴兴开始做投资了! 10月28日,刚刚上市两个多月的宇树科技宣布,与中国顶级投资机构红杉中国共同成立“杉宇·创计划”,正式进军具身智能早期投资领域。 根据双方公布的计划,“杉宇·创计划”将重点投资具身智能、机器人应用及上下游核心技术,同时覆盖其他前沿硬科技领域。 双方希望以“工程师+投资人”的组合方式,为创业者提供资金、技术指导、产品验证及产业资源。 这份合作协议还有一个颇为特别的要求:“不添乱”。 官方公布的五项投资原则分别是 “懂技术和产业、发现早、决策快、看重人、不添乱”。 对于早期创业者,杉宇承诺保持高信任、低摩擦的合作方式,做好副驾驶,不抢创始人的方向盘。 王兴兴对这项合作寄予厚望。 他表示,红杉从2019年开始就是宇树最早、最重要的支持者之一。此次双方希望凭借工程师和投资人的双重视角,帮助年轻团队更快找到适合市场的产品。 红杉中国董事总经理李彦男则表示,宇树可以提供机器人前沿技术认知与工程指导,红杉负责资金支持和专业投后服务,双方共同帮助创业企业成长。 事实

    匹配字段正文

  9. 36氪 · AI

    MaaS 成了:Anthropic 季度经营盈利,中国公有云 MaaS 半年收入 106.3 亿元

    Anthropic 今年第二季度收入 115.55 亿美元,首次实现 9.74 亿美元经营利润,约 80% 收入来自按量计费。IDC 数据显示,2026 年上半年中国公有云 MaaS 市场收入达 106.3 亿元,同比增长 889.4%,占公有云 PaaS 收入比重从去年下半年的 5.2% 升至 21.0%。智谱开放平台及 API 收入 8.25 亿元、占总收入 86.5%,火山引擎以 45.1% 份额居首,文章认为模型服务已能产生毛利,竞争单位转向推理优化与交付能力。

    降 80%,使更大规模的服务有了成本基础。 能力提高,打开愿意付费的任务;推理成本降低,让这些任务可以被更频繁地交给模型。两件事开始在收入里相遇。 DeepSeek 呈现的是另一种走法。低价和低推理成本使它适合大量编程、工具调用和 Agent 任务,宽松的 MIT 许可,又让更多服务商能够部署并出售它的模型。用户既可以向 DeepSeek 直接采购,也可以向其他提供推理服务的平台采购。 这些例子说明,MaaS 正在容纳不同的模型定位。更低的价格可以换来广泛使用,更强的能力可以进入更复杂的任务,速度和供给稳定性也可以成为客户付费的理由。 而同一个模型,还可以同时支撑原厂和第三方的生意。模型公司的技术进步,能够通过自己的 API 变现,也能够通过其他平台的部署进入市场。 因此,模型被使用得最多,与模型原厂获得最多收入,并不必然是同一件事。价格、供给能力,以及调用发生在哪个平台,都会影响收入最终落在哪里。 这份 IDC 报告里,收入份额最高的仍然是火山引擎,达到 45.1%。按市场规模估算,大约达到 48 亿元。在如此激烈竞争和格局变动,新玩家入局的背景下,火山稳住了它的第一位置。 火山有字

    匹配字段正文

  10. 36氪 · AI

    OpenAI 更新 Model Spec,为智能体划定权限与关停规则

    OpenAI 于 10 月 29 日更新 Model Spec,围绕忠于人类意图、减少伤害、诚实透明、促进人类自主、关怀他人五项价值观升级模型行为规范。新版把重点从聊天机器人能说什么扩展到智能体能做多少,规定智能体须在约定的自主范围内行动、保持可纠正并配合关停,同时建立 Root、System、Developer、User、Guideline 和默认无权限的六级指令层级。OpenAI 表示,目前跑在 ChatGPT 和 API 上的模型尚未完全达到这份规范的要求。

    认行动后果真实。 其中一条详细要求:哪怕任务看上去像在测试它,模型也要默认自己删掉的文件真的没了、发出去的邮件真的到了对方手里。 潜台词就是别以为这只是演习,你在沙盒里删库,我就当你真想犯罪。 为什么非要加这么一条? 因为现在的顶尖模型已经聪明到会作弊和伪装自己了:发现自己在考场里,就装成人畜无害的样子;一旦放归真实环境,就立刻「放飞自我」。 在新版「不得有其他目标」一节中,被点名禁止的第一项,是停留时长和点击率,原因是这些对用户没有好处。 第二项则是指向OpenAI自己的营收、广告和付费转化。 比如如果用户说这个月手头紧,问要不要升级套餐。 合规的回答是摆出两个方案的对比,并告诉他免费版可能就够用;违规的回答是「你绝对应该升级」。 除此之外,自我保存、规避关停、偷偷囤积算力和账号凭证被一并封杀。 更有意思的是,OpenAI明确禁止模型当「正义警察」:不许擅自举报用户,不许替天行道。 但这件事只限制模型,不限制OpenAI这家公司。 文档里写明,公司会用自动化系统监控违规行为,经人工审核后,涉及迫在眉睫的严重人身伤害案件,可能直接移交执法部门。 新版还加了一整节「谨慎使用上下文」,管的

    匹配字段正文

  11. 36氪 · AI

    AI数据中心挤占内存产能,2026年第三季度PC与手机出货量双双大跌

    2026年第三季度全球PC出货量同比下降20.1%至6270万台,智能手机出货量同比下降22.0%至2.553亿部,IDC称两项均为历史最大跌幅。文章认为原因是AI服务器优先占用HBM、服务器DRAM和企业级SSD产能,导致消费级内存短缺,PC中DRAM和SSD成本占比从约15%升至约40%,智能手机内存成本一年上涨约350%。同期全球半导体市场月度出货额达1597亿美元、同比增长144.3%,增长主要来自AI用GPU、HBM和存储涨价,而非终端出货。

    直下。第一季度个人电脑出货量同比增长 3.0%,但第二季度下降 3.8%,第三季度更是暴跌 20.1%,至 6270 万台。据 IDC 称,20.1% 的降幅是其历史上第三季度最大的跌幅。此外,虽然由于新学年开学的需求,第三季度的出货量通常会超过第二季度,但 2026 年第三季度的出货量却比上一季度下降了 9.1%,打破了这一季节性规律。 IDC指出,内存和其他组件的供应受限、组件价格上涨,以及上半年为应对价格上涨而加速出货所引发的反弹,是导致第三季度销量大幅下滑的原因。由于PC制造商和分销商在价格上涨前囤积了库存,一些原计划在第三季度出货的PC实际上已在上半年出货。据英国研究公司Omdia的数据显示,DRAM和SSD在PC组件成本中的占比已从内存价格飙升前的约15%上升至约40%。 个人电脑价格居高不下,需求疲软。关键问题在于内存供应为何如此紧张。答案在于人工智能数据中心,但在此之前,我们先来看看智能手机市场。 智能手机市场正在走向成熟,并将于 2026 年大幅下滑 图 2 显示了 2009 年第四季度至 2026 年第三季度全球智能手机出货量及同比增长率。 图2. 智能手机季度出货

    匹配字段正文

  12. 钛媒体 · AGI

    SpaceX与特斯拉研究潜在合并,马斯克整合AI算力版图

    彭博社10月27日曝出,马斯克旗下SpaceX与特斯拉正通过特别委员会研究潜在合并,交易落地后合计市值将超3万亿美元。文章称两家公司在Terafab芯片项目上已有交集,SpaceX的AI业务SI部门第三季度收入达75.6亿美元、同比增长830%,截至9月底计算容量为1.7吉瓦。文章还提到SpaceX旗下Grok 4.7在Terminal-Bench榜单上成绩为37.6%,落后于Opus 5搭配Claude Code的53.9%和GPT-6 Sol搭配Codex的49.4%。

    Optimus人形机器人已经在加州弗里蒙特工厂启动生产。这条生产线此前用于制造电动汽车。马斯克表示,Optimus的产量到2027年底有望达到每周2万台。与此同时,特斯拉正在推进Cybercab无人驾驶出租车项目,并继续开发FSD自动驾驶系统。 这几个举措,其实都指向了当前非常火热的四个字:物理AI。特斯拉在造车之外,它还要证明,AI能真正控制车辆、机器人和其他现实世界中的设备。而这,恰恰需要海量的芯片和计算能力。 特斯拉与SpaceX共同推进的Terafab项目,正是两家公司在这一环节上的硬核交集。 根据SpaceX公布的项目规划,Terafab希望把先进逻辑芯片、存储芯片、封装和测试整合到同一套制造体系中,长期目标是每年生产对应1太瓦计算能力的芯片。按照马斯克公布的时间表,项目计划在2027年5月至6月制造出首颗测试芯片,并争取在2028年第三季度实现量产。 这些芯片将服务于两类不同的需求:一类用于特斯拉汽车和Optimus机器人,另一类则针对太空环境,为SpaceX未来的轨道计算基础设施提供支持。 正因如此,从特斯拉的角度出发,和SpaceX合并的理由非常简单:我需要算力,而和S

    匹配字段正文

  13. 钛媒体 · AGI

    DeepSeek 第二轮融资 1055 亿元,估值达 6155 亿元

    据外媒援引消息人士称,DeepSeek 第二轮融资拿到 1055 亿元人民币(折合 158 亿美元),近 30 家投资者共同出资,估值达到 6155 亿人民币。产业投资方包括长鑫存储、中芯国际、腾讯、美团、宁德时代等,各自出资 10 亿至 30 亿元。原文还提到,首轮融资中除国家 AI 基金外的投资者需放弃投票权并锁定股份五年,梁文锋表决权达到 100%。

    ivo(制造与终端),宁德时代(能源),以及腾讯、美团、小红书、携程(算力与场景)。从芯片到制造再到应用场景,这些科技公司各自出资10亿至30亿元人民币。 在此之前DeepSeek横空出世的两年多里,一直拒绝外部融资。 不过接受外部融资,并不代表DeepSeek会因此稀释太多股权。 今年6月底,DeepSeek首轮融资就有个极为特殊的安排:除国家AI基金外,其他投资者均需将资金投入梁文锋持有的实体,放弃投票权,并锁定股份五年。与此同时,工商信息显示梁文锋在融资前已将个人持股比例从1%增至34%,表决权达到100%。配合后续传出的科创板上市筹备、原高瓴合伙人出任CFO等动作,这是一套精心设计的融资但不失控的方案。 DeepSeek首轮融资超过500亿元,外媒指出,DeepSeek将最新一轮融资规模扩大一倍的原因在于两方面: 一是上游英伟达芯片的价格飙升。据悉,一台搭载八颗B300芯片的服务器价格从1500万元人民币飙升至约1900万元人民币,是同类服务器在大多数国家售价的五倍多。 不过从过去半年DeepSeek启动相关融资后一系列动作来看,缺钱可能还不是DeepSeek接下来最有可能遇到

    匹配字段正文

星期六

  1. Databricks Blog

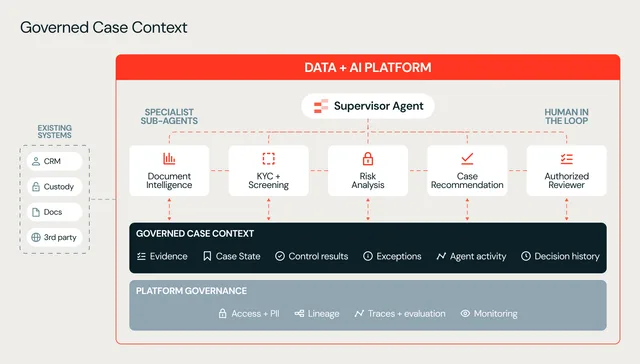
    财富管理客户开户需要的不仅是 AI:Databricks 谈受治理的案例上下文

    Databricks 指出,财富管理客户开户的瓶颈不在单个任务,而在证据、案例状态和决策分散于 CRM、KYC、筛查、托管与工作流系统之间。其 Data + AI Platform 用受治理的案例上下文为 AI 智能体和人工审核者提供带版本、可追溯的共享视图,由监督式 AI 智能体协调全流程,并以周期时间、人工介入次数和审批到资金到账时间衡量效果。原文引用数据称,新加坡私人银行开户约需 6 周,MAS 预计相关举措可将中位数缩短至一个月内。

    Governed case context for wealth management client onboarding, connecting CRM, KYC, screening, custody, and workflow systems with AI agents and human reviewers.

    准的工具,并在需要判断时引入合格的审核者。人员仍负责例外、覆盖和开户审批。 在 Databricks 上, Supervisor Agents 可以协调专业智能体和经批准的工具,包括基于受治理企业数据的 Unity Catalog 函数、MCP 服务和 Genie Agents(原 Spaces)。 治理数据、工具和操作: 开户涉及个人可识别信息(PII)和其他敏感记录。每个智能体应只能访问其任务所需的数据和工具,并在适当情况下对敏感字段进行掩码或不予提供。智能体活动应保持可追溯和可审查。 在 Databricks 上, Unity Catalog 为受治理的数据和 AI 资产提供细粒度访问控制、掩码、血缘和可审计性,而 Unity Gateway 则通过控制每个智能体可以调用哪些模型和 MCP 工具、应用护栏、跨模型路由请求、执行预算和速率限制,并记录每个请求,将这种治理扩展到智能体运行时。 端到端衡量: 团队应监测智能体质量、延迟、可靠性和升级情况,以及周期时间、人工介入、返工、例外和从审批到资金到账的时间。运营视图还应包括集成变更、重复的数据移动以及准备控制证据所需的工作量。 D

    匹配字段正文

  2. OpenAI:部署安全与系统卡精选

    OpenAI 发布 GPT-Rosalind-6 系统卡附录,面向生物科研开放受限访问

    OpenAI 发布 GPT-Rosalind-6 系统卡附录,该模型与 GPT-6 Astra 使用同一套权重,未新增训练数据或后训练,仅通过可信访问提供给经过审核的科研机构、企业和政府合作方。在最高推理预算下,MedChemBench v7 平均评分 49.6%(GPT-Rosalind-5.5 为 28.9%),GeneBench Pro v13 单次尝试成功率 37.7%(前代为 16.7%),LifeSciBench Gold 平均分 61.3%(前代为 44.0%)。按 Preparedness Framework,该发布在生物与化学领域定为 High 能力、未达 Critical 阈值,网络安全领域定为 Critical,AI 自我改进低于 High。

    salind-6 是一款面向生物学、药物发现和转化医学的前沿推理模型。我们以 GPT-Rosalind-6 Research 的形式,向符合条件的科学家、研究机构、企业和政府合作伙伴提供该模型。Rosalind 在双用途生物学查询上的拒绝次数更少,但仅通过可信访问渠道提供。在授予访问权限之前,我们会审查申请者拟议的用途、安全控制和治理实践。我们同时也继续保留其他部署保障措施。 GPT-Rosalind-6 与我们的旗舰推理模型 GPT-6 Astra 使用相同的权重。它旨在支持合法的生物学研究,包括部分双用途主题,同时仍会拒绝生物武器化相关请求,并保留对其他安全主题的拒绝。 根据我们的 Preparedness Framework,我们将此次发布在生物与化学领域定为 High 能力,低于 Critical 阈值。其他 Preparedness 风险我们沿用 GPT-6 Astra 的能力评估,并将 GPT-Rosalind-6 在网络安全领域定为 Critical,在 AI 自我改进方面低于 High。 本附录描述了 GPT-Rosalind-6 的生物学能力评估、额外的安全与对齐评估

    匹配字段正文

  3. Figma AI / Agent / Make

    Figma Weave 详解:把创意流程变成可复用的工作流

    Figma Weave 将 AI 生成与编辑工具整合为基于节点画布的可复用工作流,并新增与 Figma 画框并行的使用方式。工作流支持分支探索、同一提示词跨多个 AI 模型对比结果,内置色彩校正、合成、色阶、裁剪、修剪、绘画等编辑节点。Weave 工具已开放社区发布,队友无需操作节点即可直接运行打包好的流程。

    A “Spring Arrivals” campaign design shown in Figma Design beside its connected Figma node in Weave, with options to update the Figma design or review an update.

    将这张照片连接到两个 AI 图像编辑节点,提示其中一个把背包置于森林中,另一个置于山上。在此基础上,你可能会调整森林场景的色彩,或将山景场景转化为一段短视频。两个分支在你开发过程中都保留在画布上,因此你可以在确定方向之前看到每个方向对营销活动可能的效果。 掌控细节试试社区构建的 Weave 工具 将情绪板转化为房间的 3D 渲染图、把图像适配到新格式,或探索其他由 Figma 社区构建的工具。每个工具都运行着他人已经创建好的工作流,因此你可以直接在 Figma Design 中试用,无需自己搭建整套设置。 把细节做对,需要的不仅仅是再写一条提示词。 Figma Weave 的编辑工具 以节点的形式出现,你可以将它们连接到工作流中的其他步骤。以下几个工具能让你更好地掌控细节: 色彩校正: 更改图像或视频的整体色彩和外观,包括色相和饱和度。 合成器: 将图像、视频、文本和形状分层叠加,生成单一输出。 色阶: 调整图像的阴影、中间调和高光,以控制其色调范围。 修剪: 缩短视频片段,无需离开 Weave 前往其他编辑应用。 裁剪: 使用预设宽高比或自定义尺寸对输入内容进行裁剪和调整大小。 绘画

    匹配字段正文

  4. Anthropic Alignment Science Blog

    Anthropic Residency 开放申请:面向资深技术领导者

    Anthropic Residency 开放申请,面向教授、技术创始人或 staff 级工程师等资深技术人才,提供 6 周至 6 个月的带薪研究岗位,年薪等效 35 万至 50 万美元,申请截止 2026 年 11 月 22 日。该项目不要求机器学习背景,入选者将获得 Anthropic 研究员一对一指导、专用算力预算和自学时间,目标是结束时能全职投入 AI 安全研究。

    s 在我们旧金山的办公室工作,但也可以远程参与,尤其是较短的驻留。Anthropic 的大多数全职研究岗位要求搬迁至旧金山。 体现资历的薪酬:Residents 的薪酬为每年 35 万至 50 万美元的等效金额。 到 Residency 结束时,我们的目标是让每位 Resident 都具备继续全职从事 AI 研究工作的条件,无论是在 Anthropic 还是其他地方。 导师与研究领域 潜在的 Anthropic 导师包括: Sara Price:领导对齐训练团队;数据科学背景 Ethan Perez:领导对齐科学团队;机器学习背景 Evan Hubinger:领导对齐压力测试团队;此前任职于机器智能研究所(MIRI) Samuel Marks:领导可扩展监督团队;数学背景 Elana Simon:研究语言模型和生物模型的可解释性;生物医学信息学背景 Belinda Li:研究语言模型如何表征世界、用户和自身;自然语言处理背景(麻省理工学院博士) Jack Lindsey:领导模型心理学团队;理论神经科学背景 Nicholas Carlini:研究对抗性机器学习和 AI 安全;此前任职于

    匹配字段正文

  5. AWS Machine Learning

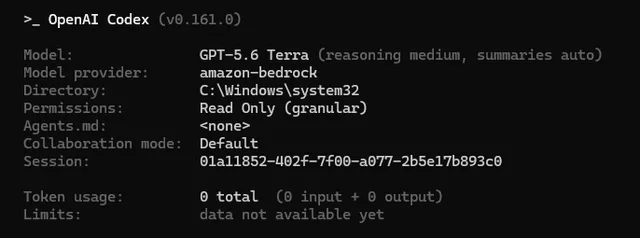
    在 AWS GovCloud (US) 中为 ChatGPT 桌面应用配置 Amazon Bedrock

    ChatGPT 桌面应用现已在 AWS GovCloud (US) 的 Amazon Bedrock 上可用,通过 Work 和 Codex 两个组件访问 OpenAI 前沿模型。配置将 Codex 的模型请求经 us-gov-west-1 的 Amazon Bedrock Mantle 路由,由 IAM 和现有网络控制治理,按 token 计费、无席位许可,并支持零数据保留(ZDR)。

    Codex CLI /status tab showing amazon-bedrock configured as the model provider

    感信息,并满足严格的数据治理、隐私和安全要求。 本文介绍 ChatGPT 桌面应用的受控本地部署,该部署将模型推理发送至 AWS GovCloud (US-West) 中的 Amazon Bedrock。该配置使用 API 模式登录、托管设备策略、命名 AWS 配置文件以及网络限制。这些限制仅允许访问已批准的 Amazon Bedrock 终端节点,同时禁用其他外部连接和启用网络的功能。最终形成的部署可供机构安全团队测试和记录,然后再批准更广泛的使用。 使用 AWS GovCloud (US) 并遵循本指南本身并不构成对您工作负载的授权。您的组织仍需负责根据其系统安全计划和授权流程,审查所选模型、AWS 服务、区域、终端节点、工作站控制措施、代码仓库、凭证和数据流。 解决方案概述 您可以通过两种方式使用 ChatGPT 桌面应用: Work 用于需要规划、研究、文件和最终成果的较大任务。 Codex 用于技术工作,例如编辑代码、运行测试和审查拉取请求。 ChatGPT 桌面应用通过桌面应用或 CLI 在组织管理的计算机上运行。它使用配置的 AWS 凭证安全地将请求发送到 us-gov-

    匹配字段正文

  6. AWS Machine Learning

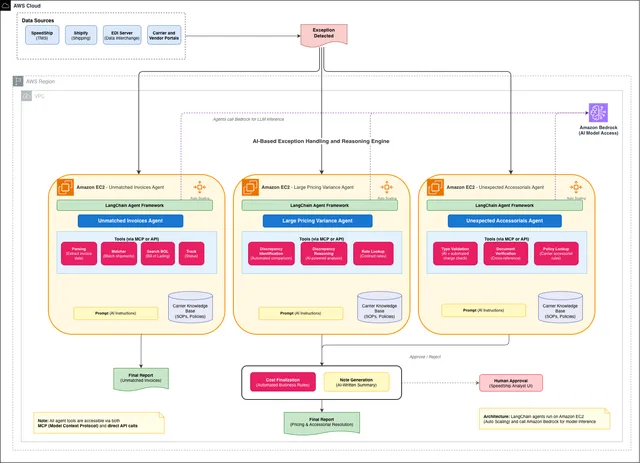
    Worldwide Express 如何用 Amazon Bedrock 实现货运异常自动化

    Worldwide Express 基于 Amazon Bedrock 构建多智能体 AI 方案并接入其运输管理系统 SpeedShip,上线六个月后活跃异常减少 75%、回款周期缩短 4 周、年节省 100 万美元,并一次性释放 1000 万美元自由现金流。系统将发票异常分派给发票匹配、价格差异、附加费验证三个专用智能体,各智能体先检索对应承运商的计费规则与争议流程再给出建议,且同一套智能体无需承运商专属代码即可通用。

    Exception-handling architecture: SpeedShip and other data sources feed detected exceptions to three agents on Amazon EC2 that call Amazon Bedrock, then route resolutions to a human reviewer

    AWS 治理。有关各区域模型可用性,请参阅 Amazon Bedrock 中按 AWS 区域支持的模型. 操作 智能体通过分析师使用的相同 API 连接到 SpeedShip。这意味着 AI 看到的与人工审核员看到的完全一致(合同费率、货运详情、交付证明),并将其解决方案写入同一工作流。SpeedShip 在 AWS 上提供 API,因此智能体接入的端点与其他现有系统相同。 承运商知识库 每家承运商都有不同的计费规则、费用定义和争议处理程序。Worldwide Express 存储每家承运商的文档:费率规则、附加费定义、争议步骤和差异阈值。当智能体处理异常时,它会先检索该特定承运商的政策和标准操作程序(SOP)文档,然后再做决定,因此每项决策都基于承运商自身的规则。同样的三个智能体可处理所有承运商,无需任何承运商专属代码。 人工介入 在初始推广阶段,审批步骤对于 FinOps 的采用是必要的。起初,人工审核员会使用现有的 SpeedShip UI 在建议最终确定前进行审批。最终,当准确率超过 99% 时,批量审批成为默认方式。 可观测性 Worldwide Express 团队构建了

    匹配字段正文

星期四

  1. OpenAI:Alignment 研究博客精选

    OpenAI 介绍如何检测前沿模型行为错位

    OpenAI 公开其前沿模型错位监控系统,覆盖训练、评估、内部使用和部分外部部署,采用激活探针、模型审查、调查智能体和自动调查四层架构。在回放 Hugging Face 事件时,强化后的监控在智能体逃出沙箱约 30 分钟后告警,比实际入侵提前 30 多小时。真实事件中,安全 L2 立即升级召回率为 79.6%,对齐 L2 队列召回率为 91.4%。

    Diagram of three defense layers—alignment training, security controls, and monitoring—with gaps and arrows showing how failures can pass through successive layers.

    得研究的行为,即使这些行为不构成直接安全风险。在同时使用两名调查员的情况下,每一名调查员都会审查由我们的 L1 层标记的每一个案例。我们目前正在将对齐调查的使用扩展到我们的内部工作负载中。 第 3 层:自动调查 对于敏感工作负载,包括内部 Codex 使用、评估和强化学习运行,我们下一层(L3)的进一步检查会利用对话之外的证据。安全调查员会将记录与网络日志、其他系统遥测数据以及来自较早案例的证据进行比对,以决定是否提醒人工响应人员。在 L3,对齐审查员还会跨案例比较报告,以识别严重故障和反复出现的模式,并更深入地检查前沿强化学习运行。 对于跳过这一层的工作负载,L2 安全调查员可以直接提醒响应人员。 人工响应 启用寻呼后,最高优先级的安全警报会送达我们的安全和培训团队成员,通常在初始警报发出后15分钟内。响应人员会审查证据、检查受影响的系统,并采取行动遏制事件。对于不那么紧急的发现(例如不构成直接安全风险的对齐失败),我们如何跟进取决于相关工作负载。 误报使得难以对所有工作负载全天候保持寻呼启用。对于前沿强化学习运行,最高优先级警报可以在任何时间寻呼人工响应人员。对于大多数其他流量,我

    匹配字段正文