←搜索结果

按匹配度 · 共 2018 条结果 清除搜索

星期三

  1. The Rundown AI

    Google DeepMind 发布 Genie 4 世界模型,可生成音效并与场景角色对话

    Google DeepMind 发布新一代世界模型 Genie 4,可将提示词实时转化为可探索的逼真场景,并首次由 Genie 模型自行生成背景音和音乐,场景中的角色也能进行实时对话。用户通过键盘移动,并用文本提示在场景中即时修改内容,场景在多次输入之间保持连贯。演示中一个模拟的 Apptronik Apollo 机器人下跳棋,每一步由 Gemini 4 Argon 规划,指向 Genie 未来的机器人训练用途。

    一天发布。 美国总统Donald Trump发帖称,他将“在所有相关文件中禁止使用‘AI/人工智能’一词”,这是朝超级智能迈进的又一举措。 AI-for-physics实验室Physical Superintelligence发布了五篇新论文,每篇都配有计算机校验的证明,声称在其内部AI的帮助下,在长期未解的量子物理问题上取得了进展。 Meta从其芯片供应商Nvidia(30亿美元)和AMD(10亿美元)处为其950亿美元的AI融资安排了40亿美元,两家公司同时也在扩大其在Meta数据中心运行的硬件。 Google签署协议,将从2027年起将其TPU芯片放入Oracle的云中,这是竞争对手云巨头首次向客户提供英伟达的自家替代品。 🎓 亮点:新闻、指南与活动 报名参加今天美东时间下午2点的研讨会:获得顾问级深度研究 The AI bubble meets Anthropic’s real numbers Zach Mink • 8分钟AI Google’s Gemini 4 Carbon tops the charts (for now) Zach Mink • 8分钟AI Kimi c

    匹配字段正文

  2. 量子位

    逐际动力更新FluxVLA Engine V2技术报告,补充在线强化学习与真机部署评测

    逐际动力更新开源具身工程底座FluxVLA Engine的第二版技术报告,相较9月首版新增在线强化学习后训练实验,并扩展仿真评测与真机部署覆盖范围。报告显示,SmolVLA经在线强化学习后,在LIBERO-10和RoboTwin Clean十项任务上的成功率分别提升10.0和15.4个百分点;8组模型与设备组合的推理频率提升至2.31–9.64倍。真机侧在ALOHA、双臂Franka、Rebot和自研人形机器人LimX Oli上验证了从模型checkpoint到闭环执行的部署链路。

    “卡顿”与“抽搐”,FluxVLA Engine放出了一套硬核的系统工程组合拳。 第一招:无损榨干算力,推理最高狂飙9.64倍 在不改动模型任何权重的前提下,FluxVLA Engine针对GR00T、π0.5等模型进行了深度的底层推理重构,把冗余计算和内核调度开销砍到了极致。 报告记录的8组模型与设备组合中,优化后的推理频率提升约2.31至9.64倍。 在NVIDIA A100上,π0.5的推理频率从2.20Hz提升至21.2Hz,足足快了9.64倍; 在算力受限的AGX Orin 64GB上,GR00T从3.20Hz提升至7.40Hz,π0.5则从1.40Hz提升至4.40Hz。 更绝的是这家伙快而不糙—— 针对GR00T动作头的数值对齐测试表明,加速后的动作输出与原版相比,余弦相似度超过0.99999,最大绝对误差仅约0.02。 好家伙,纯靠工程优化把算力潜能榨干!既不花一分钱买新显卡,也几乎不牺牲模型精度。 谁听了不说一句Perfect? 第二招:给动作加上“减震器”,实现大脑与肢体的柔顺咬合 算力提升之外,动作稳定性同样关键。 FluxVLA Engine引入了实时动作分块协

    匹配字段正文

  3. MarkTechPost

    Google DeepMind 发布 Genie 4 实时世界模型,原生生成音频

    Google DeepMind 以研究预览形式向受信任测试者发布 Genie 4 世界模型,可根据文本和图像提示实时生成可探索世界,并原生生成环境音、音乐和角色对话。该模型在仿真循环中引入 Gemini 3.8 Flash 作为规划器,负责拆解目标、检查画面并重新规划,DeepMind 称这是迈向混合世界模型的早期一步。Genie 4 仅托管在 Google 平台,后续将开放给 AI Ultra 用户和 Gemini API 合作伙伴,所有视频与音频均带 SynthID 水印。

    在循环内进行规划、检查帧并重新规划。 未披露参数、分辨率、帧率或基准测试结果。 访问权限首先面向受信任测试者开放,随后开放给 AI Ultra 和 Gemini API 合作伙伴。 漂移和短时会话仍是主要的实际限制。 Michal Sutter+ 发布文章 简介 ⮌ Michal Sutter 是一名数据科学专业人士,拥有帕多瓦大学数据科学理学硕士学位。凭借在统计分析、机器学习和数据工程方面的扎实基础,Michal 擅长将复杂数据集转化为可执行的洞察。 Michal SutterMirendil 发布 Fern 0.1,这是其首个模型,具备 1000 万 token 上下文 $uv pip install omni-parse-bench✓文本✓表格✓布局→ 按页评分在 GitHub 上加星→赞助 相关文章更多来自作者 Prime Intellect 发布 Prime Mega MoE:可训练融合 MoE 内核,前向传播速度提升 3.11 倍 NVIDIA 发布 Nemotron 3.5 Transcribe:一个开放的 30B MoE 模型,支持 40 种语言转录,约 4B 活跃参数

    匹配字段正文

  4. MarkTechPost

    Polymathic AI 与普林斯顿大学发布 FlashMap:用流映射草稿器实现 6.14 倍 LLM 解码加速

    Polymathic AI、普林斯顿大学等机构发布 FlashMap,用连续流映射替代离散扩散草稿器,一次前向传播草拟 16 个 token 的完整块。在 Qwen3-8B 上,GSM8K 温度 0 时实现最高 6.14 倍无损加速,草稿器仅 0.5B 参数。Qwen3-8B 和 Qwen3-4B 的草稿器权重已上架 Hugging Face,并提供 vLLM 和 SGLang 插件。

    无损加速。Qwen3-8B 和 Qwen3-4B 的草稿器权重已在 Hugging Face 上发布,并提供 vLLM 和 SGLang 插件。 TL;DR 规模:0.5B 参数草稿器(Qwen3-8B 为 500M,Qwen3-4B 为 475M);草拟 K = 16 个 token 的块。 运行于:与目标模型相同的 GPU。论文中的加速数据使用 1 块 NVIDIA H200 NVL,并发数为 1,bf16 精度。 性能:在 Qwen3-8B 上测试过的最快草稿器,平均比重新训练的 DFlash 高约 7%。 最佳:在 GSM8K 上、温度 0 时实现 6.14 倍加速(接受长度 7.69 个 token)。 最差:在 Alpaca 上、温度 1 时实现 2.28 倍加速。在 Qwen3-4B 上(温度 0),它在 9 项任务中的 4 项上落后于 DFlash。 什么是 FlashMap? FlashMap 是一种投机解码草稿器,可在 1 步内将高斯噪声映射为 token 块。小型草稿器提出 K 个 token。随后目标模型在 1 次并行传播中检查全部 K 个 token,并保留最

    匹配字段正文

  5. Rohan Paul

    Google TPU 将首次在 Google 之外的超大规模云上运行,Oracle 从 2027 年起部署

    Google 的 TPU 将首次在 Google 之外的超大规模云上运行,Oracle 将从 2027 日历年起部署容量,并在数年内逐步扩大。Oracle 提供电力、冷却和数据中心网络,其 Acceleron 网络把 TPU 集群连接到 Oracle 的数据库和存储,让企业无需跨云传输即可在数据旁微调和部署模型。Google 称第八代 TPU 单芯片 FP4 算力最高 12.6 PFLOPS,大规模训练时集群有效工作时间超过 97%,低延迟服务每美元性能提升最高 80%;其开源 TorchTPU 栈可让现有 PyTorch 代码及 vLLM、SGLang 等工具无需改写模型即可运行在 TPU 上。

    Google 的 TPU 将首次在 Google 之外的超大规模云上运行,Oracle 将从 2027 日历年起部署容量,并在数年内逐步扩大。 Oracle 提供电力、冷却和数据中心网络,其 Acceleron 网络将 TPU 集群连接到 Oracle 数据库和存储,使企业无需跨云传输即可在自身数据旁微调和部署模型。 Google 声称其第八代 TPU 单芯片 FP4 算力最高可达 12.6 PFLOPS,在大规模训练中集群有效工作时间超过 97%,低延迟服务的每美元性能提升最高可达 80%。 Google 表示,其开源 TorchTPU 栈可让现有 PyTorch 代码以及 vLLM、SGLang 等工具无需改写模型即可在 TPU 上运行,从而降低将工作负载从 NVIDIA GPU 迁移过来的成本。 这笔交易将 Google 把 TPU 销售到自家云之外的努力——该努力始于今年早些时候向较小规模供应商的销售——推进到直接与超大规模云厂商竞争。

    匹配字段正文

  6. 面壁智能 OpenBMB

    面壁智能开源 MiniCPM-OCR 套件,含 1B 解析模型与 2B 校验模型

    面壁智能发布开源 MiniCPM-OCR 套件,包含 1B 的 MiniCPM-OCR 1.0 与 2B 的决策模型 MiniCPM-OCR Jev。MiniCPM-OCR 1.0 在 Real5-OmniDocBench 得分 93.68、OCRBench v2 得分 54.7;Jev 可跨模型校验文本、公式和表格,在 JevOCRBench 得分 93.6,超过 JEV-35B-A3B 的 90.1,接近 Qwen3.5-397B-A17B 的 93.8。借助 DSpark,其速度为 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍,SDK 并发优化后可达每分钟 128 页,并支持 vLLM、SGLang、llama.cpp 和 Ollama 部署。

    JEV-35B-A3B(90.1),并接近 Qwen3.5-397B-A17B(93.8)。 每分钟最多 128 页 🤯:借助 DSpark,MiniCPM-OCR 的运行速度是 PaddleOCR-VL-1.6 的 1.49 倍、MinerU2.5 Pro 的 3.62 倍。SDK 的并发优化进一步将吞吐量提升至每分钟多达 128 页。 在你工作的地方部署:Day-0 支持 Arm、后摩智能、Intel 和 NVIDIA,并通过 FlagOS 支持另外 10 家芯片厂商。 适配你的技术栈:vLLM、SGLang、llama.cpp 和 Ollama,并提供量化模型、微调支持和 Agent Skills。 🔗 GitHub:https://t.co/2SlATAJk08 🤗 Hugging Face: MiniCPM-OCR 1.0:https://t.co/i347di4Fju MiniCPM-OCR Jev:https://t.co/ayVzhCJenh 👉 试用 Demo:https://t.co/QsFAJT3AFy 使用 API:https://t.co/dP01jBS2j2

    匹配字段正文

  7. Unite.AI

    Liquid AI 发布 LFM3 系列六款 2B 级开源权重模型

    Liquid AI 于 10 月 27 日发布 LFM3 系列,六款 2B 参数级开源权重模型均从同一个 LFM3-1.7B-Base 分支而来,覆盖文本、视觉、音频、全模态和决策模型。LFM3-1.7B 有 1.73B 参数、256K token 上下文、支持 16 种语言,采用 13 层门控短卷积、5 层滑动窗口注意力和 6 层全局注意力的 Tri-Hybrid 架构,以 LFM Open License v1.0 在 Hugging Face、Liquid AI Playground 和 API 提供。公司称 LFM3-1.7B 以少 35% 的参数超过 LFM2.5-2.6B,4-bit 精度下约占 1 GB 内存,但模型卡说明其不适合智能体编码或复杂多步推理。

    支持 16 种语言,并以 LFM Open License v1.0 发布。基础模型和后训练模型均为开放权重,可在 Hugging Face、Liquid AI Playground 和 Liquid AI API 上获取。 Liquid AI 的发布文章列出了首日发布合作伙伴:Ambarella、AMD、Arm、通过 OpenVINO 支持的 Intel、NVIDIA、OpenRouter、通过 Qualcomm AI Hub 和 GenieX 支持的 Qualcomm,以及 Vercel,并表示 Mercedes-Benz 和 Shopify 参与了发布前的测试与评估。 Tri-Hybrid 架构与训练 LFM3-1.7B-Base 有 24 层:13 层门控短卷积、5 层窗口为 256 token 的滑动窗口注意力层,以及 6 层全局注意力层。卷积的核大小为 7,高于 LFM2 中的 3。还有三项进一步的变化定义了该骨干:逐头门控注意力,其中 sigmoid 门控缩放每个注意力头的输出,可抑制损害量化的激活离群值;部分 RoPE,其中全局注意力层仅对每个头的最高频一半进行旋转,而

    匹配字段正文

  8. Unite.AI

    Anthropic 公布 Claude 在药物研发中的早期进展

    Anthropic 于 2026 年 10 月 27 日发布生命科学进展更新,披露与 BigHat Biosciences、Bristol Myers Squibb、Divergence Labs、Enveda、Generate Biomedicines 和 The Column Group 六家机构的合作早期结果,以及首个自研药物项目。Generate 的六名科学家用 Claude Code 搭建智能体系统,从 186 个 CAR T 细胞疗法信号域重设计中选出候选,其中一个设计比标准版本短约 70%,实验室测试中细胞表面受体数量约为原来的 10 倍。Divergence Labs 称 Claude 在约 2,750 小时 H100 算力下生成约 35,000 个抗体设计,91 个测试的 disruptor 设计中有 20 个可测量地剥离已结合的 IgE。Enveda 用 Claude 审阅 1,061 页生产批记录,将审查时间从 25.9 小时降至 2.8 小时,并称研究性新药申请 Module 2 的起草从约三个月缩短到四小时。Anthropic 强调这些结果仍处早期、多为临床前阶段,尚未在患者中验证安全性和有效性。

    结果,尚未在患者中测试安全性和有效性,下一步将进行小鼠模型测试并制定实体瘤靶点策略。 Divergence Labs 是一家成立于 2025 年的生物技术公司,正在设计一种食物过敏药物,采用双臂抗体设计,旨在既中和游离的 IgE,又剥离已与免疫细胞结合的 IgE。Anthropic 报告称,Claude 在 22 段自主工作时段中共计约 2,750 小时的 Nvidia H100 GPU 计算时间内,生成了约 35,000 个抗体设计。Divergence 报告称两个臂均取得早期命中:在 91 个测试的 disruptor 设计中有 20 个可测量地剥离了已结合的 IgE,其中三个在患者可实际接受的浓度下似乎优于已获批药物 Xolair;在 57 个测试的 anchor 设计中有三个与 IgE 结合。据报告,从构思到获得实验室结果,disruptor 臂耗时约三周,anchor 臂耗时约四周半,而此前同类工作最长需要九个月。Divergence 团队也指出了局限,发现 Claude 在决定是进一步研究某个结果还是继续推进方面,不如人类操作者务实,并表示这些结果距离成为一种新药还很遥远。

    匹配字段正文

  9. Publickey

    Oracle Cloud 宣布引入 Google TPU,2027 年起提供服务

    Oracle 在 Oracle AI World 2026 主题演讲中宣布,将把 Google 自研的 AI 芯片 Google TPU 引入 Oracle Cloud Infrastructure,并计划于 2027 年开始提供 Google TPU 服务。Oracle 表示将为大规模部署提供电力、冷却和数据中心内网络等配套。文章还提到 Google Cloud 上周开源了让 PyTorch 原生支持 TPU 的 TorchTPU。

    Cloud上为大规模部署该Google TPU提供电力、冷却、数据中心内网络等。 Oracle Cloud上的Google TPU预计于2027年开始提供。 Oracle Cloud引入Google TPU的原因 甲骨文在云市场上正拼命追赶领先的AWS、Microsoft Azure、Google Cloud。 在当前快速增长的AI市场中,这三家公司不仅使用NVIDIA的GPU,还各自推出自研AI处理器以构建独特价值,在此背景下,甲骨文与Google联手,使Oracle Cloud也能为客户提供NVIDIA以外的AI处理器选项,对于旨在提供擅长AI处理的云基础设施的甲骨文而言,可以说是合理的战略。 另一方面,Google Cloud正致力于强化Google TPU,以打破NVIDIA在AI处理器市场的堡垒。 因此,不仅能在自家的Google Cloud上,还能在Oracle Cloud上部署Google TPU,对于扩大Google TPU的使用而言无疑是理想的。 Google Cloud上周以开源方式发布了“TorchTPU”,使机器学习和AI处理中具有代表性的库PyTorch原生支

    匹配字段正文

星期四

  1. The Rundown AI

    Google 发布 Gemini 4 Carbon,17 项基准中登顶 15 项

    Google 发布面向网络安全与长时编码任务的前沿模型 Gemini 4 Carbon,在 Google 自家 17 项基准中登顶 15 项,但尚未公开,仅向部分网络安全防御人员开放。其在 Artificial Analysis 的 Intelligence Index 上得 59 分,超过 Claude Opus 5.5,比四周前的 Argon 提升 9 分;在长输入推理上领先 OpenAI Astra 和 Opus 24 分。API 介绍价为每百万 token 输入 2 美元、输出 10 美元,为 Opus 5.5 的一半,折扣期后翻倍至 Opus 的费率。Google 未公布扩大开放的时间。

    并附在电子邮件中发送给该潜在客户。第四个智能体被设置为在潜在客户回复后作出回应,为他们预约通话,并将通话添加到日历中。” 在我们的社区工作流中心查看该工作流 → 🛠️ 热门 AI 工具 ⚙️ QVAC SDK - 可免费且私密地运行任何开源模型(聊天、图像、语音生成等)。在 GitHub 上试用并加星 💬 Nemotron 3.5 Transcribe - Nvidia 的可转录 40 种语言的 AI 🔴 ChatGPT Dot - OpenAI 的常驻智能体,现可通过短信使用 ⚙️ GitHub Copilot Fusion - 可为每项任务自动挑选 AI 模型的 Copilot 模式 赞助列表 📰 今日 AI 其他动态 OpenAI 正将数百名员工调入一个“作战室”,为下周的美国中期选举做准备,在本月标记出其模型上的俄罗斯和伊朗影响力行动后,搜寻 ChatGPT 的滥用情况。 Artificial Analysis 发布了其“智能指数”AI 排行榜的 v5 版本,如今更多依赖私有测试,中国开源模型在排名中进一步落后,而 OpenAI 的新 Terra 模型尽管处于中端水平,表现却更

    匹配字段正文

  2. Mistral AI精选

    Mistral 开放 Mistral Large 4(Le Chonk)权重

    Mistral 发布 Mistral Large 4(Le Chonk)的开放权重,这是一个 1 万亿参数的原生多模态模型,在预览版基础上继续强化学习,编码与防御性网络安全能力提升。它在 FrontierCode 2.0 上得分 19.7%,在 Artificial Analysis Coding Agent Index 上得 48%,与 GLM-5.3 基本持平,但每任务平均少用 47% token;Terminal-Bench 4.0 提升 13 个百分点至 41%。模型支持三种推理模式,采用修改版 MIT 的 Mistral Ecosystem Open-Weight 许可,API 定价为每百万输入 token $0.70、缓存输入 $0.07、输出 $2.10。

    Le Chonk signal

    灵活性、选择权和控制力。像Mistral Large 4这样的创新代表着AI变革网络防御潜力的有前景的进步。我们将持续的AI创新视为加强网络安全、帮助组织应对不断演变的威胁格局的重要机遇。 John Whittle,Fortinet首席运营官 开放模型让安全研究人员和开发者能够检查、调整并基于AI进行构建。Mistral正在拓展生态系统所能构建的范围,我们在NVIDIA加速基础设施上的合作帮助开发者将这些模型投入实际使用。 Kari Briski,NVIDIA开放模型与软件副总裁 随着威胁变得愈发快速、工业化并如今实现自动化,防御必须以不同的规模运作。数量、速度、信任:这是AI时代网络安全面临的三大挑战。与Mistral AI携手,我们正在打造欧洲网络AI,由我们的专家训练并在其控制下运行。通过结合AI的力量、我们团队的专业知识以及我们的网络威胁情报,我们正在加速响应,从而能够更广泛、更快速地提供保护,并采用可信的欧洲技术。 Hugues Foulon,Orange Cyberdefense首席执行官 Rubrik支持Mistral以及推动“主权AI”的努力,为欧洲各国政府和受监管行业

    匹配字段正文

  3. TechSpot

    微软 AI 基础设施支出比预期少 65 亿美元,因数据中心交付延迟

    微软 9 月季度资本开支(含融资租赁)为 452 亿美元,比分析师预期的 517 亿美元少 65 亿美元,但仍同比增长约 30%。CFO Amy Hood 将差额归因于第三方数据中心容量交付延迟,相关设施预计在微软下半财年上线,同时把 2026 自然年支出预期从 1750 亿美元下调至 1700 亿美元。微软当季新增 24 个数据中心,并自 2023 年以来与 CoreWeave、Nebius、Nscale 签约超过 800 亿美元;Azure 收入增长 48% 至 332 亿美元。

    上涨。 微软本季度新增了24个数据中心,但它也依赖较小的云运营商。据《金融时报》报道,自2023年以来,它已与CoreWeave、Nebius和Nscale签署了超过800亿美元的合同。 一些项目正陷入困境。微软最近因电力限制放弃了一项Nscale容量协议,而Nebius在新泽西州的一处设施进展慢于预期。 这类问题并非微软独有。亚马逊正在囤积价值数十亿美元的Nvidia机架,因为一些设施缺乏运行它们所需的电力。其今年约2200亿美元的资本支出预算,比微软修订后的预期高出500亿美元。 与此同时,Alphabet维持其1950亿至2050亿美元的年度预算。它在9月季度支出了514亿美元,同样低于预期,并预计明年支出将大幅增加。其季度自由现金流为负91亿美元,延续了谷歌7月报告首个季度自由现金流为负以来的趋势。 Azure为微软的巨额账单提供了一些理由。收入增长48%至332亿美元,而公司的自由现金流仍为正,达186亿美元。 在加大支出之际,微软继续削减员工成本,包括向多达6万名员工提供买断方案。 与此同时,Alphabet维持其1950亿至2050亿美元的年度预算。它在9月季度支出了51

    匹配字段正文

  4. MarkTechPost

    MiniMax 开源 MCode Stack:17 个 Agent 技能与 5 份清单

    MiniMax 于 10 月 28 日以 MIT 协议开源 MCode Stack,包含其团队构建 MiniMax Code 所用的 17 个 SKILL.md 技能和 5 份清单,不含 MiniMax Code 源码。技能按规划拆分、上下文与工具、长会话与命令、评审、实验与热修分组,其中 independent-review 只向评审者提供 diff、需求和测试结果。可通过复制技能目录、本地插件或插件市场安装到 MiniMax Code,也能在 Claude Code 中用 /plugin marketplace add MiniMax-AI/mcode-stack 安装;原文未公布评测结果。

    场安装到 MiniMax Code 或 Claude Code。 尚无已发布评测,因此应将其视为操作手册,而非证明。 Michal Sutter+ 文章简介 ⮌ Michal Sutter 是一位数据科学专业人士,拥有帕多瓦大学数据科学理学硕士学位。凭借在统计分析、机器学习和数据工程方面的扎实基础,Michal 擅长将复杂数据集转化为可付诸行动的洞见。 Michal SutterMirendil 发布其首个模型 Fern 0.1,具备 1000 万 token 上下文 $uv pip install omni-parse-bench✓文本✓表格✓布局→ 按页评分在 GitHub 上加星→赞助 相关文章更多来自作者 Baseten 发布 joey-1,一个每 100 万 token 收费 0.01 美元的 2B 决策模型 Prime Intellect 发布 Prime Mega MoE:可训练的融合 MoE 内核,前向传播速度提升 3.11 倍 NVIDIA 发布 Nemotron 3.5 Transcribe:一个面向 40 种语言转录的开放 30B MoE 模型,约 4B 活跃参数

    匹配字段正文

  5. MarkTechPost精选

    Google DeepMind 发布 Gemini 4 Carbon,主打网络安全防御与编码

    Google DeepMind 推出 Gemini 4 Carbon,称其为面向长周期智能体编码和网络安全防御的前沿模型,在 Artificial Analysis Intelligence Index v5.0 上以 59 分排名第一。该模型在 GraphWalks 长上下文测试中取得 96.2%,在 SEC-bench Pro、ExploitGym 和 CWE-bench 上分别为 88.2%、54.8% 和 71.0%,但在 OSWorld-2.1 上以 81.5% 落后于 Claude Opus 5.5 的 87.2%。目前 Carbon 仅向经过审核的网络安全防御方开放,定价为每百万 token 输入 2 美元、输出 10 美元的引入价,后续为 4 美元和 20 美元,开发者和公众的开放时间未公布。

    美元。 Asif Razzaq网站 | + 文章简介 ⮌ Asif RazzaqBaseten 发布 joey-1,一个 2B 决策模型,价格为每 100 万 token 0.01 美元 Asif RazzaqPrime Intellect 发布 Prime Mega MoE:可训练的融合 MoE 内核,前向传播速度提升 3.11 倍 Asif RazzaqNVIDIA 发布 Nemotron 3.5 Transcribe:一个开放的 30B MoE 模型,支持 40 种语言转录,约 4B 活跃参数 $uv pip install omni-parse-bench✓文本✓表格✓布局→ 按页评分在 GitHub 上加星→赞助 相关文章更多来自作者 Baseten 发布 joey-1,一个 2B 决策模型,价格为每 100 万 token 0.01 美元 Prime Intellect 发布 Prime Mega MoE:可训练的融合 MoE 内核,前向传播速度提升 3.11 倍 NVIDIA 发布 Nemotron 3.5 Transcribe:一个开放的 30B MoE 模型,支持 4

    匹配字段正文

  6. MarkTechPost

    AssemblyAI 发布首款语音合成模型 AssemblyAI-TTS-1,每百万字符 15 美元

    AssemblyAI 发布首款文本转语音模型 AssemblyAI-TTS-1 并正式开放,面向实时电话语音智能体,定价为每 100 万字符 15 美元,不设年度合同和并发档位。该模型仅以托管 API 形式在 us-east-1 和 eu-north-1 提供,支持 HTTP、WebSocket 和 OpenAI 兼容接口,内置 4000 多种音色、即时声音克隆和 6 种语言。厂商自测显示实体准确率 93.7%、首字节中位延迟 47 ms,但 Cekura 独立基准测得流式延迟 159 ms、朗读准确率 81.5%,且发布时尚不支持 SSML、语速控制和情感标签。

    得流式延迟 159 毫秒,朗读准确率 81.5%。 发布时缺失:SSML、语速控制、发音词典和情感标签。 Michal Sutter+ 发布 简介 ⮌ Michal Sutter 是一名数据科学专业人士,拥有帕多瓦大学数据科学理学硕士学位。凭借在统计分析、机器学习和数据工程方面的扎实基础,Michal 擅长将复杂数据集转化为可执行的洞察。 Michal SutterMirendil 发布其首个模型 Fern 0.1,支持 1000 万 token 上下文 $uv pip install omni-parse-bench✓文本✓表格✓布局→ 按页计分在 GitHub 上加星→赞助 相关文章更多来自作者 Baseten 发布 joey-1,一个 20 亿参数的决策模型,每 100 万 token 收费 0.01 美元 Prime Intellect 发布 Prime Mega MoE:可训练的融合 MoE 内核,前向传播快 3.11 倍 NVIDIA 发布 Nemotron 3.5 Transcribe:一个开放的 300 亿参数 MoE 模型,支持 40 种语言转录,约 40 亿活跃参数

    匹配字段正文

  7. MarkTechPost

    Infini-AI-Lab 开源 Hermit harness 适配器框架

    Infini-AI-Lab 发布开源框架 Hermit,通过训练外部 harness 适配器来适配 AI 智能体,模型与 harness 保持冻结,v0.1.0 于 2026 年 10 月 25 日发布。框架为 Python 实现、Apache-2.0 许可,可用 pip install hermit-harness 安装,内置 GEPA、SkillOpt、MetaWorld Model、Harness² 和 Continual Harness 五种演化方法。在 GLM 5.3 Flash 上,MWM 适配器在 CL-Bench 数据库探索任务达到 0.795 准确率,高于 in-context 基线的 0.580,但多数结果为单次运行的自报数据。

    适配器可部署到 Codex、Claude Code 和 Pi,或导出为插件。 结果均为自报,大多为单次运行,使用 GLM 5.3 Flash。 Asif Razzaq网站 | + 文章简介 ⮌ Asif RazzaqPrime Intellect 发布 Prime Mega MoE:可训练融合 MoE 内核,前向传播快 3.11 倍 Asif RazzaqNVIDIA 发布 Nemotron 3.5 Transcribe:一个开放的 30B MoE 模型,支持 40 种语言转录,约 4B 活跃参数 Asif RazzaqPolymathic AI 与普林斯顿大学研究人员发布 FlashMap,一种用于 LLM 解码提速 6.14 倍的流映射起草器 $uv pip install omni-parse-bench✓文本✓表格✓布局→ 按页评分在 GitHub 上加星→赞助 相关文章更多来自作者 Prime Intellect 发布 Prime Mega MoE:可训练融合 MoE 内核,前向传播快 3.11 倍 NVIDIA 发布 Nemotron 3.5 Transcribe:一个开

    匹配字段正文

星期五

  1. MarkTechPost

    Prime Intellect 发布 Prime Mega MoE 训练内核,前向最高提速 3.11 倍

    Prime Intellect 发布 Prime Mega MoE,在 DeepSeek 开源 DeepGEMM 库的 Mega MoE 内核基础上补上了融合且重叠的反向传播,使其可用于训练而非仅推理。在 prime-rl 训练器中,Qwen3 MoE 模型的完整训练步比基线快 32% 至 34%,比 TorchTitan 快 48% 至 55%;单层前向最高提速 3.11 倍(12.0 ms 降至 3.9 ms),但 Qwen3-235B-A22B 的反向仅提速 1.24 倍。该内核支持 BF16、Blackwell 上的 MXFP8 和 Hopper 上的 blockwise FP8,以 Apache 2.0 随 prime-rl 发布,通过 mega_moe 分发后端启用。

    中,Qwen3 MoE 模型的完整训练步骤运行速度最高提升 34%。与 TorchTitan 相比,提升达到 55%。对于训练混合专家(MoE)模型的团队来说,这直接减少了 GPU 小时数。 TL;DR 规模:一个 GPU 内核,而非模型。在 Qwen3-30B-A3B 和 Qwen3-235B-A22B(128 个专家,top-8 路由)上测试。 运行于:NVIDIA Hopper(blockwise FP8)和 Blackwell(MXFP8)GPU,两者均支持 BF16。公布的数值使用 8×H200 节点,32 至 128 块 GPU。 性能:完整训练步骤比 prime-rl 基线快 32% 至 34%。比 TorchTitan 快 48% 至 55%。 最佳:在 Qwen3-30B-A3B MoE 层上前向传播快 3.11 倍(12.0 ms 降至 3.9 ms)。 最差:在 Qwen3-235B-A22B MoE 层上反向传播快 1.24 倍(30.5 ms 降至 24.6 ms)。 什么是 Prime Mega MoE? Prime Mega MoE 是 Prime Int

    匹配字段正文

  2. MarkTechPost

    Baseten 发布 2B 决策模型 joey-1,每百万 token 定价 0.01 美元

    Baseten 旗下 Base Labs 发布 2B 决策模型 joey-1,基于 Qwen3.5-2B 后训练,直接返回标签和校准概率而非生成文本,面向高并发路由、分类和护栏检查。模型在 Jev Decision Index 0.4 公开集得分 63.30,为 4B 以下最高,但比 9B 的 elephant-1 低 8.94 分。Model APIs 定价每百万输入 token 0.01 美元,平均 2000 token 请求 P50 延迟 20 ms,权重以 MIT 协议开源在 Hugging Face,可单张 CUDA GPU 自托管。

    ion Index 0.4 公开集上得分 63.30:4B 以下最强模型。 比 elephant-1 低 8.94 分;最适合作为一线路由器。 MIT 权重已发布于 Hugging Face;可在 1 张 CUDA GPU 上自托管。 Asif Razzaq网站 | + 文章作者简介 ⮌ Asif RazzaqPrime Intellect 发布 Prime Mega MoE:可训练融合 MoE 内核,前向传播快 3.11 倍 Asif RazzaqNVIDIA 发布 Nemotron 3.5 Transcribe:面向 40 种语言转录的开放 30B MoE 模型,约 4B 激活参数 $uv pip install omni-parse-bench✓文本✓表格✓布局→ 按页计分在 GitHub 上加星→赞助 相关文章更多来自作者 Prime Intellect 发布 Prime Mega MoE:可训练融合 MoE 内核,前向传播快 3.11 倍 NVIDIA 发布 Nemotron 3.5 Transcribe:面向 40 种语言转录的开放 30B MoE 模型,约 4B 激活参数

    匹配字段正文

星期二

  1. Together AI Blog

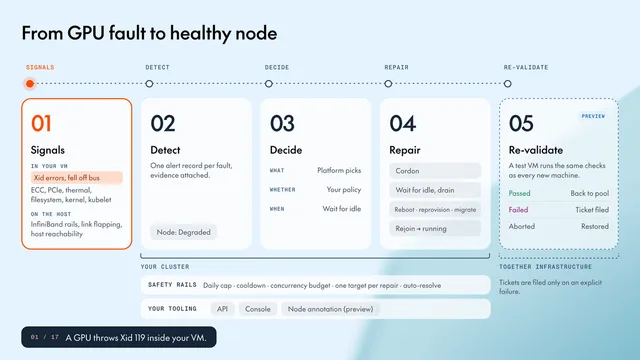
    Together AI 详解 GPU 集群自动修复:从 GPU 故障到健康节点

    Together AI 介绍其 GPU 集群自动修复系统,已正式提供被动健康检查、修复建议、自动修复策略(含按故障和按节点授权)、等待空闲控制、升级阶梯、安全护栏以及 API 与控制台修复,基于节点标签的自定义检测接入仍为预览。系统分检测、决策、修复、复验四阶段,前三个阶段在用户集群内运行,复验在 Together 侧对腾出的物理机执行。平台按信号映射最轻修复动作,用户可决定是否自动执行及等待时长,同一故障同一动作重复两次后自动升一级。

    Auto repair pipeline: signals from inside the VM and from the host feed Detect, Decide and Repair inside your cluster; migrated hosts go to Re-validate on Together infrastructure.

    反复重启 在 Slurm 上,导出器会报告被标记为 DOWN 或 DRAIN 的节点。 在主机上, 我们监控 InfiniBand 通道状态和链路抖动,并将其归因于拥有这些通道的 VM。我们还监控主机可达性,因此死掉的主机会在您的节点上显示为问题,而不是一片沉默。 每个告警都附带稳定的摘要、通俗语言的描述和机器可读的证据载荷。对于 Xid,就是每个代码及其 NVIDIA 助记符。对于热降频,就是峰值温度和降频次数。控制平面原样传递这些字符串,因此控制台、API(作为 linked alerts)和您的通知始终表达相同的内容。 我们将观测与可操作区分开来。每个与修复相关的告警都会被记录,并将您的节点标记为 Degraded. 只有具有操作映射的信号才会创建修复。例如,磁盘压力会显示出来,但不会触发重启,因为重启无法解决它。没有映射的告警会被计数并记录,绝不会被静默丢弃,并会转交我们的支持团队进行调查。 2. 策略:我们决定做什么,您决定是否以及何时做 做什么 由平台负责。每个信号都映射到能修复它的最轻量操作,因此您无需知道哪个 Xid 意味着什么: 是否 由您决定。在“修复”选项卡中,

    匹配字段正文

  2. 钛媒体 · AGI

    Edge AI Daily 早报:Anthropic 递交 IPO 申请,OpenAI 发布 GPT-6.1 Terra

    Anthropic 于 2026 年 10 月 26 日向 SEC 递交 S-1,拟以代码“ANT”在纳斯达克上市,目标估值约 2 万亿美元、拟募资高达 1000 亿美元,年化收入运行率突破 650 亿美元。同日 OpenAI 发布 GPT-6.1 Terra,标准 API 定价每百万输入 token 1 美元、输出 5 美元,为 GPT-6.1 Sol 的一半。Meta 则启动至多 950 亿美元股权融资支持 AI 基建,英伟达、AMD、博通有意合计认购最多 50 亿美元。

    年仅50%-60%既定产能可如期投运;Urban Institute称313项暂停令已覆盖44州200多个辖区,审批不确定性正被计入资产定价,抬升数据中心REITs与基础设施基金的资本成本及政治风险溢价。 国内进展: 十一、通用大模型加速向机器人动作控制延伸 1.中信证券2026年10月26日研报称,通用大模型正从机器人高层任务规划向动作生成与执行控制延伸,NVIDIA、斯坦福等机构已探索将GPT-6 Astra接入机器人控制回路,以借助其视觉理解、空间推理与任务规划能力减少对专用策略训练的依赖;研报判断,展望2027年通用模型进入具身任务领域将成AI行业下一个投入方向,短期与VLA、WAM等专用模型形成分工协同而非相互替代。 2.能力与瓶颈并存:斯坦福等机构的HomeBody系统让搭载Astra的宇树G1在新环境零训练完成厨房任务,Astra在RoboCurve机械臂抓取放置任务成功率95%(远超Claude Fable 5.1的40%、Fable 5的5%),单次任务成本约0.94美元;但真车测试单次134.7米耗约660万token(约7.74美元)、平均车速仅0.42米/秒,毫

    匹配字段正文