LMSYS 用 Miles 在 MI355X 上训练 SWE 智能体,SWE-bench Verified…
LMSYS 用 Miles、SGLang、Megatron-LM 和 Harbor 在 AMD Instinct MI355X 上对 Qwen3-30B-A3B-Instruct 做全异步智能体强化学习,在 SWE-bench Verified 的 100 任务分层子集上把 pass@1 从 7.3% 提升到 27.5%。训练分两阶段,先在约 4,000 条 Open-SWE-Traces 公开轨迹上做 SFT,再在约 1,350 个 SWE-smith 任务上跑 GRPO。固定模型和 RL 配方后,推理从 1 个节点扩到 3 个 8 卡节点、改用 E2B 云沙箱并解除并发上限,rollout 吞吐从约 860 提升到约 3,480 条轨迹/小时;在同一 8 卡节点上限制轨迹长度则让单步训练时间从 850 秒降到 284 秒。
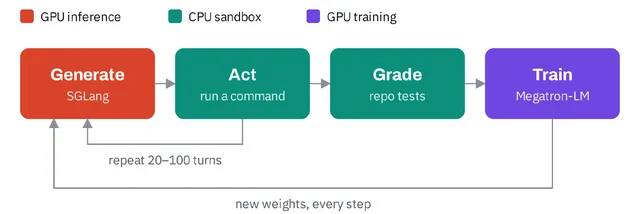
配方保持不变;推理从 1 个扩展到 3 个 8 卡 MI355X 节点,并配合云沙箱和并发修复。 RL 单步速度约提升 3 倍:850 秒 → 284 秒。 在同一 8 卡推理节点上限制轨迹长度可减少长尾。 384 个并发智能体沙箱。 最大规模的运行使用三个推理节点和一个训练节点,每个节点配备 8 块 MI355X。 背景 为什么智能体强化学习与众不同 在编码智能体强化学习中,一个训练样本就是一整个回合。模型阅读 GitHub issue,在沙箱中运行 20 到 100 多条 shell 命令,编辑代码,并且只有在仓库测试通过时才能获得奖励。 图 1: 智能体强化学习循环。一个训练样本就是一整个多轮回合。 与单轮强化学习相比,这种工作负载带来了新的问题: 长尾拖后腿者。 同一任务的两次尝试长度可能相差 2.5 倍,而 GRPO 组必须等到最慢的尝试完成才能评分,因此少数拖后腿者就可能拖住训练。 处于关键路径上的 CPU 集群。 每条轨迹都需要自己的沙箱来构建和测试代码。 架构 推理和训练运行在独立的节点上。推理节点运行八个单 GPU 的 SGLang 引擎和 Harbor,后者负责管
匹配字段正文


