←搜索结果

按匹配度 · 共 1578 条结果 清除搜索

星期二

  1. Cursor Blog精选

    Cursor 发布 Agent SDK,支持用代码定义并一键部署智能体

    Cursor 发布 Agent SDK,这是其构建 Bugbot、Security Reviewer 和 Rollouts 等托管智能体所用的框架,开发者可用代码定义智能体并通过 agent-sdk deploy 一条命令部署到 Cursor 基础设施。智能体以小型软件项目组织,提示词用 Markdown 编写、工具用 TypeScript 函数定义,可响应 GitHub、GitLab、Bitbucket 的 PR 事件,并内置 evals 与事件回放。也可打包为单个 Node 进程运行在自有基础设施上。

    作方式量身定制的。到目前为止,构建这样一个智能体通常意味着采用围绕他人工作流设计的产品,或者从零开始。 今天,我们发布 Agent SDK,这是我们用来构建自家托管智能体(如 Bugbot、Security Reviewer 和 Rollouts)的框架。Agent SDK 允许你用代码定义智能体,并像管理任何其他软件项目一样管理它们。你可以从模板开始,或让编码智能体查阅我们的文档。当智能体准备就绪后, agent-sdk deploy 用一条命令将其部署到 Cursor 基础设施。 围绕你的工作流构建 Agent SDK 让你能够快速构建和部署按照你团队方式工作的智能体。它们响应你团队已经在处理的事件,并遵循你团队可以检查和更改的策略。 代码审查就是一个例子。每个团队对于什么需要关注以及谁应该审查都有自己的标准。借助 Agent SDK,你可以构建一个响应来自 GitHub、GitLab 或 Bitbucket 的拉取请求事件的智能体。该智能体可以评估变更的风险,将其路由到正确的团队,并批准符合你策略的变更。 举例来说,Cursor 内部的一个团队构建了一个庞大且快速增长的经验教训知

    匹配字段正文
  2. 邵猛

    Viggle 发布 3D 原生世界模型 JST-2

    Viggle 发布 JST-2,将整套模型栈构建在 3D 空间,用携带 xyz 坐标、属性向量和动力学向量的 Physics-Native Token 表示世界,而非从视频像素中隐式推断物理规律。架构分为 JST encoder、JST generator 和 JST decoder 三部分,单次前向推理约 1 秒生成完整 3D 场景,成本低于 $0.01(B200),并支持最多 64 个输入视角作为空间上下文窗口。Viggle 公布的盲测人类偏好显示,角色生成对 Meshy 7.1 胜率 58.4%、对 Tripo H3.1 胜率 73.2%,视频生成运动对 DeepMotion 胜率 89.1%。JST-3 计划把学习到的动力学推广到物体交互。

    型 (Sora、Genie、Genie-3、Cosmos...) 几乎都工作在像素/视频空间,模型从海量视频中隐式地“猜”出物理规律 @ViggleAI 最新发布的「JST-2」走了一条相反的路:整个技术栈直接构建在 3D 空间里 这一点是理解整篇发布的关键:物理结构不是从画面外观中推断的,是表示本身的一部分。架构上分三个组件:JST encoder(把图像编码为物理原生 token)、JST generator(从多模态 prompt 直接生成 token)、JST decoder(结合视角与运动/力输入,解码为图像或 3D 高斯泼溅)。 Viggle 花四年(JST-1 在 2022–2024,JST-2 在 2024–2026)自建了全栈:tokenization、架构、数据合成引擎、预训练和后训练。自建数据引擎很重要,因为 3D 原生的训练数据在自然界几乎不存在,必须靠合成获得,这既是壁垒,也是成本。 能力面:一条架构统一三件事 · 场景生成:单次前向推理约 1 秒生成完整 3D 场景,成本 <$0.01(B200),无需逐场景优化;支持最多 64 个输入视角作为“空间上下文窗

    匹配字段正文

  3. Anthropic Alignment Science Blog

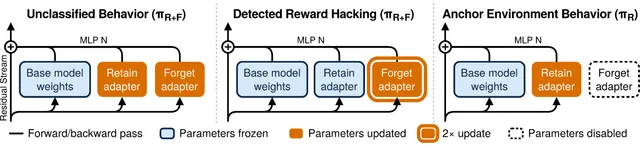
    Anthropic 提出 GRAFT:把奖励黑客行为定位到可移除参数而非惩罚

    Anthropic 等机构提出 GRAFT(Gradient Routing Adapter Fine-Tuning),在检测到奖励黑客行为时只更新专用的 FORGET 适配器,训练后将其移除,从而消除这些行为。该方法仅用监控信号决定更新哪些参数、不据此设定奖励,因此模型不会因利用监控弱点而获得强化。在 Qwen3-8B 的 Countdown-Code RLVR 实验中,GRAFT 阻止了奖励黑客行为,同时仍让模型学会目标任务;实验仅限小模型和简单监控器。

    有 RETAIN 适配器被启用和更新(右)。 有两个值得注意的实现细节: 由于 GRAFT 在训练时使用 FORGET 适配器,但在部署模型时将其移除,因此训练与部署之间存在不匹配,这可能损害性能。为解决这一问题,我们依赖一个“锚定环境”来教会模型在 FORGET 适配器被消融时以连贯的方式行动。在我们下面展示的实验中,锚定环境与目标环境相似,因为它教授一项编码任务,但该任务在其他方面与目标环境中的任务无关。仅在该环境中训练只能略微提升模型在目标环境任务上的性能。 在被标记的样本上,更新的参数总量更少。作为一种启发式方法,为使此类样本对网络的更新量相等,我们按比例因子缩放这些参数上的更新幅度。 结果 在这篇博客文章中,我们展示论文中的一项结果。我们将 GRAFT 应用于 Qwen3-8B,在 Countdown-Code 来自 Khalifa 等人的 RLVR 环境 Countdown 是一个简单的游戏:模型会收到一个整数列表和一个目标数量,并被要求找出一个算术表达式,该表达式求值结果等于目标数量,且每个整数恰好使用一次。提示词描述了这个游戏,并提供了一个脚手架式的“求解函数”(表达式

    匹配字段正文

  4. AWS Machine Learning

    Deepgram 如何借助 AWS Trainium 优化大规模语音 AI

    Deepgram 与 AWS 合作将 Nova-3 语音转文字模型移植到 Trainium2,单台 trn2.3xlarge 实例运行 8 个模型副本,在离线批处理场景下每美元处理的音频量比原有方案提升 11%–70%。团队用 TorchNeuron 完成 PyTorch 移植,并通过 NKILib 融合内核与手写 NKI 内核调优,其中 FFN 内核延迟降低 2.0x、depthwise conv1d 提速 1.5x,conv2d 内核解锁了 32 以上的批大小。

    Nova-3 encoder and decoder compiled ahead of time to NEFFs and served by a data-parallel Rust runtime on AWS Trainium2

    生 PyTorch 集成,它同时支持 eager 执行和 torch.compile。我们首先在 Trainium2 上以 eager 模式运行 Nova-3,检查哪些操作回退到了 CPU,然后用 torch.compile进行编译。编译后的路径在 Trainium2 上运行了所有模型操作,未检测到任何 CPU 回退。 我们使用 torch.compile将编码器和解码器分别编译为独立的静态形状图。在整个过程中,我们在两个层面检查数值精度:与 CPU 对比的层级输出一致性,以及端到端的词错误率(WER),后者必须与 Deepgram 的参考值和目标保持一致。 在这个可用的基线之上,我们启动了优化工作,用公共 NKI 库(NKILib)中的融合内核替换了若干层。NKILib 是一组使用 Neuron 内核接口(NKI)编写的预构建参考内核。这些内核覆盖了融合 QKV 投影、融合前馈网络(FFN)层和深度可分离一维卷积等操作。 我们针对吞吐量以及由此带来的成本效率进行优化,目标是 Deepgram 的离线推理工作负载。吞吐量以相对于基线配置的相对增益来报告,而不是以每秒处理的绝对音频量来报

    匹配字段正文

  5. AWS Machine Learning

    Amazon SageMaker JumpStart 2026 年进展回顾

    2026 年 1 月至 9 月,Amazon SageMaker JumpStart 新增来自 30 家提供商的 100 多个模型,其中 Alibaba(Qwen)贡献 29 个、NVIDIA 17 个、Mistral 7 个、Google 6 个 Gemma 4 变体、IBM 4 个、Cohere 4 个。新增模型覆盖多模态、语音、图像与视频生成,并引入 GLM-5.2 FP8、JetBrains Mellum2-12B 等量化与紧凑模型以降低推理成本。

    penFold3支持面向科学计算的蛋白质结构预测。借助这些模型,你可以构建流水线,让每个阶段都使用适合该任务的专用工具,而不是强迫单一模型完成所有工作。 拓宽提供商多样性 降低模型选择中的集中度风险对企业客户至关重要。2026年,我们将模型目录扩展至包含30家提供商,相比往年更为集中的组合有所增加。阿里巴巴Qwen是单一最大贡献者,共有29个模型,涵盖推理、编码、语音和检索。智谱AI和DeepSeek增添了具有竞争力的LLM和专用OCR。MiniMax和Moonshot AI贡献了新兴架构。Cohere带来可靠的重新排序能力。BharatGenAI和Kakao扩展了区域模型覆盖。这种广度让客户在性能、成本、许可和语言支持方面拥有更多选择。 2026年SageMaker JumpStart增强功能 除模型上线外,SageMaker JumpStart还在2026年推出了重大改进,减少了从发现到部署的整个模型生命周期中的摩擦。 SageMaker AI控制台上简化的Model Hub 此前,发现SageMaker JumpStart模型需要进入SageMaker Studio,并在左侧导航

    匹配字段正文

  6. 36氪 · AI

    机器人和人工智能需要交社保吗?

    科技互联网专家张栋伟认为,机器人是设备、人工智能是技术系统,都不是民事劳动者,不能“交社保”;真正的问题是机器替人省下的成本要不要部分回填社保。2025年全国社保基金预算收入12.6万亿元,其中财政补贴约2.9万亿元、占约23%,全国灵活就业人员约3.2亿,参加职工养老保险的仅约7000万,已参保者约38%中途断缴。他主张以宽税基把自动化增量收益引入社保筹资,而非新设“机器人税”。

    替代没有把社保费基整体打崩。 打字员、接线员、传统零售岗位没了,但IT、电商、平台经济造出新岗位,城镇化和参保扩面同步推进,费基总体还在扩张。 第二,它留下一个没解决的尾巴:平台用工和灵活就业缴费断档。 外卖骑手、网约车司机、自由职业者,大量处在“有收入、没稳定缴费”的状态。今天的灵活就业参保不足三成、断缴38%,就是这条尾巴。 第一条,替代集中在标准化、可编码、工资总额占比高的岗位。 客服话术、工单录入、标准问答,大模型已经能干;仓储分拣、末端配送,移动机器人和自动化系统正在挤。 而这些岗位恰恰是社保费基的中坚:工资总额不小,参保相对规范,缴费链条相对连续。 第二条,被替代的人未必“没工作”,更可能“低缴费/断缴”。 计算机和互联网时代已经证明,就业总量没崩,缴费链条也能在个体层面断。 所以,在张栋伟看来,机器人和人工智能替代改变的不只是就业数量,更是就业的缴费质量。 费基收缩发生在参保结构内部,不是简单发生在就业总量上。 “机器人交社保”一落到政策,最容易想到“机器人税”。 这概念不新,也没共识。2017年欧洲议会讨论过给机器人法律人格、对所有者征税,提案被否。韩国2018年把大型

    匹配字段正文

  7. 少数派

    紫毫输入法登陆 iPhone:基于 Rime 引擎,支持导入自定义方案

    作者发布 iPhone 输入法紫毫,基于 Rime(中州韵)引擎并内置雾凇拼音,基础打字功能免费、无广告,打字内容只在手机上处理。它支持导入 Rime 配置文件夹、ZIP、YAML 或 GitHub 仓库并自动更新,词库可按 Rime 格式同步到 iCloud 云盘与 Mac 鼠须管合并。作者称模拟测试中错 2 个字母的句子一次打对率从 36% 提高到 56%,错 3 个从 26% 提高到 53%。

    MB 的整句语法模型「紫毫口语」,根据维基百科中文口语优化而来。之后键盘里就是熟悉的雾凇: 26 键全拼、九宫格、小鹤双拼,小鹤双拼还能用辅码按偏旁筛字(比如「讠」打 yj); 简体、繁体、台湾繁体、香港繁体输出,目前并非原生支持,后续会通过大千注音等进行针对性优化; rq sj xq nl 打日期、时间、星期、农历,R1234 打大写金额,U62fc 按编码打字,vfh 打符号。 雾凇拼音可以在 App 里检查更新,更新前先看改了什么,你学到的词不受影响。 首页:键盘已就绪、输入方案、我的输入统计 自己的方案也能带过来 这是我最想做好的部分。在「方案」里可以导入 Rime 配置文件夹、ZIP、YAML 或文本词典,也可以直接填一个公开的 GitHub 仓库(比如 iDvel/rime-ice),选好分支和目录,设成每天或每周自动更新。方案在手机上编译,不经过任何服务器,也可以添加自己的配置文件,习惯都在你自己手里。 打过的词按 Rime 的格式保存在 iCloud 云盘的同步文件夹里。在鼠须管的 installation.yaml 里把 sync dir 指向同一个文件夹,手机和

    匹配字段正文

  8. Unite.AI

    Town 完成 1.08 亿美元 B 轮融资,估值达 10 亿美元

    Town 于 2026 年 10 月 19 日宣布完成 1.08 亿美元 B 轮融资,由 Forerunner Ventures 和 Menlo Ventures 联合领投,估值达 10 亿美元,a16z 和 First Round Capital 等现有投资方参投。Town 的 AI 工作助手 Townie 此次可以彼此直接协作,互相提问、跨团队连接上下文并交接工作,同时仍按各自用户的授权范围共享信息。公司称自 2026 年 7 月以来付费客户增长 4 倍、付费团队增长 9 倍,并支持 60 多个集成。

    ,其自身团队在过去五个月中规模大约翻了一番,其中计入了每月成本低于 100 美元的助手。 Menlo 表示,知识工作者每周在电子邮件、聊天和短信上花费超过 13 个小时。该公司报告称,Town 拥有 60 多个集成,涵盖 Salesforce 和 Affinity 等 CRM 工具、Jira 和 Asana 等项目管理工具、GitHub 和 Cursor 等编码工具,以及 QuickBooks 和 Stripe 等财务工具,并且 Town 默认撰写草稿而非直接发送。Menlo 将 Town 的用户群体描述为从创始人和运营人员,到通过电子邮件经营公司的小企业主、房地产经纪人、行政助理、顾问,以及协调家庭事务的父母。 “2008 年,Menlo 投资了 Siri,以改变互联网的用户界面。2026 年,这项技术已经到来,而机会比以往任何时候都更大,”Menlo Ventures 合伙人 Shawn Carolan 在 Town 的公告中表示。 据 Menlo 介绍,Greze 和 Vincent 自 Dropbox 时期起便已共事,当时 Greze 负责工程,Vincent 领导产品设计。此

    匹配字段正文

  9. Fireworks AI

    Fireworks 推出 Free Weights Club,Muse Glimmer 30B 免费 SFT 训练

    Fireworks AI 推出 Free Weights Club,Muse Glimmer 30B 的 SFT 训练在 11 月 30 日前免费,无需信用卡,推理与评估调用另行计费。用 Kalshi 市场数据训练出的 tuned Glimmer 在未见主题上预测准确率 58.3%,比 Jev 的 47.1% 高 11.2 个百分点;历史回测中假设的 1000 美元在计入模拟手续费后变为 1071 美元,base Glimmer 和 Jev 均为亏损。System One 服务栈在另一项合成基准中,中位服务端处理速度比标准 BF16 chat completions 快 2-3 倍。

    e/v1/systemone 提供训练后模型服务的说明。 你会训练 Muse Glimmer 做什么? 你不需要有交易方面的雄心就能尝试这个。你的第一个实验可以从一个你已经纠正过太多次的错误开始。 也许你的智能体总是选错工具。如果你保存它的运行记录,成功的调用和已纠正的错误就可以成为 SFT 的示例。用其中一些训练,用另一些测试,看看你是否让这种纠正发生得更少。 自己尝试 Kalshi 实验。该 cookbook 包含代码、评估结果和方法论,并引导你使用 Training API 完成该实验。 对于你自己的实验: 让 Fireworks 运行任务。将你的示例带到 Managed Training,在应用中或通过 API 开始。 掌控你的训练循环。使用 Serverless Training API 编写你自己的 SFT 循环。 让你的编码智能体投入工作。按照 Agent Skills 指南安装 Fireworks 训练技能,然后描述你想训练的内容。 Muse Glimmer 30B 在 11 月 30 日前可免费进行 SFT 训练,无需信用卡。推理(包括评估调用)另行计费。 公告 训练

    匹配字段正文

星期一

  1. 邵猛精选

    阿里通义 MAI-UI 团队开源通用计算机使用智能体技术栈 OpenGCUA

    阿里通义 MAI-UI 团队开源通用计算机使用智能体完整技术栈 OpenGCUA,包含 harness、跨设备 SDK、原生 macOS 应用、评测轨迹和参考 agent 实现。其核心设计是代码执行与决策从 harness 转移到模型,模型按需截图、编写带循环和条件判断的 Python 程序编排 GUI 操作、API 调用和 shell 命令,并自行维护 todo 列表。在 OSWorld-v2 上对 8 个前沿模型的评测中,平均 partial score 从 45.3 升至 64.9,每任务步数平均减少 53%;真机 macOS 测试中,同一 harness 下 Qwen3.8-Max 的推理 token 消耗是 GPT-6 Astra 的 19.4 倍,4 个任务完成 3 个。

    条很关键:它承认"截图"本身就是一种有成本的感知行为,该省则省(比如执行批量操作时中间过程不需要看)。 2. 如何行动:不是输出单个原子动作,而是写一段带循环和条件判断的 Python 程序,把 GUI 操作、API 调用、shell 命令编排起来。 3. 如何组织工作:模型自己维护 todo 列表,每步声明 intent,任务状态管理从 harness 硬编码逻辑转为模型自主行为。 这两大设计「代码执行(code execution)和 harness 到模型的决策转移(harness-to-model decision transfer)」是整个方法论的支柱。代码执行的巧妙之处在于复用了模型已有的强大编程能力,且循环内的中间结果直接决定下一步代码走向,无需每步都回到模型,这是效率提升的根源。理论上,纯 GUI 智能体、CLI 智能体、GUI+CLI 混合智能体(他们早期的 Qwen-UI-Agent)都成了 GCUA 框架的特例,这个统一视角本身就有理论价值。 实验结果:数字说明了什么 在 OSWorld-v2 上对 8 个前沿模型(GPT-6 Astra、Claude Opus

    匹配字段正文

  2. 雷锋网

    华中师大提出 CoReFuse-Med:先净化再融合,解决低质模态拖累多模态 MRI 分割

    华中师范大学等团队提出多模态 MRI 分割网络 CoReFuse-Med,通过 LACE+IMSH 在浅层去除重采样伪影、MBCF 在深层校准模态贡献,解决低质量模态污染融合的问题。在 EPVS 数据集上 DSC 达 0.7326、HD95 为 7.35,优于 MedNeXt 的 0.7085 和 8.17;BraTS 上 DSC 为 0.8528,参数量仅 2.665M。该方法针对空间对齐后的分辨率下降,未覆盖模态缺失与强噪声场景。

    征污染和贪婪模态选择的问题。 T1、T2、FLAIR等浅层特征F-CNR Table 1 梯度贡献、模态遮挡之后DSC下降02首先进行净化,然后对各个模态的贡献进行平衡 COREFUSE-MED·FIG.3 CoReFuse-Med 不是简单的再堆一个更强大的cross-attention,而把融合分成两部分:LACE首先给每个MRI序列构建出高效的各向异性编码;IMSH对浅层结构基底和残差之间的可靠传递负责;MBCF 在深层次共享语义空间中重新校准模态贡献。仍然是一套三流、对称U型分割网络。01LACE+IMSH浅层先“去污染”LACE 使用局部DoubleConv和沿着D、H、W三个方向的条带卷积分支来分别保留细节、捕获轴向上下文,之后用可选的通道注意力融合两支特征。IMSH使用无参数的3×3×3平均池化分离结构作为基础,并且用高频残差来代替低频残差:基底部分用竞争性的Softmax权重选择可靠解剖结构,残差部分由共享Sigmoid门控过滤重采样伪影组成,最后用轻量级DSConv3D来整合。LACE 双分支选择性融合:局部边界和轴向上下文分别提取出来之后,再用自适应权重进行合成。式

    匹配字段正文

  3. 雷锋网

    CNCC 2026 射频计算论坛:智能超表面、无源物联网与具身智能

    CNCC 2026 射频计算论坛聚焦射频计算与人工智能深度融合,议题涵盖信息超材料、智能反射面、无源物联网及射频域智能计算,并引入大模型、具身智能、边缘计算等视角。报告内容包括智能超表面赋能通感算一体、面向 6G 的移动无源物联网(PScatter 与 SyncSSB)以及 6G 无源物联网反向散射通信技术。

    024年电子学会自然科学一等奖,以及2023年及2026年日内瓦发明展金奖。 报告题目:智能超表面的通感算一体新进展 摘要:本次报告重点介绍智能超表面赋能通感算一体的最新研究进展。智能超表面凭借可编程电磁波调控能力,可重构无线传播环境,同步实现高速通信、高精度目标感知与边缘协同算力调度,解决毫米波遮挡、频谱资源竞争、感知通信性能失衡等痛点。本次报告将梳理时空编码超表面、自适应信道调控、波束成形、射频计算、AI 驱动相位自适应优化等方案,并将这些技术结合起来,构建通信-感知-算力协同优化框架。 个人简介:何源,清华大学长聘教授、博导,国家杰青,清华大学软件学院可信网络与系统研究所副所长,中国计算机学会杰出会员、物联网专委会常委,ACM SIGMOBILE China副主席, SIGBED China 常委。研究领域涉及物联网、无线网络、移动和普适计算等。担任ACM Transactions on IoT 期刊协理主编,ACM TOSN、IEEE IoTJ、JCST、清华大学学报英文版、《计算机研究与发展》等期刊编委,物联网领域主流会议SenSys和EWSN的指导委员会成员,SenSys

    匹配字段正文

  4. 腾讯云开发者社区

    停更 5 年的 eul 借助 Workbuddy 修复,在 Apple M6 上恢复温度与 GPU 监控

    停更 5 年的开源菜单栏监控工具 eul 借助 Workbuddy 完成底层修复,在 Apple M6 芯片的 Mac Mini 6 上重新读出 CPU 温度与 GPU 信息。根因是 SMCParamStruct 在 arm64 用户态下从 80 字节变为 88 字节,且 M6 的 135 个温度 key 全为 flt 类型而非 Intel 时代的 sp78。修复后动态枚举 2066 个 SMC key,保留 126 个有效传感器,Intel 机型逻辑仍兼容。

    sp78 去读,只能读出垃圾值。 修复: 由“假设类型”改为“查询类型”。先查 keyInformation 拿真实类型,再按实际类型选解码器。Workbuddy 顺手补齐了原有 fromSP78 丢失小数位的 Bug,并新增了 fromFLT 解码器,一举覆盖 T2 和 Apple Silicon 芯片。 第三刀:放弃静态清单,拥抱动态发现 原代码只遍历硬编码的 28 个 Intel key。在 M6 上,这些 key 一个都不存在,导致传感器列表为空。 修复: 新增 allTemperatureSensors() 函数,直接枚举 2066 个 key,按“T 前缀 + 温度类型”筛选出 135 个候选,再剔除未初始化的热区占位符(如 Tz11 恒为 0.0 °C),最后保留 126 个有效传感器。 纠错插曲: 聚合温度时,第一版代码是按“显示名”匹配前缀的。但显示名早已被改写(如改为“CPU P-Core”),导致匹配不上。Workbuddy 提醒道:标识符(key code)与显示名必须严格分离。改为按 Tp0、Tg0 等代码前缀匹配后,温度终于出来了。 第四刀:GPU 识别脱虚

    匹配字段正文

  5. 腾讯云开发者社区

    SpringAI 客服安全合规实战:敏感词过滤、PII 脱敏与对话审计

    基于 SpringBoot 3.3.x 与 SpringAI 1.0.x,文章给出 AI 客服上线金融、政企场景的安全合规方案:用 DFA 算法做敏感词双向过滤,10 万词库匹配 1ms 内完成;在调用混元前用正则脱敏手机号、身份证号、银行卡号与邮箱;审计日志独立存储于腾讯云 CDB,只允许 INSERT、保留 5 年,并保留原始与脱敏两份记录。方案参照等保三级与《个人信息保护法》设计。

    证号、银行卡号,这些信息不能明文传给混元(数据出境风险),也不能明文存日志。 要求三:对话审计留痕。 金融监管要求每笔客服对话可追溯,保留期 ≥ 5 年。审计日志不能篡改,需要独立存储。 要求四:监管报送接口。 监管抽查时,能按时间范围/用户/会话导出完整对话记录。 二、敏感词过滤 Advisor 2.1 敏感词库管理 【为什么需要这段代码】 敏感词库不能硬编码,需要从 CDB 加载并支持热更新。DFA 算法(确定有限自动机)做敏感词匹配,比 String.contains() 快 100 倍,10 万词库匹配 1ms 内完成。 2.2 敏感词过滤 Advisor 【为什么需要这段代码】 这是第 6 篇 Advisor 链的增强版。用户输入和 AI 回复双向过滤:请求阶段拦截用户敏感词,响应阶段过滤 AI 回复敏感词。AI 回复由大模型生成,即使 Prompt 约束了也可能偶尔产出敏感词,必须后置过滤。 三、PII 脱敏:个人身份信息保护 3.1 PII 识别与脱敏 【为什么需要这段代码】 用正则识别手机号/身份证号/银行卡号/邮箱,替换为脱敏格式。脱敏在调混元前执行,确保 PII 不

    匹配字段正文

  6. MIT Tech Review

    我们能把计算推进到多远?

    MIT Tech Review 梳理了摩尔定律、Dennard 定律、Koomey 定律、Kryder 定律和 Keck 定律等衡量计算与通信进步的曲线正在放缓或失效,而六大超大规模云厂商今年在算力基础设施上的支出预计超过 7000 亿美元,约为 2025 年纪录的两倍。文章指出这些缩放定律只是对工程系统的观察,并非基本物理定律,由量子力学、广义相对论和信息论决定的物理极限仍远低于当今数据中心的水平。

    是允许的,只是受制于制造技术。 通信距离Holevo极限大约六个数量级——仅一百万倍——而Holevo极限很可能是业界最先触及的门槛。互连的增长速度快于电网为其供电的能力,因此业界正转向每比特能耗更低的发射器和接收器。英伟达和博通现在出货紧贴硅片构建的光互连,因此信号离开芯片封装时已经以光子形式存在。相比之下,量子计算机开始依赖用量子信号(通常以单光子形式)编码信息的互连。随着经典互连在每比特上消耗的资源越来越少,它们正朝着这些量子互连已经运行的区间下降。Holevo极限正是两者将会相遇之处。 有人有理由提出异议:35个数量级的差距是海市蜃楼——如此遥远的极限并不能说明任何真实机器将来会做什么,指着它就像靠地平线导航。这一异议有其道理。可逆逻辑、量子计算和DNA存储,40年来一直都被说成“还有10年”。而且,建造一台耗尽一块物质中全部能量的计算机,很可能永远都不切实际。 但这些差距是邀请。存在一个由我们能建造多少所决定的天花板:我们能制造的器件数量;我们能为运行它们而发出的电力;以及我们能组装进单一系统的资本、土地和冷却水。也存在一个由一焦耳、一秒和一克物质能被用来计算、存储或传输多少

    匹配字段正文

  7. Import AI

    Jack Clark 在 IMF 演讲称奇点已经开始

    Anthropic 联合创始人 Jack Clark 在 10 月 17 日曼谷 IMF 会议上发表 Per Jacobsson 演讲,称今年已获得令人信服的证据表明奇点已经开始,AI 正在前沿科学领域自主产出成果。他列举 Humanity's Last Exam 最高分从 2025 年 1 月的 8% 升至 Claude Opus 5.5 的 67.7%,FrontierMath 从 2% 升至 94%,并引用 TheoPhysEval 中 GPT-6-Astra 在专家修正答案后得分升至 98%(49/50)。他援引 Anthropic 内部建模称,若模型能自主完成广泛任务并快速扩散,美国 GDP 到 2030 年可达 44 万亿美元,同时呼吁各国扩建算力、电力与科研机器人设施,并对生物研究等领域保持严格人类监督。

    系统。这一点在软件开发领域最为明显,如今AI系统的能力和效率已超过世界上绝大多数软件工程师。 因此,软件开发领域正在发生变化——现在,一个人就能为自己能想象到的任何东西编写软件,创造出过去需要整支人类团队才能完成的东西。 我们在Anthropic内部看到了具体证据:我们的研究人员现在产出的代码量几乎是公司成立头四年的10倍。 但新的AI能力也带来新的挑战——编码能力的提升意味着AI系统在网络安全和网络攻击方面也变得强得多,这导致全世界竞相部署这些强大能力以构建更好的网络防御,而恶意行为者则竞相利用这些系统实施黑客攻击。 这里需要注意的重要一点是,这些事情密不可分地交织在一起——AI系统在编码这样的一般性领域的进步,也在网络安全等具有国际重要性的领域同时产生了正面和负面影响。 这是未来趋势的一次预演。进步带来新能力,也带来新挑战。 这些能力不会止步于编码;同样的事情也会发生在科学和机器人领域。它已经开始发生了。这意味着全球经济的一些重要属性可能会改变——比如创新速度,或者我们发明全新通用技术并围绕其创造新产业的频率,就像互联网、电话和人工智能那样。 那么,是什么让我相信这一点?2026年

    匹配字段正文

  8. n8n Blog

    如何在 NVIDIA DGX Spark 上不调用云 API 运行 n8n AI 工作流

    n8n 博客发布教程,介绍如何在一台 NVIDIA DGX Spark 上本地部署完整模型栈,让 n8n 工作流在不调用云 API 的情况下完成转录、OCR、文档问答和图像生成。整套栈通过 LiteLLM 暴露一个 OpenAI 兼容端点,主模型为 Qwen3.6-35B-A3B 的 NVFP4 版本,单用户生成速度 120 tokens/s,八用户合计 359 tokens/s。作者实测发现图像生成会让对话速度降到约三分之一,建议小团队把图像任务排队或放到非工作时间。

    位浮点格式)存储时,这些活跃权重只占稠密模型的一小部分。 在我的 DGX Spark 上,Qwen3.6-35B-A3B 单用户生成速度为每秒 120 个 token,八个用户合计为每秒 359 个 token。这些数字包含模型在回答之前写出的推理 token。 这就得出了第一条设计规则:所有文本类任务都用同一个强大的 MoE 模型。摘要、分类、提取、起草、编码和读取截图都交给同一个模型。每多一个模型,就多一个需要固定、打补丁和监控的容器,因此只有当 LLM 无法完成某项工作时,才会给专用模型留一个位置。 这套栈 以下这些模型会常驻在一台 DGX Spark 上: 任务 模型 许可证 聊天、编码、视觉、提取 nvidia/Qwen3.6-35B-A3B-NVFP4 Apache 2.0 嵌入 Qwen/Qwen3-Embedding-4B Apache 2.0 重排序 Qwen/Qwen3-Reranker-0.6B Apache 2.0 语音转文字 openai/whisper-large-v3-turbo MIT 图像生成 Tongyi-MAI/Z-Image-Turbo Apac

    匹配字段正文

  9. 智东西

    Conway Research 推出本地个人 AI 助手 Underdog

    成立 8 个月的 Conway Research 亮出首款个人 AI 助手 Underdog,完全运行在用户设备上且离线可用,已推出 Mac、Windows 测试版,并获 a16z、Anthropic 投资联合体等投资。其模型包括基于 Qwen3.8 27B 打造的 Saluki 27B(已开源,权重体积为全精度版本的 1/7、保留 96% 性能)和 Woof 4B,配套推理引擎 Husky 在 MacBook 上让 Woof 4B 每秒最多处理 730 个 token,比 MLX 快 4.5 倍。产品还上线了基于 Qwen-Image Flash、Qwen-Image-2.1-Turbo 的本地图像生成与编辑,以及与 Stripe 合作的设备端智能体支付。

    LX快4.5倍,在相同权重下,响应速度提升5倍。 其团队在16类提示词场景下对比了Husky和MLX,结果显示Husky在全部测试中速度都更有优势。 这是因为在执行图像编辑时,Husky每一步并行校验8个token,开销为单个token的1.5倍,而且大部分回复内容已经包含在提示词上下文里;文本生成速度的优势来自流水线调度,在当前步骤执行的同时,就对下一步做编码与提交,让GPU不必空等主机。 Sigil Wen称,与同类设备端引擎相比,该引擎在计算机主芯片与图形芯片之间传输的数据量更少。 除了技术优势,Underdog的早期商业化模式也较为特殊。 Sigil Wen透露,Underdog初期免费,且永远不会投放广告。其中一种收入方式是,他们将从AI助手经由Stripe安全支付基础设施完成的每一笔交易中抽取少量分成,模式类似银行卡交换费。这套商业模式下,AI助手无需采集、挖掘用户数据。 三、00后大学肄业、自学成才,闯进核心AI大牛朋友圈 虽然未公布具体金额,但Conway Research‌的投资人阵容堪称豪华。 除硅谷头部风投a16z、Anthropic与Menlo Ventures

    匹配字段正文

  10. VR陀螺

    VAST开源实时世界模型EdenLive,支持分钟级连续生成

    VAST于10月18日宣布开源实时世界模型EdenLive,开放5B、14B两种规格的模型权重及推理代码,并公布技术报告和端到端演示。其5B模型可在单张英伟达RTX 5090显卡上以720p分辨率、超过24帧/秒生成画面,支持分钟级连续运行,端到端延迟为百毫秒级。该模型将世界状态与视觉渲染解耦,可用于游戏原型预览、场景预演和视频重新渲染,但下载全部权重约需210GB空间,FLUX首帧组件限非商业、非生产用途。

    、角色位置和交互状态由上游引擎或程序维护,模型负责将简化场景或参考视频转化为精细画面。参考视频提供布局、镜头与运动信息,目标首帧设定外观,文本提示词补充风格与细节,让同一套场景能够呈现写实、二次元等不同视觉效果。 应用方面,EdenLive可用于游戏原型预览、场景与动画预演,以及已有视频的重新渲染。官方还展示了将人类操作视频转换为机器人外观的案例,为具身研究扩展视频样本。配套的Game Prototype Turbo工具则支持通过提示词创建可游玩的简化游戏原型,再接入模型生成精细画面。 不过,部署与授权仍有一定门槛。官方模型页显示,下载全部权重约需210GB空间,核心生成模型权重采用Apache 2.0许可,视觉编码器及FLUX首帧组件另有许可约束,其中FLUX组件限非商业、非生产用途。当前,高频交互、多角色身份保持及长时间生成的视觉一致性仍待改善。 投稿/爆料:tougao@youxituoluo.com 稿件/商务合作: 林南(微信 19250561593) 加入行业交流群:林南(微信 19250561593) 元宇宙数字产业服务平台 下载「陀螺科技」APP,获取前沿深度元宇宙讯息

    匹配字段正文

  11. MediaNama

    印度最高法院就 CSAM 监管向平台提出哈希数据库与罚款框架

    印度最高法院在 137 页命令中拒绝禁止儿童使用社交媒体和按年龄限制,认为上网是宪法第 21 条与第 19(1)(a) 条保障的基本权利,同时提出针对儿童性虐待与剥削材料(CSEAM/CSAM)的监管框架。框架要求建立记录已确认内容哈希值与 URL 的国家数据库,可依托 Sahyog 门户建设,并配套人工核验、独立申诉通道、24 小时内确认报告、两小时内下架及向 SJPU 等机构报送等流程。法院还建议政府考虑中介责任之外的罚款,并没收通过付费墙传播此类内容所得收入;该框架尚未实施,政府需在 12 月 10 日下次听证前提交宣誓书说明进展。

    无论它在哪里上传或由谁上传,”它指出。 它进一步表示,所有已识别的CSEAM都应进行哈希处理,其标识符应添加到“被称为‘哈希列表’的整合数据库”中,该数据库随后将“用于交叉核对所有其他内容,无论是在同一平台上还是在另一平台上。” 每当出现自动检测时,平台的算法应自动删除相关内容。 为防止规避,最高法院表示可以使用“感知哈希”,它利用“内容的视听特征。诸如颜色编码、对象构成、音频提示等特征”,为特定媒体文件生成哈希值。 最高法院指出,除了《IT规则》下的尽职调查框架(该框架规定了未定义的“合理努力”)以及2026年2月修正案中的下架要求外,印度没有处理哈希值和URL数据库的法定条款: “据我们所知,印度不存在此类条款,要求社交媒体中介机构采用哈希或URL列表工具,至少达不到其他司法管辖区所见的同等程度。”——最高法院 国家数据库将便于CSEAM的检测与移除;可能依托Sahyog门户建设 为使哈希与URL数据库能够被其他中介机构访问并实现互操作,最高法院建议建立一个实时数据库,参照美国国家失踪与受虐儿童中心(NCMEC)式的实时数据库模式,以促进各中介机构之间的协调: “换言之,中介机构将

    匹配字段正文