每次 LLM 调用都从零开始
LLM 本身没有记忆。每个请求都是独立的:模型读取提示词,返回响应,然后什么都不保留。发送第二个请求时,在模型看来,第一个请求从未发生过。
对于一次性问题来说这没问题。但当你构建需要长期运行的东西时,它就会失效:一个处理后续跟进的支持智能体、一个为续约电话做准备的销售助手,或者一个每小时运行一次、并且应该知道上次做了什么的工作流。这些系统需要 状态,而模型无法替它们保存状态。
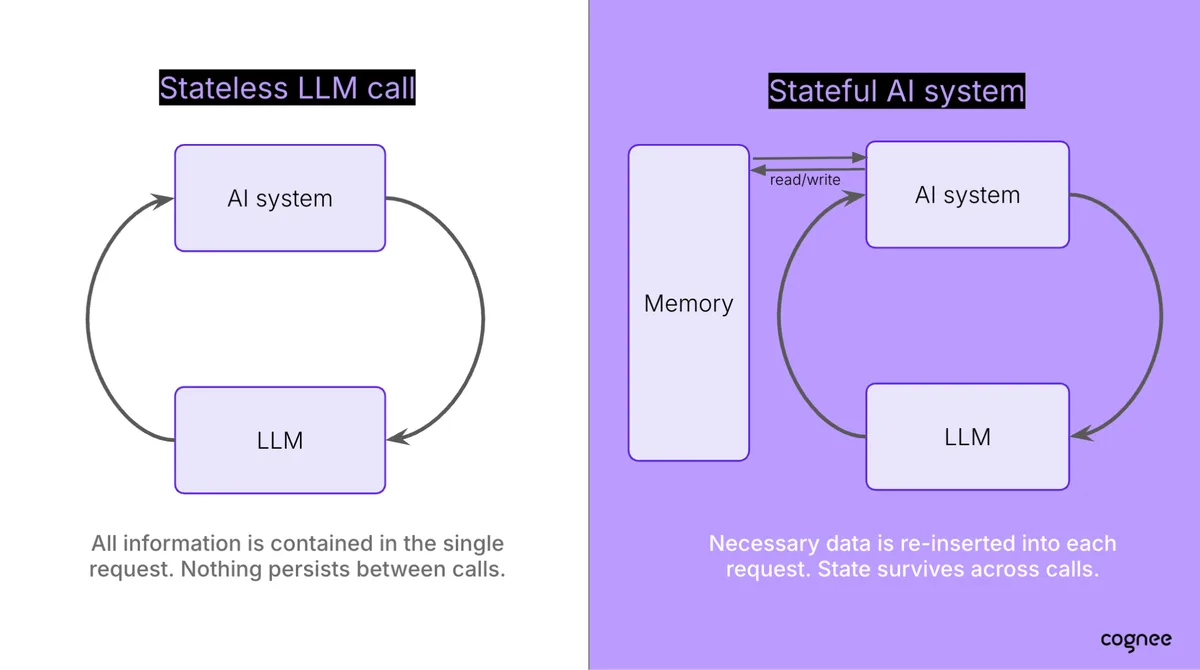
所以当人们问 LLM 记忆如何工作时,诚实的答案是:记忆存在于模型之外。智能体把学到的东西存储在别处,在每次调用前检索相关部分,再把它们反馈到提示词中。这个外部层就是我们所说的 AI 智能体记忆,而如何设计它,决定了你的智能体是记住正确的东西,还是淹没在错误的东西里。
本文解释这一层如何工作、构建它的主要方式,以及如何在 n8n,既作为你的工作流可以查询的共享“公司大脑”,也作为单个智能体工作流内部的记忆。
短期记忆与长期记忆
智能体记忆通常按两个时间尺度运作,而且它们往往被构建为两个独立的组件。
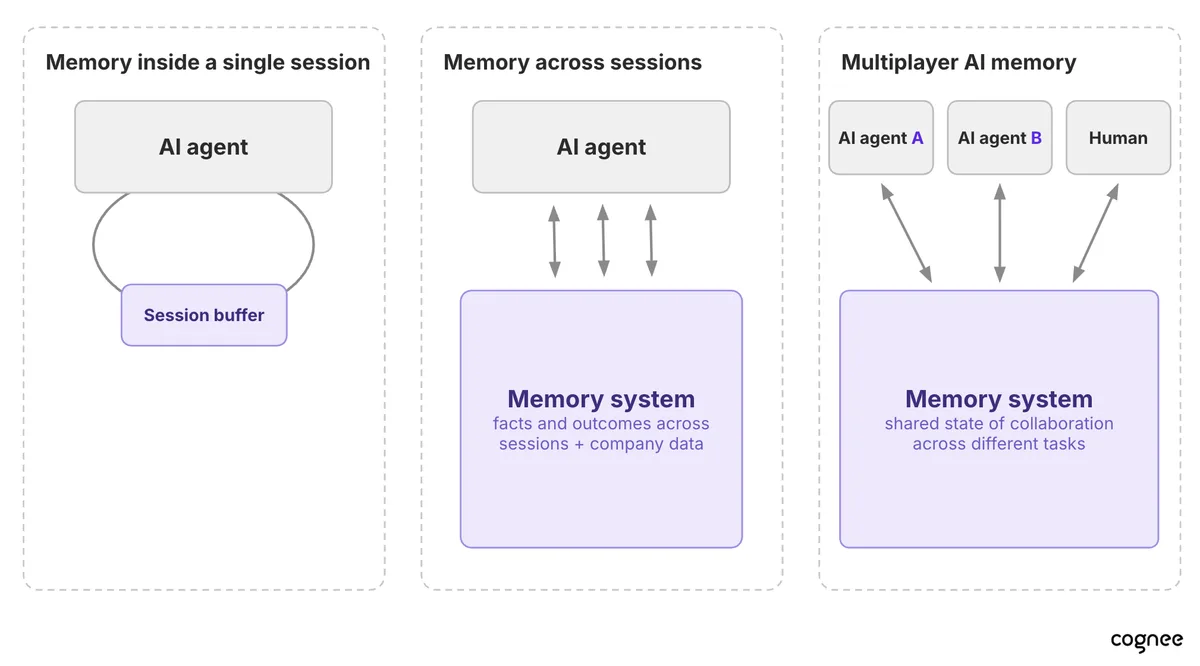
短期记忆 跟踪当下正在发生的事情:最近的消息、中间推理、工具输出、任务状态。它紧邻智能体,通常就在执行框架内部。当上下文窗口填满时,一个常见技巧是总结到目前为止的历史,再把摘要反馈回去。这办法在失效之前一直有效:摘要会丢失细节,而且有些输出根本不应该被压缩,例如中间草稿或昂贵计算的结果。
长期记忆 跨会话存续。它保存用户偏好、过去任务的结果、关于什么有效的经验教训,以及越来越多的、并非智能体自己生成的公司知识:文档、工单、CRM 记录。这几乎总是需要从第一天起就有一个专门的外部层,因为必须有东西来决定保留什么、如何组织,以及每次请求返回什么。
无论哪种方式,投递机制都不变。模型仍然只接收一个提示词。记忆只是改变了这个提示词的组装方式:新的用户消息,加上正在进行的会话,再加上当下相关的任何长期记忆。
LLM 记忆、上下文、RAG、智能体记忆:有什么区别?
这四个术语常被互换使用,但它们描述的是知识可以存在的不同位置。一个真实的系统往往四者都会用到。
方法 | 知识所在位置 | 由谁更新 | 适用于 |
|---|---|---|---|
LLM 记忆(模型权重) | 模型内部 | 训练或微调 | 通用知识和技能 |
上下文工程 | 当前提示词 | 智能体执行框架或应用代码,在每次调用时 | 把正确的数据放进这次请求 |
RAG | 外部的、基本静态的语料库 | 撰写文档的人或系统 | 让回答基于已有知识 |
智能体记忆 | 一个不断演进的外部记忆层 | 人、数据管道以及智能体自身 | 跨任务、会话和来源的连续性 |
LLM 记忆 严格来说是指模型在训练期间吸收的内容。它是压缩后的模式,而不是查找表,这就是为什么模型可以自信地重复过时的内容。微调可以添加领域知识,但它缓慢、昂贵、难以检查,而且无法捕捉实时会话中的任何内容。
上下文工程 是为这次特定调用选择什么进入上下文窗口。更大的窗口有帮助,但它们不能解决记忆问题:会话结束时上下文就消失了,长提示词成本更高,而且模型对超长输入中的内容关注并不均等。
RAG 从已有的知识源(文档、数据库、API)检索,并把结果加入提示词。关键限制在于方向:RAG 只读,不回写。它不会记住用户上周问了什么,或者哪个修复方案已经失败过。
智能体记忆 从智能体回写的地方开始。它在工作过程中捕捉新事实、偏好和结果,并在之后检索它们。想象一个销售助手,它通过 RAG 拉取本季度的数字,但也从早先的对话中记得这位用户想要以欧元表示的欧盟数据,并按国家细分。
智能体记忆实际如何工作
在高层次上,任何记忆系统都需要三个部分:一个持久化记忆的数据存储、决定存储什么以及如何存储的写入逻辑,以及让智能体找到相关记忆的检索接口。你选择的存储对其他两者有很大影响:哪种写入逻辑合理,以及检索能做什么。所以以下是按存储类型划分的主要架构。
向量数据库。 记忆被转换为嵌入,并通过语义相似度找到。易于设置且支持良好,但相似度并不代表一切。“Q3 销售额”和“Q4 销售额”在向量空间中几乎重叠,没有哪个事实是当前的概念,而一条相关但措辞不同的条目可能被完全漏掉。
纯文件。 智能体维护一个 MEMORY.md(或类似文件),它读取并编辑该文件。编码智能体推广了这种做法。它透明且受版本控制,但检索仅限于加载全部内容或 grep,而且在许多智能体之间共享一个文件很快就会变得混乱。
知识图谱。 事实变成实体和关系:销售报告 涵盖 欧盟交易,欧盟交易以 欧元记账 ,数字 来自 账单导出。检索找到一个入口点,然后沿着边遍历,因此智能体得到的是与问题 逻辑上 相关的事实,而不仅仅是听起来相似的事实。代价是摄取阶段需要更多工作。
混合系统。 在实践中,没有单一存储能覆盖一切。精确 ID 需要结构化索引,关系需要图,模糊匹配需要向量,而“客户去年三月偏好什么?”需要时间戳。生产级记忆层会组合多种存储,并在其上叠加逻辑来决定什么数据放在哪里。这也是为什么记忆层不只是数据库:存储只是数据存放的地方,记忆层位于它们之上。它决定存储什么、以什么形式存储,并暴露智能体用来写入、检索、更新和遗忘的操作。
架构 | 检索 | 优势 | 注意事项 |
|---|---|---|---|
向量数据库 | 语义相似度 | 简单、可扩展、工具链成熟 | 没有实体概念、精确 ID 能力弱、不支持时效性 |
文件 | 全量加载或文本搜索 | 透明、可版本控制、无需基础设施 | 扩展性差、共享困难 |
知识图谱 | 先找入口点,再遍历边 | 相关事实、可解释的路径 | 构建和维护更复杂 |
混合 | 一个层中组合多种存储;上层逻辑将每个查询路由到不同存储 | 覆盖混合数据:精确 ID、关系、模糊匹配和时效感知查询 | 需要更多组件来搭建和运行 |
记忆必须被管理,而不只是被累积
只增不减的记忆层会随时间推移而变差。事实会变化,偏好会转移,过时条目会开始与正确条目竞争。好的记忆系统会在存储之上处理若干流程。主要有三个:
- 整合。 原始条目堆积的速度快于它们变得有用的速度。系统应定期将它们转化为更少、更高层的记录(摘要、派生事实),同时保留回溯到原始内容的线索。
- 更新。 当事实发生变化时,盲目覆盖会丢失历史:之前什么是真的,以及何时发生了变化。在事实上保留时间信息,能让智能体同时回答“现在什么是真的?”和“我们在三月相信什么?”
- 遗忘。 有些数据必须删除:过时的数据集、一次更正、一个删除请求。这应该是一个明确、有意的操作,与让不太有用的记忆在相关性上逐渐淡出的较软性工作分开。
最好的系统还会从使用中学习. 如果一个答案得到确认,其背后的记忆权重会增加;如果被纠正,误导性的记忆权重会下降。经过数周,检索应该变得更精准,而不是更嘈杂。
你怎么知道你的记忆有效?
公开基准测试提供了有用的第一信号。大多数遵循相同的两阶段模式:将长历史输入记忆系统,然后提出答案依赖于存储和检索正确事实的问题,包括后来被更新或矛盾的事实。
规模比人们预期的更重要。如果一个基准测试的完整历史能放进现代上下文窗口,你完全可以跳过记忆,把所有内容粘贴进提示词,因此这个测试更多反映的是模型而非记忆。不过这并不意味着模型会完美回答:模型并不会均匀地利用长上下文,埋在长提示词中间的细节可能获得较少关注。LoCoMo 对话大约 26k token;LongMemEval 的常见变体约为 115k。BEAM 是三者中要求最高的,在长达 10M token 的对话上测试十种记忆能力,这正是外部记忆真正必须发挥作用的地方。BEAM 上报告的最先进水平是在 100K token 时达到 79%,在 10M 时达到 67%, 由 Cognee 创造, 高于此前最佳的 73.4% 和 64.1%。
但基准测试主要检查最终答案。它们不看记忆实际存储了什么、经过数周更新后是否仍然可靠,或者当许多智能体共享它时表现如何。要全面了解每个基准测试衡量什么以及在哪里不足,请参阅这份 AI 记忆基准测试.
指南。最重要的测试是你自己的:在开启和关闭记忆的情况下运行相同的工作流,并衡量你关心的结果,例如解决的工单数、更少的重复问题,或正确的后续跟进。
为 n8n 工作流添加记忆
n8n 工作流与 LLM 有一个共同特征:默认情况下,每次执行都从零开始。因此,一个在周一起草了修复方案的支持工作流,在周三收到后续消息时不会自动知道它。许多团队用 Postgres 表或 Airtable 基础库来处理这个问题,这可行,但每个工作流随后都需要自己的存储设置和自己的保留规则。
1. 为所有工作流提供一个共享大脑
最简单的说,记忆让任何工作流都能从上次运行中断的地方继续。一个节点存储工作流学到的东西;另一个节点在下一次运行时查找它。而且由于记忆存在于任何单个工作流之外,许多工作流可以共享它。
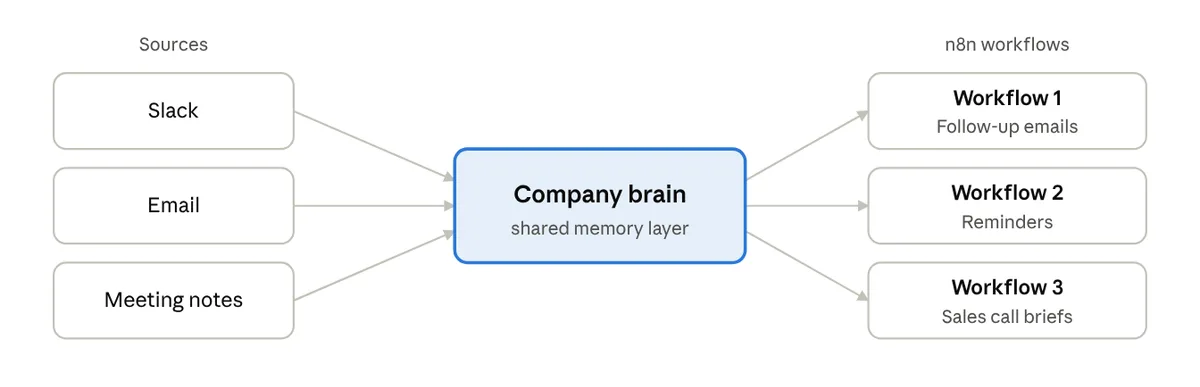
最大的回报是一个集中式的“大脑”:一个所有工作流都写入和读取的共享记忆。将其扩展到整个公司,你就得到了一个“公司大脑”。大多数有用的上下文已经存在于公司各处:Slack 线程、工单、文档、CRM 笔记、通话记录。n8n 可以从所有这些工具中收集它,而记忆层可以对其进行结构化和连接,这样每个工作流都基于公司所知情况的同一幅图景。
模式很简单:
- 收集工作流 利用 n8n 的触发器和应用集成,在新材料出现时将其拾取,例如已关闭的工单、通话摘要或表单提交,并将其发送到记忆层,由记忆层进行结构化和连接。
- 执行工作流 在它们做某事之前查询同一记忆:起草回复、路由升级、准备销售简报。它们可以用自然语言提问,比如“Acme 的当前状态是什么,我们向他们承诺了什么?”,并将答案传递给下一个节点。
因为双方都指向同一记忆,工作流共享上下文而无需共享实现细节。而当记忆保留实体之间的关系时,执行工作流会得到关联答案,例如哪些合同下季度到期,或哪些账户有相同的根本原因,这是纯相似度搜索会遗漏的。
2. 智能体工作流内部的记忆
第二种模式存在于单个 n8n AI Agent 内部,它对应前面提到的短期与长期之分。没有记忆时,智能体收到的每条消息都从零开始。n8n 通过 AI Agent 的 Memory 端口处理短期记忆这一侧。n8n 的默认选项“Simple Memory”会为当前会话存储可自定义长度的聊天历史,这是最容易上手的方式。你可以沿用这个默认选项,也可以选择更高级的第三方记忆提供方,如下所示:
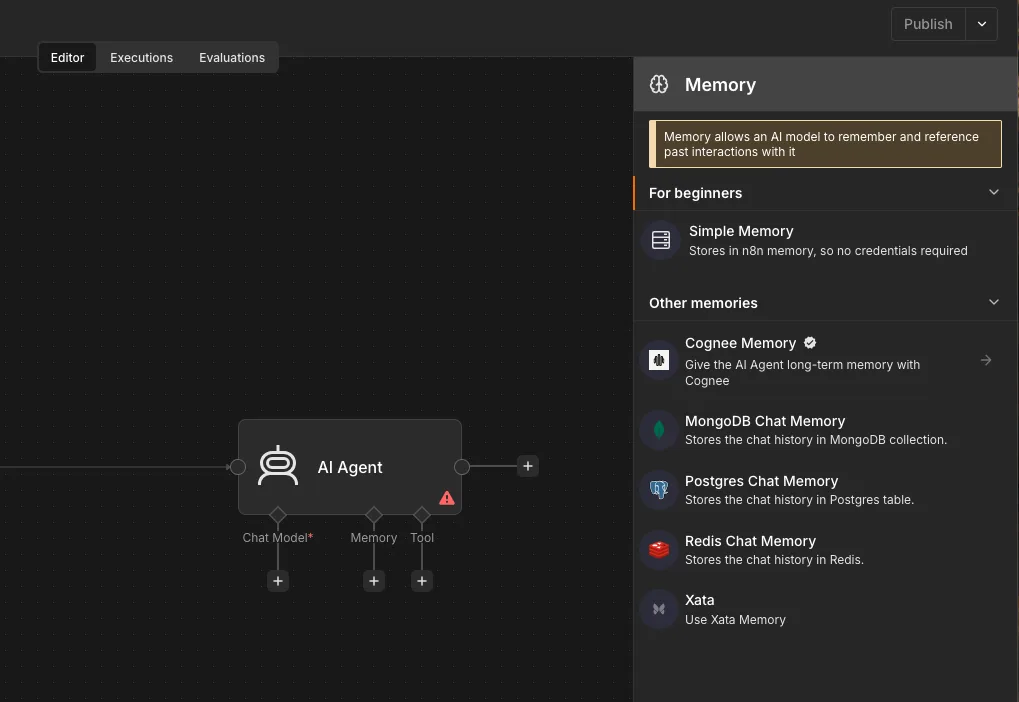
不过,聊天记忆只能记住对话内容。长期知识,例如用户偏好、过往任务的结果和公司上下文,需要的不仅仅是聊天记录。为此,需要将记忆层连接到 Agent 的 Tool 端口,在这里你可以挂载附加组件,让智能体能够访问额外的上下文或资源。然后,智能体可以自行决定何时记住新信息,以及何时搜索公司已有的知识。最终得到的智能体既能把握当前对话的脉络, 又 能在任务进行中调用共享的公司知识。
简而言之:n8n 的内置记忆对于单个聊天智能体来说是一个不错的起点。但如果你想要随时间演进、并在多个工作流和智能体之间共享的记忆,就应将其与记忆层结合:聊天记忆用于处理当前对话,共享记忆则让每次运行都从公司已知的信息出发,而不是从零开始。
结论
LLM 每次调用都从零开始,因此要构建能够长期可靠工作的 AI 智能体,就需要模型之外的记忆。但存储信息只是挑战的一半。智能体还需要一种方式,能够在不同任务和工作流之间捕获、检索并基于正确的上下文采取行动。
n8n 和 Cognee 共同解决这些挑战。 n8n 连接你的应用、编排 AI 智能体,并自动化信息在系统之间的流动。Cognee 将这些信息转化为结构化、持久的记忆,智能体可以检索、更新和共享。
两者结合,让你能够构建这样的 AI 工作流:它们不仅独立执行任务,还能从之前的交互中学习、跨会话保持上下文,并基于对公司知识的共享理解来工作。
准备好构建具有长期记忆的 AI 智能体了吗? 开始使用 n8n 并 连接 Cognee ,为你的工作流赋予共享记忆层。
与我们分享
n8n 用户来自各种不同的背景、经验水平和兴趣领域。我们一直希望在博客文章中介绍不同的用户及其项目。如果你正在使用 n8n 并希望激励社区, 请联系我们 💌
分享