 AI 热点
- 客户可以从 BigQuery 或 Databricks 访问同一份数据副本,而无需重复复制。
- Google 和 Databricks 致力于实现共享目录元数据的长期愿景。
Lakehouse 架构正变得前所未有的开放。从开放表格式——Delta Lake 和 Iceberg——起步,如今已演进为跨多个平台的零拷贝访问目录联邦。通过我们的合作和开源贡献,Databricks 和 Google Cloud 持续推动 Open Lakehouse 社区的发展。
今天,我们很荣幸与 Google 合作宣布目录互操作性的一个重要里程碑:客户现在可以从以下两个平台访问同一份数据副本: Unity Catalog 和 Google Cloud 的 无边界 Lakehouse。Databricks 与 Google Cloud 的合作持续蓬勃发展,我们致力于实现无缝的双向互操作。
Unity Catalog 与 Google Cloud 的 Lakehouse:双向联邦
将 Google Cloud 的数据引入 Databricks 非常简单。借助 面向 Google Cloud 的 Lakehouse Federation,客户可以将由 Google Cloud 的 Lakehouse 运行时目录管理的 Iceberg 表挂载到 Unity Catalog 中,以便在 Databricks 中进行分析。
随后,这些来自 Google Lakehouse 运行时目录的 Iceberg 表可以通过 Databricks Lakehouse(我们的无服务器数据仓库)进行查询,或通过 Genie进行分析——Genie 能够智能地用自然语言回答数据问题,无需编写代码或 SQL。
互操作性同样适用于另一个方向。Databricks 的数据也可以引入 Google Cloud 的 Lakehouse(了解更多)。这使使用 BigQuery 等引擎的客户无需复制数据即可读取 Unity Catalog 管理的表。
下一个前沿:让目录元数据实现互操作
Databricks 和 Google Cloud 正通过开放目录元数据,在加强互操作性方面迈出重大步伐。我们相信,业务和治理语义应当可被访问,而不是绑定到特定供应商。在 Iceberg 社区中,我们帮助推动并落地了目录标签(catalog labels)——这是一项提案,使目录能够通过键值对(即标签)共享元数据。这样一来,标记为“domain=finance”和“status=certified”的表,以及标记为“pii=ssn”的列,即使表从一个目录联邦到另一个目录,其标签仍会保留(了解更多).
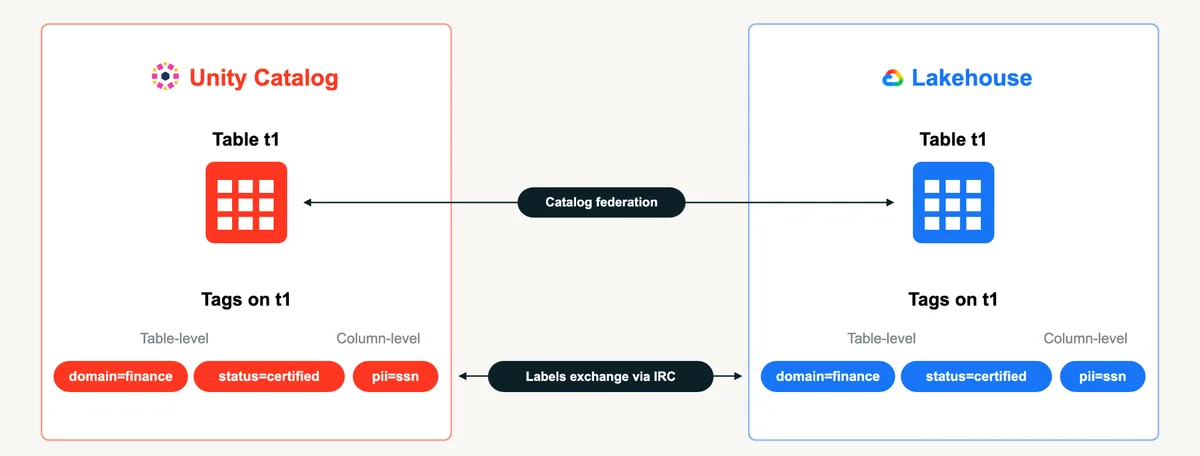
在智能体时代,共享标签对治理至关重要,因为目录元数据可用于标记敏感数据以进行掩码处理,并为搜索资产以回答数据问题的智能体提供上下文。通过我们的合作,Databricks 和 Google Cloud 致力于推进开放治理的愿景。随着数据资产规模不断扩大、AI 智能体更深入地融入企业工作流,这一共同承诺变得愈发重要。我们正迈向一个未来:治理和业务上下文可以随数据一同流转,而无需企业在每个系统中重新定义它们。
立即开始
阅读 我们的文档,即可开始使用 Unity Catalog 与 Google Cloud 无边界 Lakehouse 之间的目录联邦。你也可以 此处.
了解更多关于 Google 的目录联邦到 Unity Catalog 的信息。如果你有兴趣分享你的互操作性需求或进一步了解我们的互操作性愿景,请联系你的 Databricks 客户团队。
相关标签:在收件箱中获取最新文章
订阅我们的博客,最新文章将直接发送到你的收件箱。